


«Discovered – currently not indexed»: o que significa e como resolver
O Google sabe que o seu URL existe e ainda não o visitou. Veja como saber se deve esperar ou agir e que correções tentar primeiro num site pequeno e num grande.
Discovered – currently not indexed significa que o Google encontrou o URL mas ainda não o rastreou. É assim que a ajuda do relatório de indexação de páginas do Google o descreve. Normalmente o Google planeou o rastreio e depois reagendou-o, em vez de arriscar sobrecarregar o seu site, e é por isso que a data do último rastreio está vazia no relatório.
É um estado de prioridade de rastreio, não um veredicto sobre o seu conteúdo, porque o Google ainda não leu a página. Abaixo vai ver como difere de «Crawled», o que encontrámos quando verificámos o nosso próprio site e uma lista de correções ordenada pelo tamanho do site. É novo no relatório? Comece por este guia do Google Search Console.
O que significa «Discovered – currently not indexed»
O Google leva um URL por quatro etapas: encontra-o, rastreia-o, indexa-o e depois pode mostrá-lo nos resultados. Dois estados do Search Console descrevem um URL que parou pelo caminho.
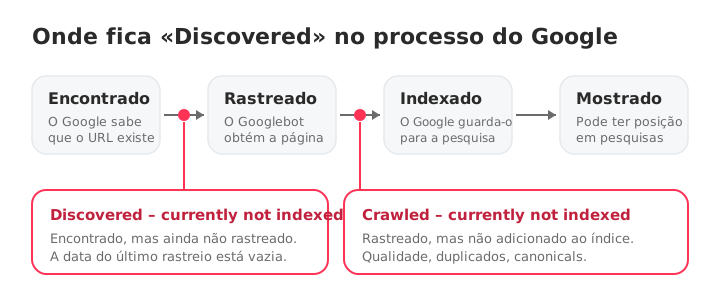
Um URL chega a «encontrado» através do seu sitemap ou de links de outras páginas. Depois o Google decide quando o rastrear. «Discovered» significa que essa decisão ainda não foi tomada.
Como difere de «Crawled – currently not indexed»
Os dois estados parecem semelhantes e exigem correções diferentes.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Rastreado pelo Google? | Não | Sim |
| Data do último rastreio | Vazia | Uma data |
| O Google leu a página? | Não | Sim |
| Motivo habitual | Rastreio adiado ou de baixa prioridade | O Google leu a página e ignorou-a |
| Ver primeiro | Links internos, sitemap, capacidade de rastreio | Qualidade do conteúdo, duplicados, canonicals |
O diagnóstico completo do segundo estado está no guia de Crawled – currently not indexed.
Como é a lista num site real
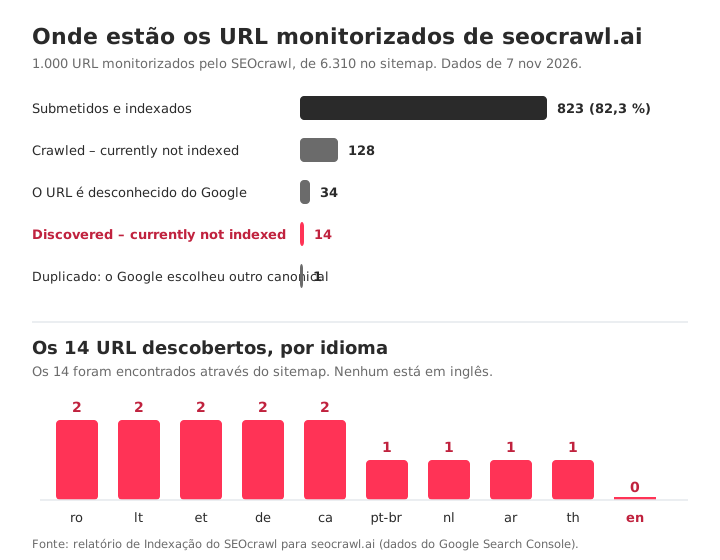
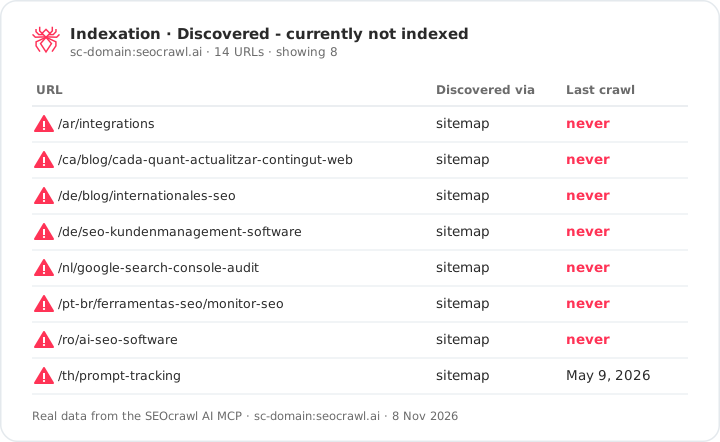
Verificámos seocrawl.ai no relatório de Indexação do SEOcrawl. Dos 1.000 URL que o SEOcrawl monitoriza (o nosso sitemap declara 6.310), 823 estão indexados, ou seja, 82,3 %. 128 estão em «Crawled – currently not indexed» e 14 em «Discovered – currently not indexed».
O que os 14 têm em comum é a parte útil:
- Todos são páginas traduzidas: árabe, catalão, alemão, estónio, lituano, neerlandês, português (Brasil), romeno e tailandês. Nenhum está em inglês.
- O Google encontrou os 14 através do sitemap, e não por um link de outra página.
- Um deles mostra uma data de rastreio anterior (9 de maio de 2026), por isso o estado descreve onde um URL está agora, e não que o Google nunca o visitou.
É um padrão a verificar, não um diagnóstico. Uma página que existe em 26 idiomas e a que se chega sobretudo pelo sitemap é uma candidata ideal a ligações internas fracas, por isso os links internos são a primeira coisa a ver. A lição vale para qualquer site: não leia a lista URL a URL. Agrupados por idioma, 14 URL tornaram-se uma única pergunta.
Os números abrangem os 1.000 URL que o SEOcrawl monitoriza, uma amostra do sitemap completo. O grupo maior, de 128 URL, corresponde ao outro estado e tem o seu próprio guia.
Porque é que o Google adia um rastreio
O guia do orçamento de rastreio do Google explica como decide quanto rastrear: um limite de capacidade que o seu servidor aguenta e a procura pelos seus URL. A maioria dos URL descobertos deve-se a uma destas cinco causas.
- Capacidade de rastreio. O Google diz que o limite desce quando o seu site fica lento ou devolve erros de servidor. Um servidor lento significa menos rastreios.
- Pouca procura de rastreio. A procura depende do tamanho do site, da frequência de atualização, da qualidade e da relevância das páginas. Um URL com poucos links internos, ou nenhum, dá ao Google poucos motivos para voltar depressa.
- Desperdício de rastreio. URL duplicados, parâmetros, facetas, longas cadeias de redirecionamentos e soft 404 competem com as suas páginas reais. O Google refere que os soft 404 continuam a ser rastreados e desperdiçam orçamento, e que ainda pede uma página com noindex antes de a descartar.
- Descoberta apenas pelo sitemap. Um sitemap diz ao Google que um URL existe. Não faz dele uma prioridade, e o Google trata-o como uma sugestão. As páginas encontradas apenas aí são as primeiras a esperar.
- Um site ou secção novos. Todos os sites começam com o mesmo limite de capacidade predefinido e conservador, que cresce à medida que o site prova estar saudável.
O orçamento de rastreio em si só merece a sua atenção em sites muito grandes. A estimativa aproximada do Google: 1.000.000+ de páginas únicas atualizadas cerca de semanalmente, ou 10.000+ páginas que mudam diariamente. Em sites mais pequenos, as causas 2 e 4 são muito mais comuns.
É um problema? Três perguntas antes de corrigir
- Este URL deve sequer ser indexado? Se for uma vista filtrada, uma página de pesquisa interna ou um URL de teste, deixá-lo de fora está bem. Para o tornar explícito, ponha-lhe noindex ou devolva um 404 ou 410 (veja Excluded by 'noindex' tag).
- Quantos URL, e com que padrão? O Google diz que, com menos de 500 páginas, provavelmente não precisa deste relatório. A lista está também limitada a 1.000 linhas, por isso num site grande é uma amostra.
- São novos? Um URL publicado na semana passada ainda não é um problema. Os prazos do próprio Google estão na tabela abaixo.
Como corrigir, consoante o tamanho do site
O primeiro passo certo depende do tamanho do seu site, por isso comece na coluna certa.
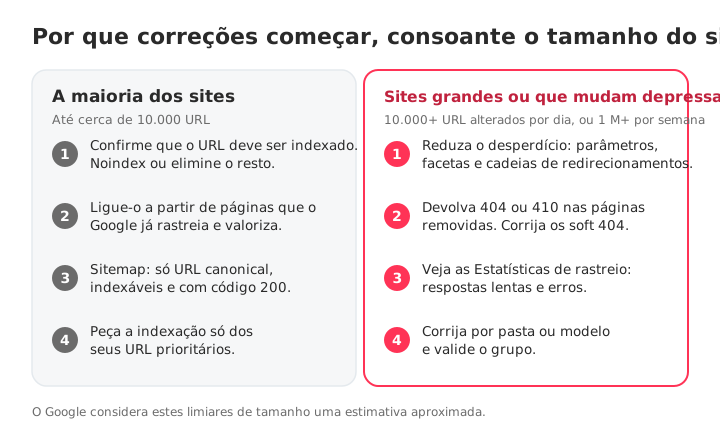
A maioria dos sites: até cerca de 10.000 URL
- Confirme que o URL merece ser indexado. Se não merecer, ponha-lhe noindex ou elimine-o e tire-o da sua lista.
- Ligue-o a partir de páginas que o Google já rastreia. Adicione links contextuais, com âncoras descritivas, a partir de páginas indexadas que recebem tráfego. Qualquer crawler consegue listar as suas páginas órfãs filtrando as que têm zero links internos, e este guia de ligações internas tem o método completo.
- Mantenha o sitemap limpo. Inclua apenas URL que devolvam 200, sejam indexáveis e sejam a versão canonical, com um
lastmodcorreto. O Google ignora priority e changefreq. Se precisar primeiro do ficheiro, encontre o seu sitemap. Se o Search Console disser que não encontra nenhum, veja No referring sitemaps detected. - Peça a indexação de um punhado de URL prioritários. Abra a ferramenta de inspeção de URL e clique em Pedir indexação. O Google aplica uma quota e diz que pedidos repetidos não aceleram nada, por isso guarde-o para as páginas que mais importam.
Sites grandes ou que mudam depressa: 10.000+ URL alterados por dia, ou 1 M+ por semana
- Reduza o desperdício de rastreio. Bloqueie no robots.txt os espaços de URL sem valor de pesquisa (parâmetros, facetas, pesquisa interna) e consolide duplicados com canonicals e redirecionamentos 301. Não conte com o noindex para poupar orçamento: o Google continua a pedir essas páginas.
- Devolva 404 ou 410 nas páginas removidas e corrija os soft 404. O Google considera um 404 um sinal forte para não voltar a rastrear um URL, enquanto os URL bloqueados ficam mais tempo na fila. Encurte qualquer cadeia longa de redirecionamentos.
- Verifique as Estatísticas de rastreio. Em Definições, o relatório de Estatísticas de rastreio mostra tempos de resposta e erros de servidor. Se forem altos, o Google reduz o seu limite de capacidade e nenhuma correção de conteúdo ajudará enquanto o servidor não melhorar.
- Corrija por pasta ou modelo e depois valide o grupo. Tome uma decisão por padrão, crie um sitemap só com os URL corrigidos e clique em Validar correção. Saiba mais sobre o orçamento de rastreio se o seu site estiver neste intervalo.
Esperar ou agir?
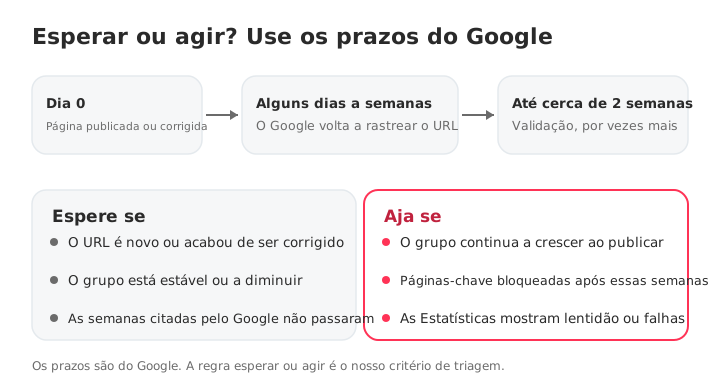
O mais difícil não é a correção, é saber quando parar de esperar. Use os intervalos do próprio Google e a sua própria tendência.
| O que fez | O que diz o Google | Fonte |
|---|---|---|
| Pediu ao Google que voltasse a rastrear | De alguns dias a algumas semanas | Pedir ao Google que volte a rastrear |
| Pediu a indexação | Normalmente cerca de um dia, até uma ou duas semanas, com um limite diário | Ajuda da inspeção de URL |
| Validou a correção | Até cerca de duas semanas, por vezes muito mais | Ajuda da indexação de páginas |
Os intervalos de tempo são do Google. A regra de esperar ou agir é nossa: espere enquanto o URL for novo e o grupo estiver estável ou a diminuir, e aja quando o grupo continuar a crescer ou as suas páginas-chave ficarem bloqueadas depois dessas semanas.
Como monitorizar ao longo do tempo
O Search Console mostra o estado mais recente de cada URL e uma lista limitada a 1.000 linhas, por isso crie a sua própria rotina:
- Uma vez por mês, exporte a lista e compare-a com a anterior. O grupo está a crescer, estável ou a diminuir?
- Agrupe por padrão (idioma, pasta, modelo) antes de olhar para URL individuais.
- Veja como o Google encontrou cada URL. Uma lista toda «sitemap» e nada de «página de referência», como nos nossos 14 URL, aponta diretamente para as ligações internas.
A vista de Indexação do SEOcrawl AI dá-lhe essa lista pronta a usar: filtre por estado de cobertura para ver os URL que contém, com a data do último rastreio, cliques e impressões. Através do MCP, cada URL traz também o canonical escolhido pelo Google face ao declarado e se foi encontrado através do sitemap ou de uma página de referência. O Crawler audita as próprias páginas, para poder verificar o que está fraco num URL antes de pedir ao Google outra análise, e o SEO Monitor avisa-o quando uma página-chave ganha um noindex, muda o canonical, devolve um 404 ou sai do sitemap.
Eis essa lista para o nosso próprio site, diretamente da vista de Indexação:
Pode também dispensar o painel. Com o MCP do SEOcrawl AI ligado ao Claude ou ao ChatGPT, pergunte: «Lista os URL em Discovered – currently not indexed e agrupa-os por pasta.» Aqui está o guia passo a passo para ligar o Search Console ao Claude e ao ChatGPT.
Perguntas frequentes
O que significa «Discovered – currently not indexed»?
Significa que o Google encontrou o seu URL mas ainda não o rastreou. Normalmente o Google planeou o rastreio e depois reagendou-o, e é por isso que a data do último rastreio está vazia (ajuda da indexação de páginas). O Google não leu a página, por isso o estado não diz nada sobre a sua qualidade. Não é uma penalização.
Quanto tempo dura «Discovered – currently not indexed»?
O Google não publica um tempo para este estado. Diz, no entanto, que um novo rastreio que peça demora de alguns dias a algumas semanas, e que uma validação de correção demora até cerca de duas semanas, por vezes muito mais. Um URL novo pode simplesmente precisar dessas semanas. Se o grupo continuar a crescer à medida que publica, deixe de esperar e aja.
Pedir a indexação resolve?
Pode ajudar com um punhado de URL prioritários, porque pede ao Google que ponha a página na fila. Não remove a causa, por isso uma página pode voltar ao mesmo estado. Os pedidos estão sujeitos a uma quota diária e o Google diz que enviar o mesmo URL várias vezes não acelera nada. Use-o depois de melhorar os links internos, nunca como ferramenta em massa.
É uma penalização?
Não. As ações manuais aparecem no seu próprio relatório. Este estado significa que o Google encontrou o URL e ainda não o rastreou, por isso não avaliou a página. A causa costuma ser a prioridade de rastreio: links internos fracos, um servidor lento ou um monte de URL de pouco valor a competir por rastreios.
Porque é que tantas das minhas páginas estão descobertas mas não indexadas?
Um número elevado aponta normalmente para um padrão, não para páginas isoladas: parâmetros de URL ou facetas, duplicados, um sitemap com URL que não deviam lá estar, links internos fracos para uma secção inteira ou um servidor que abranda o Googlebot. Agrupe os URL por pasta, idioma ou modelo antes de olhar para qualquer um em particular.
Devo preocupar-me num site pequeno?
Normalmente não. O Google diz que, se o seu site tiver menos de 500 páginas, provavelmente nem precisa do relatório de indexação de páginas. Alguns URL novos neste estado precisam sobretudo de tempo e de alguns links internos a partir de páginas que o Google já rastreia.
Como pode o SEOcrawl AI ajudar com URL descobertos?
A vista de Indexação do SEOcrawl AI lista os URL parados em cada estado de cobertura do Google, com a sua data do último rastreio, cliques e impressões. Através do MCP do SEOcrawl AI também pode pedir ao Claude ou ao ChatGPT essa lista com o canonical do Google face ao declarado e se o Google encontrou cada URL através do sitemap ou de uma página de referência, e agrupá-la por pasta.
Mais SEOcrawl AI no Google
Escolha-nos como fonte preferida e verá mais artigos nossos nas Notícias principais do Google.
Autor: David Kaufmann
Passei os últimos 10 e tantos anos completamente obcecado por SEO — e, sinceramente, não quereria que fosse de outra forma.
A minha carreira atingiu um novo patamar quando trabalhei como Senior SEO Specialist na Chess.com — um dos 100 sites mais visitados de toda a internet. Operar nessa escala, em milhões de páginas, dezenas de idiomas e numa das SERPs mais competitivas que existem, ensinou-me coisas que nenhum curso ou certificação jamais poderia. Essa experiência mudou a minha perspetiva sobre o que é realmente um grande trabalho de SEO — e tornou-se a base de tudo o que construí desde então.
Foi a partir dessa experiência que fundei a SEO Alive — uma agência para marcas que levam a sério o crescimento orgânico. Não estamos aqui para vender dashboards e relatórios mensais. Estamos aqui para construir estratégias que realmente fazem a diferença, combinando o melhor do SEO clássico com o novo e empolgante mundo da Generative Engine Optimization (GEO) — garantindo que a tua marca apareça não só nos links azuis do Google, mas também dentro das respostas geradas por AI que o ChatGPT, o Perplexity e o Google AI Overviews entregam a milhões de pessoas todos os dias.
E como não consegui encontrar uma ferramenta que lidasse corretamente com esses dois mundos, construí uma eu mesmo — a SEOcrawl AI, uma plataforma enterprise de SEO intelligence que reúne rankings, auditorias técnicas, monitoramento de backlinks, saúde do crawl e tracking de visibilidade de marca em AI, tudo num só lugar. É a plataforma que sempre desejei que existisse.
Descubra mais conteúdos deste autor
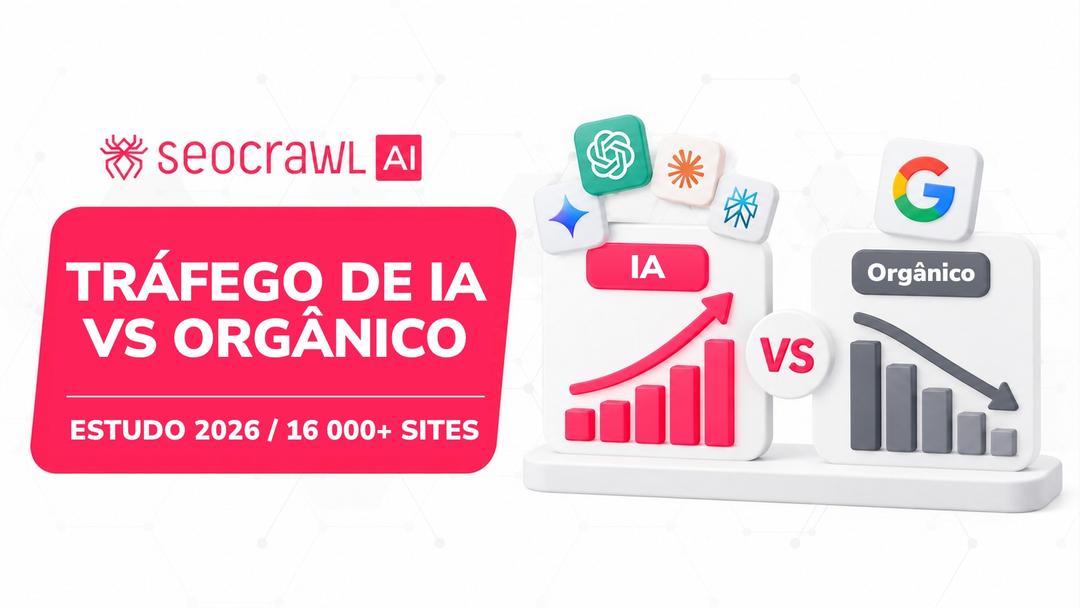
Medimos os cliques do Google e o tráfego vindo de IA em mais de 16 000 sites e 15 setores. O tráfego de IA cresce 45% ao ano, mas ainda equivale a cerca de 1 visita por cada 100 do Google, enquanto os cliques do Google caíram 15%.

Até 30 de novembro, o primeiro ano de qualquer plano anual do SEOcrawl AI custa metade com o código BLACKFRIDAY2026. O que recebe, o que cobrem os prompts de cada plano e como ver em 15 minutos onde o ChatGPT, o Gemini, o Claude e o Perplexity o mencionam.