Crawled – currently not indexed: o que significa e como resolver

O Google visitou o seu URL, leu-o e deixou-o fora da pesquisa. Saiba como perceber que páginas merecem uma segunda oportunidade e o que o Google recomenda para as voltar a pôr no índice.
Crawled – currently not indexed (rastreada, atualmente não indexada) significa que o Googlebot obteve a sua página e decidiu não a adicionar ao índice do Google, pelo que não pode aparecer na pesquisa. A ajuda do relatório de indexação de páginas explica-o assim: a página foi rastreada mas não indexada, e «pode ou não vir a ser indexada no futuro».
A causa costuma ser a própria página, e não um bloqueio técnico. Mais abaixo vai ver como decidir, URL a URL, se deve corrigir, aplicar noindex ou eliminar cada página, e quanto tempo demora uma correção segundo o Google. É a primeira vez que abre o relatório? Comece por este guia da Google Search Console.
O que significa «Crawled – currently not indexed»?
O estado significa que o Google rastreou a página e optou por não a indexar. Nada bloqueou o Googlebot: o Google decidiu deixar a página de fora, para já. Há duas distinções que ajudam a interpretar bem o estado.
Rastreada vs. indexada
Rastrear é o Googlebot descarregar uma página. Indexar é o Google guardá-la para que possa aparecer nas pesquisas. Uma página pode ser rastreada muitas vezes e nunca chegar a ser indexada.
A ajuda da ferramenta de Inspeção de URL diz que a qualidade de uma página tem de ser «suficientemente elevada para justificar a indexação», e o teste em direto não consegue detetar este estado.
Em que difere de «Discovered – currently not indexed»
Discovered – currently not indexed (detetada, atualmente não indexada) surge um passo antes: o Google encontrou o URL mas adiou o rastreio para não sobrecarregar o seu site, por isso a data do último rastreio está vazia.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Rastreada pelo Google? | Não | Sim |
| Data do último rastreio | Vazia | Uma data |
| Motivo habitual | Rastreio adiado para não sobrecarregar o site | O Google leu a página e pô-la de parte |
| O que analisar primeiro | Capacidade de rastreio, em sites muito grandes | Qualidade do conteúdo, duplicados, canónicos |
O Google diz também que «não estar indexada não é necessariamente mau». As páginas com noindex, os URLs bloqueados no robots.txt, os duplicados e os 404 sem substituto devem ficar de fora.
Porque é que o Google rastreia páginas sem as indexar
A indexação tem uma fasquia de qualidade que o rastreio não tem. O guia de orçamento de rastreio do Google diz que a procura de rastreio aumenta com o valor e a originalidade do conteúdo.
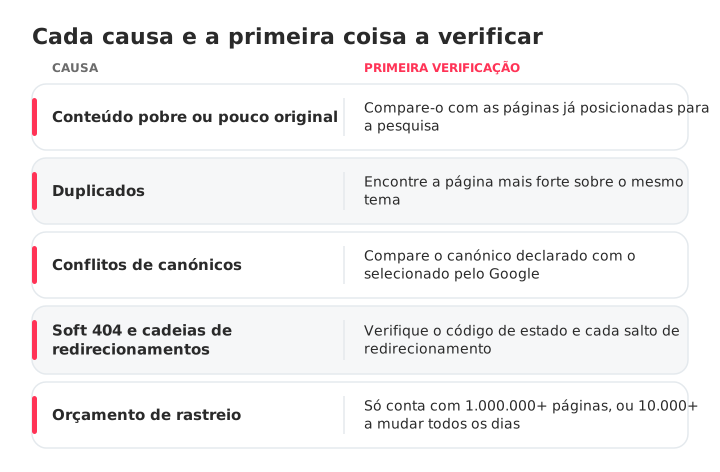
A maioria dos URLs afetados encaixa numa destas causas, cada uma com a sua primeira verificação:
- Conteúdo pobre ou pouco original: a página repete o que já está bem posicionado.
- Duplicados: arquivos de etiquetas, URLs ordenados, dois artigos sobre o mesmo tema. Veja como detetar e corrigir a canibalização de palavras-chave.
- Conflitos de canónicos: compare o canónico que declarou com o que o Google selecionou. Quando o Google escolhe outro URL, a página costuma passar para Alternate page with proper canonical tag ou para um estado de duplicado.
- Soft 404 e cadeias de redirecionamentos: o Google diz que os soft 404 desperdiçam orçamento de rastreio.
- Orçamento de rastreio: conta em sites com mais de 1.000.000 de páginas que mudam todas as semanas ou mais de 10.000 que mudam todos os dias. Na maioria dos sites, não é a causa.
A fasquia subiu em dois momentos datados. A 18 de agosto de 2022, o Google anunciou a atualização de conteúdo útil, um sinal ao nível de todo o site, e disse que remover conteúdo pouco útil podia ajudar o resto do site. A 5 de março de 2024, o Google anunciou uma core update para mostrar menos conteúdo feito para atrair cliques, juntamente com uma nova política de spam contra o abuso de conteúdo em escala.
As orientações de conteúdo útil do Google dizem que o E-E-A-T não é um fator de classificação específico, que a confiança é o que mais conta e que não existe um número de palavras preferido. Encher a página de texto não resolve.
Como encontrar e diagnosticar as páginas afetadas na GSC
Abra o relatório de indexação de páginas (antes, Cobertura), inspecione uma amostra e agrupe a lista por padrões. O Google refere que os sites com menos de 500 páginas provavelmente não precisam do relatório.
Encontrar os URLs afetados no relatório de páginas
- Na Google Search Console, vá a Indexação › Páginas.
- Em «Motivo pelo qual as páginas não estão indexadas», clique em Crawled – currently not indexed.
- Clique em Exportar e transfira a lista.
O relatório mostra até 1.000 URLs de exemplo, não necessariamente todos, por isso num site grande a exportação é uma amostra.
Verificar páginas com a ferramenta de Inspeção de URL
Inspecione cinco a dez URLs exportados e veja a data do último rastreio e o canónico selecionado pelo Google. Um canónico que aponta para outro lado significa que o Google vê um duplicado; uma data de rastreio com meses sugere que o Google raramente volta.
Detetar padrões em centenas de URLs
Ordene a exportação por pasta, modelo e parâmetro de URL, e conte cada grupo. Imagine 300 URLs divididos em 180 páginas /tag/, 70 URLs com ?sort= e 50 artigos: são três decisões, não 300.
Corrigir, noindex ou eliminar: decida o que cada URL merece
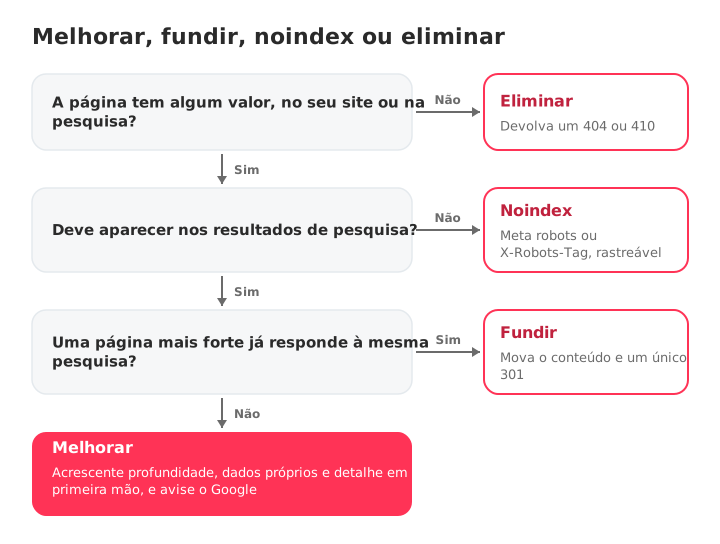
Cada URL merece um de quatro destinos. Pergunte-se: quem pesquisa ficaria satisfeito por chegar aqui, e esta é a única página do seu site que responde à pesquisa?
| Tipo de página | Exemplo | Decisão | Como |
|---|---|---|---|
| Útil e única, mas pobre | Um guia de 300 palavras sobre um tema que domina | Melhorar | Acrescente profundidade e detalhe em primeira mão |
| Duplica uma página mais forte | Dois artigos para a mesma pesquisa | Fundir | Mova o conteúdo e faça um redirecionamento 301 |
| Útil no site, não na pesquisa | Arquivos de etiquetas, pesquisa interna, páginas de agradecimento | Noindex | Meta tag robots ou X-Robots-Tag |
| Sem valor nem substituto | Promoções expiradas, páginas de teste | Eliminar | Devolva um 404 ou 410 |
O guia de orçamento de rastreio do Google sustenta as duas últimas linhas: devolva 404 ou 410 nas páginas removidas e consolide os duplicados. Um 404 na Search Console é esperado nas páginas que removeu de propósito.
É no noindex que a triagem mais vezes corre mal:
Assim não: uma tag noindex nas páginas /tag/ enquanto o robots.txt bloqueia /tag/. O Googlebot não consegue obter as páginas, por isso nunca vê a tag.
Assim sim: /tag/ continua rastreável e tem o noindex como meta tag ou cabeçalho X-Robots-Tag.
Segundo a documentação de noindex do Google, a regra não funciona dentro do robots.txt, e em páginas pouco visitadas o novo rastreio pode demorar meses. Assim que a tag é lida, esses URLs passam para Excluída pela etiqueta 'noindex', que é o que pretende para eles.
Como corrigir as páginas que merecem ser indexadas
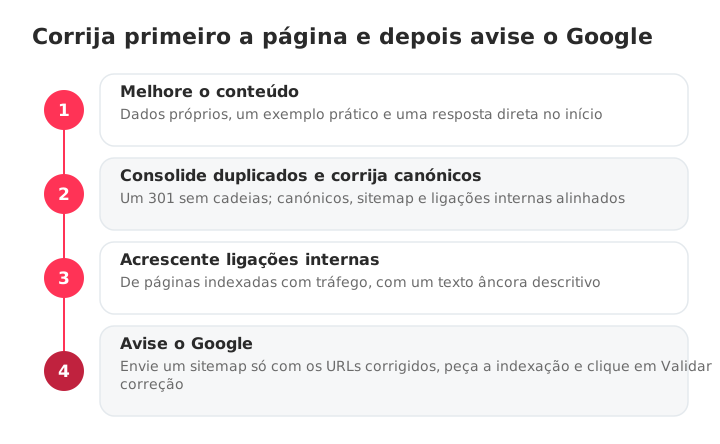
Primeiro torne a página digna de ser indexada e só depois avise o Google. Pedir a indexação de uma página sem alterações é pedir ao Google que repita uma decisão que já tomou. A ordem:
- Melhore o conteúdo.
- Consolide os duplicados e corrija os canónicos.
- Acrescente ligações internas.
- Envie um sitemap focado e peça a indexação.
Melhore a profundidade e a originalidade do conteúdo
Reescreva a pensar na pesquisa, não num número de palavras: acrescente dados próprios, capturas de ecrã, um exemplo prático e uma resposta direta logo no início.
Por exemplo, pegue num guia pobre de 300 palavras: acrescente um conjunto de dados próprio e um exemplo prático, crie ligações para ele a partir de dois artigos que já têm tráfego e só então inclua-o num sitemap focado.
Consolide os duplicados e corrija os canónicos
Quando dois URLs tratam o mesmo assunto, fique com um, mova para ele o conteúdo útil e faça um redirecionamento 301 do outro diretamente para ele, sem cadeias. Depois confirme que os canónicos, o sitemap e as ligações internas estão de acordo, e que não ficou nenhum noindex esquecido.
Acrescente ligações internas a partir de páginas que o Google já valoriza
Crie ligações para cada página corrigida a partir de páginas indexadas que têm tráfego, com um texto âncora descritivo. Qualquer crawler consegue listar as páginas órfãs (sem ligações internas) filtrando por zero ligações de entrada. O método completo está neste guia de estratégia de ligações internas.
Verifique também a página num telemóvel e no relatório Core Web Vitals: uma página avariada em mobile é rápida de excluir.
Envie um sitemap focado e peça a indexação
Crie um sitemap só com os URLs que corrigiu, envie-o e filtre o relatório de páginas por ele antes de clicar em Validar correção. O Google sugere-o para acelerar a validação. Se primeiro precisar do ficheiro atual, encontre o sitemap do seu site.
O Google ignora priority e changefreq, por isso mantenha antes o lastmod exato. Depois clique em Pedir indexação na ferramenta de Inspeção de URL para os URLs prioritários: o Google aplica uma quota e diz que repetir os pedidos não acelera nada.
Quanto tempo demora a indexação depois de uma correção?
Conte com um dia a várias semanas, e a indexação nunca está garantida. O Google indica prazos diferentes em páginas diferentes, por isso aqui ficam lado a lado:
| O que fez | O que o Google diz | Fonte |
|---|---|---|
| Pediu ao Google um novo rastreio | De alguns dias a algumas semanas | Pedir ao Google para voltar a rastrear |
| Pedir indexação | Normalmente cerca de um dia, até uma ou duas semanas, com limite diário | Ajuda da Inspeção de URL |
| Validar correção | Até cerca de duas semanas, por vezes muito mais | Ajuda da indexação de páginas |
São os prazos do Google, não casos de recuperação. Consulte o relatório de páginas todas as semanas; se os URLs corrigidos não se mexerem depois de esgotados esses prazos, volte ao conteúdo.
Como evitar que páginas novas caiam neste estado
A prevenção é uma rotina: verifique cada página antes de a publicar e reveja a Search Console todos os meses. Antes de publicar, confirme que a página:
- Responde a uma pesquisa a que nenhuma outra página do site responde.
- Acrescenta dados, exemplos ou experiência próprios.
- Tem um canónico autorreferenciado e nenhum noindex esquecido.
- Está no sitemap com um lastmod exato.
- Tem um autor identificado e, quando se aplica, dados estruturados.
- Recebe uma ligação de uma página relacionada e indexada.
Uma vez por mês, compare o relatório de páginas com o do mês anterior; um problema continua listado durante 90 dias depois de desaparecer a última ocorrência. Sites com mais de mil páginas devem também acompanhar o relatório de Estatísticas de rastreio.
O SEOcrawl AI trata da parte técnica em escala. O Crawler analisa todas as páginas e devolve um Audit Health Score, com os problemas divididos por Indexability, Crawlability, On-Page e mais. A vista Indexation agrupa os seus URLs por estado de cobertura da Search Console, para ver quantos estão em «Crawled – currently not indexed» e acompanhar esse número ao longo do tempo.
Entre rastreios, o SEO Monitor avisa-o quando uma página importante recebe um noindex, muda o canónico, devolve um 404 ou sai do sitemap. A mesma plataforma acompanha a visibilidade da sua marca no ChatGPT, Claude, Gemini, Perplexity e Copilot, para que o SEO e o GEO fiquem lado a lado.
Perguntas frequentes
O que significa «Crawled – currently not indexed»?
Significa que o Googlebot obteve a sua página e decidiu não a adicionar ao índice do Google, pelo que não pode aparecer na pesquisa. Nada bloqueou o rastreio: o Google leu a página e optou por deixá-la de fora, para já. Não é uma penalização manual, e a página pode ou não vir a ser indexada no futuro.
É o mesmo que «Discovered – currently not indexed»?
Não. «Discovered» significa que o Google conhece o URL mas adiou o rastreio, por isso a data do último rastreio está vazia. «Crawled» significa que o Google já visitou e leu a página e depois decidiu não a indexar. Com Discovered, analise a capacidade de rastreio em sites muito grandes; com Crawled, analise a qualidade do conteúdo, os duplicados e os canónicos.
«Crawled – currently not indexed» prejudica o meu SEO?
Por si só, não: o estado não é uma penalização e a página afetada só perde o seu próprio tráfego de pesquisa. O risco é o volume, porque o Google trata uma grande proporção de conteúdo pouco útil como um sinal ao nível de todo o site. Um arquivo de etiquetas fora do índice não custa nada; uma página de produto, sim. Se o número sobe sempre que publica, trate-o como um problema de conteúdo do site, e não como uma lista de URLs avulsos.
Quanto tempo demora uma página a ser indexada depois de corrigida?
Conte com um dia a várias semanas, e a indexação nunca está garantida. O Google diz que um novo rastreio demora de alguns dias a algumas semanas, que um pedido de indexação costuma ser processado em cerca de um dia mas pode demorar uma ou duas semanas, e que Validar correção costuma demorar até cerca de duas semanas.
Pedir a indexação ajuda?
Só depois de alterar a página. Pedir a indexação de uma página sem alterações é pedir ao Google que repita uma decisão que já tomou. Os pedidos estão sujeitos a uma quota diária, e o Google diz que enviar o mesmo URL várias vezes não acelera nada.
Adicionar a página ao meu sitemap XML ajuda?
Ajuda o Google a encontrar um URL, não a indexá-lo. O Google diz que um sitemap enviado é «apenas uma sugestão», e estas páginas já foram encontradas e lidas. Depois de uma correção, a função do sitemap é agrupar os URLs que quer que sejam verificados de novo. Cada ficheiro de sitemap aceita até 50.000 URLs ou 50 MB.
Porque é que a validação de «Crawled – currently not indexed» falhou?
A validação para assim que o Google encontra um URL do grupo ainda por corrigir, pelo que uma única página pendente pode fazer falhar o lote inteiro. Corrija todos os URLs do grupo, ou reduza o grupo filtrando o relatório com um sitemap que contenha apenas os URLs corrigidos, e valide de novo.
Como é que o SEOcrawl AI ajuda com páginas que o Google rastreia mas não indexa?
O SEOcrawl AI encontra as causas internas do site por trás do estado. O Crawler mostra a pontuação de saúde, o código de estado HTTP e a profundidade de rastreio de cada URL, para detetar as páginas a que o Google tem dificuldade em chegar. A vista Indexation agrupa os seus URLs por estado de cobertura da Search Console, e o SEO Monitor avisa-o quando uma página importante recebe um noindex, muda o canónico, devolve um 404 ou sai do sitemap.
Autor: David Kaufmann

Passei os últimos 10 e tantos anos completamente obcecado por SEO — e, sinceramente, não quereria que fosse de outra forma.
A minha carreira atingiu um novo patamar quando trabalhei como Senior SEO Specialist na Chess.com — um dos 100 sites mais visitados de toda a internet. Operar nessa escala, em milhões de páginas, dezenas de idiomas e numa das SERPs mais competitivas que existem, ensinou-me coisas que nenhum curso ou certificação jamais poderia. Essa experiência mudou a minha perspetiva sobre o que é realmente um grande trabalho de SEO — e tornou-se a base de tudo o que construí desde então.
Foi a partir dessa experiência que fundei a SEO Alive — uma agência para marcas que levam a sério o crescimento orgânico. Não estamos aqui para vender dashboards e relatórios mensais. Estamos aqui para construir estratégias que realmente fazem a diferença, combinando o melhor do SEO clássico com o novo e empolgante mundo da Generative Engine Optimization (GEO) — garantindo que a tua marca apareça não só nos links azuis do Google, mas também dentro das respostas geradas por AI que o ChatGPT, o Perplexity e o Google AI Overviews entregam a milhões de pessoas todos os dias.
E como não consegui encontrar uma ferramenta que lidasse corretamente com esses dois mundos, construí uma eu mesmo — a SEOcrawl AI, uma plataforma enterprise de SEO intelligence que reúne rankings, auditorias técnicas, monitoramento de backlinks, saúde do crawl e tracking de visibilidade de marca em AI, tudo num só lugar. É a plataforma que sempre desejei que existisse.
Descubra mais conteúdos deste autor

Uma página de listagem de produtos (PLP) mostra uma categoria inteira de produtos de uma só vez. Saiba em que difere de uma PDP, o que a faz converter e como pôr as páginas de listagem indexadas sem a confusão da navegação facetada.
