Excluída pela etiqueta 'noindex': o que significa e como resolver
Abriu o Google Search Console, encontrou um conjunto de URLs assinalados como "Excluída pela etiqueta 'noindex'" e agora essas páginas estão invisíveis na pesquisa.
Se encontrou um conjunto de URLs com o estado "Excluída pela etiqueta 'noindex'" no Google Search Console, as suas páginas estão a ser mantidas fora do índice do Google de forma deliberada, e a solução costuma ser mais simples do que parece: encontre a diretiva, remova-a e peça ao Google para voltar a rastrear.
Este guia explica exatamente o que desencadeia este estado, como identificar a diretiva noindex responsável e os passos precisos para a remover nos principais CMS, para que as suas páginas voltem a posicionar-se. A mesma verificação corre automaticamente no Crawler da SEOcrawl AI, que deteta diretivas noindex em todo o site sem ter de verificar URL a URL.
O que significa "Excluída pela etiqueta 'noindex'" no Google Search Console?
O estado "Excluída pela etiqueta 'noindex'" significa que o Googlebot rastreou a sua página, encontrou uma diretiva noindex e respeitou-a, mantendo a página fora do índice do Google. A página não vai aparecer nos resultados da pesquisa enquanto essa diretiva se mantiver.
Onde aparece este estado na GSC
No antigo relatório de Cobertura (substituído pelo relatório de indexação de páginas em 2022), este estado aparecia em "Excluídas". No atual relatório de indexação de páginas (Indexação › Páginas), encontra-o em "Não indexadas", na tabela "Motivo pelo qual as páginas não estão indexadas", com o motivo "Excluída pela etiqueta 'noindex'". O Google agrupa todos os URLs afetados sob esta etiqueta para que os possa exportar e rever em bloco.
Como o Google deteta e respeita a diretiva noindex
A documentação do Google sobre como bloquear a indexação com noindex descreve duas formas de a aplicar: uma etiqueta <meta name="robots" content="noindex"> no <head> do HTML da página, ou uma diretiva X-Robots-Tag: noindex nos cabeçalhos de resposta HTTP. Quando o Googlebot encontra qualquer uma delas, remove a página do índice por completo, mesmo que já estivesse indexada. Para o essencial sobre a etiqueta em si, consulte o nosso guia da meta tag noindex.
É sempre um problema? Quando a exclusão é intencional
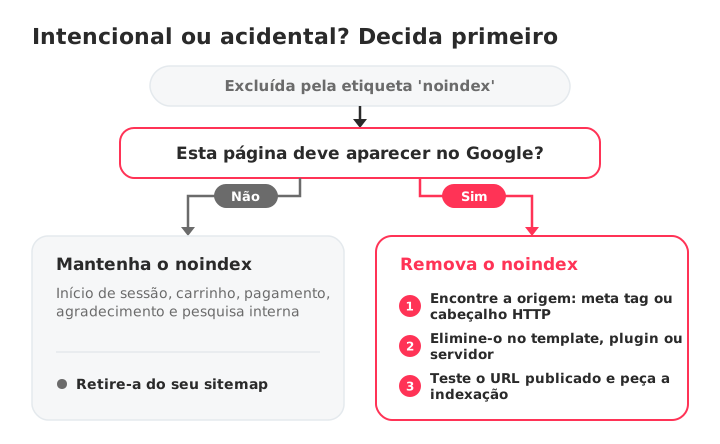
Nem todos os URLs com "Excluída pela etiqueta 'noindex'" são um erro. As páginas de administração, os ecrãs de início de sessão, o carrinho e o processo de pagamento, as páginas de agradecimento e os resultados da pesquisa interna são mantidos fora do índice do Google de propósito. Se essas páginas apresentam este estado, o sistema está a funcionar como previsto. O verdadeiro problema começa quando esta etiqueta aparece em páginas que quer posicionar.
Causas comuns do estado "Excluída pela etiqueta 'noindex'"
Uma diretiva noindex pode chegar à sua página por vários caminhos diferentes. Saber qual está ativo no seu site determina a solução.
Meta tag robots com "noindex" no <head>
É a origem mais comum. Uma linha como <meta name="robots" content="noindex"> no HTML da sua página diz ao Googlebot para não a indexar. Pode estar escrita diretamente no template ou ser inserida de forma dinâmica por um CMS, um plugin ou uma função do tema.
X-Robots-Tag nos cabeçalhos de resposta HTTP
O X-Robots-Tag funciona exatamente como a meta tag, mas está no cabeçalho de resposta HTTP e não no HTML. Pode ser adicionado por configurações do servidor, regras da CDN ou diretivas do .htaccess. Por exemplo:
Header set X-Robots-Tag "noindex"
Isto afeta todos os ficheiros abrangidos pela regra, incluindo PDFs e imagens que não têm uma secção <head> em HTML. Muitos proprietários de sites ignoram por completo este caminho, porque a diretiva não é visível no código-fonte da página.
Definições do CMS que bloqueiam a indexação por engano
O WordPress tem uma caixa de verificação em Definições › Leitura chamada "Desencorajar os motores de pesquisa de indexar este site". Quando está marcada, o WordPress adiciona uma etiqueta robots noindex a todas as páginas do site. Muitos proprietários ativam-na durante o desenvolvimento e esquecem-se de a desmarcar depois do lançamento.
A Shopify pode aplicar noindex através do código do tema ou de apps. Algumas páginas de conta e de sistema são mantidas fora do índice pela própria Shopify, o que está correto, mas uma alteração ao tema ou uma app de SEO pode adicionar noindex por engano a páginas de produto, de coleção ou do blog.
O Wix aplica noindex a qualquer página cujas definições de SEO impeçam os motores de pesquisa de a indexar. Um caso frequente é duplicar uma página e herdar, sem dar por isso, a definição noindex da original.
Conflitos de plugins ou temas que adicionam noindex
Os plugins de SEO permitem definir noindex por artigo, página ou tipo de conteúdo. Uma regra global mal configurada, uma atualização do plugin que repõe as definições ou um tema que sobrepõe as diretivas do plugin podem espalhar o noindex por dezenas de páginas de uma só vez. Se atualizou um plugin ou mudou de tema recentemente, verifique isto primeiro.
Definições do ambiente de staging publicadas em produção
Uma origem surpreendentemente comum de etiquetas noindex acidentais. O seu site de staging usa noindex para ficar fora do Google. Quando o pipeline de build leva a configuração de staging para produção, a diretiva noindex vai com ela. Normalmente afeta secções inteiras de um site ao mesmo tempo e é uma das causas mais difíceis de diagnosticar se só verificar páginas individuais.
Como diagnosticar que páginas são afetadas
Um processo de diagnóstico repetível apanha todos os URLs afetados sem adivinhar. Comece pela Search Console para obter a lista e, depois, desça ao nível de cada página para encontrar a origem.
Usar o relatório de indexação de páginas para exportar os URLs afetados
Abra o Google Search Console e vá a Indexação › Páginas. Clique em "Excluída pela etiqueta 'noindex'" na tabela "Motivo pelo qual as páginas não estão indexadas". A Search Console mostra uma amostra dos URLs afetados; use o botão Exportar para transferir a lista e trabalhá-la.
Inspecionar um único URL com a ferramenta de Inspeção de URL
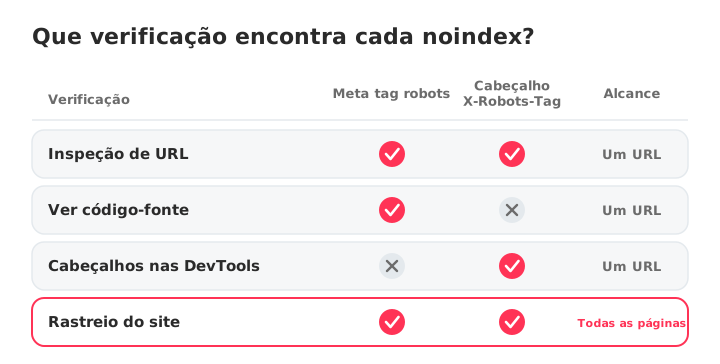
Cole qualquer URL na barra de pesquisa no topo da Search Console. A ferramenta de Inspeção de URL mostra se o Google viu uma diretiva noindex e onde a encontrou: em "Indexação permitida?", indica se o noindex veio da meta tag robots ou do cabeçalho HTTP X-Robots-Tag. Clique em Ver página rastreada para ver o HTML exato que o Googlebot recebeu. É a verificação de uma única página mais rápida que existe.
Verificar o código-fonte da página à procura de meta tags noindex
Abra a página no navegador, clique com o botão direito e selecione Ver código-fonte da página; depois pesquise "noindex" (Ctrl+F ou Cmd+F). Se encontrar <meta name="robots" content="noindex"> ou algo semelhante, a culpada é a meta tag. Se não aparecer no código-fonte, a diretiva pode estar a vir do cabeçalho HTTP.
Usar as DevTools do navegador para verificar os cabeçalhos HTTP
Abra as DevTools (F12, ou botão direito › Inspecionar), vá ao separador Rede, recarregue a página e clique no pedido do documento principal. Procure X-Robots-Tag: noindex na secção Cabeçalhos de resposta. É a única forma de detetar no navegador as diretivas noindex enviadas no cabeçalho que não aparecem no HTML.
Rastrear o seu site com o Screaming Frog ou a SEOcrawl AI
Para um diagnóstico de todo o site, um crawler apanha todas as páginas afetadas numa única passagem. O Screaming Frog SEO Spider consegue filtrar páginas por indexabilidade, tendo em conta meta tags e cabeçalhos. O Crawler da SEOcrawl AI rastreia todas as páginas, assinala cada uma que tenha uma diretiva noindex em Indexabilidade e devolve um Audit Health Score, para que veja o alcance total sem exportar e filtrar à mão.
Como resolver "Excluída pela etiqueta 'noindex'": passo a passo
Esta é a secção mais prática. Aplique a correção que corresponde ao diagnóstico da secção anterior.
Remover a meta tag noindex do código-fonte da página
Edite o template ou o conteúdo da página para remover <meta name="robots" content="noindex"> do <head> do HTML. Em sites desenvolvidos à medida, verifique diretamente os ficheiros de template. Se a etiqueta for inserida por JavaScript, encontre o script responsável e remova-o ou acrescente-lhe uma condição.
Antes:
<meta name="robots" content="noindex">
Depois:
<meta name="robots" content="index, follow">
Ou simplesmente remova a etiqueta por completo. O Google interpreta a ausência de uma diretiva noindex como "indexação permitida".
Corrigir o X-Robots-Tag na configuração do servidor ou da CDN
Verifique o seu .htaccess (Apache), o seu nginx.conf (Nginx) ou as regras da CDN à procura de diretivas X-Robots-Tag: noindex. Remova-as ou limite-as aos caminhos que devem mesmo ficar excluídos, em vez das páginas que quer indexar. Por exemplo, pode manter o noindex em /staging/ e removê-lo de /blog/.
Como resolver no WordPress
Duas verificações, por esta ordem:
- Definição global do site: vá a Definições › Leitura e desmarque "Desencorajar os motores de pesquisa de indexar este site". É a causa mais comum de problemas de noindex em todo o site no WordPress.
- Definições por página nos plugins de SEO:
- Yoast SEO: abra o artigo ou a página, desça até à caixa do Yoast, clique no separador Avançado e defina "Allow search engines to show this content in search results?" como "Sim".
- Rank Math: abra o artigo, vá à caixa do Rank Math, clique no separador Avançado e defina "Robots Meta" como "Index".
- All in One SEO: edite o artigo, abra o separador Avançado das definições do AIOSEO e confirme que "No Index" não está marcado nas definições de robots.
Verifique também as definições globais de cada plugin, caso haja tipos de conteúdo inteiros (etiquetas, categorias, tipos de artigo personalizados) definidos como noindex. Para o resto da configuração do WordPress, consulte o nosso guia para ligar o WordPress ao Google Search Console.
Como resolver na Shopify
Na Shopify, o noindex costuma vir do código do tema ou de uma app. Abra Loja online › Temas › Editar código e pesquise em theme.liquid e nos templates de página uma meta tag robots com noindex. Depois verifique as suas apps de SEO à procura de regras que ocultem produtos, coleções ou artigos do blog, bem como qualquer produto ou página que use o metacampo seo.hidden. As páginas de conta e outras páginas de sistema são mantidas fora do índice pela Shopify e devem continuar assim.
Como resolver no Wix, no Squarespace e noutros criadores de sites
Wix: abra as definições de SEO da página (a partir do menu da página) e ative "Let search engines index this page". Se duplicou uma página, a cópia pode ter herdado a definição noindex da original.
Squarespace: verifique as definições de SEO de todo o site à procura de alguma opção que o oculte dos motores de pesquisa. Para páginas individuais, abra as definições da página e procure "Hide page from search results" no separador SEO. O Squarespace também mantém algumas páginas de sistema, como o carrinho, fora dos resultados da pesquisa por predefinição.
Depois da correção: pedir a reindexação no Google Search Console
Remover a etiqueta noindex diz ao Google que pode indexar a página, mas continua a ser preciso que o Googlebot a volte a rastrear para confirmar a alteração.
Usar a ferramenta de Inspeção de URL para pedir a indexação
Cole o URL corrigido na barra de pesquisa da Search Console. Clique em Testar URL publicado para confirmar que a indexação já é permitida e, depois, clique em Pedir indexação. O Google coloca o URL na fila para novo rastreio. Pode submeter vários URLs desta forma, mas a Search Console limita o número de pedidos por dia.
Quanto tempo demora o Google a reindexar uma página?
Normalmente entre alguns dias e algumas semanas, consoante a frequência com que o Googlebot rastreia o seu site. Os sites com muito tráfego e atualizados com frequência são rastreados novamente mais depressa; os sites novos ou com pouco tráfego podem esperar semanas. Pedir a indexação é o sinal mais rápido que pode enviar, mas não é uma garantia: coloca o seu URL na fila de rastreio, não força um rastreio imediato.
Submeter um sitemap XML atualizado para acelerar o rastreio
Se corrigiu muitas páginas de uma vez, submeta um sitemap XML atualizado na secção Sitemaps da Search Console. Isto indica que o seu site mudou e incentiva um rastreio mais amplo. Um sitemap limpo, sem URLs com noindex, também evita enviar sinais contraditórios, como vemos a seguir.
Quando deve manter a etiqueta noindex (exclusões intencionais)
Nem todas as etiquetas noindex precisam de ser removidas. Algumas páginas nunca devem aparecer nos resultados da pesquisa, e indexá-las acrescenta páginas pobres ou duplicadas à visão que o Google tem do seu site e desperdiça atenção de rastreio.
Páginas que nunca devem ser indexadas
- Páginas de início de sessão e de registo
- Páginas de carrinho, pagamento e confirmação de encomenda
- Páginas de resultados da pesquisa interna (para evitar conteúdo duplicado)
- Páginas de agradecimento (lead magnets, envio de formulários)
- Páginas de administração e backend
- Ambientes de staging e de desenvolvimento
- Páginas de filtros e parâmetros que geram URLs duplicados
noindex ou robots.txt: principais diferenças
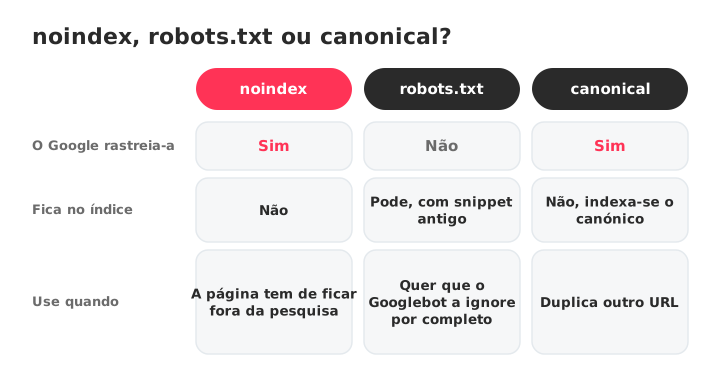
O robots.txt bloqueia o rastreio. O noindex permite o rastreio mas bloqueia a indexação. Se bloquear uma página no robots.txt, o Googlebot nunca a lê, o que significa que também nunca vê a etiqueta noindex. Se quer retirar uma página do índice, use noindex. Se quer que o Googlebot ignore a página por completo (para poupar orçamento de rastreio), use o robots.txt.
Um erro comum: usar o robots.txt para bloquear uma página que já está indexada. O Google não consegue ver a etiqueta noindex se não puder rastrear a página, pelo que o URL pode continuar no índice com um título e um snippet desatualizados. A abordagem correta é permitir o rastreio e usar noindex para retirar a página do índice.
Etiquetas canonical ou noindex: escolher a diretiva certa
Uma etiqueta canonical (rel="canonical") diz ao Google "esta página é uma cópia daquele outro URL, posiciona esse em vez desta". Uma etiqueta noindex diz ao Google "não indexes esta página de todo". Servem objetivos diferentes:
- Use canonical quando tiver conteúdo duplicado ou quase duplicado e quiser consolidar os sinais de posicionamento num único URL.
- Use noindex quando a página não deva aparecer nos resultados da pesquisa em circunstância alguma.
Combinar as duas na mesma página envia sinais contraditórios: uma diz "junta esta página a outro URL", a outra diz "descarta-a". Escolha a que corresponde ao que pretende.
Como evitar etiquetas noindex acidentais no futuro
Corrigir problemas de noindex quando surgem é necessário, mas preveni-los poupa horas de diagnóstico e tráfego perdido.
Configurar alertas da Search Console para quedas na indexação
O Google Search Console envia emails aos proprietários e utilizadores verificados quando deteta novos problemas de indexação numa propriedade. Confirme que as notificações por email estão ativadas nas preferências de email da Search Console. Se o número de páginas indexadas cair de repente, o alerta dá-lhe vantagem antes de o tráfego cair também.
Adicionar verificações de noindex à sua checklist de QA antes do lançamento
Antes de publicar qualquer site ou de passar o staging para produção, procure diretivas noindex. Uma verificação de 30 segundos com "Ver código-fonte da página" e uma pesquisa por "noindex" apanha o erro de publicação mais comum. Em sites maiores, rastreie antes e depois da publicação e compare o número de páginas com noindex. Acrescente-o à sua checklist de SEO técnico para que ninguém o salte.
Rastreios agendados para apanhar diretivas noindex indesejadas
Faça um rastreio completo de forma agendada, e depois de qualquer atualização de plugin, mudança de tema ou migração, para apanhar etiquetas noindex indesejadas antes que lhe custem tráfego. O Crawler da SEOcrawl AI permite comparar rastreios, para que veja que páginas passaram a noindex e quando, e o SEO Monitor avisa-o no momento em que uma das suas páginas-chave recebe uma etiqueta noindex.
Perguntas frequentes
O que significa "Excluída pela etiqueta 'noindex'" no Google Search Console?
Significa que o Google encontrou e respeitou uma diretiva noindex na sua página, pelo que a página não vai aparecer nos resultados da pesquisa. O estado aparece no relatório de indexação de páginas da Search Console, em "Não indexadas".
Nem sempre é um erro: as páginas que exclui intencionalmente, como as de início de sessão ou de pagamento, devem apresentar este estado.
Como resolvo "Excluída pela etiqueta 'noindex'" no WordPress?
Verifique dois sítios, por esta ordem. Primeiro, vá a Definições › Leitura e confirme que "Desencorajar os motores de pesquisa de indexar este site" está desmarcado. Depois, abra cada artigo ou página afetada no seu plugin de SEO (Yoast, Rank Math, All in One SEO) e confirme que a definição de robots da página permite a indexação.
Quanto tempo demora o Google a indexar uma página depois de remover o noindex?
Normalmente entre alguns dias e algumas semanas, consoante a frequência com que o Googlebot rastreia o seu site. Peça a indexação com a ferramenta de Inspeção de URL depois de remover a diretiva e submeta um sitemap XML atualizado para acelerar o processo. Os sites com muito tráfego são rastreados novamente mais depressa do que os sites novos ou com pouco tráfego.
Uma página pode ser excluída pelo noindex mesmo estando no meu sitemap?
Sim. A diretiva noindex sobrepõe-se à inclusão no sitemap. O Google pode continuar a rastrear o URL a partir do seu sitemap, mas não o indexa enquanto o noindex estiver presente.
Ou remove o noindex para que a página possa ser indexada, ou retira o URL do sitemap se a exclusão for intencional. Incluir URLs com noindex num sitemap envia sinais contraditórios.
Qual é a diferença entre noindex e bloquear uma página no robots.txt?
O robots.txt impede o Googlebot de rastrear a página; o noindex permite o rastreio mas impede a indexação. Se bloquear uma página com o robots.txt, o Google não consegue ler a etiqueta noindex, pelo que uma página já indexada pode continuar no índice com conteúdo desatualizado. Use o noindex para retirar uma página do índice e o robots.txt apenas quando quiser impedir totalmente o rastreio.
Como verifico se uma página tem uma etiqueta noindex?
Três métodos, do mais rápido ao mais completo: use a ferramenta de Inspeção de URL da Search Console, veja o código-fonte da página e pesquise "noindex" (Ctrl+F), ou verifique os cabeçalhos de resposta HTTP nas DevTools do seu navegador (separador Rede, procure X-Robots-Tag). Só a Inspeção de URL e as DevTools detetam um noindex enviado no cabeçalho.
Devo preocupar-me se muitas páginas apresentarem "Excluída pela etiqueta 'noindex'"?
Só se essas páginas devessem estar indexadas. Exporte a lista a partir da Search Console, compare-a com as suas exclusões intencionais (início de sessão, carrinho, administração, páginas de agradecimento) e corrija apenas as páginas que devem posicionar-se na pesquisa. Se todas as páginas afetadas forem exclusões deliberadas, o estado está a funcionar corretamente.
Autor: David Kaufmann

Passei os últimos 10 e tantos anos completamente obcecado por SEO — e, sinceramente, não quereria que fosse de outra forma.
A minha carreira atingiu um novo patamar quando trabalhei como Senior SEO Specialist na Chess.com — um dos 100 sites mais visitados de toda a internet. Operar nessa escala, em milhões de páginas, dezenas de idiomas e numa das SERPs mais competitivas que existem, ensinou-me coisas que nenhum curso ou certificação jamais poderia. Essa experiência mudou a minha perspetiva sobre o que é realmente um grande trabalho de SEO — e tornou-se a base de tudo o que construí desde então.
Foi a partir dessa experiência que fundei a SEO Alive — uma agência para marcas que levam a sério o crescimento orgânico. Não estamos aqui para vender dashboards e relatórios mensais. Estamos aqui para construir estratégias que realmente fazem a diferença, combinando o melhor do SEO clássico com o novo e empolgante mundo da Generative Engine Optimization (GEO) — garantindo que a tua marca apareça não só nos links azuis do Google, mas também dentro das respostas geradas por AI que o ChatGPT, o Perplexity e o Google AI Overviews entregam a milhões de pessoas todos os dias.
E como não consegui encontrar uma ferramenta que lidasse corretamente com esses dois mundos, construí uma eu mesmo — a SEOcrawl AI, uma plataforma enterprise de SEO intelligence que reúne rankings, auditorias técnicas, monitoramento de backlinks, saúde do crawl e tracking de visibilidade de marca em AI, tudo num só lugar. É a plataforma que sempre desejei que existisse.
Descubra mais conteúdos deste autor