


«Discovered – currently not indexed»: что это значит и как исправить
Google знает, что ваш URL существует, но ещё не заходил на него. Вот как понять, ждать или действовать, и какие исправления пробовать в первую очередь на небольшом и на крупном сайте.
Discovered – currently not indexed означает, что Google нашёл URL, но ещё не просканировал его. Так это описывает справка по отчёту об индексировании страниц от Google. Обычно Google собирался сканировать и перенёс это, чтобы не перегружать ваш сайт, поэтому в отчёте дата последнего сканирования пуста.
Это статус приоритета сканирования, а не вердикт о вашем контенте, потому что Google страницу ещё не читал. Ниже вы увидите, чем он отличается от «Crawled», что мы обнаружили, проверив собственный сайт, и список исправлений, упорядоченный по размеру сайта. Только начинаете работать с отчётом? Начните с этого руководства по Google Search Console.
Что значит «Discovered – currently not indexed»
Google проводит URL через четыре шага: находит, сканирует, индексирует и только затем может показать в результатах. Два статуса Search Console описывают URL, застрявший по дороге.
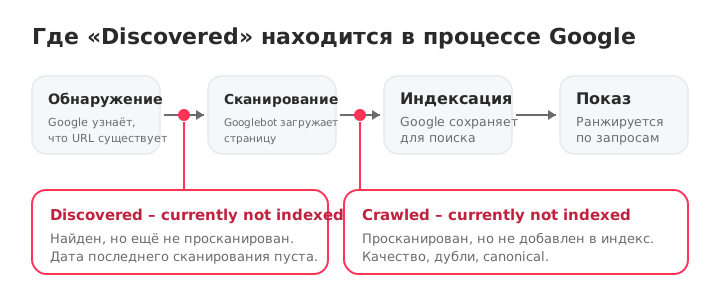
URL попадает в «найден» через sitemap или по ссылкам с других страниц. Затем Google решает, когда его сканировать. «Discovered» означает, что это решение ещё не принято.
Чем отличается от «Crawled – currently not indexed»
Эти два статуса выглядят похоже, а исправлений требуют разных.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Сканировал ли Google? | Нет | Да |
| Дата последнего сканирования | Пусто | Есть дата |
| Читал ли Google страницу? | Нет | Да |
| Обычная причина | Сканирование отложено или низкий приоритет | Google прочитал страницу и отложил её в сторону |
| Что смотреть в первую очередь | Внутренние ссылки, sitemap, ёмкость сканирования | Качество контента, дубликаты, canonical |
Полная диагностика второго статуса есть в руководстве по Crawled – currently not indexed.
Как выглядит список на реальном сайте
Мы проверили seocrawl.ai в отчёте об индексации SEOcrawl. Из 1000 URL, которые отслеживает SEOcrawl (наш sitemap заявляет 6310), 823 проиндексированы, то есть 82,3 %. 128 находятся в «Crawled – currently not indexed» и 14 — в «Discovered – currently not indexed».
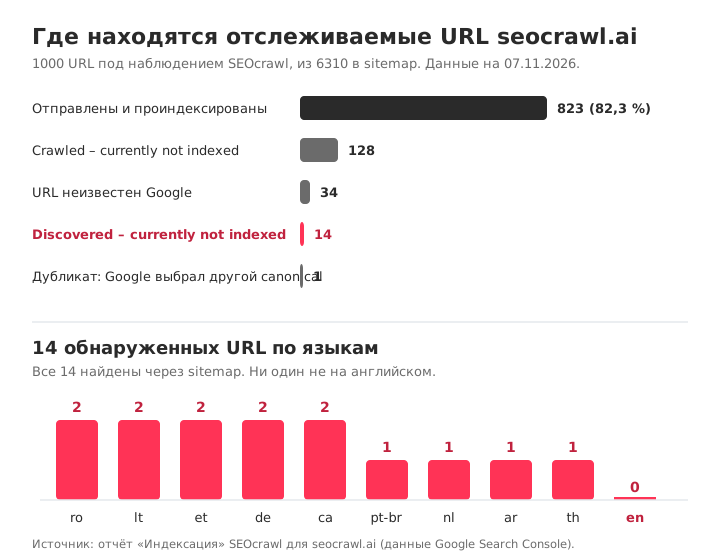
Полезна именно общая черта этих 14:
- Все они — переведённые страницы: арабский, каталанский, немецкий, эстонский, литовский, нидерландский, бразильский португальский, румынский и тайский. Ни одной на английском.
- Google нашёл все 14 через sitemap, а не по ссылке с другой страницы.
- У одной из них указана более ранняя дата сканирования (9 мая 2026), поэтому статус описывает, где URL находится сейчас, а не то, что Google никогда его не посещал.
Это закономерность, которую нужно проверить, а не диагноз. Страница, существующая на 26 языках и достижимая в основном через sitemap, — естественный кандидат на слабые внутренние ссылки, поэтому внутренние ссылки — первое, на что стоит посмотреть. Урок подходит любому сайту: не читайте список URL за URL. Сгруппированные по языкам, 14 URL стали одним вопросом.
Цифры охватывают 1000 URL, которые отслеживает SEOcrawl, то есть выборку из всего sitemap. Более крупная группа из 128 URL — это другой статус, и у неё есть своё руководство.
Почему Google откладывает сканирование
Руководство по краулинговому бюджету от Google объясняет, как он решает, сколько сканировать: предел ёмкости, который выдерживает ваш сервер, и спрос на ваши URL. Большинство обнаруженных URL сводятся к одной из этих пяти причин.
- Ёмкость сканирования. Google сообщает, что предел снижается, когда сайт замедляется или отдаёт ошибки сервера. Медленный сервер — меньше сканирований.
- Низкий спрос на сканирование. Спрос зависит от размера сайта, частоты обновлений, качества и актуальности страниц. URL с малым числом внутренних ссылок или совсем без них даёт Google мало поводов скоро вернуться.
- Напрасное сканирование. Дублирующиеся URL, параметры, фасеты, длинные цепочки редиректов и soft 404 конкурируют с вашими настоящими страницами. Google отмечает, что soft 404 продолжают сканироваться и тратят бюджет, а страницу с noindex он всё равно запрашивает, прежде чем отказаться от неё.
- Найден только через sitemap. Sitemap сообщает Google, что URL существует. Приоритетным он его не делает, а Google воспринимает sitemap как подсказку. Страницы, найденные только там, ждут первыми.
- Новый сайт или раздел. Любой сайт начинает с одного и того же осторожного предела ёмкости по умолчанию, который растёт по мере того, как сайт доказывает свою исправность.
Сам краулинговый бюджет заслуживает вашего внимания только на очень крупных сайтах. Грубая оценка Google: 1 000 000+ уникальных страниц, обновляемых примерно раз в неделю, или 10 000+ страниц, меняющихся ежедневно. На небольших сайтах причины 2 и 4 встречаются гораздо чаще.
Это проблема? Три вопроса, прежде чем что-то исправлять
- Должен ли этот URL вообще индексироваться? Если это отфильтрованное представление, страница внутреннего поиска или тестовый URL, его отсутствие в индексе нормально. Чтобы зафиксировать это явно, примените noindex или верните 404 или 410 (см. Excluded by 'noindex' tag).
- Сколько URL и по какой закономерности? Google говорит, что при менее чем 500 страницах этот отчёт вам, скорее всего, даже не нужен. Список также ограничен 1000 строками, поэтому на крупном сайте это выборка.
- Они новые? URL, опубликованный на прошлой неделе, ещё не проблема. Временные рамки самого Google приведены в таблице ниже.
Как исправлять в зависимости от размера сайта
Верный первый шаг зависит от размера вашего сайта, поэтому начните с подходящей колонки.
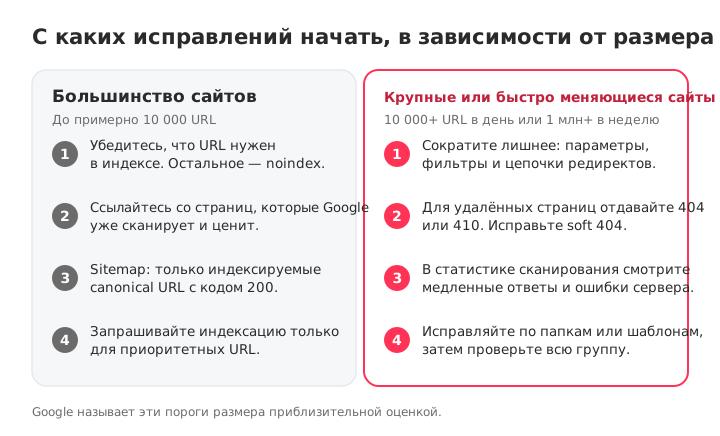
Большинство сайтов: до примерно 10 000 URL
- Убедитесь, что URL заслуживает индексации. Если нет — примените noindex или удалите его и вычеркните из списка.
- Ставьте ссылки со страниц, которые Google уже сканирует. Добавьте контекстные ссылки с описательным анкором со страниц, которые уже в индексе и получают трафик. Любой краулер покажет ваши страницы-сироты, если отфильтровать страницы без внутренних ссылок, а в этом руководстве по внутренним ссылкам описан весь метод.
- Держите sitemap чистым. Включайте только URL, которые отдают 200, индексируются и являются canonical-версией, с точным
lastmod. Google игнорирует priority и changefreq. Если сначала нужен сам файл, найдите свой sitemap. Если Search Console пишет, что не находит ни одного, см. No referring sitemaps detected. - Запросите индексацию для нескольких приоритетных URL. Откройте инструмент проверки URL и нажмите Запросить индексирование. Google применяет квоту и сообщает, что повторные запросы ничего не ускоряют, поэтому приберегите это для самых важных страниц.
Крупные или быстро меняющиеся сайты: 10 000+ URL меняется в день или 1 млн+ в неделю
- Сократите напрасное сканирование. Закройте в robots.txt пространства URL без поисковой ценности (параметры, фасеты, внутренний поиск) и объединяйте дубликаты через canonical и редиректы 301. Не рассчитывайте, что noindex сэкономит бюджет: Google продолжает запрашивать эти страницы.
- Для удалённых страниц возвращайте 404 или 410 и исправляйте soft 404. Google называет 404 сильным сигналом больше не сканировать URL, тогда как заблокированные URL остаются в очереди дольше. Сократите любую длинную цепочку редиректов.
- Проверьте статистику сканирования. В Настройках отчёт «Статистика сканирования» показывает время ответа и ошибки сервера. Если они высокие, Google снижает ваш предел ёмкости, и никакие правки контента не помогут, пока сервер не станет лучше.
- Исправляйте по папкам или шаблонам, затем проверяйте группу. Принимайте одно решение на закономерность, создайте sitemap только с исправленными URL и нажмите Проверить исправление. Подробнее о краулинговом бюджете, если ваш сайт относится к этой категории.
Ждать или действовать?
Труднее всего не исправление, а понимание, когда пора перестать ждать. Используйте собственные диапазоны Google и свою динамику.
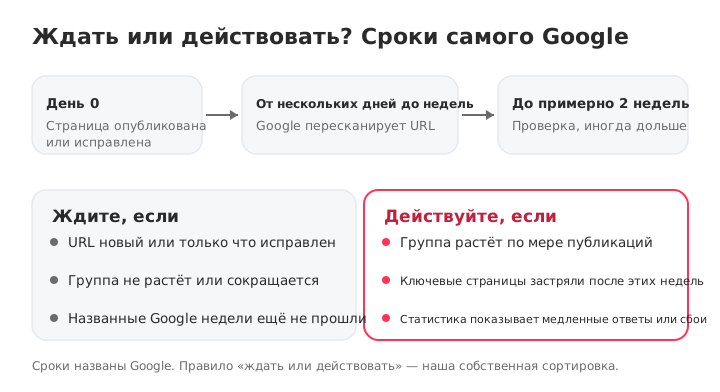
| Что вы сделали | Что говорит Google | Источник |
|---|---|---|
| Попросили Google пересканировать | От нескольких дней до нескольких недель | Запрос на повторное сканирование |
| Запросили индексацию | Обычно около суток, до одной-двух недель, с дневной квотой | Справка по проверке URL |
| Проверили исправление | До примерно двух недель, иногда гораздо дольше | Справка по индексированию страниц |
Временные диапазоны принадлежат Google. Правило «ждать или действовать» — наше: ждите, пока URL новый, а группа стабильна или уменьшается, и действуйте, когда группа продолжает расти или ваши ключевые страницы остаются застрявшими после этих недель.
Как отслеживать со временем
Search Console показывает последнее состояние каждого URL и список, ограниченный 1000 строками, поэтому выстройте собственную рутину:
- Раз в месяц экспортируйте список и сравнивайте с предыдущим. Группа растёт, стабильна или уменьшается?
- Группируйте по закономерности (язык, папка, шаблон), прежде чем смотреть на отдельные URL.
- Смотрите, как Google нашёл каждый URL. Список, где везде «sitemap» и нигде «страница-источник», как у наших 14 URL, прямо указывает на внутренние ссылки.
Представление Индексация в SEOcrawl AI даёт этот список готовым: фильтруйте по состоянию покрытия, чтобы увидеть URL в нём, с датой последнего сканирования, кликами и показами. Через MCP каждый URL приходит также с canonical, выбранным Google, в сравнении с заявленным, и с указанием, найден ли он через sitemap или страницу-источник. Crawler проводит аудит ваших собственных страниц, поэтому вы видите, что слабо в URL, прежде чем просить Google взглянуть ещё раз, а SEO Monitor предупреждает, когда ключевая страница получает noindex, меняет canonical, отдаёт 404 или пропадает из sitemap.
Вот этот список для нашего собственного сайта прямо из представления «Индексация»:
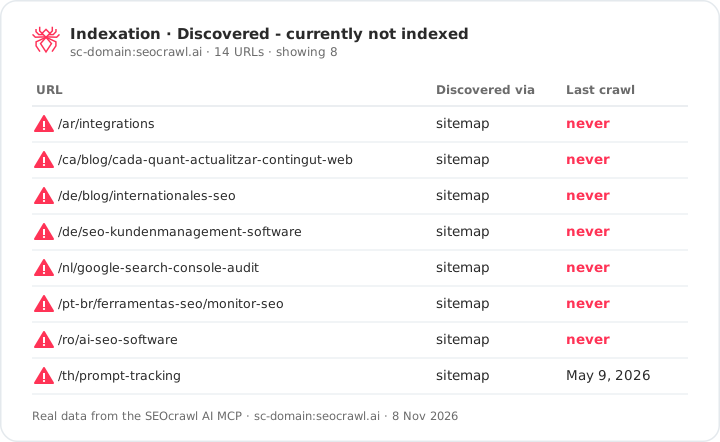
Можно обойтись и без панели. С MCP SEOcrawl AI, подключённым к Claude или ChatGPT, спросите: «Покажи URL в статусе Discovered – currently not indexed и сгруппируй их по папкам.» Вот пошаговая инструкция по подключению Search Console к Claude и ChatGPT.
Часто задаваемые вопросы
Что значит «Discovered – currently not indexed»?
Это значит, что Google нашёл ваш URL, но ещё не просканировал его. Обычно Google собирался сканировать и отложил это, поэтому дата последнего сканирования пуста (справка по индексированию страниц). Google страницу не читал, так что статус ничего не говорит о её качестве. Это не штраф.
Сколько длится «Discovered – currently not indexed»?
Google не публикует срока для этого статуса. Он сообщает, что запрошенное повторное сканирование занимает от нескольких дней до нескольких недель, а проверка исправления — примерно до двух недель, иногда гораздо дольше. Новому URL эти недели могут просто понадобиться. Если группа продолжает расти по мере ваших публикаций, перестаньте ждать и действуйте.
Решит ли проблему запрос индексации?
Он может помочь для нескольких приоритетных URL, потому что просит Google поставить страницу в очередь. Он не устраняет причину, поэтому страница может вернуться в тот же статус. Запросы подчиняются дневной квоте, а Google сообщает, что повторная отправка одного и того же URL ничего не ускоряет. Используйте его после улучшения внутренних ссылок, но никогда как массовый инструмент.
Это штраф?
Нет. Ручные меры отображаются в отдельном отчёте. Этот статус означает, что Google нашёл URL и ещё не сканировал его, то есть страница не оценивалась. Причина обычно в приоритете сканирования: слабые внутренние ссылки, медленный сервер или множество малоценных URL, конкурирующих за сканирование.
Почему так много моих страниц обнаружены, но не проиндексированы?
Большое число обычно указывает на закономерность, а не на отдельные страницы: параметры URL или фасеты, дубликаты, sitemap с URL, которым там не место, слабые внутренние ссылки на целый раздел или сервер, который замедляет Googlebot. Сгруппируйте URL по папкам, языкам или шаблонам, прежде чем смотреть на любой из них отдельно.
Стоит ли беспокоиться на небольшом сайте?
Обычно нет. Google говорит, что если на вашем сайте менее 500 страниц, отчёт об индексировании страниц вам, скорее всего, даже не нужен. Нескольким новым URL в этом статусе чаще всего нужны время и пара внутренних ссылок со страниц, которые Google уже сканирует.
Чем SEOcrawl AI поможет с обнаруженными URL?
Представление Индексация в SEOcrawl AI перечисляет URL, застрявшие в каждом состоянии покрытия Google, с датой последнего сканирования, кликами и показами. Через MCP SEOcrawl AI вы также можете попросить Claude или ChatGPT выдать этот список с canonical Google в сравнении с заявленным и с указанием, нашёл ли Google каждый URL через sitemap или страницу-источник, сгруппированный по папкам.
Больше SEOcrawl AI в Google
Выберите нас предпочтительным источником, и вы будете чаще видеть наши статьи в главных новостях Google.
Автор: David Kaufmann
Последние 10 с лишним лет я полностью одержим SEO — и, честно говоря, не хотел бы иначе.
Моя карьера вышла на новый уровень, когда я работал старшим SEO-специалистом в Chess.com — одном из ста самых посещаемых сайтов интернета. Работа в таком масштабе: миллионы страниц, десятки языков и одна из самых конкурентных выдач — научила меня тому, чему не научит ни один курс и ни один сертификат. Этот опыт изменил моё представление о том, как выглядит по-настоящему сильное SEO, и лёг в основу всего, что я построил потом.
Из него выросло SEO Alive — агентство для брендов, которые всерьёз занимаются органическим ростом. Мы не продаём дашборды и ежемесячные отчёты. Мы строим стратегии, которые реально двигают цифры, соединяя классическое SEO с новым и захватывающим миром Generative Engine Optimization (GEO): чтобы ваш бренд появлялся не только в синих ссылках Google, но и внутри ответов, которые ChatGPT, Perplexity и Google AI Overviews каждый день выдают миллионам людей.
А поскольку инструмента, который нормально закрывает оба этих мира, я так и не нашёл, я сделал его сам — SEOcrawl AI, платформу SEO-аналитики корпоративного уровня, где в одном месте собраны позиции, технические аудиты, мониторинг ссылок, здоровье краулинга и отслеживание видимости бренда в AI. Это та платформа, которой мне всегда не хватало.
Откройте больше материалов этого автора
Мы измерили клики из Google и переходы из ИИ на 16 000+ сайтах в 15 отраслях. Трафик из ИИ растёт на 45% в год, но по-прежнему составляет около 1 визита на каждые 100 из Google, а клики из Google за это время сократились на 15%.

До 30 ноября первый год любого годового тарифа SEOcrawl AI стоит вдвое дешевле с кодом BLACKFRIDAY2026. Что вы получаете, что покрывают промпты каждого тарифа и как за 15 минут увидеть, где вас упоминают ChatGPT, Gemini, Claude и Perplexity.