Crawled – currently not indexed: что это значит и как исправить

Google зашёл на ваш URL, прочитал страницу и не включил её в поиск. Рассказываем, как понять, какие страницы заслуживают второго шанса, и как, по словам Google, вернуть их в индекс.
Crawled – currently not indexed (страница просканирована, но пока не проиндексирована) означает, что Googlebot загрузил вашу страницу и решил не добавлять её в индекс Google, поэтому она не может появиться в поиске. Справка по отчёту об индексировании страниц формулирует это так: страница просканирована, но не проиндексирована, и она «может быть проиндексирована в будущем, а может и нет».
Причина обычно в самой странице, а не в технической блокировке. Ниже вы узнаете, как для каждого URL решить, нужно ли страницу исправить, закрыть noindex или удалить, и сколько, по словам Google, занимает исправление. Только начинаете работать с отчётом? Начните с этого руководства по Google Search Console.
Что означает «Crawled – currently not indexed»?
Статус означает, что Google просканировал страницу и решил её не индексировать. Ничто не блокировало Googlebot: Google решил пока не включать страницу. Два различия помогут правильно понять этот статус.
Сканирование и индексирование
Сканирование — это загрузка страницы роботом Googlebot. Индексирование — это сохранение страницы в Google, чтобы она могла показываться в поиске. Страницу можно сканировать много раз, и она всё равно никогда не попадёт в индекс.
Справка по инструменту проверки URL говорит, что качество страницы должно быть «достаточно высоким, чтобы оправдать индексирование», а проверка в реальном времени вообще не может выявить этот статус.
Чем он отличается от «Discovered – currently not indexed»
Discovered – currently not indexed (страница обнаружена, но пока не проиндексирована) — это шаг раньше: Google нашёл URL, но отложил сканирование, чтобы не перегружать ваш сайт, поэтому дата последнего сканирования пустая.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Сканировал ли Google? | Нет | Да |
| Дата последнего сканирования | Пустая | Указана |
| Обычная причина | Сканирование отложено, чтобы не перегружать сайт | Google прочитал страницу и пропустил её |
| Что проверять первым | Возможности сканирования очень крупных сайтов | Качество контента, дубли, canonical |
Google также говорит: «То, что страница не проиндексирована, не обязательно плохо». Страницы с noindex, URL, заблокированные в robots.txt, дубли и 404 без замены и должны оставаться вне индекса.
Почему Google сканирует страницы, но не индексирует их
У индексирования есть планка качества, которой нет у сканирования. Руководство Google по краулинговому бюджету говорит, что потребность в сканировании растёт вместе с ценностью и уникальностью вашего контента.
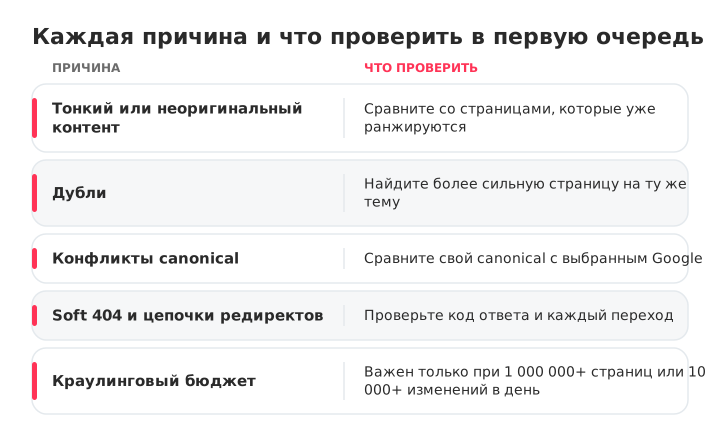
Большинство затронутых URL подпадает под одну из этих причин, и у каждой своя первая проверка:
- Тонкий или неоригинальный контент: страница повторяет то, что уже ранжируется.
- Дубли: архивы тегов, URL с сортировкой, две статьи на одну тему. Вот как найти и устранить каннибализацию ключевых слов.
- Конфликты canonical: сравните заявленный канонический URL с тем, который выбрал Google. Когда Google выбирает другой URL, страница обычно переходит в статус Alternate page with proper canonical tag или в один из статусов дублей.
- Soft 404 и цепочки редиректов: Google говорит, что soft 404 расходуют краулинговый бюджет.
- Краулинговый бюджет: он важен для сайтов с 1 000 000+ страниц, которые меняются еженедельно, или с 10 000+ страниц, которые меняются ежедневно. Для большинства сайтов причина не в нём.
Планка поднималась в два этапа. 18 августа 2022 года Google объявил о helpful content update — сигнале на уровне всего сайта — и сказал, что удаление бесполезного контента может помочь остальным страницам сайта. 5 марта 2024 года Google объявил о core update, который должен показывать меньше контента, созданного ради кликов, вместе с новой политикой против спама в виде массово создаваемого контента.
Рекомендации Google о полезном контенте говорят, что E-E-A-T не является отдельным фактором ранжирования, что важнее всего достоверность и что предпочтительного количества слов нет. Раздувание текста страницу не исправит.
Как найти и диагностировать затронутые страницы в GSC
Откройте отчёт «Индексирование страниц» (раньше — отчёт «Покрытие»), проверьте выборку и сгруппируйте список по закономерностям. Google отмечает, что сайтам меньше 500 страниц этот отчёт, скорее всего, не нужен.
Поиск затронутых URL в отчёте «Страницы»
- В Google Search Console перейдите в раздел Индексирование › Страницы.
- В таблице «Почему эти страницы не индексируются» нажмите Crawled – currently not indexed.
- Нажмите Экспортировать и скачайте список.
Отчёт показывает до 1000 примеров URL, не обязательно все, поэтому на крупном сайте экспорт — это выборка.
Проверка страниц инструментом проверки URL
Проверьте пять–десять экспортированных URL: посмотрите дату последнего сканирования и канонический URL, выбранный Google. Если канонический URL указывает на другую страницу, Google видит дубль; дата сканирования многомесячной давности говорит о том, что Google возвращается редко.
Поиск закономерностей среди сотен URL
Отсортируйте экспорт по папке, шаблону и параметру URL, затем посчитайте каждую группу. Допустим, 300 URL делятся на 180 страниц /tag/, 70 URL с ?sort= и 50 статей: это три решения, а не 300.
Исправить, закрыть noindex или удалить: решите, чего заслуживает каждый URL
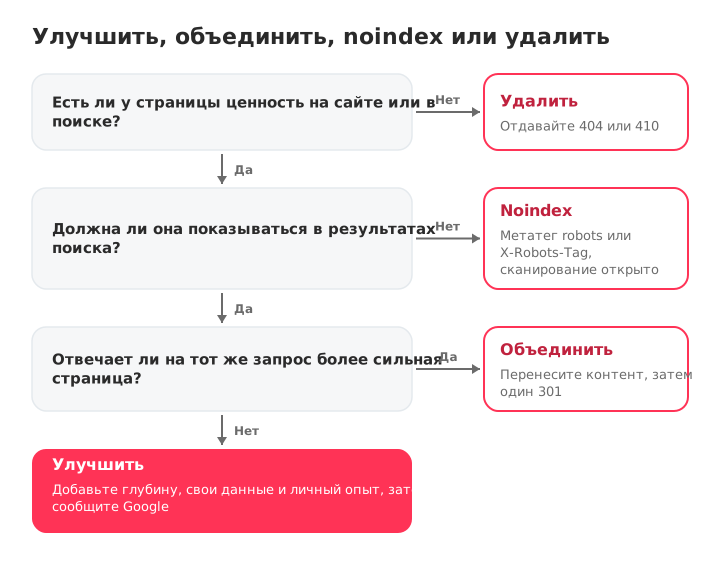
У каждого URL должен быть один из четырёх исходов. Спросите себя: будет ли пользователь рад попасть сюда и единственная ли это страница на сайте, которая отвечает на запрос?
| Тип страницы | Пример | Решение | Как |
|---|---|---|---|
| Полезная и уникальная, но тонкая | Руководство на 300 слов по теме, в которой вы разбираетесь | Улучшить | Добавьте глубину и личный опыт |
| Дублирует более сильную страницу | Две статьи под один запрос | Объединить | Перенесите контент, затем 301-редирект |
| Полезна на сайте, но не в поиске | Архивы тегов, внутренний поиск, страницы благодарности | Noindex | Метатег robots или X-Robots-Tag |
| Без ценности и без замены | Истёкшие акции, тестовые страницы | Удалить | Отдавайте 404 или 410 |
Руководство Google по краулинговому бюджету подтверждает две последние строки: для удалённых страниц отдавайте 404 или 410 и объединяйте дубли. Ошибка 404 в Search Console ожидаема для страниц, которые вы удалили намеренно.
Именно с noindex сортировка чаще всего идёт не так:
Не так: тег noindex на страницах /tag/, в то время как robots.txt блокирует /tag/. Googlebot не может загрузить страницы и поэтому никогда не увидит тег.
А так: /tag/ остаётся доступным для сканирования и содержит noindex в метатеге или в заголовке X-Robots-Tag.
Согласно документации Google по noindex, это правило не работает внутри robots.txt, а на редко посещаемых страницах повторное сканирование может занять месяцы. Как только тег будет прочитан, эти URL перейдут в статус Excluded by 'noindex' tag, и для них это именно то, что нужно.
Как исправить страницы, достойные индексации
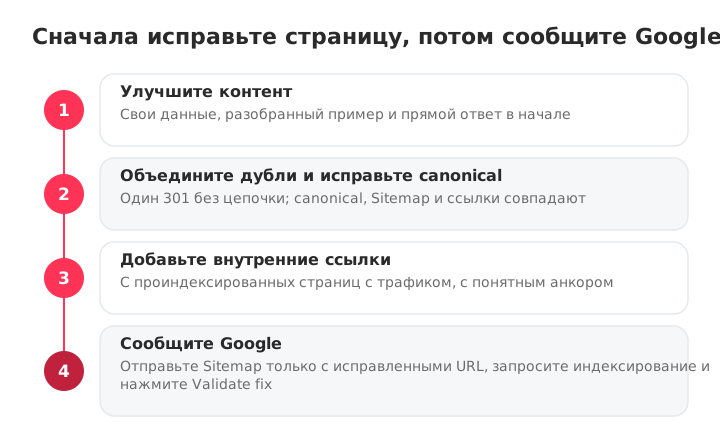
Сначала сделайте страницу достойной индексации, затем сообщите об этом Google. Запрос индексирования неизменённой страницы просит Google повторить решение, которое он уже принял. Порядок:
- Улучшите контент.
- Объедините дубли и исправьте canonical.
- Добавьте внутренние ссылки.
- Отправьте отдельный файл Sitemap и запросите индексирование.
Сделайте контент глубже и оригинальнее
Переписывайте под запрос, а не под количество слов: добавьте собственные данные, скриншоты, разобранный пример и прямой ответ в начале.
Например, возьмите тонкое руководство на 300 слов: добавьте собственный набор данных и разобранный пример, поставьте на него ссылки из двух статей, у которых уже есть трафик, и только после этого добавьте его в отдельный Sitemap.
Объедините дубли и исправьте canonical
Если два URL посвящены одному и тому же, оставьте один, перенесите в него полезный контент и настройте с другого 301-редирект прямо на него, без цепочки. Затем убедитесь, что canonical, Sitemap и внутренние ссылки согласованы и что нигде не остался случайный noindex.
Добавьте внутренние ссылки со страниц, которые Google уже ценит
Поставьте ссылку на каждую исправленную страницу с проиндексированных страниц с трафиком, используя описательный анкор. Любой краулер сайта покажет страницы-сироты (без внутренних ссылок), если отфильтровать страницы с нулём входящих ссылок. Полная методика — в руководстве по стратегии внутренней перелинковки.
Также проверьте страницу на телефоне и в отчёте «Основные интернет-показатели»: сломанную мобильную версию легко быстро исключить.
Отправьте отдельный Sitemap и запросите индексирование
Создайте файл Sitemap только с исправленными URL, отправьте его и отфильтруйте по нему отчёт «Страницы», прежде чем нажать Validate fix. Google рекомендует так делать, чтобы ускорить проверку. Если сначала нужен текущий файл, найдите Sitemap своего сайта.
Google игнорирует priority и changefreq, поэтому лучше следите за точностью lastmod. Затем нажмите Запросить индексирование в инструменте проверки URL для приоритетных URL: Google применяет квоту и отмечает, что повторные запросы ничего не ускоряют.
Сколько занимает индексирование после исправления?
Рассчитывайте на срок от дня до нескольких недель, и индексирование никогда не гарантировано. Google называет разные сроки на разных страницах, поэтому сведём их вместе:
| Что вы сделали | Что говорит Google | Источник |
|---|---|---|
| Попросили Google повторно просканировать | От нескольких дней до нескольких недель | Как запросить повторное сканирование |
| Запросить индексирование | Обычно около суток, до одной-двух недель, с дневным лимитом | Справка по проверке URL |
| Validate fix | До двух недель, иногда гораздо дольше | Справка по индексированию страниц |
Это сроки Google, а не кейсы восстановления. Проверяйте отчёт «Страницы» раз в неделю; если по истечении этих сроков исправленные URL не сдвинулись, возвращайтесь к контенту.
Как не допустить, чтобы новые страницы попадали в этот статус
Профилактика — это рутина: проверяйте каждую страницу перед публикацией и раз в месяц просматривайте Search Console. Перед публикацией убедитесь, что страница:
- Отвечает на запрос, на который не отвечает ни одна другая страница сайта.
- Содержит ваши собственные данные, примеры или опыт.
- Имеет canonical, указывающий на себя, и не содержит случайного noindex.
- Есть в Sitemap с точным lastmod.
- Имеет указанного автора и, где это уместно, структурированные данные.
- Получает ссылку со связанной проиндексированной страницы.
Раз в месяц сравнивайте отчёт «Страницы» с прошлым месяцем; проблема остаётся в списке 90 дней после исчезновения последнего случая. Сайтам больше тысячи страниц стоит также следить за отчётом «Статистика сканирования».
SEOcrawl AI берёт на себя техническую сторону в масштабе. Crawler сканирует каждую страницу и выдаёт Audit Health Score с проблемами, разбитыми по категориям Indexability, Crawlability, On-Page и другим. Его представление Indexation группирует ваши URL по статусу покрытия в Search Console, так что вы видите, сколько из них находится в статусе «Crawled – currently not indexed», и можете отслеживать это число во времени.
Между сканированиями SEO Monitor предупреждает вас, когда важная страница получает noindex, меняет canonical, отдаёт 404 или выпадает из Sitemap. Та же платформа отслеживает видимость вашего бренда в ChatGPT, Claude, Gemini, Perplexity и Copilot, так что SEO и GEO собраны в одном месте.
Частые вопросы
Что означает статус «Crawled – currently not indexed»?
Это значит, что Googlebot загрузил вашу страницу и решил не добавлять её в индекс Google, поэтому она не может появиться в поиске. Сканированию ничто не мешало: Google прочитал страницу и пока решил её не включать. Это не ручная санкция, и страница может быть проиндексирована в будущем, а может и нет.
Это то же самое, что «Discovered – currently not indexed»?
Нет. «Discovered» означает, что Google знает URL, но отложил сканирование, поэтому дата последнего сканирования пустая. «Crawled» означает, что Google уже посетил и прочитал страницу, а затем решил её не индексировать. В случае Discovered смотрите на возможности сканирования очень крупных сайтов; в случае Crawled — на качество контента, дубли и canonical.
Вредит ли статус «Crawled – currently not indexed» SEO?
Сам по себе нет: статус не является санкцией, и затронутая страница теряет только собственный поисковый трафик. Риск в объёме, потому что Google воспринимает большую долю бесполезного контента как сигнал на уровне всего сайта. Архив тегов вне индекса ничего не стоит; страница товара — стоит. Если число таких страниц растёт с каждой публикацией, считайте это проблемой контента всего сайта, а не списком отдельных URL.
Сколько времени нужно, чтобы страница проиндексировалась после исправления?
Рассчитывайте на срок от одного дня до нескольких недель, и индексирование никогда не гарантировано. По словам Google, повторное сканирование занимает от нескольких дней до нескольких недель, запрос индексирования обычно обрабатывается примерно за сутки, но может занять неделю-две, а Validate fix обычно длится до двух недель.
Поможет ли запрос индексирования?
Только после того, как вы измените страницу. Запрос индексирования неизменённой страницы просит Google повторить решение, которое он уже принял. Для запросов действует дневная квота, а Google отмечает, что повторная отправка одного и того же URL ничего не ускоряет.
Поможет ли добавление страницы в XML-файл Sitemap?
Это помогает Google найти URL, но не проиндексировать его. Google называет отправленный файл Sitemap «всего лишь подсказкой», а эти страницы уже найдены и прочитаны. После исправления задача Sitemap — собрать в группу URL, которые вы хотите отправить на повторную проверку. Один файл Sitemap вмещает до 50 000 URL или 50 МБ.
Почему проверка исправления статуса «Crawled – currently not indexed» не прошла?
Проверка останавливается, как только Google находит в группе хотя бы один неисправленный URL, поэтому одна забытая страница может провалить весь пакет. Исправьте все URL в группе или сузьте группу, отфильтровав отчёт по файлу Sitemap только с исправленными URL, и запустите проверку снова.
Как SEOcrawl AI помогает со страницами, которые Google сканирует, но не индексирует?
SEOcrawl AI находит причины этого статуса на стороне сайта. Crawler показывает для каждого URL оценку здоровья, код ответа HTTP и глубину сканирования, так что вы замечаете страницы, до которых Google трудно добраться. Представление Indexation группирует ваши URL по статусу покрытия в Search Console, а SEO Monitor предупреждает вас, когда важная страница получает noindex, меняет canonical, отдаёт 404 или выпадает из Sitemap.
Автор: David Kaufmann

Последние 10 с лишним лет я полностью одержим SEO — и, честно говоря, не хотел бы иначе.
Моя карьера вышла на новый уровень, когда я работал старшим SEO-специалистом в Chess.com — одном из ста самых посещаемых сайтов интернета. Работа в таком масштабе: миллионы страниц, десятки языков и одна из самых конкурентных выдач — научила меня тому, чему не научит ни один курс и ни один сертификат. Этот опыт изменил моё представление о том, как выглядит по-настоящему сильное SEO, и лёг в основу всего, что я построил потом.
Из него выросло SEO Alive — агентство для брендов, которые всерьёз занимаются органическим ростом. Мы не продаём дашборды и ежемесячные отчёты. Мы строим стратегии, которые реально двигают цифры, соединяя классическое SEO с новым и захватывающим миром Generative Engine Optimization (GEO): чтобы ваш бренд появлялся не только в синих ссылках Google, но и внутри ответов, которые ChatGPT, Perplexity и Google AI Overviews каждый день выдают миллионам людей.
А поскольку инструмента, который нормально закрывает оба этих мира, я так и не нашёл, я сделал его сам — SEOcrawl AI, платформу SEO-аналитики корпоративного уровня, где в одном месте собраны позиции, технические аудиты, мониторинг ссылок, здоровье краулинга и отслеживание видимости бренда в AI. Это та платформа, которой мне всегда не хватало.
Откройте больше материалов этого автора


Domain Authority прогнозирует, насколько хорошо сайт будет ранжироваться, но не является фактором ранжирования Google. Разбираем, что на самом деле измеряет DA, чем он отличается от DR и Authority Score и на какие метрики стоит смотреть вместо него.