Страницы-сироты: что это такое и как их найти
Чтобы сайт работал и мог показывать содержащиеся на нём страницы пользователям, у него должна быть правильная структура перелинковки, которая помогает, во-первых, пользователям добираться до этих страниц в один клик, а во-вторых, гарантирует, что их обойдут боты и пауки Google и они попадут в результаты поиска. Когда страница не встроена в структуру ссылок, её называют «страницей-сиротой».
Но что именно такое страница-сирота? Мы подробно разберём этот термин, а также последствия, которые он может иметь с точки зрения SEO, почему так происходит, как находить такие страницы и как решать проблемы, которые они могут создавать. Приступим!
Что такое страницы-сироты?
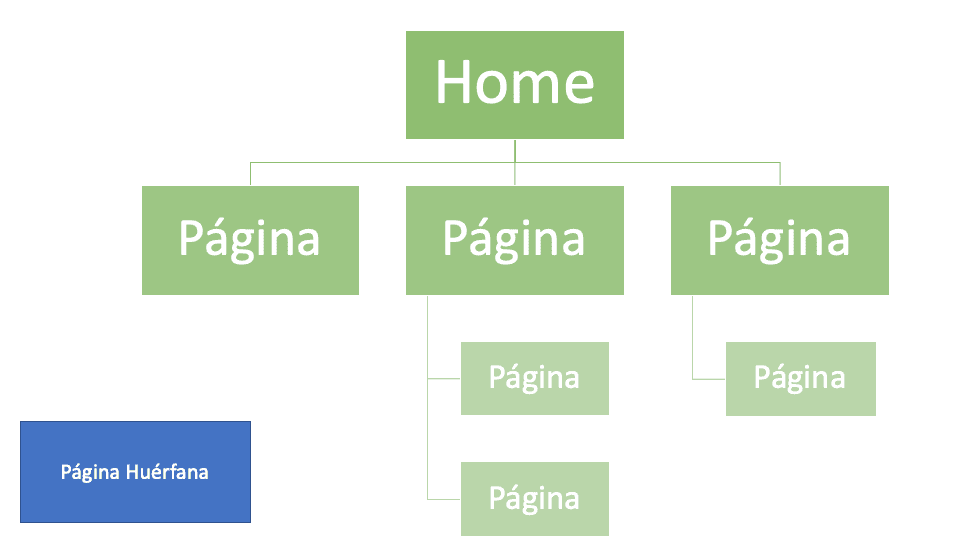
Если точно, страница-сирота — это страница сайта, которая, будучи проиндексированной Google или другой поисковой системой или нет, не связана и не соединена со структурой страниц платформы и оказывается полностью изолированной.
Таким образом, эта страница как бы «висит в воздухе» на сайте, не будучи доступной ни пользователям, которые могли бы её посетить, ни ботам Google, чтобы показать её в результатах поиска, даже если она проиндексирована. Даже если страница представлена в XML-карте сайта со своим URL, это не гарантирует отсутствия страниц-сирот, потому что по какой-то причине или из-за человеческой ошибки до неё нельзя добраться ни пользователю, ни краулерам поисковых систем.
Например, существует два способа обнаружения страниц сайта:
-
через краулер, который находит все страницы, следуя по ссылкам между ними, и
-
через список URL в XML-карте сайта.
Когда существует изолированная страница-сирота, она словно невидима, даже если она есть в sitemap, потому что на неё не ведут ссылки и её попросту не находят.
Это влечёт за собой ряд проблем, связанных с:
-
трафиком
-
потерей потенциала
-
SEO-проблемами
-
видимостью
-
авторитетом и
-
возможными санкциями
…среди прочих, которые мы подробно разберём далее. Пока же ясно одно: потенциальные страницы-сироты, независимо от того, насколько велик или мал сайт, нужно исправлять — это возможно и является обычной практикой обслуживания.
Почему на сайте появляются страницы-сироты?
Есть несколько причин, по которым на сайте появляются страницы-сироты, даже без ведома владельца или разработчика в тот или иной момент. Часто такие страницы, нежелательные на веб-платформе, возникают из-за плохо выполненных изменений, что обычно вызвано человеческой ошибкой.
Ниже мы показываем основные сценарии, при которых на сайте создаются или возникают страницы-сироты:
-
Иногда меняется внутренняя перелинковка страниц сайта, из-за чего часть URL убирают, потому что они больше не нужны, устарели или сайт оптимизируют. Нередко, даже когда ссылки убраны, страницы остаются на сайте и висят, не будучи полностью удалёнными.
-
Страницы A/B-тестов, с которыми конечный пользователь не соприкасается и которые после использования при разработке сайта остаются там и не удаляются.
-
Когда временно создаётся посадочная страница, чтобы привлечь пользователей и сделать их клиентами сайта — например, в период акций, Рождества и т. д., — а после окончания этого периода страницу удаляют, но проиндексированный URL остаётся.
-
Когда категорию убирают из меню сайта, но не перенаправляют должным образом на другую, созданную вместо неё, и оставшаяся страница остаётся без ссылок на платформе.
-
Во время миграции сайта часто возникает множество страниц-сирот, которые меняют формат, URL и параметры, но не удаляются и оказываются отсоединёнными и изолированными от сайта.
-
Когда для создания сайта используется шаблон, а страницы шаблона по умолчанию остаются, о них потом забывают и не удаляют.
С другой стороны, есть две частые причины появления страниц-сирот, которые нужно устранять немедленно; по сути это дубли страниц, которые должны последовательно автоматически перенаправляться на единый URL. Речь о последовательном использовании HTTPS и HTTP на канонических и неканонических страницах, а также об использовании слеша в конце адреса.
Иначе велика вероятность, что некоторые версии страницы не будут связаны ссылками и в результате станут сиротами. В этом случае главная проблема не в том, что они сироты, а в том, что они дубли и создадут проблемы с санкциями или потерей индексации — то, что Google трактует как скопированный или некачественный контент. Мы вернёмся к этому в разделе о решении проблемы страниц-сирот.
Страницы-сироты помогают или вредят SEO?
Страницы-сироты представляют собой проблему с точки зрения SEO, а также для видимости, авторитета, потери контента и трафика — в зависимости от их количества на платформе. То есть одна, две или несколько страниц-сирот могут не создавать никаких проблем, но когда они составляют значительный процент сайта, вот тут и начинаются сложности.
Оптимизировать сайт так, чтобы на нём не было страниц-сирот, важно для SEO и в других аспектах, и никак нельзя сказать, что они идут сайту на пользу; скорее они вредят ему, когда их слишком много.
Во-первых, поисковые системы не могут найти страницы-сироты по ссылкам, поэтому такие страницы часто не индексируются и никогда не появляются в результатах поиска, что бьёт по их трафику, видимости и потенциалу, — но об этом подробнее в отдельном разделе ниже.
Общие проблемы, которые создают страницы-сироты
Ниже — некоторые общие проблемы, которые создают страницы-сироты, особенно когда они охватывают заметную часть структуры ссылок и URL сайта:
-
Пользовательский опыт: страницы-сироты, каким бы невероятным это ни казалось, сильно влияют на пользовательский опыт сайта, поскольку пользователи не могут естественным образом попасть на страницу через меню или интересующую их ссылку, которая приведёт их к нужному, даже если страница существует и содержит качественный контент.
-
Авторитет: если важные страницы становятся сиротами и теряют связь с остальными URL сайта, весь авторитет, который у них мог быть, растрачивается впустую, и это напрямую сказывается на позициях в результатах поиска Google, ведь это важный SEO-фактор в том, как поисковая система упорядочивает результаты по конкретному запросу.
-
Контекст: внутренняя перелинковка сайта даёт краулерам Google контекст, чтобы понять, как индексировать страницу и для каких запросов она важна и релевантна. Страницы-сироты приводят к тому, что и сайт, и сами страницы теряют контекст и смысловую связность — в случае, если они проиндексированы.
Однако когда страницы-сироты присутствуют в больших количествах, их влияние гораздо заметнее в том, что касается ранжирования, трафика и обхода, поэтому эти проблемы нужно разбирать отдельно и подробнее.
Проблема страницы с низкой видимостью и трафиком
Страницы-сироты заметно негативно влияют непосредственно на ранжирование или позиции сайта и конкретной затронутой страницы, а также на её трафик. И это потому, что, как уже говорилось, страница-сирота изолирована и становится невидимой — и для пользователя, который не может естественным образом найти её на сайте кнопкой или кликом, и для краулеров Google или других поисковых систем.
Это явно сказывается на трафике сайта и страницы, а также на их видимости, из-за того что они не получают много пользователей и из-за слабого или вовсе отсутствующего места, которое страницы-сироты занимают в результатах поиска. Как следствие, мы имеем дело с полной потерей потенциала сайта и страницы, особенно если на ней есть качественный контент о товарах, услугах и других темах. Влияние на трафик и видимость оборачивается также потерей авторитета и значимости сайта в его нише или отрасли по сравнению с конкурентами.
Проблема потери обхода
Google как поисковая система индексирует страницы сайта в соответствии с тем, что известно как краулинговый бюджет, или Crawl Budget, — его можно описать как время, которое краулеры или пауки поисковой системы потратят на поиск страниц для индексации. Чем больше страниц на сайте, тем больше времени потребуется, то есть тем больше краулингового бюджета.
Вот тут и вступает в игру оптимизация структуры, архитектуры и других элементов сайта, в том числе страниц-сирот. Если на сайте есть нерелевантные страницы-сироты, они всё равно будут потреблять краулинговый бюджет, который расходуется впустую и из-за которого страницы с хорошим состоянием и контентом могут остаться непроиндексированными, что скажется на результатах поиска и трафике. Коротко говоря, страницы-сироты — это трата ресурсов, которую Google не готов себе позволить.
Разница между страницами-сиротами и тупиковыми страницами (Dead End)
Когда речь заходит о SEO, термин «страница-сирота»** можно спутать с термином «тупиковая страница», или «Dead End"**, потому что они означают похожие проблемы, но это не одно и то же. Что такое Orphan Pages, мы уже определили выше, перейдём к тупикам:
Тупиковая страница — это страница, которая не связана ссылками ни с одной другой во внутренней перелинковке сайта, ни с какой-либо внешней веб-платформой, то есть, попав на неё, вы не можете сделать ничего, кроме как закрыть её и уйти.
Когда краулеры поисковой системы вроде Google попадают на тупиковую страницу, им некуда идти — отсюда и название, проводящее аналогию с улицей без выезда.
Как найти страницы-сироты на своём сайте?
Чтобы начать решать проблемы, связанные со страницами-сиротами, или Orphan Pages, первое, что нужно сделать, — найти их, поскольку очевидно, что с первого взгляда они не видны ни пользователю сайта, ни разработчику. К счастью, можно использовать разные инструменты, например SEO-софт, который детально анализирует всю структуру нашего сайта, получая через логи сервера полную картину по всем страницам.
Если вам нужен мощный SEO Software, который поможет не только находить страницы-сироты, но и усилить и улучшить вашу SEO-стратегию, обязательно посмотрите программу собственной разработки SEO Alive!
Как распознать страницы-сироты с помощью Screaming Frog
Как мы упоминали, на рынке есть несколько программ, которые помогают выявить эти страницы-сироты; мы сосредоточимся на том, чтобы просто объяснить, как это сделать с помощью одной из самых известных — Screaming Frog.
У Screaming Frog есть две разные программы: самая известная всем, которая обходит весь сайт, следуя по найденным внутренним ссылкам, и log analyser, который анализирует логи доступа сервера, то есть записи, остающиеся, когда Googlebot (или другой user agent) заходит на любую из наших страниц.
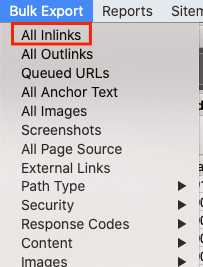
С помощью первой мы извлечём файл со списком всех URL, которые краулер находит при обходе; это будет файл Excel, который можно найти в разделе отчётов под пунктом «all inlinks»:
Итак, когда этот файл у нас есть, мы берём логи с нашего сервера — обычно это сжатый файл с упомянутыми записями — и загружаем его в log analyser от Screaming Frog, чтобы получить панель, где появятся все URL, которые Googlebot посетил за загруженный период, независимо от того, есть на них ссылки или нет.
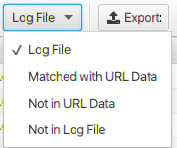
Последним шагом будет загрузить файл Excel из предыдущего шага в предназначенный для этого раздел log analyser, и при этом откроется новая вкладка со следующими опциями:
-
Matched with URL data: это будет набор URL, на которые есть внутренние ссылки и которые посещал Google.
-
Not in log file: те URL, на которые есть ссылки, но которые по какой-то причине не получают событий (визитов) от Google.
-
Not in URL data: именно эта группа нас в данном случае интересует; это URL, которые Google посещает, оставляя запись в логах, но которые краулер не смог найти при симуляции, потому что на них нет внутренних ссылок, — то есть это наши искомые Orphan Pages.
Из этой третьей группы мы извлечём список страниц, которые отнесём к сиротам, причём объектом нашей оптимизации в первую очередь будут те, что отдают код 200.
Как решить проблему страниц-сирот?
В общем случае и вручную можно сделать четыре вещи, если у вас есть URL, не встроенные во внутреннюю перелинковку, и здесь нужно принять несколько решений:
-
Во-первых, если после миграции остались страницы-сироты — а они, скорее всего, останутся, — и при их разборе оказывается, что у многих из них мало релевантного контента, его нет вовсе или он дублируется, лучше всего их удалить и, где уместно, добавить 301-редирект на похожие или приоритетные страницы сайта с большим авторитетом.
-
Во-вторых, если по какой-то причине вы хотите сохранить страницу-сироту из-за хорошего контента, авторитета и трафика, следующий шаг — поставить на неё ссылку с URL сайта со связанным контентом, до которого легко добраться пользователям и Google. Разумеется, стоит отметить, что URL страницы должен быть включён в карту сайта.
-
В-третьих, если страниц-сирот появляется много, но они по своей природе временные и их контент уже устарел, потому что содержал акции и материалы, привязанные к конкретному времени, сделаем то же, что и на предыдущем шаге, и свяжем страницу с другой внутренней — значимой и доступной. Но в этом случае мы сделаем так, чтобы этот URL не индексировался, добавив метатег «noindex», чтобы краулеры его не учитывали.
-
Наконец, в случае страниц-сирот с дублирующимся или почти дублирующимся контентом стоит подумать о том, чтобы удалить такую страницу и включить её контент в другую, чтобы не потерять его и продолжать использовать его общий потенциал.
Вывод
Страницы-сироты — естественный элемент, который появляется на сайте по разным причинам, и когда их немного и их количество не растёт в геометрической прогрессии, они не представляют никакой проблемы.
С другой стороны, когда большой процент сайта и его внутренней перелинковки составляют страницы такого типа, это может создать множество проблем с обходом, ранжированием и трафиком в части SEO, а также с авторитетом, пользовательским опытом и другими вопросами, которые нужно решать.
Хорошая новость в том, что страницы-сироты можно устранить разными способами, но всегда в ходе анализа: спросить себя нужно, значима ли каждая конкретная страница-сирота для ранжирования, для контента, можно ли связать её с другой, — а когда это не так, просто удалить.
А вы, дорогой читатель… знали о существовании страниц-сирот? Сталкивались ли вы с этим элементом в своих проектах или проектах своих клиентов? Оставьте нам комментарий, и мы вам ответим. Большое спасибо и до новых встреч!
Автор: David Kaufmann

Последние 10 с лишним лет я полностью одержим SEO — и, честно говоря, не хотел бы иначе.
Моя карьера вышла на новый уровень, когда я работал старшим SEO-специалистом в Chess.com — одном из ста самых посещаемых сайтов интернета. Работа в таком масштабе: миллионы страниц, десятки языков и одна из самых конкурентных выдач — научила меня тому, чему не научит ни один курс и ни один сертификат. Этот опыт изменил моё представление о том, как выглядит по-настоящему сильное SEO, и лёг в основу всего, что я построил потом.
Из него выросло SEO Alive — агентство для брендов, которые всерьёз занимаются органическим ростом. Мы не продаём дашборды и ежемесячные отчёты. Мы строим стратегии, которые реально двигают цифры, соединяя классическое SEO с новым и захватывающим миром Generative Engine Optimization (GEO): чтобы ваш бренд появлялся не только в синих ссылках Google, но и внутри ответов, которые ChatGPT, Perplexity и Google AI Overviews каждый день выдают миллионам людей.
А поскольку инструмента, который нормально закрывает оба этих мира, я так и не нашёл, я сделал его сам — SEOcrawl AI, платформу SEO-аналитики корпоративного уровня, где в одном месте собраны позиции, технические аудиты, мониторинг ссылок, здоровье краулинга и отслеживание видимости бренда в ИИ. Это та платформа, которой мне всегда не хватало.
Откройте больше материалов этого автора