„Gecrawlt – zurzeit nicht indexiert“: Bedeutung und Lösung

Google hat Ihre URL besucht, gelesen und aus der Suche herausgelassen. So erkennen Sie, welche Seiten eine zweite Chance verdienen und wie Google empfiehlt, sie in den Index zu bringen.
Gecrawlt – zurzeit nicht indexiert bedeutet, dass der Googlebot Ihre Seite abgerufen und entschieden hat, sie nicht in den Google-Index aufzunehmen, sodass sie nicht in der Suche erscheinen kann. Die Hilfe zum Bericht zur Seitenindexierung formuliert es so: Die Seite wurde gecrawlt, aber nicht indexiert, und sie „wird in Zukunft möglicherweise indexiert, möglicherweise aber auch nicht“.
Die Ursache ist meist die Seite selbst, keine technische Sperre. Im Folgenden sehen Sie, wie Sie URL für URL entscheiden, ob Sie eine Seite korrigieren, auf noindex setzen oder löschen, und wie lange eine Korrektur laut Google dauert. Neu im Bericht? Beginnen Sie mit diesem Leitfaden zur Google Search Console.
Was bedeutet „Gecrawlt – zurzeit nicht indexiert“?
Der Status bedeutet, dass Google die Seite gecrawlt und sich gegen die Indexierung entschieden hat. Nichts hat den Googlebot blockiert: Google hat beschlossen, die Seite vorerst draußen zu lassen. Zwei Unterscheidungen helfen, den Status richtig zu lesen.
Gecrawlt vs. indexiert
Crawling heißt, dass der Googlebot eine Seite herunterlädt. Indexierung heißt, dass Google sie speichert, damit sie in Suchergebnissen erscheinen kann. Eine Seite kann viele Male gecrawlt und trotzdem nie indexiert werden.
Die Hilfe zum URL-Prüftool sagt, die Qualität einer Seite müsse „hoch genug sein, um eine Indexierung zu rechtfertigen“, und der Live-Test kann diesen Status überhaupt nicht prüfen.
Der Unterschied zu „Gefunden – zurzeit nicht indexiert“
Gefunden – zurzeit nicht indexiert kommt einen Schritt früher: Google hat die URL entdeckt, das Crawling aber verschoben, um Ihre Website nicht zu überlasten, daher ist das Datum des letzten Crawls leer.
| Gefunden – zurzeit nicht indexiert | Gecrawlt – zurzeit nicht indexiert | |
|---|---|---|
| Von Google gecrawlt? | Nein | Ja |
| Datum des letzten Crawls | Leer | Ein Datum |
| Üblicher Grund | Crawling verschoben, um die Website nicht zu überlasten | Google hat die Seite gelesen und übergangen |
| Zuerst prüfen | Crawling-Kapazität, auf sehr großen Websites | Content-Qualität, Duplikate, Canonicals |
Google sagt außerdem: „Nicht indexiert ist nicht unbedingt schlecht.“ Seiten mit noindex, in der robots.txt blockierte URLs, Duplikate und 404-Seiten ohne Ersatz sollen draußen bleiben.
Warum Google Seiten crawlt, ohne sie zu indexieren
Die Indexierung hat eine Qualitätshürde, das Crawling nicht. Googles Leitfaden zum Crawl-Budget sagt, dass der Crawling-Bedarf mit dem Wert und der Einzigartigkeit Ihrer Inhalte steigt.
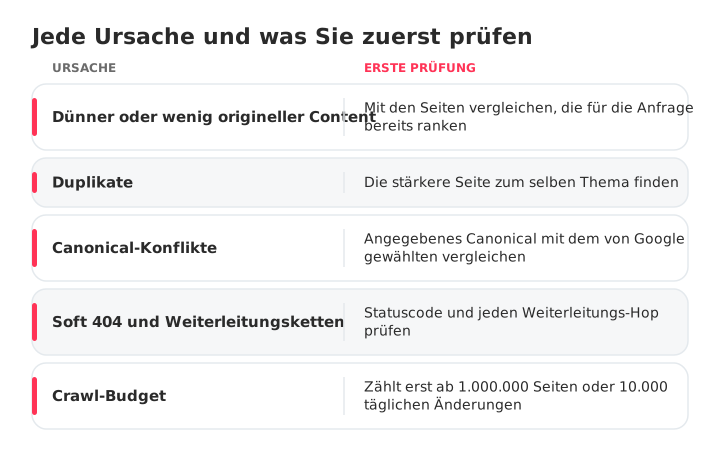
Die meisten betroffenen URLs fallen unter eine dieser Ursachen, jeweils mit der ersten Prüfung:
- Dünner oder wenig origineller Content: Die Seite wiederholt, was bereits rankt.
- Duplikate: Tag-Archive, sortierte URLs, zwei Beiträge zum selben Thema. So erkennen und beheben Sie Keyword-Kannibalisierung.
- Canonical-Konflikte: Vergleichen Sie Ihr angegebenes Canonical mit dem, das Google ausgewählt hat. Wählt Google eine andere URL, wandert die Seite meist zu Alternative Seite mit richtigem kanonischen Tag oder einem Duplikat-Status.
- Soft 404 und Weiterleitungsketten: Laut Google verschwenden Soft-404-Fehler Crawl-Budget.
- Crawl-Budget: Es zählt bei Websites mit über 1.000.000 Seiten, die sich wöchentlich ändern, oder über 10.000, die sich täglich ändern. Bei den meisten Websites ist es nicht die Ursache.
Die Hürde ist in zwei datierten Schritten gestiegen. Am 18. August 2022 kündigte Google das Helpful Content Update an, ein websiteweites Signal, und erklärte, dass das Entfernen wenig hilfreicher Inhalte dem Rest einer Website helfen kann. Am 5. März 2024 kündigte Google ein Core Update an, das weniger auf Klicks ausgelegte Inhalte zeigen soll, zusammen mit einer neuen Spamrichtlinie gegen den Missbrauch skalierter Inhalte.
Googles Leitfaden zu hilfreichen Inhalten sagt, dass E-E-A-T kein eigener Rankingfaktor ist, dass Vertrauenswürdigkeit am wichtigsten ist und dass es keine bevorzugte Wortzahl gibt. Eine Seite aufzublähen, löst das Problem nicht.
So finden und diagnostizieren Sie betroffene Seiten in der GSC
Öffnen Sie den Bericht zur Seitenindexierung (früher Abdeckung), prüfen Sie eine Stichprobe und gruppieren Sie die Liste nach Mustern. Laut Google brauchen Websites mit weniger als 500 Seiten den Bericht wahrscheinlich nicht.
Betroffene URLs im Bericht „Seiten“ finden
- Gehen Sie in der Google Search Console zu Indexierung › Seiten.
- Klicken Sie unter „Gründe, warum Seiten nicht indexiert werden“ auf Gecrawlt – zurzeit nicht indexiert.
- Klicken Sie auf Exportieren und laden Sie die Liste herunter.
Der Bericht zeigt bis zu 1.000 Beispiel-URLs, nicht unbedingt alle, auf einer großen Website ist der Export also eine Stichprobe.
Seiten mit dem URL-Prüftool prüfen
Prüfen Sie fünf bis zehn exportierte URLs auf das Datum des letzten Crawls und die von Google ausgewählte kanonische URL. Zeigt das Canonical woandershin, sieht Google ein Duplikat; ein Monate altes Crawl-Datum deutet darauf hin, dass Google selten zurückkommt.
Muster in Hunderten von URLs erkennen
Sortieren Sie den Export nach Ordner, Template und URL-Parameter und zählen Sie jede Gruppe. Angenommen, 300 URLs verteilen sich auf 180 /tag/-Seiten, 70 ?sort=-URLs und 50 Beiträge: Das sind drei Entscheidungen, nicht 300.
Korrigieren, noindex oder löschen: Entscheiden Sie, was jede URL verdient
Jede URL verdient eines von vier Ergebnissen. Fragen Sie sich: Wäre ein Suchender froh, hier zu landen, und ist dies die einzige Seite Ihrer Website, die die Suchanfrage beantwortet?
| Seitentyp | Beispiel | Entscheidung | Wie |
|---|---|---|---|
| Nützlich und einzigartig, aber dünn | Ein Leitfaden mit 300 Wörtern zu einem Thema, das Sie kennen | Verbessern | Tiefe und Details aus erster Hand ergänzen |
| Duplikat einer stärkeren Seite | Zwei Beiträge zur selben Suchanfrage | Zusammenführen | Inhalt verschieben, dann 301-Weiterleitung |
| Nützlich auf der Website, nicht in der Suche | Tag-Archive, interne Suche, Danke-Seiten | Noindex | Robots-Meta-Tag oder X-Robots-Tag |
| Kein Wert, kein Ersatz | Abgelaufene Aktionen, Testseiten | Löschen | 404 oder 410 zurückgeben |
Googles Leitfaden zum Crawl-Budget stützt die letzten beiden Zeilen: Geben Sie für entfernte Seiten 404 oder 410 zurück und führen Sie Duplikate zusammen. Ein 404 in der Search Console ist bei absichtlich entfernten Seiten zu erwarten.
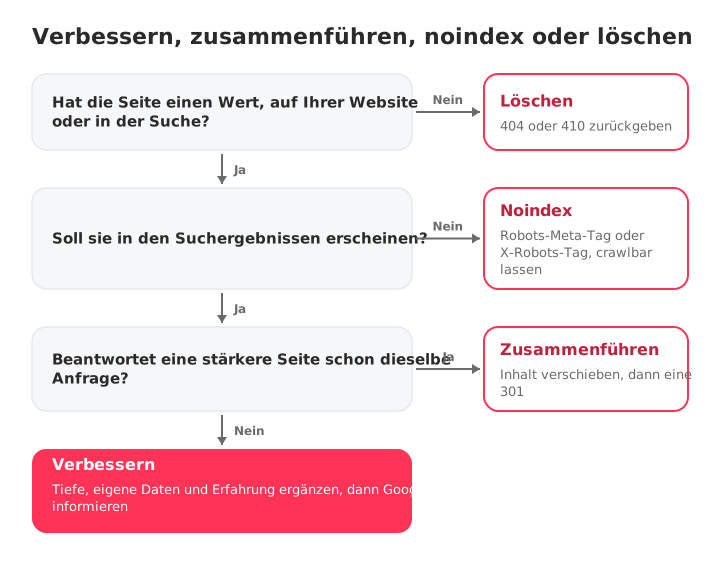
Beim noindex geht die Triage am häufigsten schief:
Nicht so: ein noindex-Tag auf Ihren /tag/-Seiten, während die robots.txt /tag/ blockiert. Der Googlebot kann die Seiten nicht abrufen und sieht das Tag daher nie.
Sondern so: /tag/ bleibt crawlbar und trägt das noindex als Meta-Tag oder X-Robots-Tag-Header.
Laut Googles Dokumentation zu noindex funktioniert die Regel nicht in der robots.txt, und bei selten besuchten Seiten kann das erneute Crawling Monate dauern. Sobald das Tag gelesen wurde, wandern diese URLs zu Durch „noindex“-Tag ausgeschlossen, und genau das wollen Sie für sie.
So korrigieren Sie die Seiten, die eine Indexierung verdienen
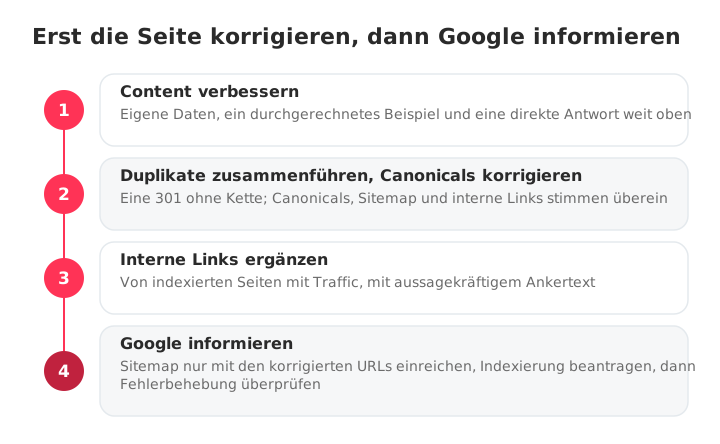
Machen Sie die Seite zuerst indexierungswürdig, dann informieren Sie Google. Wer für eine unveränderte Seite die Indexierung beantragt, bittet Google, eine bereits getroffene Entscheidung zu wiederholen. Die Reihenfolge:
- Content verbessern.
- Duplikate zusammenführen und Canonicals korrigieren.
- Interne Links ergänzen.
- Eine fokussierte Sitemap einreichen und die Indexierung beantragen.
Tiefe und Originalität des Contents verbessern
Schreiben Sie für die Suchanfrage, nicht für eine Wortzahl: Ergänzen Sie eigene Daten, Screenshots, ein durchgerechnetes Beispiel und eine direkte Antwort weit oben.
Ein Beispiel: Nehmen Sie einen dünnen Leitfaden mit 300 Wörtern, ergänzen Sie einen eigenen Datensatz und ein durchgerechnetes Beispiel, verlinken Sie ihn aus zwei Beiträgen, die bereits Traffic bekommen, und nehmen Sie ihn erst dann in eine fokussierte Sitemap auf.
Duplikate zusammenführen und Canonicals korrigieren
Wenn zwei URLs dasselbe abdecken, behalten Sie eine, verschieben den nützlichen Inhalt dorthin und leiten die andere per 301-Weiterleitung direkt darauf weiter, ohne Kette. Prüfen Sie dann, ob Canonicals, Sitemap und interne Links übereinstimmen und kein vergessenes noindex übrig ist.
Interne Links von Seiten ergänzen, die Google bereits schätzt
Verlinken Sie jede korrigierte Seite von indexierten Seiten mit Traffic, mit einem aussagekräftigen Ankertext. Jeder Website-Crawler kann verwaiste Seiten (null interne Links) auflisten, indem Sie nach null eingehenden Links filtern. Die vollständige Methode finden Sie in diesem Leitfaden zur internen Verlinkung.
Prüfen Sie die Seite außerdem auf dem Smartphone und im Bericht „Core Web Vitals“: Eine defekte Mobilseite lässt sich schnell ausschließen.
Eine fokussierte Sitemap einreichen und die Indexierung beantragen
Erstellen Sie eine Sitemap nur mit den korrigierten URLs, reichen Sie sie ein und filtern Sie den Bericht „Seiten“ danach, bevor Sie auf Fehlerbehebung überprüfen klicken. Google empfiehlt das, um die Überprüfung zu beschleunigen. Wenn Sie zuerst Ihre aktuelle Datei brauchen: So finden Sie die Sitemap Ihrer Website.
Google ignoriert priority und changefreq, halten Sie stattdessen lastmod korrekt. Klicken Sie dann im URL-Prüftool für Ihre wichtigsten URLs auf Indexierung beantragen: Google wendet ein Kontingent an und sagt, dass wiederholte Anträge nichts beschleunigen.
Wie lange dauert die Indexierung nach einer Korrektur?
Rechnen Sie mit einem Tag bis mehreren Wochen, und eine Indexierung ist nie garantiert. Google nennt auf verschiedenen Seiten verschiedene Zeiträume, hier stehen sie nebeneinander:
| Was Sie getan haben | Was Google sagt | Quelle |
|---|---|---|
| Google um erneutes Crawling gebeten | Einige Tage bis einige Wochen | Google um erneutes Crawling bitten |
| Indexierung beantragen | Meist etwa ein Tag, bis zu ein bis zwei Wochen, mit Tageslimit | Hilfe zur URL-Prüfung |
| Fehlerbehebung überprüfen | Bis zu etwa zwei Wochen, manchmal deutlich länger | Hilfe zur Seitenindexierung |
Das sind Googles Zeitangaben, keine Fallbeispiele. Prüfen Sie den Bericht „Seiten“ wöchentlich; haben sich korrigierte URLs nach Ablauf dieser Zeiträume nicht bewegt, gehen Sie zurück zum Content.
So verhindern Sie, dass neue Seiten in diesem Status landen
Vorbeugung ist Routine: Prüfen Sie jede Seite vor dem Livegang und sehen Sie sich die Search Console monatlich an. Stellen Sie vor der Veröffentlichung sicher, dass die Seite:
- Eine Suchanfrage beantwortet, die keine andere Seite Ihrer Website beantwortet.
- Eigene Daten, Beispiele oder Erfahrung einbringt.
- Ein selbstreferenzierendes Canonical und kein vergessenes noindex hat.
- Mit korrektem lastmod in der Sitemap steht.
- Einen namentlich genannten Autor und, wo sinnvoll, strukturierte Daten hat.
- Einen Link von einer thematisch passenden, indexierten Seite bekommt.
Vergleichen Sie einmal im Monat den Bericht „Seiten“ mit dem Vormonat; ein Problem bleibt 90 Tage gelistet, nachdem sein letztes Vorkommen verschwunden ist. Websites mit über tausend Seiten sollten zusätzlich den Bericht „Crawling-Statistiken“ im Blick behalten.
SEOcrawl AI übernimmt die technische Seite im großen Maßstab. Der Crawler scannt jede Seite und liefert einen Audit Health Score, mit Problemen aufgeschlüsselt nach Indexability, Crawlability, On-Page und mehr. Seine Indexation-Ansicht gruppiert Ihre URLs nach Search-Console-Abdeckungsstatus, sodass Sie sehen, wie viele unter „Gecrawlt – zurzeit nicht indexiert“ stehen, und die Zahl im Zeitverlauf verfolgen können.
Zwischen den Crawls warnt Sie SEO Monitor, wenn eine wichtige Seite ein noindex erhält, ihr Canonical ändert, einen 404 zurückgibt oder aus der Sitemap fällt. Dieselbe Plattform verfolgt die Sichtbarkeit Ihrer Marke in ChatGPT, Claude, Gemini, Perplexity und Copilot, damit SEO und GEO an einem Ort zusammenkommen.
FAQs
Was bedeutet „Gecrawlt – zurzeit nicht indexiert“?
Es bedeutet, dass der Googlebot Ihre Seite abgerufen und entschieden hat, sie nicht in den Google-Index aufzunehmen, sodass sie nicht in der Suche erscheinen kann. Nichts hat das Crawling blockiert: Google hat die Seite gelesen und sie vorerst aussortiert. Es ist keine manuelle Maßnahme, und die Seite wird in Zukunft möglicherweise indexiert, möglicherweise aber auch nicht.
Ist das dasselbe wie „Gefunden – zurzeit nicht indexiert“?
Nein. „Gefunden“ bedeutet, dass Google die URL kennt, das Crawling aber verschoben hat, daher ist das Datum des letzten Crawls leer. „Gecrawlt“ bedeutet, dass Google die Seite bereits besucht und gelesen und dann entschieden hat, sie nicht zu indexieren. Bei „Gefunden“ prüfen Sie auf sehr großen Websites die Crawling-Kapazität; bei „Gecrawlt“ die Content-Qualität, Duplikate und Canonicals.
Schadet „Gecrawlt – zurzeit nicht indexiert“ meinem SEO?
Nicht an sich: Der Status ist keine Abstrafung, und die betroffene Seite verliert nur ihren eigenen Suchtraffic. Das Risiko liegt in der Menge, denn Google behandelt einen großen Anteil wenig hilfreicher Inhalte als websiteweites Signal. Ein Tag-Archiv außerhalb des Index kostet nichts, eine Produktseite schon. Steigt die Zahl mit jeder Veröffentlichung, behandeln Sie es als Content-Problem der ganzen Website, nicht als Liste einzelner URLs.
Wie lange dauert es nach einer Korrektur, bis eine Seite indexiert wird?
Rechnen Sie mit einem Tag bis mehreren Wochen, und eine Indexierung ist nie garantiert. Laut Google dauert ein erneutes Crawling einige Tage bis einige Wochen, ein Antrag auf Indexierung wird meist innerhalb etwa eines Tages bearbeitet, kann aber ein bis zwei Wochen dauern, und eine Überprüfung der Fehlerbehebung dauert in der Regel bis zu etwa zwei Wochen.
Hilft es, die Indexierung zu beantragen?
Nur, nachdem Sie die Seite geändert haben. Wer für eine unveränderte Seite die Indexierung beantragt, bittet Google, eine bereits getroffene Entscheidung zu wiederholen. Anträge unterliegen einem Tageskontingent, und laut Google beschleunigt mehrfaches Einreichen derselben URL nichts.
Hilft es, die Seite in meine XML-Sitemap aufzunehmen?
Es hilft Google, eine URL zu finden, nicht, sie zu indexieren. Google nennt eine eingereichte Sitemap „lediglich einen Hinweis“, und diese Seiten wurden bereits gefunden und gelesen. Nach einer Korrektur besteht die Aufgabe der Sitemap darin, die URLs zu bündeln, die erneut geprüft werden sollen. Jede Sitemap-Datei fasst bis zu 50.000 URLs oder 50 MB.
Warum ist meine Überprüfung von „Gecrawlt – zurzeit nicht indexiert“ fehlgeschlagen?
Die Überprüfung stoppt, sobald Google in der Gruppe eine URL findet, die noch nicht behoben ist, daher kann eine einzige übrig gebliebene Seite den ganzen Stapel scheitern lassen. Beheben Sie jede URL der Gruppe oder verkleinern Sie die Gruppe, indem Sie den Bericht mit einer Sitemap filtern, die nur Ihre korrigierten URLs enthält, und starten Sie die Überprüfung dann neu.
Wie hilft SEOcrawl AI bei Seiten, die Google crawlt, aber nicht indexiert?
SEOcrawl AI findet die Ursachen auf Ihrer Website hinter dem Status. Der Crawler zeigt für jede URL Health Score, HTTP-Statuscode und Crawl-Tiefe, damit Sie Seiten erkennen, die Google schwer erreicht. Die Indexation-Ansicht gruppiert Ihre URLs nach Search-Console-Abdeckungsstatus, und SEO Monitor warnt Sie, wenn eine wichtige Seite ein noindex erhält, ihr Canonical ändert, einen 404 zurückgibt oder aus der Sitemap fällt.
Autor: David Kaufmann

In den letzten über 10 Jahren habe ich mich komplett dem SEO verschrieben — und ehrlich gesagt möchte ich es nicht anders haben.
Meine Karriere erreichte eine neue Stufe, als ich als Senior SEO Specialist für Chess.com gearbeitet habe — eine der 100 meistbesuchten Websites im gesamten Internet. In dieser Größenordnung zu arbeiten, über Millionen von Seiten, Dutzende Sprachen und in einer der umkämpftesten SERPs überhaupt, hat mich Dinge gelehrt, die kein Kurs und kein Zertifikat je vermitteln könnte. Diese Erfahrung hat meine Sichtweise darauf verändert, wie großartiges SEO wirklich aussieht — und sie wurde zum Fundament für alles, was ich seitdem aufgebaut habe.
Aus dieser Erfahrung heraus habe ich SEO Alive gegründet — eine Agentur für Marken, die es mit organischem Wachstum ernst meinen. Wir sind nicht hier, um dashboards und monatliche Reports zu verkaufen. Wir sind hier, um Strategien zu entwickeln, die wirklich etwas bewegen, indem wir das Beste aus dem klassischen SEO mit der spannenden neuen Welt der Generative Engine Optimization (GEO) verbinden — damit deine Marke nicht nur in den blauen Links von Google auftaucht, sondern auch in den AI-generierten Antworten, die ChatGPT, Perplexity und Google AI Overviews tagtäglich Millionen von Menschen liefern.
Und weil ich kein Tool finden konnte, das beide Welten richtig abdeckt, habe ich selbst eines gebaut — SEOcrawl AI, eine Enterprise-SEO-Intelligence-Plattform, die rankings, technische Audits, backlinks-Monitoring, crawl-Health und AI-Brand-Visibility-Tracking an einem Ort vereint. Es ist die Plattform, die ich mir immer gewünscht habe.
Entdecke weitere Inhalte von diesem Autor

Eine Produktlistenseite (PLP) zeigt eine ganze Produktkategorie auf einmal. Erfahren Sie, wie sie sich von einer PDP unterscheidet, was sie konvertieren lässt und wie Sie Listenseiten ohne das Chaos der Facettennavigation indexieren lassen.

Die Domain Authority sagt voraus, wie gut eine Website ranken wird, ist aber kein Google-Rankingfaktor. Hier erfährst du, was die DA wirklich misst, wie sie sich von DR und Authority Score unterscheidet und welche Kennzahlen stattdessen deine Aufmerksamkeit verdienen.