


„Gefunden – zurzeit nicht indexiert“: Bedeutung und Lösung
Google kennt Ihre URL und hat sie noch nicht besucht. So erkennen Sie, ob Sie warten oder handeln sollten, und womit Sie bei einer kleinen und einer großen Website beginnen.
Gefunden – zurzeit nicht indexiert bedeutet, dass Google die URL gefunden, sie aber noch nicht gecrawlt hat. So beschreibt es die Hilfe zum Seitenindexierungsbericht von Google. Meist hat Google das Crawling geplant und dann verschoben, statt Ihre Website zu überlasten. Deshalb ist das Datum des letzten Crawls im Bericht leer.
Es ist ein Status zur Crawling-Priorität, kein Urteil über Ihre Inhalte, denn Google hat die Seite noch nicht gelesen. Unten sehen Sie, worin er sich von „Gecrawlt“ unterscheidet, was wir auf unserer eigenen Website gefunden haben und eine nach Websitegröße geordnete Liste von Lösungen. Neu im Bericht? Beginnen Sie mit diesem Leitfaden zur Google Search Console.
Was „Gefunden – zurzeit nicht indexiert“ bedeutet
Google führt eine URL durch vier Stufen: Es findet sie, crawlt sie, indexiert sie und kann sie dann in den Ergebnissen anzeigen. Zwei Statusmeldungen der Search Console beschreiben eine URL, die unterwegs stehen geblieben ist.
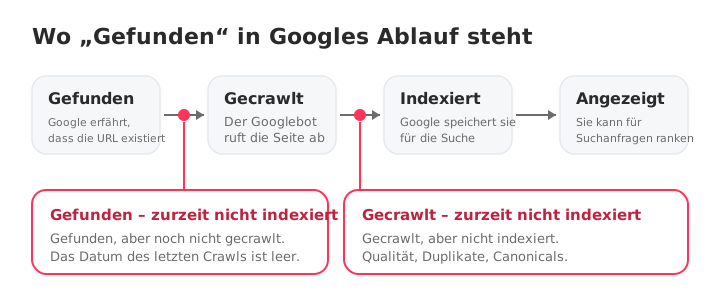
Eine URL gelangt über Ihre Sitemap oder über Links anderer Seiten zu „gefunden“. Danach entscheidet Google, wann es sie crawlt. „Gefunden“ bedeutet, dass diese Entscheidung noch nicht gefallen ist.
Worin er sich von „Gecrawlt – zurzeit nicht indexiert“ unterscheidet
Die beiden Status klingen ähnlich und erfordern unterschiedliche Lösungen.
| Gefunden – zurzeit nicht indexiert | Gecrawlt – zurzeit nicht indexiert | |
|---|---|---|
| Von Google gecrawlt? | Nein | Ja |
| Datum des letzten Crawls | Leer | Ein Datum |
| Hat Google die Seite gelesen? | Nein | Ja |
| Üblicher Grund | Crawling verschoben oder niedrige Priorität | Google hat die Seite gelesen und übersprungen |
| Zuerst prüfen | Interne Links, Sitemap, Crawling-Kapazität | Inhaltsqualität, Duplikate, Canonicals |
Die vollständige Diagnose des zweiten Status finden Sie im Leitfaden zu „Gecrawlt – zurzeit nicht indexiert“.
So sieht die Liste auf einer echten Website aus
Wir haben seocrawl.ai im Indexierungsbericht von SEOcrawl geprüft. Von den 1.000 URLs, die SEOcrawl beobachtet (unsere Sitemap deklariert 6.310), sind 823 indexiert, also 82,3 %. 128 stehen auf „Gecrawlt – zurzeit nicht indexiert“ und 14 auf „Gefunden – zurzeit nicht indexiert“.
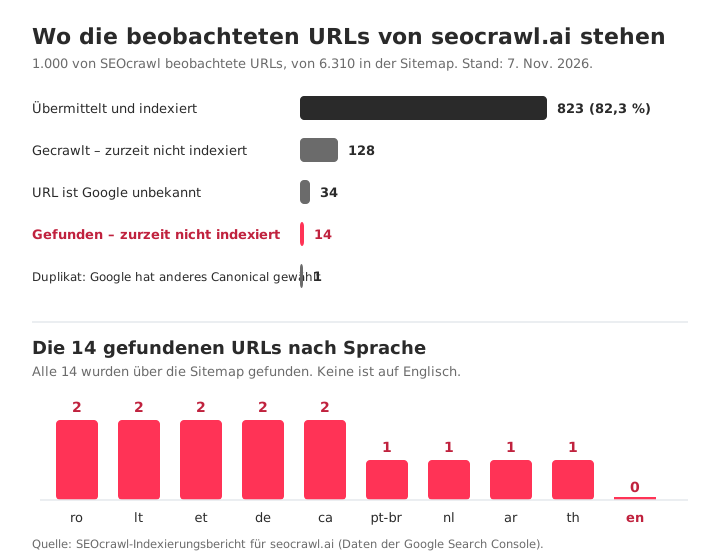
Aufschlussreich ist, was die 14 gemeinsam haben:
- Jede ist eine übersetzte Seite: Arabisch, Katalanisch, Deutsch, Estnisch, Litauisch, Niederländisch, Portugiesisch (Brasilien), Rumänisch und Thai. Keine ist auf Englisch.
- Google hat alle 14 über die Sitemap gefunden, nicht über einen Link einer anderen Seite.
- Bei einer steht ein älteres Crawl-Datum (9. Mai 2026). Der Status beschreibt also, wo eine URL jetzt steht, und nicht, dass Google sie nie besucht hat.
Das ist ein Muster, das Sie prüfen sollten, keine Diagnose. Eine Seite, die in 26 Sprachen existiert und hauptsächlich über die Sitemap erreichbar ist, ist ein klarer Kandidat für schwache interne Verlinkung, deshalb sind interne Links das Erste, was Sie ansehen sollten. Die Lehre gilt für jede Website: Lesen Sie die Liste nicht URL für URL. Nach Sprache gruppiert, wurden aus 14 URLs eine einzige Frage.
Die Zahlen beziehen sich auf die 1.000 URLs, die SEOcrawl beobachtet, eine Stichprobe der gesamten Sitemap. Die größere Gruppe mit 128 URLs gehört zum anderen Status und hat einen eigenen Leitfaden.
Warum Google ein Crawling verschiebt
Googles Leitfaden zum Crawl-Budget erklärt, wie Google entscheidet, wie viel es crawlt: ein Kapazitätslimit, das Ihr Server verkraftet, und die Nachfrage nach Ihren URLs. Die meisten gefundenen URLs lassen sich auf eine dieser fünf Ursachen zurückführen.
- Crawling-Kapazität. Laut Google sinkt das Limit, wenn Ihre Website langsamer wird oder Serverfehler liefert. Ein langsamer Server bedeutet weniger Crawls.
- Geringe Crawling-Nachfrage. Die Nachfrage hängt von Größe, Aktualisierungshäufigkeit, Seitenqualität und Relevanz einer Website ab. Eine URL mit wenigen oder gar keinen internen Links gibt Google wenig Anlass, bald wiederzukommen.
- Crawl-Verschwendung. Doppelte URLs, Parameter, Facetten, lange Weiterleitungsketten und Soft 404s konkurrieren mit Ihren echten Seiten. Google weist darauf hin, dass Soft 404s weiter gecrawlt werden und Budget verschwenden und dass es eine noindex-Seite noch abruft, bevor es sie verwirft.
- Entdeckung nur über die Sitemap. Eine Sitemap teilt Google mit, dass eine URL existiert. Sie macht die URL nicht zur Priorität, und Google behandelt sie als Hinweis. Seiten, die nur dort gefunden werden, warten als Erste.
- Eine neue Website oder ein neuer Bereich. Jede Website beginnt mit demselben konservativen Standard-Kapazitätslimit, das wächst, sobald sich die Website als gesund erweist.
Das Crawl-Budget selbst verdient nur bei sehr großen Websites Ihre Aufmerksamkeit. Googles grobe Schätzung: 1.000.000+ eindeutige Seiten, die etwa wöchentlich aktualisiert werden, oder 10.000+ Seiten, die sich täglich ändern. Bei kleineren Websites sind die Ursachen 2 und 4 weitaus häufiger.
Ist es ein Problem? Drei Fragen, bevor Sie etwas beheben
- Soll diese URL überhaupt indexiert werden? Handelt es sich um eine gefilterte Ansicht, eine interne Suchseite oder eine Test-URL, ist es in Ordnung, sie draußen zu lassen. Um das deutlich zu machen, setzen Sie noindex oder geben Sie 404 oder 410 zurück (siehe Durch „noindex“-Tag ausgeschlossen).
- Wie viele URLs, und nach welchem Muster? Google sagt, dass Sie bei weniger als 500 Seiten diesen Bericht vermutlich nicht brauchen. Die Liste ist außerdem auf 1.000 Zeilen begrenzt, bei einer großen Website also eine Stichprobe.
- Sind sie neu? Eine URL, die letzte Woche veröffentlicht wurde, ist noch kein Problem. Googles eigene Zeitangaben finden Sie in der Tabelle unten.
So beheben Sie es, nach Websitegröße
Der richtige erste Schritt hängt von der Größe Ihrer Website ab. Beginnen Sie also in der passenden Spalte.
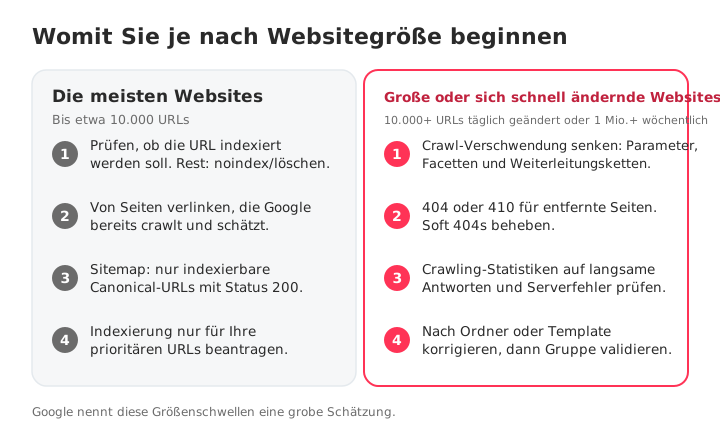
Die meisten Websites: bis etwa 10.000 URLs
- Prüfen Sie, ob die URL eine Indexierung verdient. Wenn nicht, setzen Sie noindex oder löschen Sie sie und nehmen Sie sie aus Ihrer Liste.
- Verlinken Sie sie von Seiten, die Google bereits crawlt. Fügen Sie kontextbezogene Links mit aussagekräftigen Ankertexten von indexierten Seiten mit Traffic hinzu. Jeder Crawler kann Ihre verwaisten Seiten auflisten, indem er nach null internen Links filtert, und dieser Leitfaden zur internen Verlinkung beschreibt die gesamte Methode.
- Halten Sie die Sitemap sauber. Nehmen Sie nur URLs auf, die 200 liefern, indexierbar und die kanonische Version sind, mit einem korrekten
lastmod. Google ignoriert priority und changefreq. Brauchen Sie zuerst die Datei, finden Sie Ihre Sitemap. Meldet die Search Console, dass sie keine findet, lesen Sie Keine verweisenden Sitemaps erkannt. - Beantragen Sie die Indexierung für eine Handvoll prioritärer URLs. Öffnen Sie das URL-Prüftool und klicken Sie auf Indexierung beantragen. Google wendet ein Kontingent an und sagt, dass wiederholte Anträge nichts beschleunigen. Heben Sie sich das also für die wichtigsten Seiten auf.
Große oder sich schnell ändernde Websites: 10.000+ URLs täglich geändert oder 1 Mio.+ wöchentlich
- Senken Sie die Crawl-Verschwendung. Sperren Sie URL-Bereiche ohne Suchwert (Parameter, Facetten, interne Suche) in der robots.txt und führen Sie Duplikate mit Canonicals und 301-Weiterleitungen zusammen. Verlassen Sie sich nicht auf noindex, um Budget zu sparen: Google ruft diese Seiten weiterhin ab.
- Geben Sie für entfernte Seiten 404 oder 410 zurück und beheben Sie Soft 404s. Google nennt einen 404 ein starkes Signal, eine URL nicht erneut zu crawlen, während blockierte URLs länger in der Warteschlange bleiben. Kürzen Sie lange Weiterleitungsketten.
- Prüfen Sie die Crawling-Statistiken. Unter „Einstellungen“ zeigt der Bericht „Crawling-Statistiken“ Antwortzeiten und Serverfehler. Sind sie hoch, senkt Google Ihr Kapazitätslimit, und keine Inhaltskorrektur hilft, bis der Server besser ist.
- Korrigieren Sie nach Ordner oder Template und validieren Sie dann die Gruppe. Treffen Sie eine Entscheidung pro Muster, erstellen Sie eine Sitemap nur mit den korrigierten URLs und klicken Sie auf Fehlerbehebung überprüfen. Mehr zum Crawl-Budget, falls Ihre Website in diesem Bereich liegt.
Warten oder handeln?
Das Schwierigste ist nicht die Lösung, sondern zu wissen, wann man aufhört zu warten. Nutzen Sie Googles eigene Spannen und Ihren eigenen Trend.
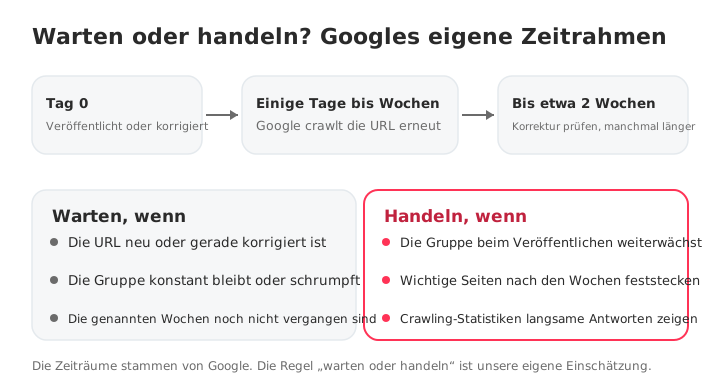
| Was Sie getan haben | Was Google sagt | Quelle |
|---|---|---|
| Google um ein erneutes Crawling gebeten | Einige Tage bis einige Wochen | Google um erneutes Crawling bitten |
| Indexierung beantragt | In der Regel etwa einen Tag, bis zu ein oder zwei Wochen, mit Tageslimit | Hilfe zum URL-Prüftool |
| Fehlerbehebung überprüfen | Bis zu etwa zwei Wochen, manchmal deutlich länger | Hilfe zur Seitenindexierung |
Die Zeitspannen stammen von Google. Die Regel „warten oder handeln“ ist unsere: Warten Sie, solange die URL neu ist und die Gruppe konstant bleibt oder schrumpft, und handeln Sie, wenn die Gruppe weiter wächst oder Ihre wichtigen Seiten nach diesen Wochen feststecken.
So behalten Sie es im Zeitverlauf im Blick
Die Search Console zeigt den neuesten Stand jeder URL und eine auf 1.000 Zeilen begrenzte Liste. Bauen Sie sich daher eine eigene Routine:
- Exportieren Sie die Liste einmal im Monat und vergleichen Sie sie mit der vorherigen. Wächst die Gruppe, bleibt sie gleich oder schrumpft sie?
- Gruppieren Sie nach Muster (Sprache, Ordner, Template), bevor Sie einzelne URLs ansehen.
- Prüfen Sie, wie Google jede URL gefunden hat. Eine Liste, die nur aus „Sitemap“ und nie aus „verweisender Seite“ besteht, wie bei unseren 14 URLs, deutet direkt auf die interne Verlinkung.
Die Ansicht Indexierung von SEOcrawl AI liefert Ihnen diese Liste fertig: Filtern Sie nach Abdeckungsstatus, um die enthaltenen URLs mit Datum des letzten Crawls, Klicks und Impressionen zu sehen. Über den MCP erhält außerdem jede URL Googles Canonical im Vergleich zum deklarierten und die Angabe, ob sie über die Sitemap oder eine verweisende Seite gefunden wurde. Der Crawler prüft die Seiten selbst, sodass Sie erkennen, was an einer URL schwach ist, bevor Sie Google um einen weiteren Blick bitten, und SEO Monitor warnt Sie, wenn eine wichtige Seite ein noindex bekommt, ihr Canonical ändert, einen 404 liefert oder die Sitemap verlässt.
So sieht diese Liste für unsere eigene Website aus, direkt aus der Indexierungsansicht:
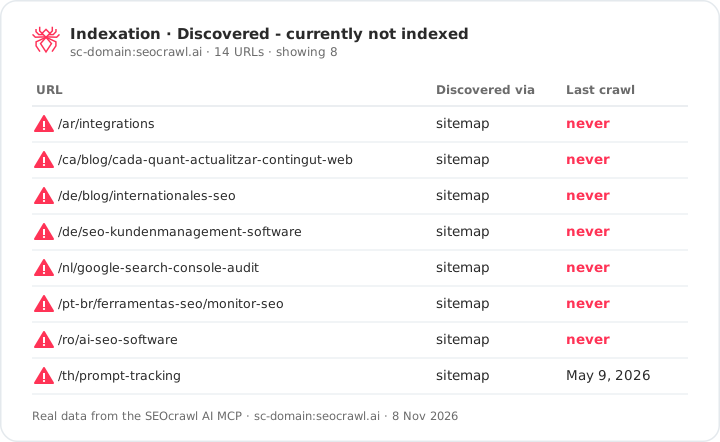
Sie können das Dashboard auch überspringen. Fragen Sie mit dem an Claude oder ChatGPT angebundenen SEOcrawl AI MCP: „Liste die URLs in Gefunden – zurzeit nicht indexiert auf und gruppiere sie nach Ordner.“ Hier ist die Schritt-für-Schritt-Anleitung, um die Search Console mit Claude und ChatGPT zu verbinden.
Häufige Fragen
Was bedeutet „Gefunden – zurzeit nicht indexiert“?
Es bedeutet, dass Google Ihre URL gefunden, aber noch nicht gecrawlt hat. Meist hat Google das Crawling geplant und dann verschoben, weshalb das Datum des letzten Crawls leer ist (Hilfe zur Seitenindexierung). Google hat die Seite nicht gelesen, der Status sagt also nichts über ihre Qualität. Er ist keine Abstrafung.
Wie lange dauert „Gefunden – zurzeit nicht indexiert“?
Google nennt für diesen Status keine Zeit. Es sagt aber, dass ein beantragtes erneutes Crawling einige Tage bis einige Wochen dauert und die Überprüfung einer Fehlerbehebung bis zu etwa zwei Wochen, manchmal deutlich länger. Eine neue URL braucht möglicherweise einfach diese Wochen. Wächst die Gruppe mit jeder Veröffentlichung weiter, warten Sie nicht länger, sondern handeln Sie.
Behebt eine Indexierungsanfrage das Problem?
Sie kann bei einer Handvoll prioritärer URLs helfen, weil sie Google bittet, die Seite einzuplanen. Sie beseitigt die Ursache nicht, sodass eine Seite wieder im selben Status landen kann. Anträge unterliegen einem Tageskontingent, und Google sagt, dass mehrfaches Senden derselben URL nichts beschleunigt. Nutzen Sie sie nach der Verbesserung der internen Links, nie als Massenwerkzeug.
Ist es eine Abstrafung?
Nein. Manuelle Maßnahmen erscheinen in einem eigenen Bericht. Dieser Status bedeutet, dass Google die URL gefunden und noch nicht gecrawlt hat und die Seite daher nicht bewertet hat. Die Ursache ist meist die Crawling-Priorität: schwache interne Links, ein langsamer Server oder ein Haufen wenig wertvoller URLs, die um Crawls konkurrieren.
Warum sind so viele meiner Seiten gefunden, aber nicht indexiert?
Eine hohe Zahl deutet meist auf ein Muster statt auf einzelne Seiten hin: URL-Parameter oder Facetten, Duplikate, eine Sitemap mit URLs, die dort nicht hingehören, schwache interne Links zu einem ganzen Bereich oder ein Server, der den Googlebot ausbremst. Gruppieren Sie die URLs nach Ordner, Sprache oder Template, bevor Sie eine einzelne ansehen.
Muss ich mir bei einer kleinen Website Sorgen machen?
In der Regel nicht. Google sagt, dass Sie bei weniger als 500 Seiten den Seitenindexierungsbericht vermutlich gar nicht brauchen. Ein paar neue URLs in diesem Status brauchen meist nur Zeit und ein paar interne Links von Seiten, die Google bereits crawlt.
Wie hilft SEOcrawl AI bei gefundenen URLs?
Die Ansicht Indexierung von SEOcrawl AI listet die URLs auf, die in den einzelnen Abdeckungsstatus von Google feststecken, mit Datum des letzten Crawls, Klicks und Impressionen. Über den SEOcrawl AI MCP können Sie Claude oder ChatGPT außerdem nach dieser Liste mit Googles Canonical im Vergleich zum deklarierten fragen, samt der Angabe, ob Google jede URL über die Sitemap oder eine verweisende Seite gefunden hat, und sie nach Ordner gruppieren lassen.
Mehr von SEOcrawl AI bei Google
Wähle uns als bevorzugte Quelle und du siehst mehr unserer Artikel in den Top-Meldungen von Google.
Autor: David Kaufmann
In den letzten über 10 Jahren habe ich mich komplett dem SEO verschrieben — und ehrlich gesagt möchte ich es nicht anders haben.
Meine Karriere erreichte eine neue Stufe, als ich als Senior SEO Specialist für Chess.com gearbeitet habe — eine der 100 meistbesuchten Websites im gesamten Internet. In dieser Größenordnung zu arbeiten, über Millionen von Seiten, Dutzende Sprachen und in einer der umkämpftesten SERPs überhaupt, hat mich Dinge gelehrt, die kein Kurs und kein Zertifikat je vermitteln könnte. Diese Erfahrung hat meine Sichtweise darauf verändert, wie großartiges SEO wirklich aussieht — und sie wurde zum Fundament für alles, was ich seitdem aufgebaut habe.
Aus dieser Erfahrung heraus habe ich SEO Alive gegründet — eine Agentur für Marken, die es mit organischem Wachstum ernst meinen. Wir sind nicht hier, um dashboards und monatliche Reports zu verkaufen. Wir sind hier, um Strategien zu entwickeln, die wirklich etwas bewegen, indem wir das Beste aus dem klassischen SEO mit der spannenden neuen Welt der Generative Engine Optimization (GEO) verbinden — damit deine Marke nicht nur in den blauen Links von Google auftaucht, sondern auch in den AI-generierten Antworten, die ChatGPT, Perplexity und Google AI Overviews tagtäglich Millionen von Menschen liefern.
Und weil ich kein Tool finden konnte, das beide Welten richtig abdeckt, habe ich selbst eines gebaut — SEOcrawl AI, eine Enterprise-SEO-Intelligence-Plattform, die rankings, technische Audits, backlinks-Monitoring, crawl-Health und AI-Brand-Visibility-Tracking an einem Ort vereint. Es ist die Plattform, die ich mir immer gewünscht habe.
Entdecke weitere Inhalte von diesem Autor
Wir haben Google-Klicks und KI-Referral-Traffic auf über 16.000 Websites in 15 Branchen gemessen. Der KI-Traffic wächst um 45 % pro Jahr, entspricht aber noch immer nur etwa 1 Besuch pro 100 Besuche von Google – während die Google-Klicks um 15 % gesunken sind.

Bis zum 30. November kostet das erste Jahr jedes SEOcrawl-AI-Jahrestarifs mit dem Code BLACKFRIDAY2026 nur die Hälfte. Das bekommst du, was die Prompts der einzelnen Tarife abdecken und wie du in 15 Minuten siehst, wo dich ChatGPT, Gemini, Claude und Perplexity erwähnen.