Ошибка переадресации в Google Search Console: причины и решения
Вы открыли отчёт «Индексирование страниц» в Search Console и нашли URL со статусом «Ошибка переадресации» (Redirect error). В отличие от большинства статусов в этом отчёте, этот указывает на настоящую проблему.
Если коротко: Google попытался пройти по редиректу с вашего URL и не смог добраться до рабочей страницы. Пока вы это не исправите, URL остаётся вне индекса, а вместе с ним и контент, на который вы хотели его перенаправить.
Хорошая новость в том, что ошибки переадресации обычно быстро диагностируются, если знать, на что смотреть. В этом руководстве мы разберём, что означает этот статус, какие причины называет Google, как отследить каждую из них и как всё исправить и подтвердить исправление.
Что означает «Ошибка переадресации» в Search Console
«Ошибка переадресации» — одна из причин в таблице «Почему эти страницы не индексируются» отчёта «Индексирование страниц» в Google Search Console. Она появляется, когда Googlebot идёт по редиректу с вашего URL, но так и не попадает на конечный адрес, который может просканировать, поэтому ни исходный URL, ни целевой не индексируются по этому пути.
Этот статус легко спутать со «Страница с переадресацией» (Page with redirect), поэтому сразу уточним: тот статус нормален. Он означает, что редирект сработал: URL не индексируется, потому что ведёт на другой адрес, а Google оценивает целевую страницу отдельно. «Ошибка переадресации» означает, что сам редирект не сработал.
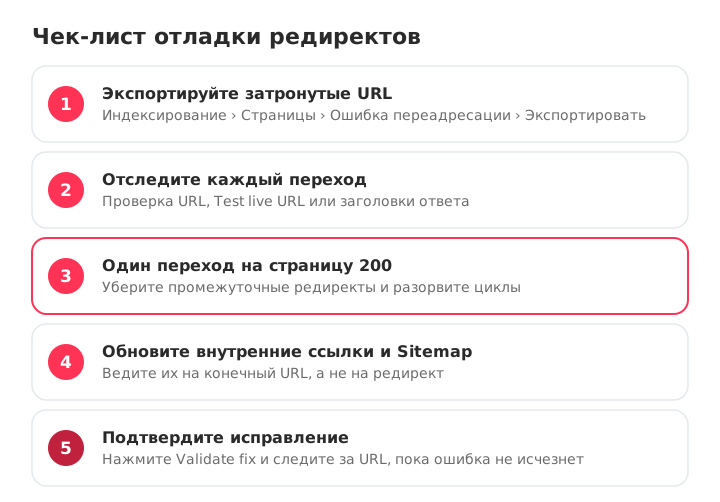
Найти её можно в разделе Индексирование › Страницы. Нажмите на строку «Ошибка переадресации», чтобы увидеть затронутые URL, и с помощью кнопки Экспортировать скачайте полный список.
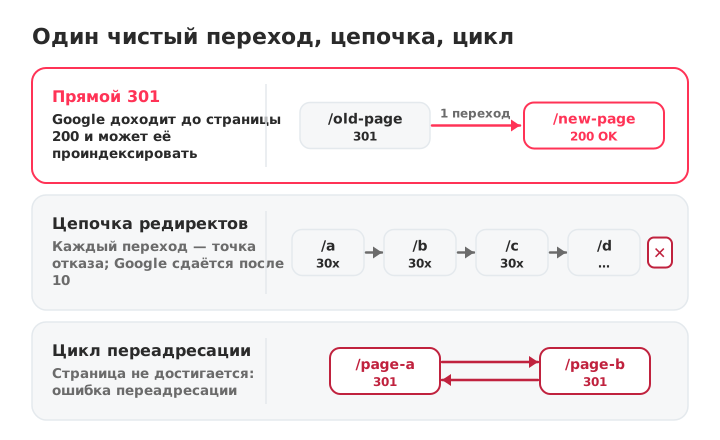
Частые причины ошибки переадресации
В документации к отчёту «Индексирование страниц» Google перечисляет четыре ситуации, которые приводят к этому статусу. Ещё две часто встречаются на практике.
1. Слишком длинная цепочка редиректов
Каждый URL, который перенаправляет на другой, добавляет один переход. Поисковые роботы Google проходят не более 10 переходов, согласно документации Google по сканированию. Дальше Googlebot сдаётся, и Search Console сообщает об ошибке переадресации. Цепочки обычно разрастаются со временем: сначала правило HTTP → HTTPS, потом правило для www, потом правило для слеша в конце URL, а сверху ещё и миграция сайта.
2. Цикл переадресации
URL A перенаправляет на URL B, а URL B — обратно на URL A (или на любой адрес, который снова ведёт к A). Цепочка никогда не завершается, и ни одна страница так и не достигается. Циклы часто возникают из-за двух противоречащих друг другу правил, например одно добавляет слеш в конце URL, а другое его убирает.
3. URL редиректа превышает максимальную длину
Если правило редиректа на каждом переходе что-то дописывает к URL, например параметр или сегмент пути, адрес растёт, пока не превысит максимальную длину URL, и цепочка обрывается.
4. Неверный или пустой URL в цепочке
Опечатка вроде htp:// вместо http://, относительный путь, который ведёт не туда, или пустой заголовок Location ломают редирект на этом переходе.
5. Конечный адрес, который Google не может просканировать
Если конечный URL заблокирован в robots.txt, Googlebot не сможет его загрузить. Проверяйте не только то, что цель каждого редиректа существует, но и то, что она доступна для сканирования.
6. Конфликтующие правила редиректов в разных местах
Редиректы, настроенные в CMS, в плагине, на веб-сервере и в CDN, могут накладываться друг на друга или конфликтовать. Правило, добавленное на одном уровне, может вернуть URL к правилу на другом, и именно так появляется большинство цепочек и циклов.
Как диагностировать ошибку переадресации
Начните с конкретных URL, которые отмечает Search Console, а затем отследите, что происходит при запросе каждого из них.
Используйте проверку URL
Вставьте затронутый URL в строку проверки в верхней части Search Console. В разделе Индексирование страницы видно, когда Google последний раз сканировал страницу и удалось ли её загрузить. Нажмите Test live URL, чтобы проверить текущее поведение, ведь отчёт может отставать от ваших исправлений.
Отследите весь путь переадресации
Запросите URL и пройдите по каждому переходу. Из терминала:
curl -sIL https://example.com/old-page | grep -iE "^(HTTP|location)"
В выводе по порядку перечислены все коды ответа и заголовки Location. Ищите больше одного перехода, URL, который встречается дважды (цикл), некорректный Location или последний ответ, отличный от 200.
Если не хотите работать в терминале, бесплатный SEO-аудит на странице Crawler от SEOcrawl AI подсчитывает переходы редиректа для любого URL, а инструмент fetch_url в MCP-сервере SEOcrawl AI возвращает конечный URL, код ответа и всю цепочку редиректов прямо в Claude, ChatGPT или Cursor.
Проверьте код ответа конечной страницы
Убедитесь, что последний URL в цепочке отдаёт 200, а не очередной 3xx, 4xx или 5xx. Если цепочка заканчивается ошибкой, проблема находится на конечной странице: см. наши руководства по статусам Not found (404) и Blocked due to other 4xx issue.
Как исправить каждую причину
Решение почти всегда строится на одной идее: перенаправить исходный URL на конечный адрес одним чистым переходом.
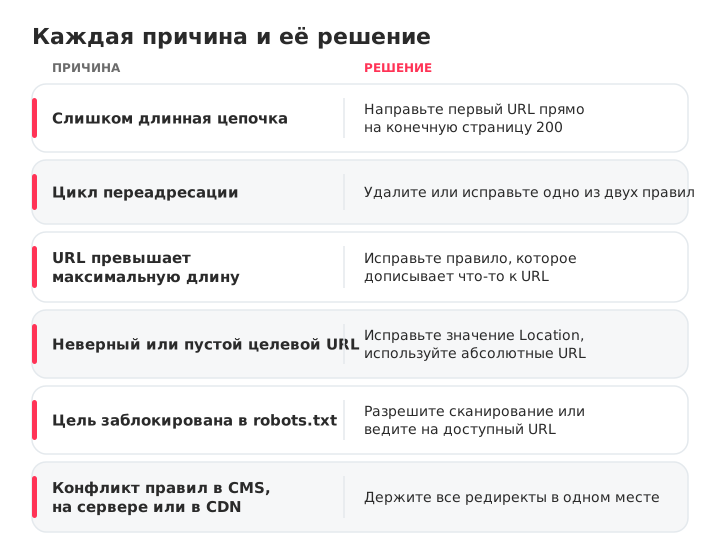
- Слишком длинная цепочка: направьте первый URL прямо на конечный URL с кодом 200 и уберите промежуточные переходы. Если в одну цепочку ведут несколько старых URL, обновите каждый из них.
- Цикл переадресации: найдите два правила, которые ссылаются друг на друга, и удалите или исправьте одно из них, чтобы путь заканчивался на настоящей странице.
- Слишком длинный URL: исправьте правило, которое постоянно дописывает что-то к URL, затем убедитесь, что конечная страница загружается.
- Неверная или пустая цель: исправьте опечатку или пустое значение
Locationи используйте абсолютные URL. - Конечный адрес заблокирован в robots.txt: разрешите сканирование конечной страницы или перенаправьте на URL, который не заблокирован.
- Конфликтующие правила: держите редиректы в одном месте, чтобы CMS, сервер и CDN не перезаписывали друг друга.
Затем обновите внутренние ссылки, чтобы они вели на конечный URL, а не на перенаправляющий, и оставьте в XML-файле Sitemap только конечные URL. Crawler находит оба случая по всему сайту: внутренние ссылки, которые отдают 3xx, и файлы Sitemap со ссылками на перенаправляющие URL. Чтобы проверить отдельный Sitemap, прогоните его через бесплатный валидатор Sitemap: он проверяет коды ответа и цепочки редиректов для каждого URL в файле.
Лучшие практики настройки редиректов
Несколько привычек предотвращают большинство ошибок переадресации ещё до их появления.
- Используйте правильный код ответа. Редирект 301 (или 308) — сильный сигнал, что индексировать нужно целевую страницу: используйте его для постоянных переездов. Редирект 302 (или 307) — слабый сигнал, который оставляет в результатах исходный URL: используйте его, только если переезд временный.
- Отдавайте предпочтение серверным редиректам. Google также проходит по мгновенным meta refresh и JavaScript-редиректам, но рекомендует использовать JavaScript, только если серверный редирект или meta refresh невозможны.
- Делайте цепочки короткими. Идеально — один переход. Каждый лишний переход замедляет пользователей, расходует краулинговый бюджет и добавляет ещё одну точку отказа.
- Всегда перенаправляйте на URL, который отдаёт 200, а не на очередной редирект.
- Обновляйте внутренние ссылки и файлы Sitemap, указывая конечные URL, чтобы Google и посетители вообще не проходили через редирект.
- Перепроверяйте всё после каждой миграции или изменения правил в CMS, на сервере или в CDN: именно тогда появляются новые цепочки и циклы.
Как подтвердить исправление
Когда редирект за один переход приводит на страницу с кодом 200:
- Запустите проверку URL для затронутого адреса и нажмите Test live URL, чтобы убедиться, что Google теперь добирается до конечной страницы.
- Нажмите Запросить индексирование для самых важных URL.
- В отчёте «Индексирование страниц» откройте проблему «Ошибка переадресации» и нажмите Validate fix, чтобы Google повторно просканировал все затронутые URL.
- Следите за статусом проверки. Она может занять от нескольких дней до пары недель; URL исчезают из списка по мере повторного сканирования.
Опережайте ошибки переадресации
Ошибки переадресации редко заявляют о себе сами. Они появляются в отчёте «Индексирование страниц», и на большом сайте могут оставаться незамеченными, пока не упадёт трафик. Проверять Search Console вручную для каждого ресурса долго, и об этом легко забыть.
Раздел Indexation в SEOcrawl AI группирует ваши URL по статусу покрытия в Search Console, поэтому вы видите, какие URL находятся в состоянии ошибки, и можете отслеживать, как их число меняется со временем. Затронутые URL можно помечать тегами по правилам, вручную или через MCP-сервер и разбирать их, пока каждый не будет исправлен. Если вы работаете с AI-ассистентом, аудит Google Search Console проверяет покрытие индекса одним промптом и создаёт задачу для каждого исправления.
Часто задаваемые вопросы
Что вызывает ошибку переадресации в Google Search Console?
Google называет четыре причины: слишком длинная цепочка редиректов, цикл переадресации, URL редиректа, который в итоге превышает максимальную длину URL, и неверный или пустой URL в цепочке. В каждом из этих случаев Googlebot не может добраться до рабочей конечной страницы.
Как исправить ошибку переадресации?
Перенаправьте исходный URL на конечный адрес за один переход. Уберите промежуточные редиректы, разорвите цикл, если он есть, и убедитесь, что последний URL отдаёт код 200. Обновите внутренние ссылки, чтобы они вели на конечный адрес, затем запустите проверку URL и нажмите Validate fix в отчёте «Индексирование страниц».
Что такое цепочка редиректов и цикл переадресации?
Цепочка редиректов — это серия перенаправлений, в которой URL A ведёт на B, B ведёт на C и так далее, пока не будет достигнута конечная страница. Цикл переадресации — это цепочка, которая никогда не заканчивается, потому что URL ссылаются друг на друга. И то и другое может помешать Google добраться до страницы и проиндексировать её.
301 или 302: какой редирект выбрать?
Используйте 301 (или 308) для постоянного переезда: Google воспринимает его как сильный сигнал индексировать целевую страницу. Используйте 302 (или 307) только для временного переезда, когда нужно, чтобы исходный URL оставался в результатах поиска.
«Страница с переадресацией» и «Ошибка переадресации» — это одно и то же?
Нет. «Страница с переадресацией» означает, что редирект сработал: URL не индексируется, потому что ведёт на другую страницу. «Ошибка переадресации» означает, что Google попытался пройти по редиректу и так и не добрался до рабочей страницы.
Сколько времени нужно, чтобы ошибка переадресации исчезла?
После нажатия Validate fix Google повторно сканирует затронутые URL в течение следующих дней, иногда до двух недель. Статус обновляется по мере обработки каждого URL, поэтому запрашивать индексирование для каждого адреса вручную не нужно.
Автор: David Kaufmann
Последние 10 с лишним лет я полностью одержим SEO — и, честно говоря, не хотел бы иначе.
Моя карьера вышла на новый уровень, когда я работал старшим SEO-специалистом в Chess.com — одном из ста самых посещаемых сайтов интернета. Работа в таком масштабе: миллионы страниц, десятки языков и одна из самых конкурентных выдач — научила меня тому, чему не научит ни один курс и ни один сертификат. Этот опыт изменил моё представление о том, как выглядит по-настоящему сильное SEO, и лёг в основу всего, что я построил потом.
Из него выросло SEO Alive — агентство для брендов, которые всерьёз занимаются органическим ростом. Мы не продаём дашборды и ежемесячные отчёты. Мы строим стратегии, которые реально двигают цифры, соединяя классическое SEO с новым и захватывающим миром Generative Engine Optimization (GEO): чтобы ваш бренд появлялся не только в синих ссылках Google, но и внутри ответов, которые ChatGPT, Perplexity и Google AI Overviews каждый день выдают миллионам людей.
А поскольку инструмента, который нормально закрывает оба этих мира, я так и не нашёл, я сделал его сам — SEOcrawl AI, платформу SEO-аналитики корпоративного уровня, где в одном месте собраны позиции, технические аудиты, мониторинг ссылок, здоровье краулинга и отслеживание видимости бренда в AI. Это та платформа, которой мне всегда не хватало.
Откройте больше материалов этого автора
CTR показывает, сколько людей из тех, кто увидел ваш результат, действительно по нему кликнули. Разбираем формулу, какой CTR считается хорошим в 2026 году по каналам и позициям в Google и как получить больше кликов с позиций, которые у вас уже есть.
Видите в Search Console статус «Alternate page with proper canonical tag»? Чаще всего Google делает именно то, о чём вы его просили. Рассказываем, как отличить нормальные случаи от настоящих проблем и как исправить те, что действительно важны.