«Заблокировано из-за другой ошибки 4xx»: как исправить
Вы открываете Search Console, и вот оно: Не проиндексировано: «Заблокировано из-за другой ошибки 4xx». Ни кода статуса, ни затронутого файла, ни очевидной причины.
В этом руководстве разбираем, какие именно ошибки вызывают такую формулировку, как найти реальный код статуса за ней и как устранить каждую причину — включая диагностические шаги, которые большинство материалов пропускает. О том, где этот отчёт находится внутри инструмента целиком, читайте в нашем полном руководстве по Google Search Console.
Что на самом деле означает «заблокировано из-за другой ошибки 4xx»
«Заблокировано из-за другой ошибки 4xx» означает, что Googlebot запросил URL и получил ответ 4xx (на стороне клиента), который Search Console не выносит в собственную категорию.
Поскольку Google не смог получить страницу, он её не проиндексирует. В таких случаях URL остаётся вне результатов поиска, пока не начнёт отдавать успешный статус.
Ключевое слово здесь — «другой». У Search Console уже есть отдельные формулировки для трёх самых частых кодов 4xx:
- 401 → «Заблокировано из-за неавторизованного запроса (401)».
- 403 → «Заблокировано из-за запрета доступа (403)».
- 404 → «Не найдено (404)».
Так что «другая 4xx» становится зонтиком для всего остального в диапазоне 4xx: 400, 405, 408, 410, 429 и похожих кодов. Сообщение расплывчатое, потому что Google знает, что произошла 4xx, но это не та, для которой у него есть ярлык.
Какие коды статуса 4xx вызывают эту ошибку
Вот коды, которые чаще всего попадают под эту формулировку. Прежде чем что-то чинить, нужно понять, какой из них на самом деле отдаёт ваш сервер.
| Код | Название | Типичная причина |
|---|---|---|
| 400 | Bad Request | Некорректный URL, недопустимые символы, повреждённый запрос |
| 405 | Method Not Allowed | Сервер отклоняет метод запроса (например, GET отключён на этом пути) |
| 406 | Not Acceptable | Несовпадение при согласовании содержимого |
| 408 | Request Timeout | Сервер слишком медленно отвечает в отведённое окно |
| 410 | Gone | Страница удалена навсегда (см. примечание ниже) |
| 411 / 412 / 421 / 422 | Разные | Проблемы с длиной / предусловием / неверной адресацией / необрабатываемым запросом |
| 429 | Too Many Requests | Ограничение частоты запросов (очень частая причина на крупных или агрессивно защищённых сайтах) |
| 451 | Unavailable for Legal Reasons | Гео- или юридическая блокировка |
| 418 | I'm a teapot | Шуточный статус, описанный в RFC (редкость, но реальный код, который некоторые конфигурации иногда отдают) |
Примечание про 410 (Gone): если страница намеренно удалена навсегда, 410 — это правильный ответ, и «чинить» его не надо. Просто убедитесь, что это не страница, которую вы на самом деле хотите видеть в индексе.
Из-за чего у Googlebot возникают ошибки 4xx
Большинство случаев сводится к одной из этих пяти причин:

- Правила безопасности и WAF. Фаерволы вроде Cloudflare, Sucuri или AWS WAF иногда принимают Googlebot за угрозу и отдают 403 или блокируют запрос. Плагины безопасности в WordPress могут делать то же самое.
- Ограничение частоты запросов (429). Сервер отдаёт 429, когда решает, что запросов пришло слишком много и слишком быстро, а Google не станет индексировать страницу, на которой его постоянно ограничивают.
- Конфигурация сервера или CDN. Правило CDN, директива в .htaccess или изменение шаблона могут начать отдавать 4xx на URL, которые в вашем браузере открываются нормально.
- Некорректные URL (400). 400 означает, что сервер не смог понять запрос — часто из-за неправильной структуры URL или плохих параметров. Это типично для фасетной навигации и параметров сессии / отслеживания.
- Права доступа к файлам. Слишком жёстко выставленные права на каталоги (например, 700 вместо 755) могут вызвать 403.
Полезный признак: поскольку это ответы на стороне клиента, привязанные к тому, как сделан запрос, в собственном браузере вы ту же ошибку часто не увидите — именно поэтому отчёт кажется таким непрозрачным.
Как найти точный код статуса 4xx, который получил Google
Search Console сообщает, что страница затронута, но не говорит, какой код 4xx она вернула. Найти его придётся вам самим. Пройдите такую последовательность:
- Составьте список затронутых URL. В Search Console перейдите в Индексирование → Страницы, прокрутите до «Почему страницы не индексируются» и нажмите «Заблокировано из-за другой ошибки 4xx», чтобы увидеть полный список. Они находятся в разделе «Страницы» → вкладка «Не проиндексировано».
- Проверьте URL. Нажмите на URL, затем «Проверить страницу» в инструменте проверки URL. Он покажет ровно то, что увидел Googlebot, включая HTTP-ответ и любые редиректы.
- Запросите страницу как Googlebot. Поскольку ошибка часто зависит от user agent, воспроизведите её с user agent Googlebot. В Chrome DevTools откройте вкладку Network conditions, снимите галочку «Use browser default», выберите «Googlebot Smartphone», затем перезагрузите страницу и посмотрите код статуса. Также можно выполнить
curl -A "Googlebot" -I https://yoururlиз терминала. - Проверьте логи сервера. Логи показывают реальный код статуса, который ваш сервер вернул на IP-адреса Google, — это истина в последней инстанции, когда DevTools и браузер расходятся.
- Убедитесь, что это действительно Googlebot. Если блокирует WAF, перед расширением доступа подтвердите, что запрашивающий IP действительно принадлежит Google, чтобы не открыть дверь поддельным ботам.

Как исправить каждую ошибку 4xx, код за кодом
Как только вы знаете код, решение следует из него:
| Код 4xx | Вероятная причина | Как исправить |
|---|---|---|
| 403 | WAF или фаервол блокирует Googlebot | Добавьте подтверждённый Googlebot в белый список или подправьте правило, которое его ловит. Исправьте права доступа к файлам, если причина в них. |
| 429 | Ограничение частоты запросов | Поднимите или настройте лимит частоты для подтверждённых поисковых ботов и проверьте, не душит ли сканирование плагин или CDN. |
| 400 | Некорректный URL | Исправьте структуру URL, прекратите генерировать недопустимые комбинации параметров и канонизируйте параметризованные URL. |
| 405 / 406 / 408 | Правило сервера, согласование содержимого или таймаут | Исправьте серверное правило, согласование содержимого или поведение таймаута для затронутых путей. |
| 410 (не должна быть удалена) | Страница удалена по ошибке | Восстановите страницу или поставьте 301 редирект на ближайший аналог, если у неё есть ценность и бэклинки. |
| 404 / 410 (намеренно) | URL действительно мёртв | Оставьте как есть. Это не ошибки, которые надо чинить. Если объёмы большие, закройте лишнее сканирование через robots.txt. |
Как подтвердить исправление 4xx в Search Console
После устранения первопричины вернитесь в отчёт «Заблокировано из-за другой ошибки 4xx» и нажмите «Проверить исправление».
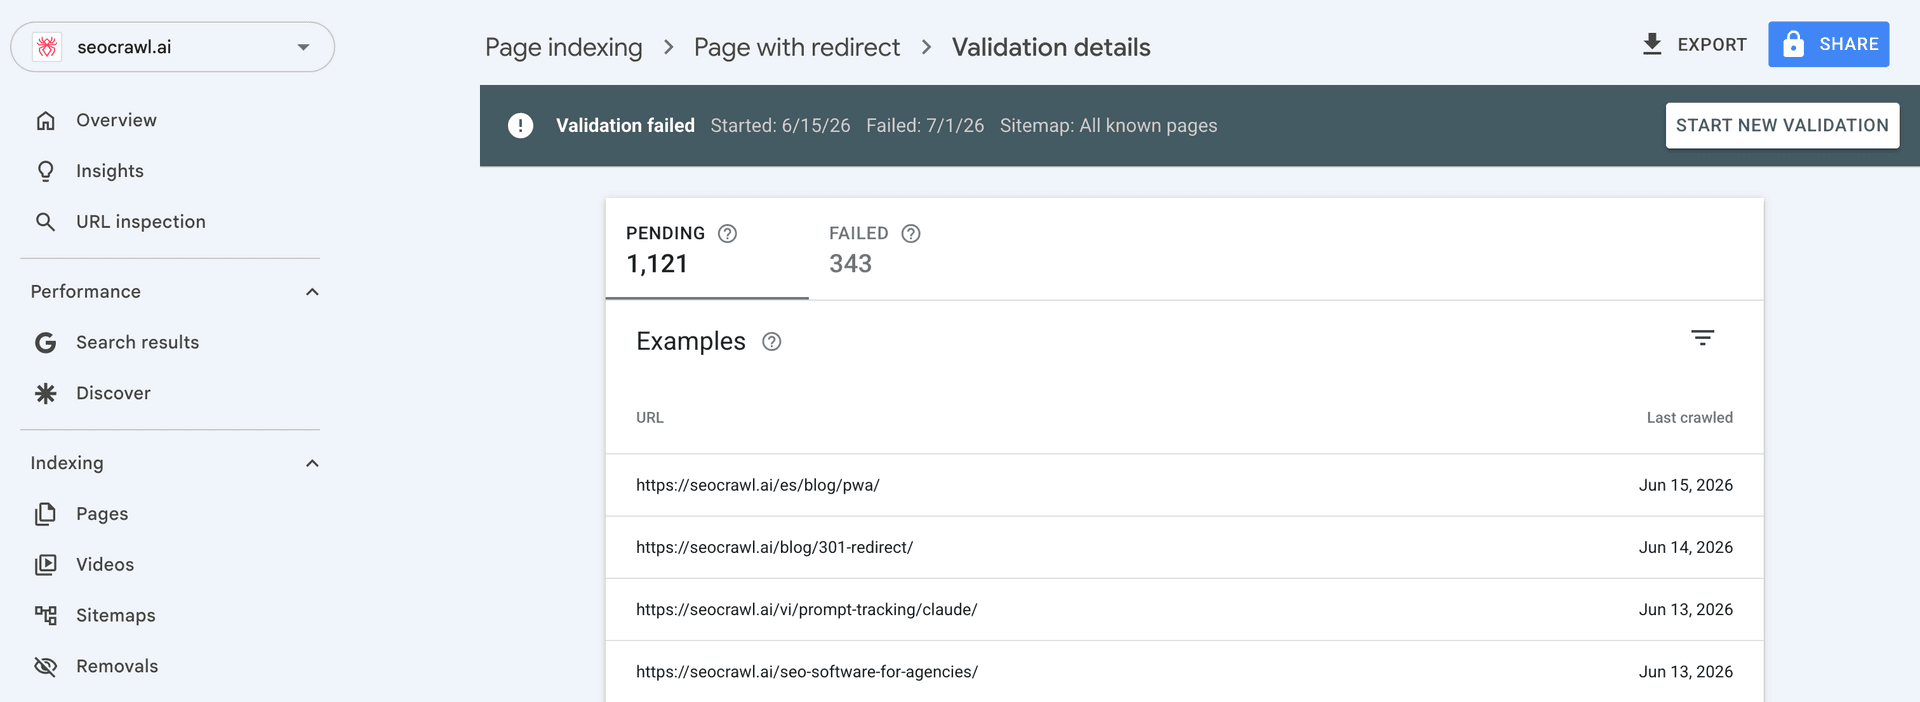
Google пересканирует затронутые URL; пересканирование исправленных URL обычно занимает от нескольких дней до нескольких недель в зависимости от краулингового бюджета.
Отчёт обновляется по мере того, как Google заново обращается к каждому URL, поэтому свежие исправления не отобразятся мгновенно. Держите под рукой инструмент проверки URL, чтобы убедиться, что каждая страница теперь отдаёт 200, прежде чем полагаться на результат проверки.
Поиск URL с ошибками 4xx в масштабе с SEOcrawl AI
Search Console показывает проблему, но заставляет проверять URL по одному. SEOcrawl AI подтягивает данные о покрытии из Search Console и показывает состояния индексации по всему сайту, так что затронутые URL видно массово, а не по одному клику за раз.
Наш MCP-сервер позволяет читать полную разбивку покрытия индекса по состояниям и фильтровать просканированные страницы по коду статуса (например, все, что отдают 404) прямо из Claude или ChatGPT, а также помечать их тегами по правилам, вручную или через MCP. Добавьте к этому запланированные сканирования и оповещения — и вы поймаете всплеск URL с 4xx раньше, чем он ударит по позициям.

Найдите все URL с ошибками 4xx в одном месте. Вместо того чтобы кликать по Search Console URL за URL, SEOcrawl AI показывает полную разбивку покрытия индекса и позволяет фильтровать просканированные страницы по коду статуса прямо из Claude или ChatGPT. Попробуйте SEOcrawl AI.
FAQ
Что означает ошибка 4xx?
Ошибка 4xx — это HTTP-статус на стороне клиента: сам запрос не может быть выполнен, потому что страница не найдена, в доступе отказано, запрос сформирован неверно или сервер ограничивает частоту обращений.
В семейство 4xx входят, среди прочего, 400 (некорректный запрос), 403 (доступ запрещён), 404 (не найдено), 410 (удалено) и 429 (слишком много запросов). Для SEO любая 4xx на странице, которую вы хотите видеть в индексе, — это проблема, потому что Google не может получить контент, чтобы его ранжировать.
Вредят ли ошибки 4xx для SEO?
Вредят, когда попадают на страницы, которые вы хотите видеть в индексе. Страницу, отдающую 4xx, нельзя просканировать, поэтому она не будет ни проиндексирована, ни ранжирована, и вы теряете трафик, который она могла бы принести.
В масштабе массовые ошибки 4xx ещё и расходуют краулинговый бюджет и могут сигнализировать о плохом обслуживании сайта. Намеренные 404 и 410 на действительно мёртвых URL — это нормально; проблема в ответах 4xx на страницах, которые должны быть живыми.
Что такое ошибка 4xx в SEO?
С точки зрения SEO ошибка 4xx — это любой ответ на стороне клиента, который мешает поисковым системам получить доступ к URL. Больше всего значат 404 (битые или удалённые страницы), 403 (доступ закрыт, часто фаерволом) и коды за формулировкой «заблокировано из-за другой ошибки 4xx» — 400, 429 и 410.
Как узнать, какую именно 4xx получил Google?
Search Console не называет код, поэтому проверяйте сами. Откройте затронутый URL в инструменте проверки URL и запустите «Проверить страницу», чтобы увидеть ответ, либо запросите страницу с user agent Googlebot (через панель Network conditions в Chrome DevTools или командой curl -A "Googlebot" -I [url]).
Логи сервера дают окончательный код статуса, который ваш сервер вернул Google. Чтобы сделать это сразу по множеству URL, в SEOcrawl AI можно массово фильтровать просканированные страницы по коду статуса.
Автор: David Kaufmann

Последние 10 с лишним лет я полностью одержим SEO — и, честно говоря, не хотел бы иначе.
Моя карьера вышла на новый уровень, когда я работал старшим SEO-специалистом в Chess.com — одном из ста самых посещаемых сайтов интернета. Работа в таком масштабе: миллионы страниц, десятки языков и одна из самых конкурентных выдач — научила меня тому, чему не научит ни один курс и ни один сертификат. Этот опыт изменил моё представление о том, как выглядит по-настоящему сильное SEO, и лёг в основу всего, что я построил потом.
Из него выросло SEO Alive — агентство для брендов, которые всерьёз занимаются органическим ростом. Мы не продаём дашборды и ежемесячные отчёты. Мы строим стратегии, которые реально двигают цифры, соединяя классическое SEO с новым и захватывающим миром Generative Engine Optimization (GEO): чтобы ваш бренд появлялся не только в синих ссылках Google, но и внутри ответов, которые ChatGPT, Perplexity и Google AI Overviews каждый день выдают миллионам людей.
А поскольку инструмента, который нормально закрывает оба этих мира, я так и не нашёл, я сделал его сам — SEOcrawl AI, платформу SEO-аналитики корпоративного уровня, где в одном месте собраны позиции, технические аудиты, мониторинг ссылок, здоровье краулинга и отслеживание видимости бренда в ИИ. Это та платформа, которой мне всегда не хватало.
Откройте больше материалов этого автора