«Discovered – currently not indexed»: mida see tähendab ja kuidas seda parandada
Google teab, et su URL on olemas, ent pole seda veel külastanud. Nii otsustad, kas oodata või tegutseda, ja milliseid parandusi proovida esmalt väikesel ja suurel saidil.
Discovered – currently not indexed tähendab, et Google leidis URL-i, kuid pole seda veel roomanud. Nii kirjeldab seda Google'i lehtede indekseerimise aruande abi. Tavaliselt kavatses Google roomata ja lükkas selle edasi, et su saiti mitte üle koormata, mistõttu on aruandes viimase roomamise kuupäev tühi.
See on roomamise prioriteedi staatus, mitte otsus su sisu kohta, sest Google ei ole lehte veel lugenud. Allpool näed, kuidas see erineb staatusest «Crawled», mida leidsime oma saiti kontrollides ja saidi suuruse järgi järjestatud parandusi. Kasutad aruannet esimest korda? Alusta sellest Google Search Console'i juhendist.
Mida «Discovered – currently not indexed» tähendab
Google viib URL-i läbi nelja sammu: leiab, roomab, indekseerib ja alles siis võib kuvada tulemustes. Kaks Search Console'i staatust kirjeldavad URL-i, mis jäi teel kinni.
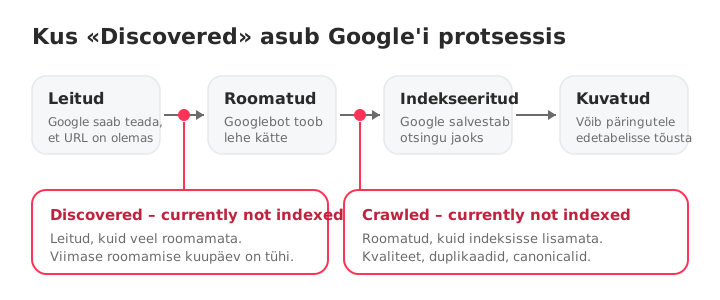
URL jõuab olekusse «leitud» saidikaardi või teiste lehtede linkide kaudu. Seejärel otsustab Google, millal see roomata. «Discovered» tähendab, et seda otsust pole veel tehtud.
Erinevus staatusest «Crawled – currently not indexed»
Need kaks staatust näevad välja sarnased, kuid nõuavad erinevaid parandusi.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Kas Google on roomanud? | Ei | Jah |
| Viimase roomamise kuupäev | Tühi | Kuupäev olemas |
| Kas Google luges lehe läbi? | Ei | Jah |
| Tavaline põhjus | Roomamine edasi lükatud või madal prioriteet | Google luges lehe ja jättis selle kõrvale |
| Vaata esmalt | Sisemised lingid, saidikaart, roomamisvõimsus | Sisu kvaliteet, duplikaadid, canonical'id |
Teise staatuse täielik diagnostika on Crawled – currently not indexed juhendis.
Kuidas nimekiri päris saidil välja näeb
Kontrollisime seocrawl.ai-d SEOcrawli indekseerimise aruandes. 1000 URL-ist, mida SEOcrawl jälgib (meie saidikaart deklareerib 6310), on 823 indekseeritud ehk 82,3%. 128 on staatuses «Crawled – currently not indexed» ja 14 staatuses «Discovered – currently not indexed».
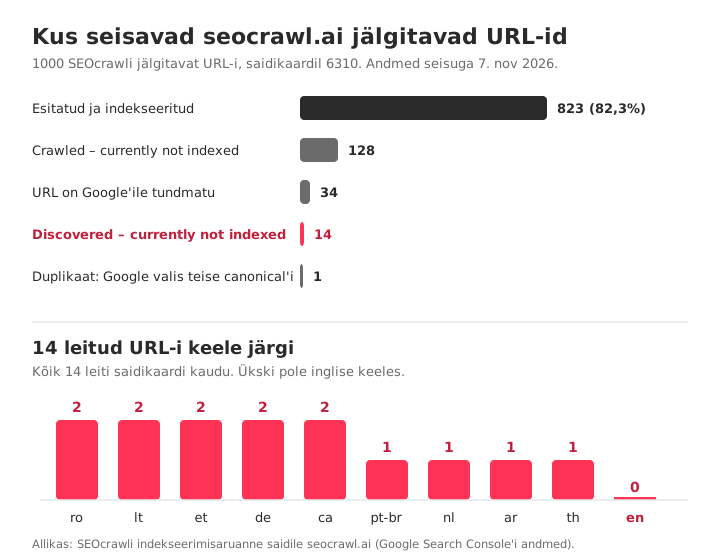
See, mis neil 14-l ühist on, on kasulik osa:
- Kõik on tõlgitud lehed: araabia, katalaani, saksa, eesti, leedu, hollandi, Brasiilia portugali, rumeenia ja tai. Ükski ei ole ingliskeelne.
- Google leidis kõik 14 saidikaardi kaudu, mitte mõne teise lehe lingi kaudu.
- Ühel neist on varasem roomamiskuupäev (9. mai 2026), seega staatus kirjeldab, kus URL praegu on, mitte seda, et Google poleks seda kunagi külastanud.
See on kontrollimist vajav muster, mitte diagnoos. Leht, mis on olemas 26 keeles ja mida jõutakse peamiselt saidikaardi kaudu, on loomulik kandidaat nõrkade sisemiste linkide jaoks, seega on sisemised lingid esimene asi, mida vaadata. Õppetund kehtib igal saidil: ära loe nimekirja URL haaval. Keele järgi rühmitatuna sai 14 URL-ist üks küsimus.
Numbrid hõlmavad 1000 URL-i, mida SEOcrawl jälgib, mis on valim kogu saidikaardist. Suurem, 128 URL-i rühm on teine staatus ja sellel on oma juhend.
Miks Google roomamise edasi lükkab
Google'i roomamisbudgeti juhend selgitab, kuidas Google otsustab, kui palju roomata: võimsuspiir, mida su server talub, ja su URL-ide nõudlus. Enamiku avastatud URL-ide põhjuseks on üks neist viiest.
- Roomamisvõimsus. Google ütleb, et piir langeb, kui sinu sait muutub aeglaseks või tagastab serveriviga. Aeglane server tähendab vähem roomamisi.
- Madal roomamisnõudlus. Nõudlus sõltub saidi suurusest, uuendamise sagedusest ning lehtede kvaliteedist ja asjakohasusest. URL, millel on vähe sisemisi linke või mitte ühtegi, annab Google'ile vähe põhjust kiiresti tagasi tulla.
- Raisatud roomamine. Dubleeritud URL-id, parameetrid, fassetid, pikad ümbersuunamisahelad ja soft 404-d konkureerivad sinu päris lehtedega. Google märgib, et soft 404-sid roomatakse edasi ja need raiskavad budgetit ning et noindexiga lehte küsitakse enne loobumist ikkagi.
- Leitud ainult saidikaardi kaudu. Saidikaart annab Google'ile teada, et URL on olemas. See ei muuda seda prioriteediks ja Google käsitleb saidikaarti vihjena. Lehed, mis leitakse ainult sealt, jäävad esimesena ootele.
- Uus sait või jaotis. Iga sait alustab sama ettevaatliku vaikimisi võimsuspiiriga, mis kasvab, kui sait tõestab oma tervist.
Roomamisbudget ise väärib tähelepanu vaid väga suurtel saitidel. Google'i jäme hinnang: 1 000 000+ unikaalset lehte, mida uuendatakse umbes nädalas, või 10 000+ lehte, mis muutuvad iga päev. Väiksematel saitidel on põhjused 2 ja 4 palju sagedasemad.
Kas see on probleem? Kolm küsimust enne mis tahes parandust
- Kas see URL peabki indekseeritud olema? Kui tegu on filtreeritud vaate, sisemise otsingulehe või test-URL-iga, on puudumine normaalne. Selle selgeks tegemiseks kasuta noindexit või tagasta 404 või 410 (vt Excluded by 'noindex' tag).
- Mitu URL-i ja mis mustriga? Google ütleb, et alla 500 lehe korral pole sul seda aruannet tõenäoliselt üldse vaja. Nimekiri on ka piiratud 1000 reaga, seega suurel saidil on see valim.
- Kas need on uued? Eelmisel nädalal avaldatud URL ei ole veel probleem. Google'i enda ajavahemikud on allolevas tabelis.
Kuidas parandada, olenevalt saidi suurusest
Õige esimene samm sõltub su saidi suurusest, seega alusta õigest veerust.
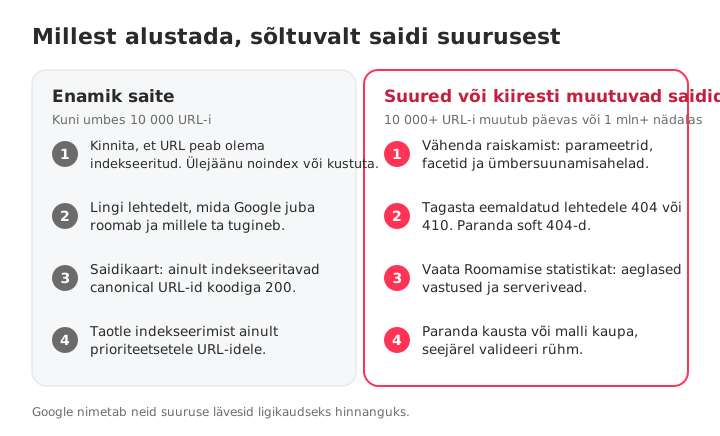
Enamik saite: kuni umbes 10 000 URL-i
- Kinnita, et URL väärib indekseerimist. Kui ei, kasuta noindexit või eemalda see ja tõmba nimekirjast maha.
- Lingi lehtedelt, mida Google juba roomab. Lisa kontekstilisi linke kirjeldava ankurtekstiga indekseeritud lehtedelt, mis saavad liiklust. Iga roomaja näitab su orbudeks jäänud lehti, filtreerides lehed, millel pole sisemisi linke, ja see sisemiste linkide juhend sisaldab kogu meetodit.
- Hoia saidikaart puhas. Lisa ainult URL-id, mis tagastavad 200, on indekseeritavad ja on canonical versioon, õige
lastmodiga. Google ignoreerib priorityt ja changefreqi. Kui vajad esmalt faili, leia oma saidikaart. Kui Search Console ütleb, et ei leia ühtegi, vaata No referring sitemaps detected. - Palu mõne prioriteetse URL-i indekseerimist. Ava URL-i kontrollimise tööriist ja klõpsa Taotle indekseerimist. Google kohaldab kvooti ja ütleb, et korduvad taotlused ei kiirenda midagi, seega hoia see kõige olulisemate lehtede jaoks.
Suured või kiiresti muutuvad saidid: 10 000+ URL-i muutub päevas või 1 mln+ nädalas
- Vähenda raisatud roomamist. Blokeeri robots.txt-is URL-ruumid, millel pole otsinguväärtust (parameetrid, fassetid, saidisisene otsing), ja koonda duplikaadid canonical'ite ning 301-ümbersuunamistega. Ära looda, et noindex säästab budgetit: Google küsib neid lehti edasi.
- Tagasta eemaldatud lehtedele 404 või 410 ja paranda soft 404-d. Google nimetab 404 tugevaks signaaliks URL-i mitte uuesti roomata, samas kui blokeeritud URL-id püsivad järjekorras kauem. Lühenda iga pikk ümbersuunamisahel.
- Kontrolli roomamisstatistikat. Seadetes näitab roomamisstatistika aruanne vastuseaegu ja serverivigu. Kui need on kõrged, langetab Google su võimsuspiiri ja ükski sisuparandus ei aita enne, kui server paraneb.
- Paranda kaustade või mallide kaupa, siis valideeri rühm. Tee mustri kohta üks otsus, loo saidikaart ainult parandatud URL-idega ja klõpsa Valideeri parandus. Loe lähemalt roomamisbudgetist, kui su sait kuulub sellesse kategooriasse.
Oodata või tegutseda?
Raskeim pole parandus, vaid teadmine, millal oodata lõpetada. Kasuta Google'i enda ajavahemikke ja oma trendi.
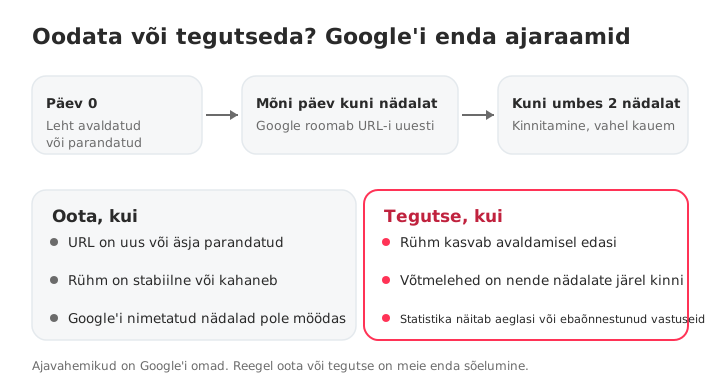
| Mida tegid | Mida Google ütleb | Allikas |
|---|---|---|
| Palusid Google'il uuesti roomata | Mõnest päevast mõne nädalani | Google'i palumine uuesti roomata |
| Taotlesid indekseerimist | Tavaliselt umbes päev, kuni üks või kaks nädalat, päevase kvoodiga | URL-i kontrollimise abi |
| Valideerisid parenduse | Kuni umbes kaks nädalat, vahel palju kauem | Lehtede indekseerimise abi |
Ajavahemikud on Google'i omad. Reegel «oota või tegutse» on meie oma: oota, kuni URL on uus ja rühm stabiilne või kahanev, ning tegutse, kui rühm kasvab edasi või su võtmelehed on pärast neid nädalaid kinni.
Kuidas seda aja jooksul jälgida
Search Console näitab iga URL-i viimast seisu ja nimekirja, mis on piiratud 1000 reaga, seega ehita oma rutiin:
- Ekspordi nimekiri kord kuus ja võrdle eelmisega. Kas rühm kasvab, on stabiilne või kahaneb?
- Rühmita mustri järgi (keel, kaust, mall), enne kui vaatad üksikuid URL-e.
- Vaata, kuidas Google iga URL-i leidis. Nimekiri, kus on kõikjal «saidikaart» ja mitte kusagil «viitav leht», nagu meie 14 URL-i puhul, osutab otse sisemistele linkidele.
SEOcrawl AI Indekseerimise vaade annab selle nimekirja valmis kujul: filtreeri kattuvuse oleku järgi, et näha selles olevaid URL-e koos viimase roomamise kuupäeva, klikkide ja näitamistega. MCP kaudu tuleb iga URL-iga kaasa ka Google'i valitud canonical võrreldes deklareeritud omaga ning see, kas see leiti saidikaardi või viitava lehe kaudu. Crawler auditeerib sinu enda lehti, nii et näed, mis URL-il nõrk on, enne kui palud Google'il uuesti vaadata, ja SEO Monitor annab märku, kui võtmeleht saab noindexi, vahetab canonical'i, tagastab 404 või kaob saidikaardilt.
Siin on see nimekiri meie enda saidi kohta, otse Indekseerimise vaatest:
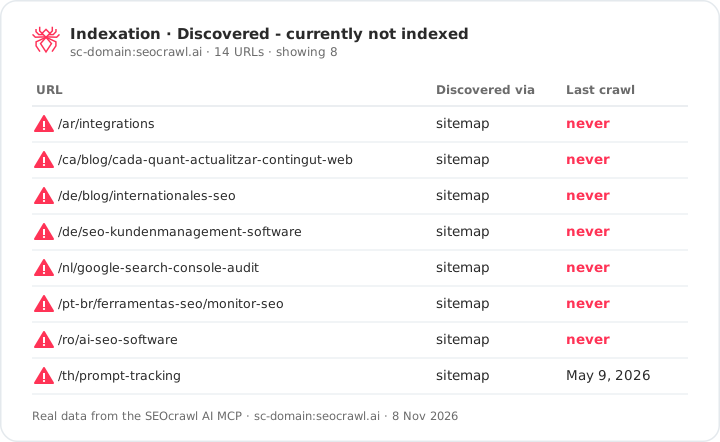
Armatuurlaua võid ka vahele jätta. Kui SEOcrawl AI MCP on ühendatud Claude'i või ChatGPT-ga, küsi: «Näita URL-e olekus Discovered – currently not indexed ja rühmita need kaustade järgi.» Siin on samm-sammuline juhend Search Console'i ühendamiseks Claude'i ja ChatGPT-ga.
Korduma kippuvad küsimused
Mida tähendab «Discovered – currently not indexed»?
See tähendab, et Google leidis su URL-i, kuid pole seda veel roomanud. Tavaliselt kavatses Google roomata ja lükkas selle edasi, mistõttu on viimase roomamise kuupäev tühi (lehtede indekseerimise abi). Google ei ole lehte lugenud, seega staatus ei ütle midagi selle kvaliteedi kohta. See ei ole karistus.
Kui kaua «Discovered – currently not indexed» kestab?
Google ei avalda selle staatuse jaoks tähtaega. Ta ütleb, et taotletud uuesti roomamine võtab mõnest päevast mõne nädalani ja parenduse valideerimine kuni umbes kaks nädalat, vahel palju kauem. Uus URL võib neid nädalaid lihtsalt vajada. Kui rühm kasvab edasi, samal ajal kui sa avaldad, lõpeta ootamine ja tegutse.
Kas indekseerimise taotlemine lahendab selle?
See võib aidata mõne prioriteetse URL-i puhul, sest palub Google'il leht järjekorda panna. See ei kõrvalda põhjust, seega võib leht naasta sama staatuse juurde. Taotlustele kehtib päevane kvoot ja Google ütleb, et sama URL-i korduv esitamine ei kiirenda midagi. Kasuta seda pärast sisemiste linkide parandamist, mitte kunagi massitööriistana.
Kas see on karistus?
Ei. Käsitsi tehtud toimingutel on eraldi aruanne. See staatus tähendab, et Google leidis URL-i ja pole seda veel roomanud, seega pole lehte hinnatud. Põhjus on tavaliselt roomamise prioriteet: nõrgad sisemised lingid, aeglane server või hulk väikese väärtusega URL-e, mis konkureerivad roomamiste pärast.
Miks on nii palju mu lehti avastatud, kuid indekseerimata?
Suur arv osutab tavaliselt mustrile, mitte üksikutele lehtedele: URL-i parameetrid või fassetid, duplikaadid, saidikaart URL-idega, mis sinna ei kuulu, nõrgad sisemised lingid tervele jaotisele või server, mis aeglustab Googlebotti. Rühmita URL-id kausta, keele või malli järgi, enne kui vaatad ühtegi eraldi.
Kas pean väikesel saidil muretsema?
Tavaliselt mitte. Google ütleb, et kui su saidil on alla 500 lehe, pole sul lehtede indekseerimise aruannet tõenäoliselt üldse vaja. Mõned uued URL-id selles staatuses vajavad enamasti aega ja paari sisemist linki lehtedelt, mida Google juba roomab.
Kuidas aitab SEOcrawl AI avastatud URL-idega?
SEOcrawl AI Indekseerimise vaade loetleb URL-id, mis on kinni jäänud igas Google'i kattuvuse olekus, koos viimase roomamise kuupäeva, klikkide ja näitamistega. SEOcrawl AI MCP kaudu saad paluda Claude'ilt või ChatGPT-lt ka selle nimekirja koos Google'i canonical'iga võrreldes deklareeritud omaga ning teabega, kas Google leidis iga URL-i saidikaardi või viitava lehe kaudu, ja lasta see kaustade järgi rühmitada.
Rohkem SEOcrawl AI-d Google'is
Vali meid eelistatud allikaks ja näed Google'i peauudistes rohkem meie artikleid.
Autor: David Kaufmann
Olen viimased 10+ aastat olnud täielikult SEO-sse haaratud — ja ausalt öeldes ei tahaks ma seda teisiti.
Minu karjäär jõudis uuele tasemele, kui töötasin vanem-SEO-spetsialistina Chess.com-is — ühel 100 külastatuimast veebisaidist kogu internetis. Sellises mahus töötamine, hõlmates miljoneid lehti, kümneid keeli ja üht konkurentsitihedaimat SERPs, õpetas mulle asju, mida ükski kursus ega sertifikaat kunagi ei suudaks. See kogemus muutis minu arusaama sellest, milline suurepärane SEO tegelikult välja näeb — ja sai aluseks kõigele, mille olen sellest ajast peale üles ehitanud.
Sellest kogemusest lähtudes asutasin SEO Alive — agentuuri brändidele, kes suhtuvad orgaanilisse kasvu tõsiselt. Me ei ole siin selleks, et müüa dashboards ja igakuiseid aruandeid. Me oleme siin selleks, et luua strateegiaid, mis päriselt tulemusi liigutavad, ühendades klassikalise SEO parima osa põneva uue Generative Engine Optimization (GEO) maailmaga — tagades, et teie bränd ilmub mitte ainult Google'i sinistes linkides, vaid ka AI genereeritud vastustes, mida ChatGPT, Perplexity ja Google AI Overviews iga päev miljonitele inimestele edastavad.
Ja kuna ma ei leidnud tööriista, mis mõlemat neist maailmadest korralikult hallanuks, ehitasin selle ise — SEOcrawl AI, enterprise SEO intelligence platvormi, mis toob kokku rankings, tehnilised auditid, backlinks jälgimise, crawl tervise ja AI brändi nähtavuse jälgimise ühte kohta. See on platvorm, mille olemasolu ma alati soovisin.
Avastage rohkem selle autori sisu
Mõõtsime Google'i klikke ja TI-st suunatud liiklust enam kui 16 000 veebisaidil ja 15 valdkonnas. TI-liiklus kasvab aastas 45%, kuid vastab endiselt umbes 1 külastusele iga 100 Google'i külastuse kohta, samal ajal kui Google'i klikid vähenesid 15%.