Excluded by 'noindex' tag: mida see tähendab ja kuidas seda parandada
Avasid Google Search Console'i, märkasid hulka URL-e märkega "Excluded by 'noindex' tag" ja nüüd ei ole need lehed otsingus nähtavad.
Kui märkasid Google Search Console'is hulka URL-e olekuga "Excluded by 'noindex' tag", hoitakse sinu lehti teadlikult Google'i indeksist väljas, ja lahendus on tavaliselt lihtsam, kui paistab: leia direktiiv, eemalda see ja palu Google'il leht uuesti roomata.
See juhend selgitab täpselt, mis selle oleku põhjustab, kuidas leida selle taga olev noindex-direktiiv ja millised on täpsed sammud selle eemaldamiseks kõigis suuremates CMS-ides, et sinu lehed saaksid taas otsingus asetuda. Sama kontroll töötab automaatselt SEOcrawl AI Crawleris, mis märgib noindex-direktiivid üle kogu saidi ilma URL-e ükshaaval kontrollimata.
Mida tähendab Google Search Console'is olek "Excluded by 'noindex' tag"?
Olek "Excluded by 'noindex' tag" tähendab, et Googlebot roomas sinu lehte, leidis noindex-direktiivi ja järgis seda, jättes lehe Google'i indeksist välja. Seni kuni direktiiv on alles, sinu leht otsingutulemustes ei ilmu.
Kus see olek GSC-s kuvatakse
Vanas aruandes Coverage (asendati 2022. aastal aruandega Page indexing) oli see olek jaotises "Excluded". Praeguses aruandes Page indexing (Indexing › Pages) leiad selle jaotisest "Not indexed", tabelist "Why pages aren't indexed", põhjusega "Excluded by 'noindex' tag". Google koondab kõik mõjutatud URL-id selle märke alla, et saaksid need korraga eksportida ja üle vaadata.
Kuidas Google noindex-direktiivi avastab ja järgib
Google'i dokumentatsioon indekseerimise blokeerimise kohta noindexiga kirjeldab kahte edastusviisi: silt <meta name="robots" content="noindex"> lehe HTML-i jaotises <head> või direktiiv X-Robots-Tag: noindex HTTP vastuse päistes. Kui Googlebot kohtab kumbagi, eemaldab ta lehe indeksist täielikult, isegi kui leht oli varem indekseeritud. Sildi enda põhitõed leiad meie juhendist noindex-metasildi kohta.
Kas see on alati probleem? Millal on väljajätmine tahtlik
Mitte iga URL olekuga "Excluded by 'noindex' tag" ei ole viga. Administraatorilehed, sisselogimisvaated, ostukorv ja ostu vormistamine, tänulehed ning sisemise otsingu tulemused hoitakse teadlikult Google'i indeksist väljas. Kui neil lehtedel on see olek, töötab süsteem nii, nagu ette nähtud. Tegelik probleem algab siis, kui selle märke saavad lehed, mida soovid otsingus näha.
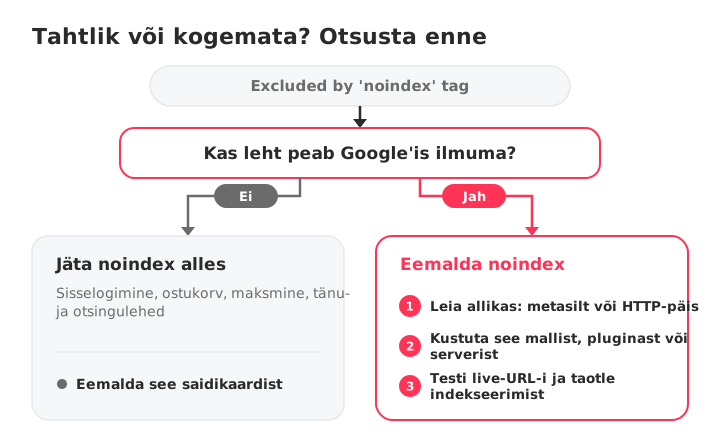
Oleku "Excluded by 'noindex' tag" levinumad põhjused
Noindex-direktiiv võib sinu lehele jõuda mitut eri teed pidi. Lahendus sõltub sellest, milline neist sinu saidil toimib.
Robots-metasilt väärtusega "noindex" jaotises <head>
Kõige levinum allikas. Rida nagu <meta name="robots" content="noindex"> lehe HTML-is ütleb Googlebotile, et lehte ei tohi indekseerida. See võib olla malli otse sisse kirjutatud või lisatud dünaamiliselt CMS-i, plugina või teemafunktsiooni poolt.
X-Robots-Tag HTTP vastuse päistes
X-Robots-Tag toimib täpselt nagu metasilt, kuid asub HTTP vastuse päises, mitte HTML-is. Selle võivad lisada serverikonfiguratsioon, CDN-i reeglid või .htaccess-direktiivid. Näiteks:
Header set X-Robots-Tag "noindex"
See mõjutab iga reeglile vastavat faili, sealhulgas PDF-e ja pilte, millel ei ole HTML-i jaotist <head>. Paljud saidiomanikud jätavad selle tee täiesti tähelepanuta, sest direktiivi ei ole lehe lähtekoodis näha.
CMS-i seaded, mis kogemata indekseerimist blokeerivad
WordPressis on jaotises Settings › Reading märkeruut "Discourage search engines from indexing this site". Kui see on märgitud, lisab WordPress saidi igale lehele robots noindex-sildi. Paljud lülitavad selle arenduse ajal sisse ja unustavad pärast käivitamist märke eemaldada.
Shopify võib noindexi lisada teema koodi või rakenduste kaudu. Mõned konto- ja süsteemilehed jätab Shopify ise indeksist välja, mis on õige, kuid teema muudatus või SEO-rakendus võib ekslikult lisada noindexi toote-, kollektsiooni- või blogilehtedele.
Wix lisab noindexi igale lehele, mille SEO-seaded takistavad otsingumootoritel seda indekseerimast. Levinud põhjus on lehe dubleerimine, mille puhul koopia pärib märkamatult originaali noindex-seade.
Pluginate või teemade konfliktid, mis lisavad noindexi
SEO-pluginad võimaldavad määrata noindexi postituse, lehe või sisutüübi kaupa. Valesti seadistatud globaalne reegel, seaded lähtestav plugina uuendus või plugina direktiive üle kirjutav teema võivad korraga lisada noindexi kümnetele lehtedele. Kui uuendasid hiljuti pluginat või vahetasid teemat, kontrolli seda esimesena.
Testkeskkonna seaded, mis jõudsid tootmisse
Üllatavalt sage tahtmatute noindex-siltide allikas. Sinu testkeskkonna sait kasutab noindexit, et Google'isse mitte sattuda. Kui juurutusprotsess viib testkeskkonna konfiguratsiooni tootmisse, liigub noindex-direktiiv sellega kaasa. Tavaliselt mõjutab see korraga terveid saidi jaotisi ja on üks raskemini diagnoositavaid põhjuseid, kui kontrollid ainult üksikuid lehti.
Kuidas tuvastada, millised lehed on mõjutatud
Korratav diagnostikaprotsess leiab kõik mõjutatud URL-id ilma arvamata. Alusta Search Console'ist, et saada loend, ja liigu seejärel üksikute lehtede juurde, et allikas leida.
Mõjutatud URL-ide eksportimine aruandest Page indexing
Ava Google Search Console ja mine Indexing › Pages. Klõpsa tabelis "Why pages aren't indexed" real "Excluded by 'noindex' tag". Search Console näitab valimit mõjutatud URL-idest; kasuta nuppu Export, et loend töötlemiseks alla laadida.
Ühe URL-i kontrollimine tööriistaga URL Inspection
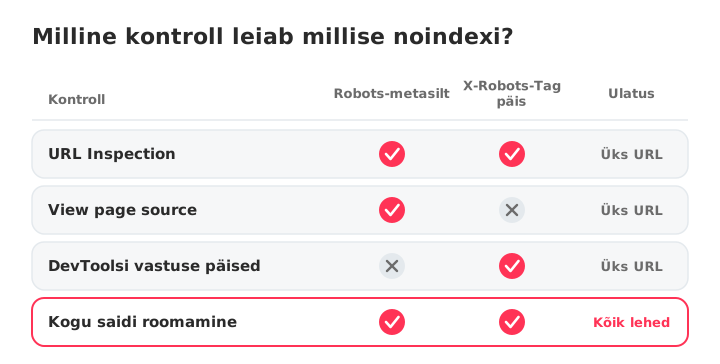
Kleebi ükskõik milline URL Search Console'i ülaosas olevale otsinguribale. Tööriist URL Inspection näitab, kas Google nägi noindex-direktiivi ja kust ta selle leidis: punktis "Indexing allowed?" on kirjas, kas noindex tuli robots-metasildist või X-Robots-Tag HTTP-päisest. Klõpsa View crawled page, et näha täpset HTML-i, mille Googlebot sai. See on kiireim võimalik ühe lehe kontroll.
Lehe lähtekoodist noindex-metasiltide otsimine
Ava leht brauseris, tee paremklõps ja vali View page source, seejärel otsi sõna "noindex" (Ctrl+F või Cmd+F). Kui leiad <meta name="robots" content="noindex"> või midagi sarnast, on süüdlane metasilt. Kui lähtekoodist seda ei leia, võib direktiiv tulla hoopis HTTP-päisest.
HTTP-päiste kontrollimine brauseri DevToolsiga
Ava DevTools (F12 või paremklõps › Inspect), mine vahekaardile Network, laadi leht uuesti ja klõpsa põhidokumendi päringul. Otsi jaotisest Response Headers rida X-Robots-Tag: noindex. See on ainus viis otse brauseris tabada päisepõhiseid noindex-direktiive, mis HTML-is ei ilmu.
Saidi roomamine Screaming Frogi või SEOcrawl AI-ga
Kogu saidi diagnoosimiseks leiab roomaja kõik mõjutatud lehed ühe läbimisega. Screaming Frog SEO Spider saab lehti filtreerida indekseeritavuse järgi nii metasiltide kui ka päiste põhjal. SEOcrawl AI Crawler roomab iga lehte, märgib jaotises Indexability kõik noindex-direktiiviga lehed ja annab sulle Audit Health Score'i, nii et näed kogu ulatust ilma käsitsi eksportimata ja filtreerimata.
Kuidas parandada olekut "Excluded by 'noindex' tag": samm-sammult
See on kõige praktilisem osa. Järgi lahendust, mis vastab eelmise osa diagnoosile.
Noindex-metasildi eemaldamine lehe lähtekoodist
Muuda lehe malli või sisu ja eemalda <meta name="robots" content="noindex"> HTML-i jaotisest <head>. Eritellimusel ehitatud saitidel kontrolli mallifaile otse. Kui silt lisatakse JavaScriptiga, leia selle eest vastutav skript ning eemalda see või lisa sellele tingimus.
Enne:
<meta name="robots" content="noindex">
Pärast:
<meta name="robots" content="index, follow">
Või eemalda silt lihtsalt täielikult. Google käsitleb noindex-direktiivi puudumist kui "indekseerimine lubatud".
X-Robots-Tagi parandamine serveri või CDN-i konfiguratsioonis
Kontrolli faili .htaccess (Apache), nginx.conf (Nginx) või CDN-i reegleid X-Robots-Tag: noindex-direktiivide suhtes. Eemalda need või piira need konkreetsete teedega, mis tuleb välja jätta, mitte lehtedega, mida soovid indekseerida. Näiteks võid jätta noindexi teele /staging/ ja eemaldada selle teelt /blog/.
Kuidas parandada WordPressis
Kaks kontrolli selles järjekorras:
- Kogu saidi seade: mine Settings › Reading ja eemalda märge valikult "Discourage search engines from indexing this site". See on WordPressis kogu saiti hõlmavate noindex-probleemide kõige levinum põhjus.
- Lehepõhised seaded SEO-pluginates:
- Yoast SEO: ava postitus või leht, keri Yoasti kastini, klõpsa vahekaardil Advanced ja määra "Allow search engines to show this content in search results?" väärtuseks "Yes".
- Rank Math: ava postitus, mine Rank Mathi kasti, klõpsa vahekaardil Advanced ja määra "Robots Meta" väärtuseks "Index".
- All in One SEO: muuda postitust, ava AIOSEO seadetes vahekaart Advanced ja veendu, et robots-seadetes ei oleks "No Index" märgitud.
Kontrolli ka iga plugina globaalseid seadeid, kas terveid sisutüüpe (sildid, kategooriad, kohandatud postitustüübid) ei ole määratud noindexiks. Ülejäänud WordPressi seadistuse kohta loe meie juhendit WordPressi ühendamisest Google Search Console'iga.
Kuidas parandada Shopifys
Shopifys tuleb noindex tavaliselt teema koodist või rakendusest. Ava Online Store › Themes › Edit code ja otsi failist theme.liquid ning lehemallidest noindexiga robots-metasilti. Seejärel kontrolli oma SEO-rakendusi reeglite suhtes, mis peidavad tooteid, kollektsioone või blogipostitusi, ning kõiki tooteid või lehti, mis kasutavad metavälja seo.hidden. Konto- ja muud süsteemilehed jätab Shopify ise indeksist välja ja nii see peabki jääma.
Kuidas parandada Wixis, Squarespace'is ja teistes veebilehe koostajates
Wix: ava lehe SEO-seaded (lehe menüüst) ja lülita sisse "Let search engines index this page". Kui dubleerisid lehte, võis koopia pärida originaalilt noindex-seade.
Squarespace: kontrolli kogu saidi SEO-seadeid, kas seal ei ole valikut, mis peidab saidi otsingumootorite eest. Üksikute lehtede puhul ava lehe seaded ja otsi vahekaardilt SEO valikut "Hide page from search results". Squarespace jätab vaikimisi otsingutulemustest välja ka mõned süsteemilehed, näiteks ostukorvi.
Pärast parandust: uuesti indekseerimise taotlemine Google Search Console'is
Noindex-sildi eemaldamine annab Google'ile teada, et ta võib lehte indekseerida, kuid Googlebot peab lehte muudatuse kinnitamiseks siiski uuesti roomama.
Indekseerimise taotlemine tööriistaga URL Inspection
Kleebi parandatud URL Search Console'i otsinguribale. Klõpsa Test live URL, et veenduda, et indekseerimine on nüüd lubatud, ja seejärel klõpsa Request indexing. Google paneb URL-i uuesti roomamise järjekorda. Nii saad esitada mitu URL-i, kuid Search Console piirab, mitu taotlust päevas teha saab.
Kui kaua võtab Google'il aega lehe uuesti indekseerimine?
Tavaliselt mõnest päevast mõne nädalani, sõltuvalt sellest, kui sageli Googlebot sinu saiti roomab. Suure liiklusega ja sageli uuendatavaid saite roomatakse uuesti kiiremini; uued või väikese liiklusega saidid võivad oodata nädalaid. Indekseerimise taotlemine on kiireim signaal, mida saad saata, kuid see ei ole garantii: see paneb sinu URL-i roomamisjärjekorda, mitte ei sunni kohe uuesti roomama.
Uuendatud XML-saidikaardi esitamine roomamise kiirendamiseks
Kui parandasid korraga palju lehti, esita uuendatud XML-saidikaart Search Console'i jaotises Sitemaps. See annab märku, et sinu sait on muutunud, ja soodustab ulatuslikumat uuesti roomamist. Puhas saidikaart ilma noindexiga URL-ideta väldib ka vastukäivaid signaale, millest räägime järgmisena.
Millal noindex-silt alles jätta (tahtlikud väljajätmised)
Mitte iga noindex-silti ei pea eemaldama. Mõned lehed ei tohiks kunagi otsingutulemustes ilmuda, ja nende indekseerimine lisab Google'i pildile sinu saidist õhukese sisuga või dubleeritud lehti ning raiskab roomaja tähelepanu.
Lehed, mida ei tohiks kunagi indekseerida
- Sisselogimis- ja registreerimislehed
- Ostukorvi, ostu vormistamise ja tellimuse kinnituse lehed
- Sisemise otsingu tulemuste lehed (dubleeritud sisu vältimiseks)
- Tänulehed (lead magnet'id, vormide esitamine)
- Administraatori- ja taustsüsteemi lehed
- Test- ja arenduskeskkonnad
- Filtri- ja parameetrilehed, mis loovad dubleeritud URL-e
noindex vs. robots.txt: peamised erinevused
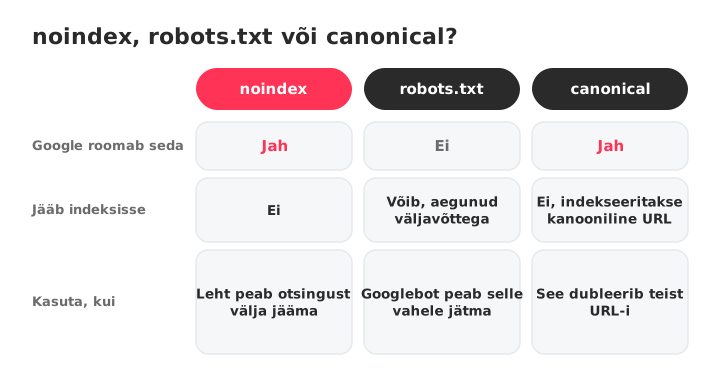
robots.txt blokeerib roomamise. noindex lubab roomamist, kuid blokeerib indekseerimise. Kui blokeerid lehe failis robots.txt, ei loe Googlebot seda kunagi, mis tähendab, et ta ei näe ka noindex-silti. Kui soovid lehe indeksist eemaldada, kasuta noindexit. Kui soovid, et Googlebot jätaks lehe täiesti vahele (et säästa roomamiseelarvet), kasuta robots.txt-d.
Levinud viga: juba indekseeritud lehe blokeerimine robots.txt-ga. Google ei näe noindex-silti, kui ta ei saa lehte roomata, nii et URL võib jääda indeksisse aegunud pealkirja ja väljavõttega. Õige lähenemine on roomamine lubada ja kasutada noindexit, et leht indeksist eemaldada.
Canonical-sildid vs. noindex: õige direktiivi valimine
Canonical-silt (rel="canonical") ütleb Google'ile: "see leht on teise URL-i koopia, järjesta hoopis seda". Noindex-silt ütleb Google'ile: "ära seda lehte üldse indekseeri". Neil on erinevad eesmärgid:
- Kasuta canonicalit, kui sul on dubleeritud või peaaegu dubleeritud sisu ja soovid koondada järjestussignaalid ühele URL-ile.
- Kasuta noindexit, kui leht ei tohi mingil juhul otsingutulemustes ilmuda.
Mõlema kasutamine samal lehel saadab vastukäivaid signaale: üks ütleb "liida see leht teise URL-iga", teine ütleb "jäta see välja". Vali see, mis vastab sinu eesmärgile.
Kuidas vältida tahtmatuid noindex-silte tulevikus
Noindex-probleemide parandamine tagantjärele on vajalik, kuid nende ennetamine säästab tunde diagnostikat ja kaotatud liiklust.
Search Console'i hoiatuste seadistamine indekseerimise languste kohta
Google Search Console saadab kinnitatud omanikele ja kasutajatele e-kirju, kui tuvastab atribuudil uusi indekseerimisprobleeme. Veendu, et e-posti teavitused oleksid Search Console'i e-posti eelistustes sisse lülitatud. Kui indekseeritud lehtede arv järsult langeb, annab hoiatus sulle edumaa enne, kui liiklus järgneb.
Noindex-kontrollide lisamine käivituseelsesse QA kontrollnimekirja
Enne mis tahes saidi juurutamist või testkeskkonna tootmisse viimist kontrolli noindex-direktiivide olemasolu. 30-sekundiline kontroll vaatega "View page source" ja sõna "noindex" otsinguga tabab kõige levinuma juurutusvea. Suuremate saitide puhul rooma saiti enne ja pärast juurutamist ning võrdle noindexiga lehtede arvu. Lisa see oma tehnilise SEO kontrollnimekirja, et keegi seda vahele ei jätaks.
Ajastatud roomamised soovimatute noindex-direktiivide tabamiseks
Käivita täielik roomamine ajakava järgi ning pärast iga plugina uuendust, teema vahetust või migratsiooni, et tabada soovimatud noindex-sildid enne, kui need sulle liiklust maksma lähevad. SEOcrawl AI Crawler võimaldab roomamisi võrrelda, nii et näed, millised lehed ja millal noindexi said, ning SEO Monitor hoiatab sind kohe, kui mõnele sinu olulisele lehele lisandub noindex-silt.
Korduma kippuvad küsimused
Mida tähendab Google Search Console'is olek "Excluded by 'noindex' tag"?
See tähendab, et Google leidis sinu lehelt noindex-direktiivi ja järgis seda, nii et leht ei ilmu otsingutulemustesse. Olek kuvatakse Search Console'i aruandes Page indexing jaotises "Not indexed".
See ei ole alati viga: lehtedel, mille jätad teadlikult välja, näiteks sisselogimis- või ostu vormistamise lehtedel, peabki see olek olema.
Kuidas parandada olekut "Excluded by 'noindex' tag" WordPressis?
Kontrolli kahte kohta selles järjekorras. Esmalt ava Settings › Reading ja veendu, et valik "Discourage search engines from indexing this site" ei oleks märgitud. Seejärel ava iga mõjutatud postitus või leht oma SEO-pluginas (Yoast, Rank Math, All in One SEO) ja veendu, et lehe robots-seade lubab indekseerimist.
Kui kaua võtab Google'il aega lehe indekseerimine pärast noindexi eemaldamist?
Tavaliselt mõnest päevast mõne nädalani, sõltuvalt sellest, kui sageli Googlebot sinu saiti roomab. Pärast direktiivi eemaldamist taotle indekseerimist tööriistaga URL Inspection ja esita uuendatud XML-saidikaart, et protsessi kiirendada. Suure liiklusega saite roomatakse uuesti kiiremini kui uusi või väikese liiklusega saite.
Kas leht võib olla noindexiga välja jäetud ka siis, kui see on minu saidikaardis?
Jah. Noindex-direktiiv kaalub saidikaardis olemise üles. Google võib URL-i saidikaardi kaudu endiselt roomata, kuid ei indekseeri seda, kuni noindex on olemas.
Kas eemalda noindex, et lehte saaks indekseerida, või eemalda URL saidikaardist, kui väljajätmine on tahtlik. Noindexiga URL-id saidikaardis saadavad vastukäivaid signaale.
Mis vahe on noindexil ja lehe blokeerimisel failis robots.txt?
robots.txt takistab Googlebotil lehte roomamast; noindex lubab roomamist, kuid takistab indekseerimist. Kui blokeerid lehe failiga robots.txt, ei saa Google noindex-silti lugeda, nii et juba indekseeritud leht võib jääda indeksisse aegunud sisuga. Kasuta noindexit lehe eemaldamiseks indeksist ja robots.txt-d ainult siis, kui soovid roomamist täielikult vältida.
Kuidas kontrollida, kas lehel on noindex-silt?
Kolm meetodit, kiireimast põhjalikumani: kasuta Search Console'is tööriista URL Inspection, vaata lehe lähtekoodi ja otsi sõna "noindex" (Ctrl+F) või kontrolli HTTP vastuse päiseid brauseri DevToolsis (vahekaart Network, otsi X-Robots-Tag). Ainult URL Inspection ja DevTools tabavad päises saadetud noindexi.
Kas peaksin muretsema, kui paljudel lehtedel on olek "Excluded by 'noindex' tag"?
Ainult siis, kui need lehed peaksid olema indekseeritud. Ekspordi loend Search Console'ist, võrdle seda oma tahtlike väljajätmistega (sisselogimine, ostukorv, admin, tänulehed) ja paranda ainult need lehed, mis peaksid otsingus asetuma. Kui kõik mõjutatud lehed on sinu teadlikult välja jäetud, töötab olek õigesti.
Autor: David Kaufmann
Olen viimased 10+ aastat olnud täielikult SEO-sse haaratud — ja ausalt öeldes ei tahaks ma seda teisiti.
Minu karjäär jõudis uuele tasemele, kui töötasin vanem-SEO-spetsialistina Chess.com-is — ühel 100 külastatuimast veebisaidist kogu internetis. Sellises mahus töötamine, hõlmates miljoneid lehti, kümneid keeli ja üht konkurentsitihedaimat SERPs, õpetas mulle asju, mida ükski kursus ega sertifikaat kunagi ei suudaks. See kogemus muutis minu arusaama sellest, milline suurepärane SEO tegelikult välja näeb — ja sai aluseks kõigele, mille olen sellest ajast peale üles ehitanud.
Sellest kogemusest lähtudes asutasin SEO Alive — agentuuri brändidele, kes suhtuvad orgaanilisse kasvu tõsiselt. Me ei ole siin selleks, et müüa dashboards ja igakuiseid aruandeid. Me oleme siin selleks, et luua strateegiaid, mis päriselt tulemusi liigutavad, ühendades klassikalise SEO parima osa põneva uue Generative Engine Optimization (GEO) maailmaga — tagades, et teie bränd ilmub mitte ainult Google'i sinistes linkides, vaid ka AI genereeritud vastustes, mida ChatGPT, Perplexity ja Google AI Overviews iga päev miljonitele inimestele edastavad.
Ja kuna ma ei leidnud tööriista, mis mõlemat neist maailmadest korralikult hallanuks, ehitasin selle ise — SEOcrawl AI, enterprise SEO intelligence platvormi, mis toob kokku rankings, tehnilised auditid, backlinks jälgimise, crawl tervise ja AI brändi nähtavuse jälgimise ühte kohta. See on platvorm, mille olemasolu ma alati soovisin.
Avastage rohkem selle autori sisu
Näed Search Console'is olekut "Alternate page with proper canonical tag"? Enamasti teeb Google täpselt seda, mida palusid. Siit saad teada, kuidas eristada tavalisi juhtumeid päris probleemidest ja kuidas parandada neid, mis on olulised.