Crawled – currently not indexed: mida see tähendab ja kuidas parandada

Google külastas sinu URL-i, luges selle läbi ja jättis otsingust välja. Siit saad teada, kuidas eristada lehti, mis väärivad teist võimalust, ja mida Google soovitab, et need indeksisse tagasi saada.
Crawled – currently not indexed (roomatud – praegu indekseerimata) tähendab, et Googlebot laadis sinu lehe alla ja otsustas seda Google'i indeksisse mitte lisada, nii et see ei saa otsingus ilmuda. Aruande Page indexing abiteave sõnastab selle nii: leht roomati läbi, kuid seda ei indekseeritud, ja see "võidakse tulevikus indekseerida või mitte".
Põhjus on tavaliselt leht ise, mitte tehniline blokeering. Allpool näed, kuidas iga URL-i puhul otsustada, kas lehte parandada, sellele noindex lisada või see kustutada, ning kui kaua parandus Google'i andmetel aega võtab. Aruanne on sulle uus? Alusta sellest Google Search Console'i juhendist.
Mida tähendab "Crawled – currently not indexed"?
See olek tähendab, et Google roomas lehe läbi ja otsustas seda mitte indekseerida. Miski ei blokeerinud Googlebotit: Google otsustas lehe praegu välja jätta. Oleku õigesti mõistmisel aitavad kaks eristust.
Roomatud vs. indekseeritud
Roomamine tähendab, et Googlebot laadib lehe alla. Indekseerimine tähendab, et Google salvestab lehe, et see saaks otsingutes ilmuda. Lehte võidakse roomata mitu korda ja see võib ikkagi mitte kunagi indeksisse jõuda.
URL Inspectioni tööriista abiteave ütleb, et lehe kvaliteet peab olema "piisavalt kõrge, et õigustada indekseerimist", ning selle tööriista reaalajas test ei suuda seda olekut üldse kontrollida.
Kuidas see erineb olekust "Discovered – currently not indexed"
Discovered – currently not indexed (avastatud – praegu indekseerimata) tuleb üks samm varem: Google leidis URL-i, kuid lükkas roomamise edasi, et sinu saiti mitte üle koormata, nii et viimase roomamise kuupäev on tühi.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Kas Google roomas? | Ei | Jah |
| Viimase roomamise kuupäev | Tühi | Kuupäev |
| Tavaline põhjus | Roomamine lükati edasi, et saiti mitte üle koormata | Google luges lehe läbi ja jättis selle vahele |
| Vaata kõigepealt | Roomamisvõimekust väga suurtel saitidel | Sisu kvaliteeti, duplikaate, canonicaleid |
Google ütleb ka: "Indekseerimata olek ei ole tingimata halb." Noindexiga lehed, robots.txt-is blokeeritud URL-id, duplikaadid ja asenduseta 404-lehed peavadki indeksist välja jääma.
Miks Google roomab lehti, kuid ei indekseeri neid
Indekseerimisel on kvaliteedilatt, mida roomamisel pole. Google'i roomamiseelarve juhend ütleb, et roomamisnõudlus kasvab koos sinu sisu väärtuse ja unikaalsusega.
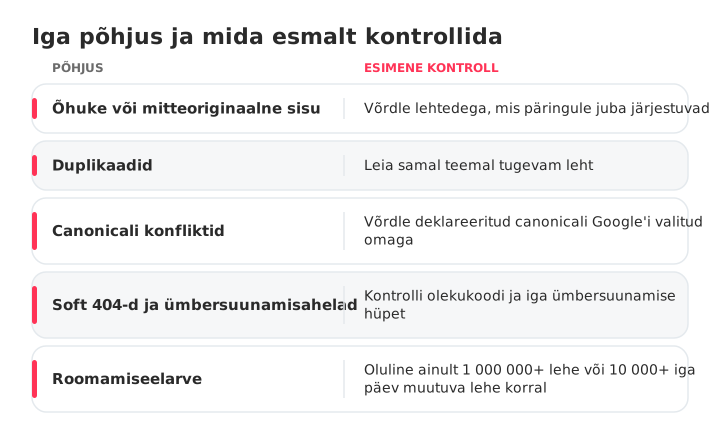
Enamik mõjutatud URL-e kuulub ühe järgmise põhjuse alla ja igal on oma esimene kontroll:
- Õhuke või mitteoriginaalne sisu: leht kordab seda, mis juba järjestub.
- Duplikaadid: siltide arhiivid, sorteeritud URL-id, kaks postitust samal teemal. Siit saad teada, kuidas märksõnade kannibalismi tuvastada ja parandada.
- Canonicali konfliktid: võrdle enda deklareeritud canonicali sellega, mille valis Google. Kui Google valib teise URL-i, liigub leht tavaliselt olekusse Alternate page with proper canonical tag või duplikaadi olekusse.
- Soft 404-d ja ümbersuunamisahelad: Google'i sõnul raiskavad soft 404-d roomamiseelarvet.
- Roomamiseelarve: see on oluline saitidele, millel on üle 1 000 000 lehe, mis muutuvad iga nädal, või üle 10 000, mis muutuvad iga päev. Enamiku saitide puhul pole see põhjus.
Latt tõusis kahes kuupäevaga sammus. 18. augustil 2022 teatas Google kasuliku sisu uuendusest, mis on kogu saiti puudutav signaal, ja ütles, et kasutu sisu eemaldamine võib aidata ülejäänud saiti. 5. märtsil 2024 teatas Google põhiuuendusest, et näidata vähem klikkide meelitamiseks loodud sisu, koos uue rämpspostipoliitikaga masstoodetud sisu kuritarvitamise vastu.
Google'i kasuliku sisu juhised ütlevad, et E-E-A-T ei ole konkreetne järjestustegur, et kõige olulisem on usaldusväärsus ja et eelistatud sõnade arvu pole. Lehe täitesõnadega paisutamine seda ei paranda.
Kuidas GSC-s mõjutatud lehti leida ja diagnoosida
Ava aruanne Page indexing (varem Coverage), kontrolli valimit ja rühmita loend mustrite järgi. Google märgib, et alla 500 lehega saidid seda aruannet tõenäoliselt ei vaja.
Mõjutatud URL-ide leidmine aruandes Pages
- Ava Google Search Console'is Indexing › Pages.
- Jaotises "Why pages aren't indexed" klõpsa real Crawled – currently not indexed.
- Klõpsa Export ja laadi loend alla.
Aruanne näitab kuni 1000 näidis-URL-i, mitte tingimata kõiki, nii et suurel saidil on eksport vaid valim.
Lehtede kontrollimine URL Inspectioni tööriistaga
Kontrolli viit kuni kümmet eksporditud URL-i ja vaata viimase roomamise kuupäeva ning Google-selected canonicalit (Google'i valitud canonicalit). Kui canonical viitab mujale, näeb Google duplikaati; kuude vanune roomamiskuupäev viitab sellele, et Google naaseb harva.
Mustrite märkamine sadade URL-ide seas
Sorteeri eksport kausta, malli ja URL-i parameetri järgi ning loe iga grupp kokku. Oletame, et 300 URL-i jagunevad 180 /tag/ lehe, 70 ?sort= URL-i ja 50 postituse vahel: see on kolm otsust, mitte 300.
Paranda, lisa noindex või kustuta: otsusta, mida iga URL väärib
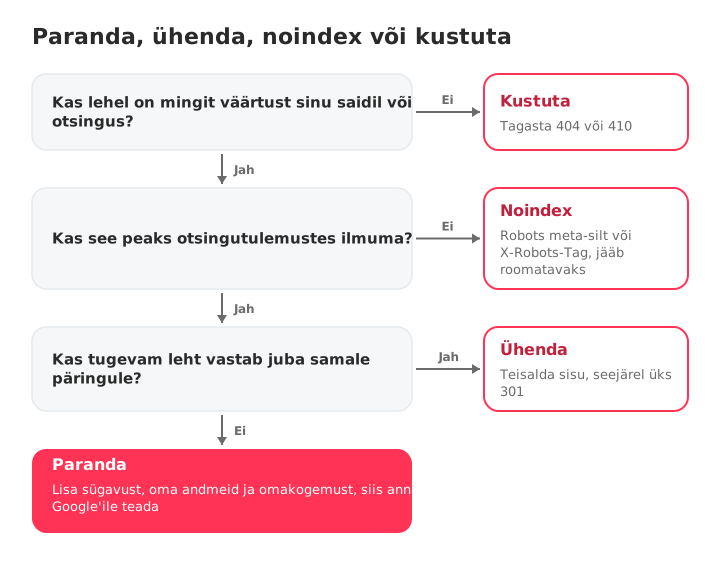
Iga URL väärib üht neljast tulemusest. Küsi: kas otsija oleks rõõmus siia jõudes ja kas see on sinu saidi ainus leht, mis päringule vastab?
| Lehe tüüp | Näide | Otsus | Kuidas |
|---|---|---|---|
| Kasulik ja unikaalne, kuid õhuke | 300-sõnaline juhend teemal, mida tunned | Paranda | Lisa sügavust ja omakogemusest pärit detaile |
| Dubleerib tugevamat lehte | Kaks postitust samal päringul | Ühenda | Teisalda sisu, seejärel 301-ümbersuunamine |
| Kasulik saidil, mitte otsingus | Siltide arhiivid, sisemine otsing, tänulehed | Noindex | Robots meta-silt või X-Robots-Tag |
| Väärtuseta, asenduseta | Aegunud kampaaniad, testlehed | Kustuta | Tagasta 404 või 410 |
Google'i roomamiseelarve juhend toetab kahte viimast rida: tagasta eemaldatud lehtedele 404 või 410 ja koonda duplikaadid. 404 Search Console'is on oodatav lehtede puhul, mille eemaldasid teadlikult.
Just noindexiga läheb sorteerimine kõige sagedamini viltu:
Mitte nii: noindex-silt /tag/ lehtedel, samal ajal kui robots.txt blokeerib /tag/. Googlebot ei saa lehti alla laadida, nii et ta ei näe silti kunagi.
Vaid nii: /tag/ jääb roomatavaks ja kannab noindexit meta-sildi või X-Robots-Tag päisena.
Google'i noindexi dokumentatsiooni järgi ei tööta reegel robots.txt-is ning harva külastatavatel lehtedel võib uuesti roomamine võtta kuid. Kui silt on loetud, liiguvad need URL-id olekusse Excluded by 'noindex' tag, ja just seda sa nende jaoks soovidki.
Kuidas parandada indekseerimist väärivaid lehti
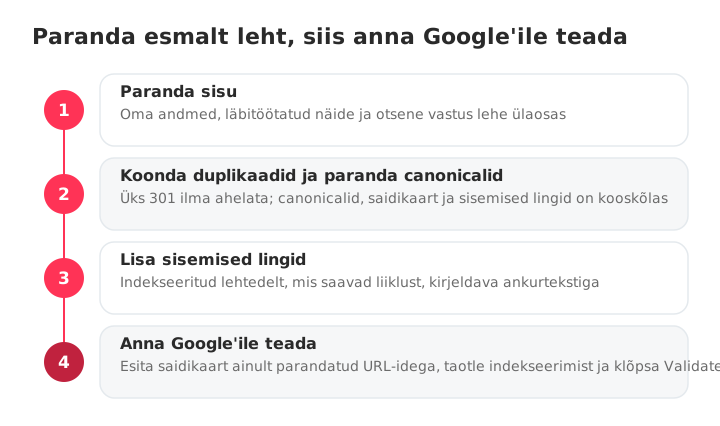
Tee leht esmalt indekseerimist väärivaks, seejärel anna Google'ile teada. Muutmata lehe indekseerimist taotledes palud Google'il korrata juba tehtud otsust. Järjekord:
- Paranda sisu.
- Koonda duplikaadid ja paranda canonicalid.
- Lisa sisemised lingid.
- Esita sihitud saidikaart ja taotle indekseerimist.
Paranda sisu sügavust ja originaalsust
Kirjuta ümber päringut, mitte sõnade arvu silmas pidades: lisa oma andmed, ekraanipildid, läbitöötatud näide ja otsene vastus lehe ülaossa.
Võtame näiteks õhukese 300-sõnalise juhendi: lisa omakogemusest pärit andmestik ja läbitöötatud näide, lingi sellele kahest postitusest, mis juba liiklust saavad, ja alles siis lisa see sihitud saidikaarti.
Koonda duplikaadid ja paranda canonicalid
Kui kaks URL-i käsitlevad sama asja, jäta alles üks, teisalda kasulik sisu sinna ja suuna teine 301-ga ümber otse sellele, ilma ahelata. Seejärel kontrolli, et canonicalid, saidikaart ja sisemised lingid oleksid kooskõlas ning et kuhugi poleks jäänud juhuslikku noindexit.
Lisa sisemised lingid lehtedelt, mida Google juba väärtustab
Lingi igale parandatud lehele indekseeritud lehtedelt, mis saavad liiklust, kirjeldava ankurtekstiga. Iga saidiroomaja oskab orbleheküljed (null sisemist linki) välja tuua, filtreerides nulli sissetuleva lingiga lehed. Täielik meetod on sisemise linkimise strateegia juhendis.
Kontrolli lehte ka telefonis ja aruandes Core Web Vitals: katkist mobiililehte on kiire välistada.
Esita sihitud saidikaart ja taotle indekseerimist
Koosta saidikaart ainult parandatud URL-idega, esita see ja filtreeri selle järgi aruannet Pages, enne kui klõpsad Validate fix. Google soovitab seda valideerimise kiirendamiseks. Kui vajad kõigepealt oma praegust faili, leia oma saidi saidikaart.
Google eirab priority ja changefreq väärtusi, nii et hoia selle asemel lastmod täpsena. Seejärel klõpsa URL Inspectioni tööriistas oma prioriteetsete URL-ide puhul Request indexing: Google rakendab kvooti ja ütleb, et korduvad taotlused ei kiirenda midagi.
Kui kaua võtab indekseerimine pärast parandust aega?
Arvesta ajaga päevast mitme nädalani ning indekseerimine pole kunagi garanteeritud. Google annab eri lehtedel erinevaid vahemikke, nii et siin on need kõrvuti:
| Mida sa tegid | Mida Google ütleb | Allikas |
|---|---|---|
| Palusid Google'il uuesti roomata | Mõnest päevast mõne nädalani | Ask Google to recrawl |
| Request indexing | Tavaliselt umbes päev, kuni nädal või kaks, päevase limiidiga | URL Inspectioni abiteave |
| Validate fix | Kuni umbes kaks nädalat, mõnikord palju kauem | Page indexingu abiteave |
Need on Google'i ajakavad, mitte taastumise juhtumid. Kontrolli aruannet Pages iga nädal; kui parandatud URL-id pole pärast nende vahemike möödumist liikunud, mine tagasi sisu juurde.
Kuidas vältida uute lehtede sattumist sellesse olekusse
Ennetamine on rutiin: kontrolli iga lehte enne avaldamist ja vaata Search Console üle kord kuus. Enne avaldamist veendu, et leht:
- Vastab päringule, millele ükski teine sinu saidi leht ei vasta.
- Lisab sinu enda andmeid, näiteid või kogemust.
- Omab iseendale viitavat canonicalit ega sisalda juhuslikku noindexit.
- On saidikaardis täpse lastmodiga.
- Omab nimelist autorit ja vajaduse korral struktureeritud andmeid.
- Saab lingi seotud ja indekseeritud lehelt.
Kord kuus võrdle aruannet Pages eelmise kuuga; probleem püsib loendis 90 päeva pärast selle viimase esinemise kadumist. Üle tuhande lehega saidid peaksid jälgima ka aruannet Crawl Stats.
SEOcrawl AI tegeleb tehnilise poolega suures mahus. Crawler roomab läbi iga lehe ja annab Audit Health Score'i, kus probleemid on jagatud kategooriatesse Indexability, Crawlability, On-Page ja teised. Selle vaade Indexation rühmitab sinu URL-id Search Console'i katvusoleku järgi, nii et näed, kui palju neist on olekus "Crawled – currently not indexed", ja saad arvu aja jooksul jälgida.
Roomamiste vahel hoiatab SEO Monitor, kui oluline leht saab noindexi, muudab oma canonicali, tagastab 404 või kaob saidikaardilt. Sama platvorm jälgib sinu brändi nähtavust ChatGPT-s, Claude'is, Geminis, Perplexitys ja Copilotis, nii et SEO ja GEO on ühes kohas.
KKK
Mida tähendab "Crawled – currently not indexed"?
See tähendab, et Googlebot laadis sinu lehe alla ja otsustas seda Google'i indeksisse mitte lisada, nii et see ei saa otsingus ilmuda. Miski ei blokeerinud roomamist: Google luges lehe läbi ja otsustas selle praegu välja jätta. See ei ole käsitsi määratud karistus ning leht võidakse tulevikus indekseerida või mitte.
Kas see on sama mis "Discovered – currently not indexed"?
Ei. "Discovered" tähendab, et Google teab URL-i, kuid lükkas roomamise edasi, nii et viimase roomamise kuupäev on tühi. "Crawled" tähendab, et Google on lehte juba külastanud ja selle läbi lugenud ning seejärel otsustanud seda mitte indekseerida. Discovered puhul vaata väga suurte saitide roomamisvõimekust; Crawled puhul sisu kvaliteeti, duplikaate ja canonicaleid.
Kas "Crawled – currently not indexed" kahjustab minu SEO-d?
Iseenesest mitte: see olek ei ole karistus ja mõjutatud leht kaotab ainult oma otsinguliikluse. Risk peitub mahus, sest suurt osa kasutust sisust käsitleb Google kogu saiti puudutava signaalina. Indeksist väljas olev siltide arhiiv ei maksa midagi; tootelehega on teine lugu. Kui arv kasvab iga kord, kui midagi avaldad, käsitle seda kogu saidi sisuprobleemina, mitte üksikute URL-ide loendina.
Kui kaua võtab lehe indekseerimine pärast parandust aega?
Arvesta ajaga päevast mitme nädalani ning indekseerimine pole kunagi garanteeritud. Google'i sõnul võtab uuesti roomamine aega mõnest päevast mõne nädalani, Request indexing töödeldakse tavaliselt umbes päevaga, kuid see võib võtta nädal või kaks, ning Validate fix kestab tavaliselt kuni umbes kaks nädalat.
Kas indekseerimise taotlemine aitab?
Ainult pärast seda, kui oled lehte muutnud. Muutmata lehe indekseerimist taotledes palud Google'il korrata juba tehtud otsust. Taotlustele kehtib päevane kvoot ning Google ütleb, et sama URL-i mitu korda saatmine ei kiirenda midagi.
Kas lehe lisamine XML-saidikaarti aitab?
See aitab Google'il URL-i leida, mitte seda indekseerida. Google nimetab esitatud saidikaarti "vaid vihjeks" ning need lehed on juba leitud ja läbi loetud. Pärast parandust on saidikaardi ülesanne koondada URL-id, mida soovid uuesti kontrollida. Igas saidikaardi failis võib olla kuni 50 000 URL-i või 50 MB.
Miks "Crawled – currently not indexed" valideerimine ebaõnnestus?
Valideerimine peatub kohe, kui Google leiab grupist ühe veel parandamata URL-i, nii et üksainus allesjäänud leht võib kogu grupi läbi kukutada. Paranda grupi iga URL või kitsenda gruppi, filtreerides aruannet saidikaardiga, milles on ainult parandatud URL-id, ja valideeri uuesti.
Kuidas aitab SEOcrawl AI lehtedega, mida Google roomab, kuid ei indekseeri?
SEOcrawl AI leiab selle oleku põhjused saidilt endalt. Crawler näitab iga URL-i tervisehinnet, HTTP olekukoodi ja roomamissügavust, nii et märkad lehti, milleni Google'il on raske jõuda. Vaade Indexation rühmitab sinu URL-id Search Console'i katvusoleku järgi ning SEO Monitor hoiatab, kui oluline leht saab noindexi, muudab oma canonicali, tagastab 404 või kaob saidikaardilt.
Autor: David Kaufmann

Olen viimased 10+ aastat olnud täielikult SEO-sse haaratud — ja ausalt öeldes ei tahaks ma seda teisiti.
Minu karjäär jõudis uuele tasemele, kui töötasin vanem-SEO-spetsialistina Chess.com-is — ühel 100 külastatuimast veebisaidist kogu internetis. Sellises mahus töötamine, hõlmates miljoneid lehti, kümneid keeli ja üht konkurentsitihedaimat SERPs, õpetas mulle asju, mida ükski kursus ega sertifikaat kunagi ei suudaks. See kogemus muutis minu arusaama sellest, milline suurepärane SEO tegelikult välja näeb — ja sai aluseks kõigele, mille olen sellest ajast peale üles ehitanud.
Sellest kogemusest lähtudes asutasin SEO Alive — agentuuri brändidele, kes suhtuvad orgaanilisse kasvu tõsiselt. Me ei ole siin selleks, et müüa dashboards ja igakuiseid aruandeid. Me oleme siin selleks, et luua strateegiaid, mis päriselt tulemusi liigutavad, ühendades klassikalise SEO parima osa põneva uue Generative Engine Optimization (GEO) maailmaga — tagades, et teie bränd ilmub mitte ainult Google'i sinistes linkides, vaid ka AI genereeritud vastustes, mida ChatGPT, Perplexity ja Google AI Overviews iga päev miljonitele inimestele edastavad.
Ja kuna ma ei leidnud tööriista, mis mõlemat neist maailmadest korralikult hallanuks, ehitasin selle ise — SEOcrawl AI, enterprise SEO intelligence platvormi, mis toob kokku rankings, tehnilised auditid, backlinks jälgimise, crawl tervise ja AI brändi nähtavuse jälgimise ühte kohta. See on platvorm, mille olemasolu ma alati soovisin.
Avastage rohkem selle autori sisu


Domain Authority ennustab, kui hästi sait otsingus järjestub, kuid see ei ole Google'i järjestustegur. Siit saad teada, mida DA tegelikult mõõdab, kuidas see erineb DR-ist ja Authority Score'ist ning millistele mõõdikutele tasub selle asemel tähelepanu pöörata.