Procházeno – momentálně neindexováno: co to znamená a jak to opravit

Google navštívil vaši URL, přečetl ji a do vyhledávání ji nezařadil. Ukážeme vám, jak poznat, které stránky si zaslouží druhou šanci, a jak je podle Googlu dostat zpět do indexu.
Procházeno – momentálně neindexováno znamená, že Googlebot vaši stránku stáhl a rozhodl se ji nepřidat do indexu Googlu, takže se nemůže zobrazit ve vyhledávání. Nápověda k přehledu Indexování stránek to popisuje takto: stránka byla procházena, ale ne indexována, a „v budoucnu může, ale nemusí být indexována“.
Příčinou je obvykle samotná stránka, ne technický blok. Níže zjistíte, jak u každé URL rozhodnout, zda stránku opravit, označit noindex, nebo smazat, a jak dlouho podle Googlu oprava trvá. S přehledem začínáte? Začněte tímto průvodcem Google Search Console.
Co znamená „Procházeno – momentálně neindexováno“?
Tento stav znamená, že Google stránku prošel a rozhodl se ji neindexovat. Googlebota nic neblokovalo: Google se rozhodl stránku zatím vynechat. Správně číst tento stav vám pomohou dvě rozlišení.
Procházení vs. indexování
Procházení znamená, že Googlebot stránku stáhne. Indexování znamená, že ji Google uloží, aby se mohla zobrazovat ve vyhledávání. Stránka může být procházena mnohokrát, a přesto nikdy nebýt indexována.
Nápověda k nástroji Kontrola URL uvádí, že kvalita stránky musí být „dostatečně vysoká, aby indexaci odůvodnila“, a živý test tento stav vůbec nedokáže zjistit.
Čím se liší od „Objeveno – momentálně neindexováno“
Objeveno – momentálně neindexováno přichází o krok dřív: Google URL našel, ale procházení odložil, aby váš web nepřetížil, takže datum posledního procházení je prázdné.
| Objeveno – momentálně neindexováno | Procházeno – momentálně neindexováno | |
|---|---|---|
| Procházeno Googlem? | Ne | Ano |
| Datum posledního procházení | Prázdné | Konkrétní datum |
| Obvyklý důvod | Procházení odloženo, aby se web nepřetížil | Google stránku přečetl a vynechal ji |
| Co kontrolovat nejdřív | Kapacitu procházení u velmi velkých webů | Kvalitu obsahu, duplicity, kanonické URL |
Google také uvádí: „Neindexováno nemusí nutně znamenat špatně.“ Stránky s noindex, URL blokované v robots.txt, duplicity a 404 bez náhrady mají zůstat mimo index.
Proč Google stránky prochází, ale neindexuje
Indexování má laťku kvality, kterou procházení nemá. Průvodce Googlu ke crawl budgetu uvádí, že poptávka po procházení roste s hodnotou a jedinečností vašeho obsahu.
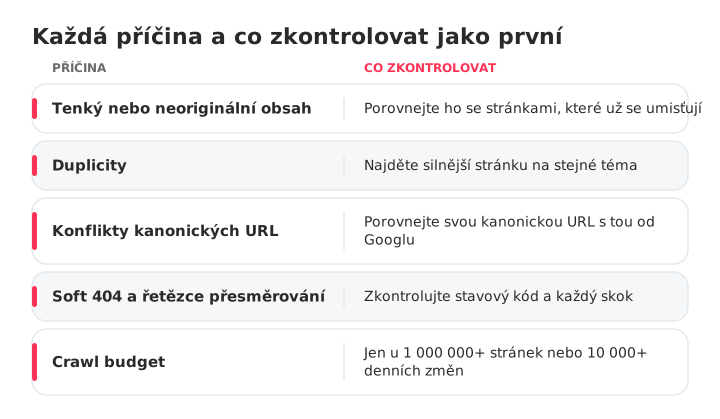
Většina dotčených URL spadá pod jednu z těchto příčin, každá s vlastní první kontrolou:
- Tenký nebo neoriginální obsah: stránka opakuje to, co už se umisťuje.
- Duplicity: archivy štítků, URL s řazením, dva články na jedno téma. Podívejte se, jak odhalit a opravit kanibalizaci klíčových slov.
- Konflikty kanonických URL: porovnejte deklarovanou kanonickou URL s tou, kterou vybral Google. Když Google zvolí jinou URL, stránka se obvykle přesune do stavu Alternativní stránka se správnou kanonickou značkou nebo do některého ze stavů duplicity.
- Soft 404 a řetězce přesměrování: podle Googlu soft 404 plýtvají crawl budgetem.
- Crawl budget: hraje roli u webů s více než 1 000 000 stránek, které se mění každý týden, nebo s více než 10 000 stránkami, které se mění denně. U většiny webů to příčina není.
Laťka se zvedla ve dvou krocích. 18. srpna 2022 Google oznámil helpful content update, signál pro celý web, a uvedl, že odstranění neužitečného obsahu může pomoci zbytku webu. 5. března 2024 Google oznámil core update, který má zobrazovat méně obsahu vytvořeného pro kliky, spolu s novými pravidly proti spamu ze zneužívání obsahu ve velkém měřítku.
Doporučení Googlu k užitečnému obsahu uvádějí, že E-E-A-T není konkrétní faktor hodnocení, že nejdůležitější je důvěryhodnost a že neexistuje žádný preferovaný počet slov. Natahování textu stránku nespraví.
Jak v GSC najít a diagnostikovat dotčené stránky
Otevřete přehled Indexování stránek (dříve přehled Pokrytí), zkontrolujte vzorek a pak seznam seskupte podle vzorců. Google uvádí, že weby s méně než 500 stránkami tento přehled pravděpodobně nepotřebují.
Hledání dotčených URL v přehledu Stránky
- V Google Search Console přejděte do Indexování › Stránky.
- V tabulce „Proč stránky nejsou indexovány“ klikněte na Procházeno – momentálně neindexováno.
- Klikněte na Exportovat a stáhněte seznam.
Přehled zobrazuje až 1 000 ukázkových URL, ne nutně všechny, takže u velkého webu je export jen vzorek.
Kontrola stránek nástrojem Kontrola URL
U pěti až deseti exportovaných URL zkontrolujte datum posledního procházení a kanonickou stránku vybranou Googlem. Kanonická URL mířící jinam znamená, že Google vidí duplicitu; datum procházení staré několik měsíců naznačuje, že se Google vrací jen zřídka.
Hledání vzorců ve stovkách URL
Seřaďte export podle složky, šablony a parametru URL a pak každou skupinu spočítejte. Řekněme, že se 300 URL rozdělí na 180 stránek /tag/, 70 URL s ?sort= a 50 článků: to jsou tři rozhodnutí, ne 300.
Opravit, noindex, nebo smazat: rozhodněte, co si která URL zaslouží
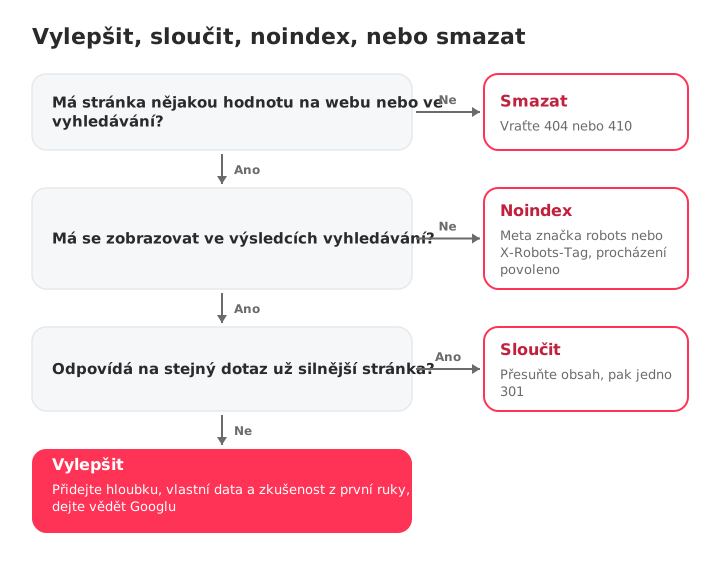
Každá URL si zaslouží jeden ze čtyř výsledků. Zeptejte se: byl by uživatel rád, že sem přišel, a je to jediná stránka na vašem webu, která na dotaz odpovídá?
| Typ stránky | Příklad | Rozhodnutí | Jak |
|---|---|---|---|
| Užitečná a jedinečná, ale tenká | Návod o 300 slovech na téma, kterému rozumíte | Vylepšit | Přidejte hloubku a zkušenost z první ruky |
| Duplikuje silnější stránku | Dva články na stejný dotaz | Sloučit | Přesuňte obsah, pak přesměrování 301 |
| Užitečná na webu, ne ve vyhledávání | Archivy štítků, interní vyhledávání, děkovací stránky | Noindex | Meta značka robots nebo X-Robots-Tag |
| Bez hodnoty a bez náhrady | Prošlé akce, testovací stránky | Smazat | Vraťte 404 nebo 410 |
Průvodce Googlu ke crawl budgetu podporuje poslední dva řádky: u odstraněných stránek vracejte 404 nebo 410 a duplicity konsolidujte. Chyba 404 v Search Console je u záměrně odstraněných stránek očekávaná.
Právě u noindex se třídění nejčastěji pokazí:
Takhle ne: značka noindex na stránkách /tag/, zatímco robots.txt blokuje /tag/. Googlebot stránky nemůže stáhnout, takže značku nikdy neuvidí.
Takhle ano: /tag/ zůstává procházitelné a noindex nese jako meta značku nebo hlavičku X-Robots-Tag.
Podle dokumentace Googlu k noindex toto pravidlo uvnitř robots.txt nefunguje a u zřídka navštěvovaných stránek může nové procházení trvat měsíce. Jakmile Google značku přečte, tyto URL se přesunou do stavu Vyloučeno značkou 'noindex', což je přesně to, co u nich chcete.
Jak opravit stránky, které si indexaci zaslouží
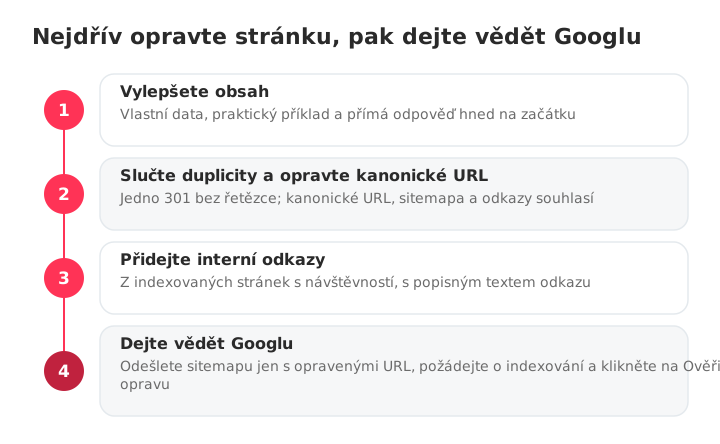
Nejdřív stránku udělejte hodnou indexace, pak dejte vědět Googlu. Žádost o indexování nezměněné stránky žádá Google, aby zopakoval rozhodnutí, které už učinil. Pořadí:
- Vylepšete obsah.
- Slučte duplicity a opravte kanonické URL.
- Přidejte interní odkazy.
- Odešlete cílenou sitemapu a požádejte o indexování.
Zlepšete hloubku a originalitu obsahu
Přepisujte podle dotazu, ne podle počtu slov: přidejte vlastní data, snímky obrazovky, praktický příklad a přímou odpověď blízko začátku.
Vezměte například tenký návod o 300 slovech: přidejte vlastní datovou sadu a praktický příklad, odkažte na něj ze dvou článků, které už mají návštěvnost, a teprve pak ho přidejte do cílené sitemapy.
Slučte duplicity a opravte kanonické URL
Když dvě URL pokrývají totéž, ponechte jednu, přesuňte do ní užitečný obsah a druhou přesměrujte 301 přímo na ni, bez řetězce. Pak zkontrolujte, že kanonické URL, sitemapa a interní odkazy souhlasí a že nikde nezůstal zapomenutý noindex.
Přidejte interní odkazy ze stránek, kterých si Google už cení
Na každou opravenou stránku odkažte z indexovaných stránek s návštěvností, s popisným textem odkazu. Kterýkoli crawler webu vypíše osamocené stránky (bez interních odkazů), když vyfiltrujete nulový počet příchozích odkazů. Celý postup najdete v průvodci strategií interního prolinkování.
Zkontrolujte také stránku na telefonu a v přehledu Core Web Vitals: rozbitou mobilní verzi vyloučíte rychle.
Odešlete cílenou sitemapu a požádejte o indexování
Vytvořte sitemapu jen s URL, které jste opravili, odešlete ji a vyfiltrujte podle ní přehled Stránky, než kliknete na Ověřit opravu. Google to doporučuje pro rychlejší ověření. Pokud nejdřív potřebujete aktuální soubor, najděte sitemapu svého webu.
Google ignoruje priority a changefreq, takže místo toho udržujte přesné lastmod. Pak u prioritních URL klikněte v nástroji Kontrola URL na Požádat o indexování: Google uplatňuje kvótu a uvádí, že opakované žádosti nic neurychlí.
Jak dlouho trvá indexace po opravě?
Počítejte s dobou od jednoho dne po několik týdnů a indexace není nikdy zaručená. Google uvádí na různých stránkách různé rozsahy, proto je tu máte vedle sebe:
| Co jste udělali | Co uvádí Google | Zdroj |
|---|---|---|
| Požádali jste Google o nové procházení | Několik dní až několik týdnů | Požádání Googlu o nové procházení |
| Požádat o indexování | Obvykle zhruba den, až týden či dva, s denním limitem | Nápověda ke Kontrole URL |
| Ověřit opravu | Až zhruba dva týdny, někdy mnohem déle | Nápověda k Indexování stránek |
Jde o časové rámce Googlu, ne o případové studie obnovy. Kontrolujte přehled Stránky každý týden; pokud se opravené URL po uplynutí těchto lhůt nepohnuly, vraťte se k obsahu.
Jak zabránit tomu, aby nové stránky končily v tomto stavu
Prevence je rutina: zkontrolujte každou stránku před zveřejněním a jednou měsíčně projděte Search Console. Před publikací ověřte, že stránka:
- Odpovídá na dotaz, na který neodpovídá žádná jiná stránka vašeho webu.
- Přináší vaše vlastní data, příklady nebo zkušenosti.
- Má kanonickou URL odkazující sama na sebe a žádný zapomenutý noindex.
- Je v sitemapě s přesným lastmod.
- Má uvedeného autora a tam, kde to dává smysl, strukturovaná data.
- Získá odkaz ze související indexované stránky.
Jednou měsíčně porovnejte přehled Stránky s předchozím měsícem; problém zůstává v seznamu ještě 90 dní po zmizení posledního výskytu. Weby s více než tisícem stránek by měly sledovat i přehled Statistiky procházení.
SEOcrawl AI pokryje technickou stránku ve velkém. Crawler projde každou stránku a vrátí Audit Health Score s problémy rozdělenými do kategorií Indexability, Crawlability, On-Page a dalších. Jeho zobrazení Indexation seskupí vaše URL podle stavu pokrytí v Search Console, takže vidíte, kolik jich je ve stavu „Procházeno – momentálně neindexováno“, a můžete počet sledovat v čase.
Mezi procházeními vás SEO Monitor upozorní, když klíčová stránka dostane noindex, změní kanonickou URL, vrátí 404 nebo zmizí ze sitemapy. Stejná platforma sleduje viditelnost vaší značky v ChatGPT, Claude, Gemini, Perplexity a Copilot, takže SEO a GEO máte pohromadě.
Časté dotazy
Co znamená stav „Procházeno – momentálně neindexováno“?
Znamená, že Googlebot vaši stránku stáhl a rozhodl se ji nepřidat do indexu Googlu, takže se nemůže zobrazit ve vyhledávání. Procházení nic neblokovalo: Google stránku přečetl a zatím ji vynechal. Nejde o ruční postih a stránka může, ale nemusí být v budoucnu indexována.
Je to totéž jako „Objeveno – momentálně neindexováno“?
Ne. „Objeveno“ znamená, že Google URL zná, ale procházení odložil, takže datum posledního procházení je prázdné. „Procházeno“ znamená, že Google stránku už navštívil a přečetl, a pak se rozhodl ji neindexovat. U stavu Objeveno řešte kapacitu procházení na velmi velkých webech; u stavu Procházeno kvalitu obsahu, duplicity a kanonické URL.
Škodí stav „Procházeno – momentálně neindexováno“ mému SEO?
Sám o sobě ne: tento stav není postih a dotčená stránka přichází jen o vlastní návštěvnost z vyhledávání. Rizikem je objem, protože Google bere velký podíl neužitečného obsahu jako signál pro celý web. Archiv štítků mimo index nic nestojí; produktová stránka ano. Pokud počet roste s každou publikací, řešte to jako problém obsahu na úrovni celého webu, ne jako seznam jednotlivých URL.
Jak dlouho trvá, než se stránka po opravě zaindexuje?
Počítejte s dobou od jednoho dne po několik týdnů a indexace není nikdy zaručená. Podle Googlu trvá nové procházení několik dní až několik týdnů, žádost o indexování se obvykle zpracuje zhruba do jednoho dne, ale může trvat týden či dva, a Ověřit opravu obvykle trvá až zhruba dva týdny.
Pomůže požádat o indexování?
Jen poté, co stránku změníte. Žádost o indexování nezměněné stránky žádá Google, aby zopakoval rozhodnutí, které už učinil. Žádosti podléhají dennímu limitu a Google uvádí, že opakované odeslání stejné URL nic neurychlí.
Pomůže přidat stránku do XML sitemapy?
Pomůže Googlu URL najít, ne ji zaindexovat. Google označuje odeslanou sitemapu za „pouhou nápovědu“ a tyto stránky už byly nalezeny i přečteny. Po opravě má sitemapa za úkol seskupit URL, které chcete nechat znovu zkontrolovat. Jeden soubor sitemapy pojme až 50 000 URL nebo 50 MB.
Proč selhalo ověření opravy stavu „Procházeno – momentálně neindexováno“?
Ověření se zastaví, jakmile Google najde ve skupině jedinou neopravenou URL, takže jedna zapomenutá stránka může shodit celou dávku. Opravte všechny URL ve skupině, nebo skupinu zužte filtrováním přehledu podle sitemapy jen s opravenými URL, a ověření spusťte znovu.
Jak SEOcrawl AI pomáhá se stránkami, které Google prochází, ale neindexuje?
SEOcrawl AI najde příčiny tohoto stavu na straně webu. Crawler ukazuje u každé URL health score, stavový kód HTTP a hloubku procházení, takže odhalíte stránky, ke kterým se Google dostává obtížně. Zobrazení Indexation seskupí vaše URL podle stavu pokrytí v Search Console a SEO Monitor vás upozorní, když klíčová stránka dostane noindex, změní kanonickou URL, vrátí 404 nebo zmizí ze sitemapy.
Autor: David Kaufmann

Posledních 10+ let jsem byl naprosto posedlý SEO — a upřímně, jinak bych to mít ani nechtěl.
Moje kariéra dostala nový rozměr, když jsem pracoval jako senior SEO specialista pro Chess.com — jeden ze 100 nejnavštěvovanějších webů celého internetu. Pracovat v takovém měřítku, na milionech stránek, v desítkách jazyků a v jedné z nejkonkurenčnějších SERP, mě naučilo věci, které žádný kurz ani certifikát nemůže předat. Tato zkušenost změnila mou perspektivu na to, jak vypadá opravdu skvělé SEO — a stala se základem všeho, co jsem od té doby vybudoval.
Z této zkušenosti jsem založil SEO Alive — agenturu pro značky, které to s organickým růstem myslí vážně. Nejsme tady, abychom prodávali dashboardy a měsíční reporty. Jsme tady, abychom stavěli strategie, které opravdu pohnou výsledky, kombinací toho nejlepšího z klasického SEO se vzrušujícím novým světem Generative Engine Optimization (GEO) — abychom zajistili, že se vaše značka objeví nejen v modrých odkazech Googlu, ale i uvnitř odpovědí generovaných AI, které ChatGPT, Perplexity a Google AI Overviews každý den dodávají milionům lidí.
A protože jsem nenašel nástroj, který by oba tyto světy zvládal pořádně, postavil jsem si vlastní — SEOcrawl AI, enterprise SEO intelligence platformu, která spojuje rankings, technické audity, monitoring backlinků, zdraví crawlu a sledování viditelnosti značky v AI na jednom místě. Je to platforma, kterou jsem si vždy přál, aby existovala.
Objevte další obsah od tohoto autora

