


«Objeveno – momentálně neindexováno»: co to znamená a jak to opravit
Google ví, že vaše URL existuje, ale ještě ji nenavštívil. Takto poznáte, zda čekat, nebo jednat, a jaké opravy zkusit nejdřív na malém a velkém webu.
Objeveno – momentálně neindexováno znamená, že Google URL našel, ale ještě ji neprocházel. Tak to popisuje nápověda k přehledu Indexování stránek od Google. Obvykle Google procházení plánoval a odložil ho, aby váš web nepřetížil, a proto je v přehledu datum posledního procházení prázdné.
Je to stav priority procházení, ne verdikt o vašem obsahu, protože Google stránku ještě nečetl. Níže uvidíte, jak se liší od «Prohledáno», co jsme zjistili při kontrole vlastního webu a seznam oprav seřazený podle velikosti webu. S přehledem teprve začínáte? Začněte tímto průvodcem Google Search Console.
Co znamená «Objeveno – momentálně neindexováno»
Google vede URL čtyřmi kroky: nalezení, procházení, indexování a poté případné zobrazení ve výsledcích. Dva stavy Search Console popisují URL, která se po cestě zasekla.
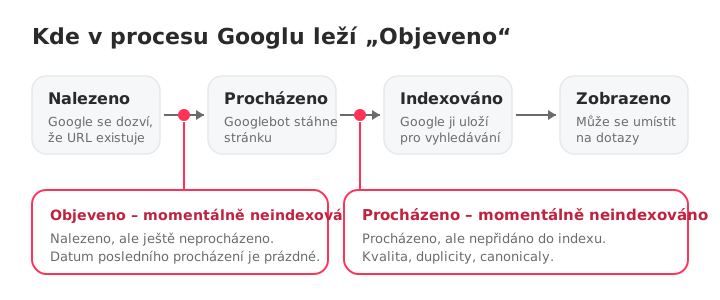
URL se dostane do «nalezeno» přes vaši sitemapu nebo odkazy z jiných stránek. Pak Google rozhoduje, kdy ji projde. «Objeveno» znamená, že k tomu rozhodnutí ještě nedošlo.
Rozdíl oproti «Prohledáno – momentálně neindexováno»
Oba stavy vypadají podobně a vyžadují různé opravy.
| Objeveno – momentálně neindexováno | Prohledáno – momentálně neindexováno | |
|---|---|---|
| Procházel ji Google? | Ne | Ano |
| Datum posledního procházení | Prázdné | Datum |
| Četl Google stránku? | Ne | Ano |
| Obvyklý důvod | Procházení odloženo nebo nízká priorita | Google stránku přečetl a zavrhl |
| Nejdřív zkontrolovat | Interní odkazy, sitemapa, kapacita procházení | Kvalita obsahu, duplicity, canonicaly |
Úplná diagnostika druhého stavu je v průvodci Prohledáno – momentálně neindexováno.
Jak vypadá seznam na skutečném webu
Zkontrolovali jsme seocrawl.ai v přehledu Indexace v SEOcrawlu. Z 1 000 URL, které SEOcrawl sleduje (naše sitemapa jich uvádí 6 310), je 823 indexováno, tedy 82,3 %. 128 je ve stavu «Prohledáno – momentálně neindexováno» a 14 v «Objeveno – momentálně neindexováno».
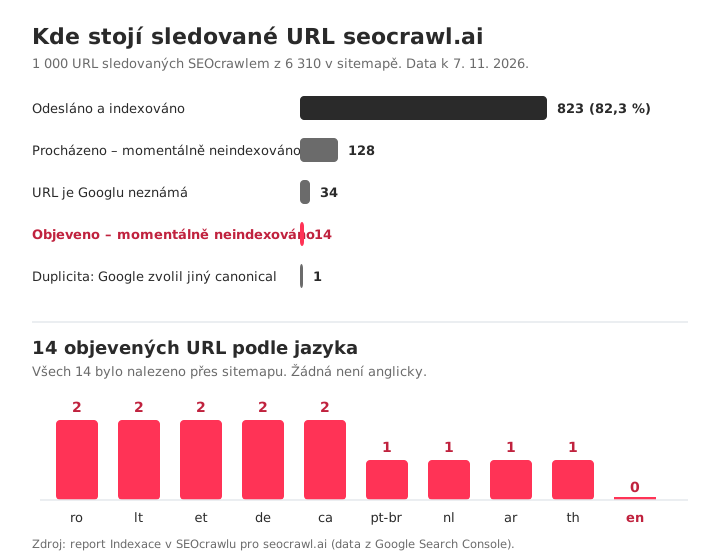
To, co mají těch 14 společné, je užitečná část:
- Všechny jsou přeložené stránky: arabština, katalánština, němčina, estonština, litevština, nizozemština, brazilská portugalština, rumunština a thajština. Žádná není anglicky.
- Google našel všech 14 přes sitemapu, a ne přes odkaz z jiné stránky.
- Jedna z nich má dřívější datum procházení (9. května 2026), takže stav popisuje, kde URL je nyní, ne že ji Google nikdy nenavštívil.
Je to vzorec ke kontrole, ne diagnóza. Stránka, která existuje ve 26 jazycích a je dostupná hlavně přes sitemapu, je přirozeným kandidátem na slabé interní odkazy, takže interní odkazy jsou první věc, na kterou se podívat. Poučení platí pro každý web: nečtěte seznam URL po URL. Seskupeno podle jazyka se z 14 URL stala jedna otázka.
Čísla pokrývají 1 000 URL, které SEOcrawl sleduje, tedy vzorek celé sitemapy. Větší skupina 128 URL je jiný stav a má vlastního průvodce.
Proč Google procházení odkládá
Průvodce crawl budgetem od Google vysvětluje, jak rozhoduje, kolik toho projde: limit kapacity, který váš server zvládne, a poptávka po vašich URL. Většinu objevených URL lze vysledovat k jedné z těchto pěti příčin.
- Kapacita procházení. Google uvádí, že limit klesá, když se web zpomalí nebo vrací chyby serveru. Pomalý server znamená méně procházení.
- Nízká poptávka po procházení. Poptávka závisí na velikosti webu, frekvenci aktualizací a kvalitě i relevanci stránek. URL s málo interními odkazy, nebo žádnými, dává Googlu málo důvodů se rychle vrátit.
- Plýtvání procházením. Duplicitní URL, parametry, fazety, dlouhé řetězce přesměrování a soft 404 soupeří s vašimi skutečnými stránkami. Google poznamenává, že soft 404 se dál procházejí a plýtvají rozpočtem a že stránku s noindex stále požaduje, než ji opustí.
- Nalezeno jen přes sitemapu. Sitemapa Googlu sděluje, že URL existuje. Nedělá z ní prioritu a Google ji bere jako nápovědu. Stránky nalezené jen tam čekají jako první.
- Nový web nebo sekce. Každý web začíná se stejným opatrným výchozím limitem kapacity, který roste, jak web prokazuje zdraví.
Samotný crawl budget si zaslouží pozornost jen u velmi velkých webů. Hrubý odhad Google: 1 000 000+ unikátních stránek aktualizovaných zhruba týdně, nebo 10 000+ stránek měnících se denně. U menších webů jsou příčiny 2 a 4 mnohem běžnější.
Je to problém? Tři otázky, než cokoli opravíte
- Má se tato URL vůbec indexovat? Pokud jde o filtrované zobrazení, interní vyhledávací stránku nebo testovací URL, je normální, že chybí. Chcete-li to vyjádřit explicitně, použijte noindex nebo vraťte 404 či 410 (viz Excluded by 'noindex' tag).
- Kolik URL a s jakým vzorcem? Google uvádí, že při méně než 500 stránkách tento přehled pravděpodobně ani nepotřebujete. Seznam je navíc omezen na 1 000 řádků, takže u velkého webu jde o vzorek.
- Jsou nové? URL publikovaná minulý týden zatím problém není. Časová rozmezí samotného Google jsou v tabulce níže.
Jak to opravit podle velikosti webu
Správný první krok závisí na velikosti vašeho webu, takže začněte ve správném sloupci.
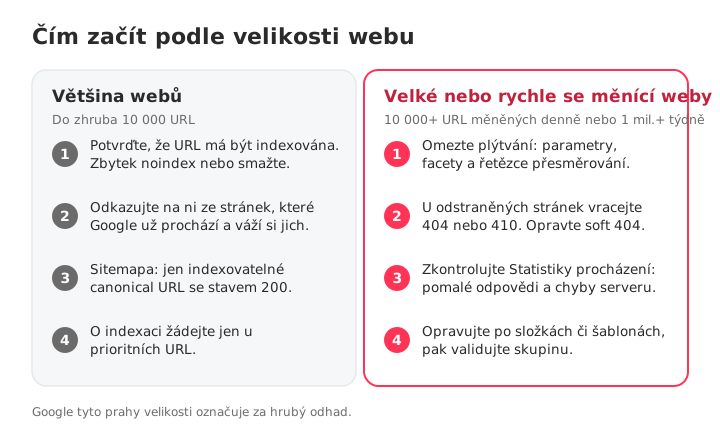
Většina webů: do cca 10 000 URL
- Potvrďte, že URL si indexaci zaslouží. Pokud ne, použijte noindex nebo ji odstraňte a vyřaďte ze seznamu.
- Odkazujte ze stránek, které Google už prochází. Přidejte kontextové odkazy s popisným textem odkazu ze stránek, které jsou indexované a mají návštěvnost. Každý crawler zobrazí vaše osiřelé stránky filtrem na stránky bez interních odkazů a tento průvodce interním prolinkováním obsahuje celou metodu.
- Udržujte sitemapu čistou. Uvádějte jen URL, které vracejí 200, jsou indexovatelné a jsou canonical verzí, se správným
lastmod. Google ignoruje priority a changefreq. Pokud nejdřív potřebujete soubor, najděte svou sitemapu. Pokud Search Console hlásí, že žádnou nenašla, viz No referring sitemaps detected. - Požádejte o indexaci několika prioritních URL. Otevřete nástroj Kontrola adresy URL a klikněte na Požádat o indexování. Google uplatňuje kvótu a uvádí, že opakované žádosti nic neurychlí, takže si to nechte pro stránky, na kterých záleží nejvíc.
Velké nebo rychle se měnící weby: 10 000+ URL změněných denně nebo 1 mil.+ týdně
- Omezte plýtvání procházením. V robots.txt zablokujte prostory URL bez hodnoty pro vyhledávání (parametry, fazety, interní vyhledávání) a duplicity sjednocujte canonicaly a přesměrováními 301. Nespoléhejte, že noindex ušetří rozpočet: Google ty stránky dál požaduje.
- U odstraněných stránek vracejte 404 nebo 410 a opravte soft 404. Google označuje 404 za silný signál, aby URL znovu neprocházel, zatímco blokované URL zůstávají ve frontě déle. Zkraťte každý dlouhý řetězec přesměrování.
- Zkontrolujte statistiky procházení. V Nastavení ukazuje přehled Statistiky procházení doby odezvy a chyby serveru. Pokud jsou vysoké, Google snižuje váš limit kapacity a žádná oprava obsahu nepomůže, dokud se server nezlepší.
- Opravujte po složkách či šablonách a pak skupinu ověřte. Udělejte jedno rozhodnutí na vzorec, vytvořte sitemapu jen s opravenými URL a klikněte na Ověřit opravu. Přečtěte si víc o crawl budgetu, pokud váš web patří do této kategorie.
Čekat, nebo jednat?
Nejtěžší není oprava, ale vědět, kdy přestat čekat. Použijte rozmezí od samotného Google a vlastní trend.
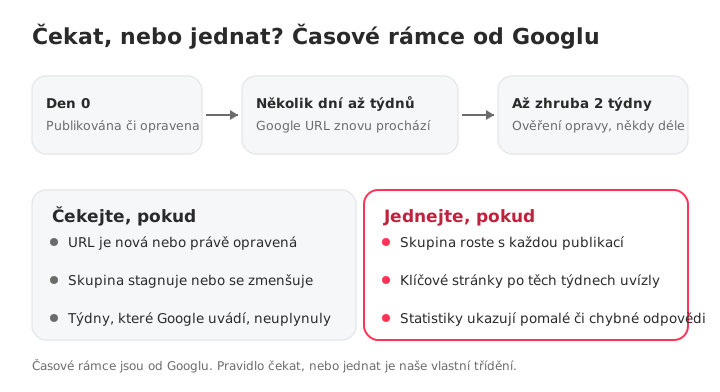
| Co jste udělali | Co říká Google | Zdroj |
|---|---|---|
| Požádali jste Google o nové procházení | Od několika dní po několik týdnů | Žádost Googlu o nové procházení |
| Požádali jste o indexaci | Obvykle zhruba den, až jeden či dva týdny, s denní kvótou | Nápověda ke kontrole URL |
| Ověřili jste opravu | Až cca dva týdny, někdy mnohem déle | Nápověda k indexování stránek |
Časová rozmezí jsou od Google. Pravidlo čekat, nebo jednat je naše: čekejte, dokud je URL nová a skupina je stabilní nebo se zmenšuje, a jednejte, když skupina dál roste nebo vaše klíčové stránky po těch týdnech uvázly.
Jak to sledovat v čase
Search Console ukazuje poslední stav každé URL a seznam omezený na 1 000 řádků, takže si vytvořte vlastní rutinu:
- Jednou za měsíc exportujte seznam a porovnejte ho s předchozím. Skupina roste, je stabilní, nebo se zmenšuje?
- Seskupujte podle vzorce (jazyk, složka, šablona), než se podíváte na jednotlivé URL.
- Zjistěte, jak Google každou URL našel. Seznam, kde je všude «sitemapa» a nikde «odkazující stránka», jako u našich 14 URL, míří přímo na interní odkazy.
Zobrazení Indexace v SEOcrawl AI dodá tento seznam hotový: filtrujte podle stavu pokrytí a uvidíte URL v něm, s datem posledního procházení, kliky a zobrazeními. Přes MCP má každá URL také canonical vybraný Googlem oproti deklarovanému a informaci, zda byla nalezena přes sitemapu, nebo odkazující stránku. Crawler auditují vaše vlastní stránky, takže uvidíte, co je u URL slabé, než Google požádáte o další pohled, a SEO Monitor upozorní, když klíčová stránka dostane noindex, změní canonical, vrátí 404 nebo zmizí ze sitemapy.
Tady je ten seznam pro náš vlastní web, přímo ze zobrazení Indexace:
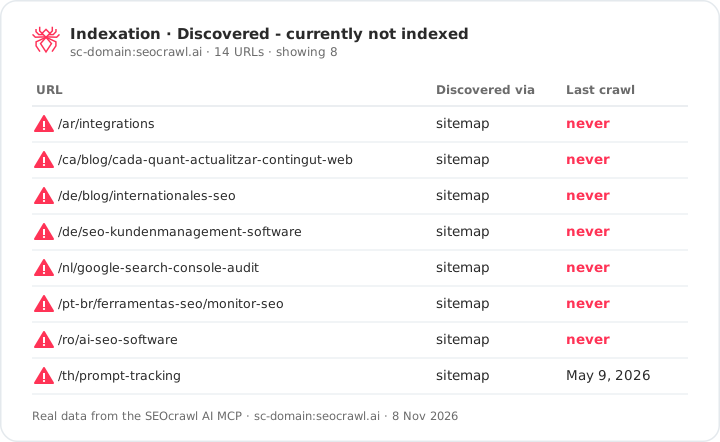
Dashboard můžete také přeskočit. S MCP SEOcrawl AI připojeným ke Claude nebo ChatGPT se zeptejte: «Zobraz URL ve stavu Objeveno – momentálně neindexováno a seskup je podle složky.» Tady je postup krok za krokem, jak propojit Search Console s Claude a ChatGPT.
Často kladené otázky
Co znamená «Objeveno – momentálně neindexováno»?
Znamená, že Google vaši URL našel, ale ještě ji neprocházel. Obvykle Google procházení plánoval a odložil, a proto je datum posledního procházení prázdné (nápověda k indexování stránek). Google stránku nečetl, takže stav o její kvalitě nic nevypovídá. Není to penalizace.
Jak dlouho trvá «Objeveno – momentálně neindexováno»?
Google pro tento stav nezveřejňuje lhůtu. Uvádí, že vyžádané nové procházení trvá od několika dní do několika týdnů a ověření opravy až cca dva týdny, někdy mnohem déle. Nová URL může ty týdny prostě potřebovat. Pokud skupina s vaším publikováním dál roste, přestaňte čekat a jednejte.
Vyřeší to žádost o indexaci?
Může pomoci u několika prioritních URL, protože žádá Google, aby stránku zařadil do fronty. Nemění příčinu, takže se stránka může vrátit ke stejnému stavu. Žádosti podléhají denní kvótě a Google uvádí, že opakované odesílání téže URL nic neurychlí. Použijte to po zlepšení interních odkazů, nikdy jako hromadný nástroj.
Je to penalizace?
Ne. Ruční akce mají samostatný přehled. Tento stav znamená, že Google URL našel a ještě ji neprocházel, takže stránku nehodnotil. Příčinou bývá priorita procházení: slabé interní odkazy, pomalý server nebo hromada málo hodnotných URL soupeřících o procházení.
Proč je tolik mých stránek objeveno, ale neindexováno?
Vysoké číslo obvykle ukazuje na vzorec, ne na jednotlivé stránky: parametry URL nebo fazety, duplicity, sitemapu s URL, které tam nepatří, slabé interní odkazy na celou sekci nebo server, který Googlebota brzdí. Seskupte URL podle složky, jazyka nebo šablony, než se podíváte na kteroukoli zvlášť.
Mám se na malém webu znepokojovat?
Obvykle ne. Google uvádí, že pokud má váš web méně než 500 stránek, přehled Indexování stránek pravděpodobně ani nepotřebujete. Několik nových URL v tomto stavu většinou potřebuje čas a pár interních odkazů ze stránek, které Google už prochází.
Jak může SEOcrawl AI pomoci s objevenými URL?
Zobrazení Indexace v SEOcrawl AI vypisuje URL zaseknuté v každém ze stavů pokrytí Google, s datem posledního procházení, kliky a zobrazeními. Přes MCP SEOcrawl AI také můžete požádat Claude nebo ChatGPT o tento seznam s canonicalem Google oproti deklarovanému a informací, zda Google každou URL našel přes sitemapu, nebo odkazující stránku, a nechat ho seskupit podle složky.
Více SEOcrawl AI v Googlu
Vyberte si nás jako preferovaný zdroj a uvidíte víc našich článků v Hlavních zprávách Google.
Autor: David Kaufmann
Posledních 10+ let jsem byl naprosto posedlý SEO — a upřímně, jinak bych to mít ani nechtěl.
Moje kariéra dostala nový rozměr, když jsem pracoval jako senior SEO specialista pro Chess.com — jeden ze 100 nejnavštěvovanějších webů celého internetu. Pracovat v takovém měřítku, na milionech stránek, v desítkách jazyků a v jedné z nejkonkurenčnějších SERP, mě naučilo věci, které žádný kurz ani certifikát nemůže předat. Tato zkušenost změnila mou perspektivu na to, jak vypadá opravdu skvělé SEO — a stala se základem všeho, co jsem od té doby vybudoval.
Z této zkušenosti jsem založil SEO Alive — agenturu pro značky, které to s organickým růstem myslí vážně. Nejsme tady, abychom prodávali dashboardy a měsíční reporty. Jsme tady, abychom stavěli strategie, které opravdu pohnou výsledky, kombinací toho nejlepšího z klasického SEO se vzrušujícím novým světem Generative Engine Optimization (GEO) — abychom zajistili, že se vaše značka objeví nejen v modrých odkazech Googlu, ale i uvnitř odpovědí generovaných AI, které ChatGPT, Perplexity a Google AI Overviews každý den dodávají milionům lidí.
A protože jsem nenašel nástroj, který by oba tyto světy zvládal pořádně, postavil jsem si vlastní — SEOcrawl AI, enterprise SEO intelligence platformu, která spojuje rankings, technické audity, monitoring backlinků, zdraví crawlu a sledování viditelnosti značky v AI na jednom místě. Je to platforma, kterou jsem si vždy přál, aby existovala.
Objevte další obsah od tohoto autora
Změřili jsme prokliky z Google a návštěvnost z AI asistentů na více než 16 000 webech v 15 odvětvích. Návštěvnost z AI roste o 45 % ročně, ale stále odpovídá zhruba 1 návštěvě na každých 100 z Google, zatímco prokliky z Google klesly o 15 %.

Do 30. listopadu stojí první rok jakéhokoli ročního tarifu SEOcrawl AI s kódem BLACKFRIDAY2026 polovinu. Co dostanete, co pokrývají prompty v každém tarifu a jak za 15 minut zjistit, kde vás zmiňují ChatGPT, Gemini, Claude a Perplexity.