Vyloučeno značkou 'noindex': co to znamená a jak to opravit
Otevřeli jste Google Search Console, všimli si skupiny URL se stavem "Vyloučeno značkou 'noindex'," a tyto stránky jsou teď ve vyhledávání neviditelné.
Pokud jste v Google Search Console narazili na skupinu URL se stavem "Vyloučeno značkou 'noindex'", vaše stránky jsou záměrně drženy mimo index Googlu, a oprava je obvykle jednodušší, než se zdá: najděte direktivu, odstraňte ji a požádejte Google o nové procházení.
Tento průvodce přesně vysvětluje, co tento stav spouští, jak najít direktivu noindex, která ho způsobuje, a jak ji krok za krokem odstranit ve všech hlavních CMS, aby se vaše stránky mohly znovu umisťovat ve výsledcích. Stejná kontrola běží automaticky v Crawleru SEOcrawl AI, který označí direktivy noindex na celém webu bez kontroly URL po jedné.
Co znamená "Vyloučeno značkou 'noindex'" v Google Search Console?
Stav "Vyloučeno značkou 'noindex'" znamená, že Googlebot vaši stránku prošel, našel direktivu noindex a respektoval ji tím, že stránku nezařadil do indexu Googlu. Dokud direktiva zůstane, stránka se ve výsledcích vyhledávání nezobrazí.
Kde se tento stav v GSC zobrazuje
Ve starém přehledu Pokrytí (v roce 2022 ho nahradil přehled Indexování stránek) se tento stav zobrazoval v části "Vyloučeno". V současném přehledu Indexování stránek (Indexování › Stránky) ho najdete v části "Neindexováno", v tabulce "Proč stránky nejsou indexovány", s důvodem "Vyloučeno značkou 'noindex'". Google pod tímto štítkem seskupuje všechny dotčené URL, takže je můžete hromadně exportovat a projít.
Jak Google direktivu noindex zjistí a respektuje
Dokumentace Googlu o blokování indexování pomocí noindex popisuje dva způsoby předání: značku <meta name="robots" content="noindex"> v HTML sekci <head> stránky, nebo direktivu X-Robots-Tag: noindex v hlavičkách HTTP odpovědi. Když Googlebot narazí na kteroukoli z nich, stránku z indexu zcela odstraní, i když byla dříve zaindexovaná. Základy samotné značky najdete v našem průvodci meta značkou noindex.
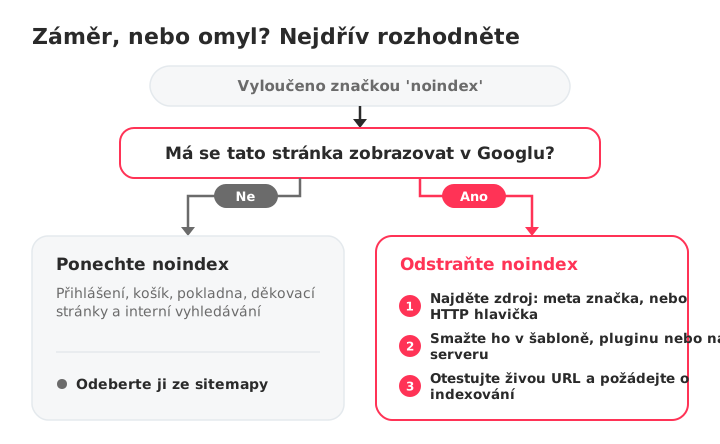
Je to vždy problém? Kdy je vyloučení záměrné
Ne každá URL se stavem "Vyloučeno značkou 'noindex'" je chyba. Administrace, přihlašovací obrazovky, košík a pokladna, děkovací stránky a výsledky interního vyhledávání jsou z indexu Googlu vyloučeny záměrně. Pokud tyto stránky tento stav mají, systém funguje tak, jak má. Skutečný problém nastává, když tento štítek nesou stránky, které chcete mít ve výsledcích.
Časté příčiny stavu "Vyloučeno značkou 'noindex'"
Direktiva noindex se na vaši stránku může dostat několika různými cestami. To, která z nich je na vašem webu aktivní, určuje, jak problém opravit.
Meta značka robots s "noindex" v <head>
Nejčastější zdroj. Řádek jako <meta name="robots" content="noindex"> v HTML vaší stránky říká Googlebotu, aby ji neindexoval. Může být napevno v šabloně, nebo ho dynamicky vkládá CMS, plugin či funkce šablony.
X-Robots-Tag v hlavičkách HTTP odpovědi
X-Robots-Tag funguje stejně jako meta značka, ale nachází se v hlavičce HTTP odpovědi, ne v HTML. Přidat ji může konfigurace serveru, pravidla CDN nebo direktivy v .htaccess. Například:
Header set X-Robots-Tag "noindex"
Týká se to každého souboru, který odpovídá pravidlu, včetně PDF a obrázků, které HTML sekci <head> nemají. Mnoho majitelů webů tuto cestu úplně přehlédne, protože direktiva není vidět ve zdrojovém kódu stránky.
Nastavení CMS, které omylem blokuje indexování
WordPress má v Nastavení › Zobrazování zaškrtávací políčko "Požádat vyhledávače, aby neindexovaly tento web". Pokud je zaškrtnuté, WordPress přidá značku robots noindex na každou stránku webu. Mnoho majitelů webů ho zapne během vývoje a po spuštění ho zapomene vypnout.
Shopify může noindex použít prostřednictvím kódu šablony nebo aplikací. Některé stránky účtu a systémové stránky drží mimo index sám Shopify, což je správně, ale úprava šablony nebo SEO aplikace může omylem přidat noindex na stránky produktů, kolekcí nebo blogu.
Wix použije noindex na každou stránku, jejíž nastavení SEO brání vyhledávačům v indexování. Častým spouštěčem je duplikace stránky, při které kopie nepozorovaně převezme nastavení noindex z originálu.
Konflikty pluginů nebo šablon, které přidávají noindex
SEO pluginy umožňují nastavit noindex pro jednotlivé příspěvky, stránky nebo typy obsahu. Špatně nastavené globální pravidlo, aktualizace pluginu, která resetuje nastavení, nebo šablona, která přepíše direktivy pluginu, mohou rozšířit noindex na desítky stránek najednou. Pokud jste nedávno aktualizovali plugin nebo změnili šablonu, zkontrolujte nejdřív toto.
Nastavení stagingu nasazené do produkce
Překvapivě častý zdroj nechtěných značek noindex. Váš staging web používá noindex, aby se nedostal do Googlu. Když build pipeline přenese konfiguraci stagingu do produkce, direktiva noindex se přenese s ní. Obvykle to zasáhne celé sekce webu najednou a patří to k nejhůře diagnostikovatelným příčinám, pokud kontrolujete jen jednotlivé stránky.
Jak zjistit, kterých stránek se problém týká
Opakovatelný diagnostický postup zachytí všechny dotčené URL bez hádání. Začněte v Search Console, kde získáte seznam, a pak přejděte k jednotlivým stránkám a najděte zdroj.
Export dotčených URL z přehledu Indexování stránek
Otevřete Google Search Console a přejděte do Indexování › Stránky. V tabulce "Proč stránky nejsou indexovány" klikněte na "Vyloučeno značkou 'noindex'". Search Console zobrazí vzorek dotčených URL; tlačítkem Exportovat si seznam stáhnete k dalšímu zpracování.
Kontrola jedné URL v nástroji Kontrola URL
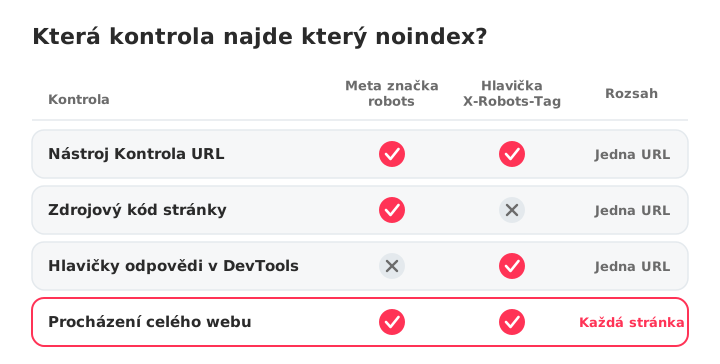
Vložte libovolnou URL do vyhledávacího pole v horní části Search Console. Nástroj Kontrola URL ukáže, zda Google viděl direktivu noindex a kde ji našel: v části "Indexování povoleno?" uvádí, zda noindex pochází z meta značky robots, nebo z HTTP hlavičky X-Robots-Tag. Kliknutím na Zobrazit procházenou stránku uvidíte přesně to HTML, které Googlebot obdržel. Je to nejrychlejší dostupná kontrola jedné stránky.
Kontrola zdrojového kódu stránky kvůli meta značkám noindex
Otevřete stránku v prohlížeči, klikněte pravým tlačítkem, zvolte Zobrazit zdrojový kód stránky a vyhledejte "noindex" (Ctrl+F nebo Cmd+F). Pokud najdete <meta name="robots" content="noindex"> nebo něco podobného, viníkem je meta značka. Pokud ji ve zdrojovém kódu nenajdete, direktiva může přicházet z HTTP hlavičky.
Kontrola HTTP hlaviček v DevTools prohlížeče
Otevřete DevTools (F12, nebo pravé tlačítko › Prozkoumat), přejděte na kartu Network, znovu načtěte stránku a klikněte na hlavní požadavek dokumentu. V sekci Response Headers hledejte X-Robots-Tag: noindex. Je to jediný způsob, jak přímo v prohlížeči zachytit direktivy noindex v hlavičce, které se v HTML neobjevují.
Procházení webu pomocí Screaming Frog nebo SEOcrawl AI
Pro diagnostiku celého webu zachytí crawler všechny dotčené stránky během jednoho průchodu. Screaming Frog SEO Spider umí filtrovat stránky podle indexovatelnosti napříč meta značkami i hlavičkami. Crawler SEOcrawl AI projde každou stránku, každou s direktivou noindex označí v sekci Indexability a vrátí Audit Health Score, takže vidíte celý rozsah problému bez ručního exportu a filtrování.
Jak opravit "Vyloučeno značkou 'noindex'": krok za krokem
Toto je nejpraktičtější část. Postupujte podle opravy, která odpovídá vaší diagnóze z předchozí části.
Odstranění meta značky noindex ze zdrojového kódu stránky
Upravte šablonu nebo obsah stránky a odstraňte <meta name="robots" content="noindex"> z HTML sekce <head>. U webů na míru zkontrolujte přímo soubory šablon. Pokud značku vkládá JavaScript, najděte odpovědný skript a odstraňte ho, nebo ho podmiňte.
Před:
<meta name="robots" content="noindex">
Po:
<meta name="robots" content="index, follow">
Nebo značku jednoduše úplně odstraňte. Google považuje absenci direktivy noindex za "indexování povoleno".
Oprava X-Robots-Tag v konfiguraci serveru nebo CDN
Zkontrolujte .htaccess (Apache), nginx.conf (Nginx) nebo pravidla CDN, zda neobsahují direktivy X-Robots-Tag: noindex. Odstraňte je, nebo je omezte jen na konkrétní cesty, které mají být vyloučené, a ne na stránky, které chcete indexovat. Můžete například ponechat noindex na /staging/ a odstranit ho z /blog/.
Jak to opravit ve WordPressu
Dvě kontroly, v tomto pořadí:
- Nastavení pro celý web: přejděte do Nastavení › Zobrazování a zrušte zaškrtnutí "Požádat vyhledávače, aby neindexovaly tento web". Je to nejčastější příčina problémů s noindex na celém webu ve WordPressu.
- Nastavení jednotlivých stránek v SEO pluginech:
- Yoast SEO: otevřete příspěvek nebo stránku, sjeďte k meta boxu Yoast, klikněte na kartu Advanced a nastavte "Allow search engines to show this content in search results?" na "Yes".
- Rank Math: otevřete příspěvek, přejděte do meta boxu Rank Math, klikněte na kartu Advanced a nastavte "Robots Meta" na "Index".
- All in One SEO: upravte příspěvek, otevřete kartu Advanced v nastavení AIOSEO a ujistěte se, že v nastavení robots není zaškrtnuto "No Index".
Zkontrolujte také globální nastavení každého pluginu, zda nemají celé typy obsahu (štítky, rubriky, vlastní typy příspěvků) nastavený noindex. Další nastavení WordPressu najdete v našem průvodci propojením WordPressu s Google Search Console.
Jak to opravit v Shopify
V Shopify noindex obvykle pochází z kódu šablony nebo z aplikace. Otevřete Online Store › Themes › Edit code a v theme.liquid a šablonách stránek vyhledejte meta značku robots s noindex. Poté zkontrolujte, zda vaše SEO aplikace nemají pravidla skrývající produkty, kolekce nebo příspěvky blogu, a zda některý produkt nebo stránka nepoužívá metapole seo.hidden. Stránky účtu a další systémové stránky drží mimo index sám Shopify a tak by to mělo zůstat.
Jak to opravit ve Wixu, Squarespace a dalších nástrojích pro tvorbu webů
Wix: otevřete nastavení SEO stránky (z nabídky stránky) a zapněte "Let search engines index this page". Pokud jste stránku duplikovali, kopie mohla převzít nastavení noindex z originálu.
Squarespace: zkontrolujte nastavení SEO pro celý web, zda neobsahuje volbu, která web skrývá před vyhledávači. U jednotlivých stránek otevřete nastavení stránky a na kartě SEO hledejte "Hide page from search results". Squarespace také ve výchozím stavu drží některé systémové stránky, například košík, mimo výsledky vyhledávání.
Po opravě: žádost o opětovné indexování v Google Search Console
Odstraněním značky noindex dáváte Googlu najevo, že stránku může indexovat, ale stále potřebujete, aby ji Googlebot znovu prošel a změnu potvrdil.
Žádost o indexování v nástroji Kontrola URL
Vložte opravenou URL do vyhledávacího pole Search Console. Kliknutím na Otestovat živou URL ověřte, že je indexování nyní povoleno, a pak klikněte na Požádat o indexování. Google zařadí URL do fronty k novému procházení. Tímto způsobem můžete odeslat více URL, ale Search Console omezuje počet žádostí za den.
Jak dlouho trvá, než Google stránku znovu zaindexuje?
Obvykle několik dní až několik týdnů, podle toho, jak často Googlebot váš web prochází. Weby s vysokou návštěvností a častými aktualizacemi se procházejí rychleji; nové nebo málo navštěvované weby mohou čekat týdny. Žádost o indexování je nejrychlejší signál, který můžete vyslat, ale není to záruka: vaši URL zařadí do fronty procházení, okamžité procházení ale nevynutí.
Odeslání aktualizované XML sitemapy pro rychlejší procházení
Pokud jste opravili mnoho stránek najednou, odešlete aktualizovanou XML sitemapu v sekci Soubory Sitemap v Search Console. Tím dáte najevo, že se váš web změnil, a podpoříte rozsáhlejší nové procházení. Čistá sitemapa bez URL s noindex navíc nevysílá protichůdné signály, o kterých mluvíme dále.
Kdy značku noindex ponechat (záměrná vyloučení)
Ne každou značku noindex je potřeba odstranit. Některé stránky by se ve výsledcích vyhledávání nikdy objevit neměly, a jejich indexování přidává do pohledu Googlu na váš web tenké nebo duplicitní stránky a plýtvá pozorností crawleru.
Stránky, které by nikdy neměly být indexované
- Přihlašovací a registrační stránky
- Košík, pokladna a potvrzení objednávky
- Stránky s výsledky interního vyhledávání (kvůli prevenci duplicitního obsahu)
- Děkovací stránky (lead magnety, odeslané formuláře)
- Administrace a backend
- Staging a vývojová prostředí
- Stránky s filtry a parametry, které generují duplicitní URL
noindex vs. robots.txt: hlavní rozdíly
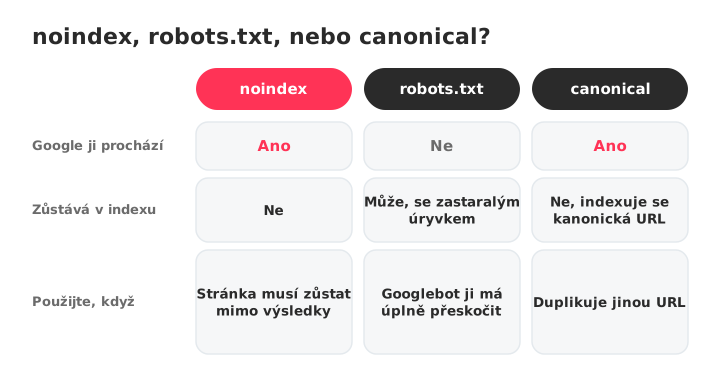
robots.txt blokuje procházení. noindex procházení povoluje, ale blokuje indexování. Pokud stránku zablokujete v robots.txt, Googlebot ji nikdy nepřečte, a tedy nikdy neuvidí ani značku noindex. Chcete-li stránku dostat z indexu, použijte noindex. Chcete-li, aby ji Googlebot úplně přeskočil (kvůli úspoře crawl budgetu), použijte robots.txt.
Častá chyba: blokovat v robots.txt stránku, která už je zaindexovaná. Google nevidí značku noindex, pokud stránku nemůže procházet, takže URL může v indexu zůstat se zastaralým titulkem a úryvkem. Správný postup je procházení povolit a noindex použít k odstranění stránky z indexu.
Kanonické značky vs. noindex: výběr správné direktivy
Kanonická značka (rel="canonical") říká Googlu "tato stránka je kopií té jiné URL, zobrazuj raději tu". Značka noindex říká Googlu "tuto stránku vůbec neindexuj". Každá slouží jinému účelu:
- canonical použijte, když máte duplicitní nebo téměř duplicitní obsah a chcete sloučit signály hodnocení do jedné URL.
- noindex použijte, když se stránka nemá za žádných okolností zobrazovat ve výsledcích vyhledávání.
Kombinace obou na stejné stránce vysílá protichůdné signály: jedna říká "slouč tuto stránku s jinou URL", druhá "zahoď ji". Vyberte tu, která odpovídá vašemu cíli.
Jak nechtěným značkám noindex předejít
Řešit problémy s noindex zpětně je nutné, ale prevence vám ušetří hodiny diagnostiky a ztracenou návštěvnost.
Nastavení upozornění Search Console na pokles indexování
Google Search Console posílá ověřeným vlastníkům a uživatelům e-mail, když u služby zjistí nové problémy s indexováním. Ujistěte se, že máte v e-mailových předvolbách Search Console zapnutá e-mailová oznámení. Když počet indexovaných stránek náhle klesne, upozornění vám dá náskok dřív, než klesne i návštěvnost.
Kontrola noindex v QA checklistu před spuštěním
Před nasazením jakéhokoli webu nebo přenosem stagingu do produkce zkontrolujte direktivy noindex. Třicetivteřinová kontrola přes "Zobrazit zdrojový kód stránky" a vyhledání "noindex" zachytí nejčastější chybu při nasazení. U větších webů proveďte procházení před nasazením a po něm a porovnejte počet stránek s noindex. Přidejte to do svého technického SEO checklistu, aby to nikdo nevynechal.
Plánované procházení k zachycení nechtěných direktiv noindex
Spouštějte úplné procházení podle plánu a také po každé aktualizaci pluginu, změně šablony nebo migraci, abyste zachytili nechtěné značky noindex dřív, než vás připraví o návštěvnost. Crawler SEOcrawl AI umožňuje porovnávat jednotlivá procházení, takže vidíte, které stránky dostaly noindex a kdy, a SEO Monitor vás upozorní ve chvíli, kdy některá z vašich klíčových stránek získá značku noindex.
Často kladené otázky
Co znamená "Vyloučeno značkou 'noindex'" v Google Search Console?
Znamená to, že Google na vaší stránce našel a respektoval direktivu noindex, takže se stránka nebude zobrazovat ve výsledcích vyhledávání. Stav najdete v přehledu Indexování stránek v Search Console, v části "Neindexováno".
Nemusí jít vždy o chybu: stránky, které vylučujete záměrně, například přihlášení nebo pokladna, by tento stav mít měly.
Jak opravit "Vyloučeno značkou 'noindex'" ve WordPressu?
Zkontrolujte postupně dvě místa. Nejprve otevřete Nastavení › Zobrazování a ujistěte se, že volba "Požádat vyhledávače, aby neindexovaly tento web" není zaškrtnutá. Poté otevřete každý dotčený příspěvek nebo stránku v SEO pluginu (Yoast, Rank Math, All in One SEO) a ověřte, že nastavení robots pro danou stránku indexování povoluje.
Jak dlouho trvá, než Google po odstranění noindex stránku zaindexuje?
Obvykle několik dní až několik týdnů, podle toho, jak často Googlebot váš web prochází. Po odstranění direktivy požádejte o indexování v nástroji Kontrola URL a odešlete aktualizovanou XML sitemapu, abyste proces urychlili. Weby s vysokou návštěvností se procházejí znovu rychleji než nové nebo málo navštěvované weby.
Může být stránka vyloučena značkou noindex, i když je v mé sitemapě?
Ano. Direktiva noindex má přednost před zařazením do sitemapy. Google může URL ze sitemapy dál procházet, ale dokud je noindex přítomen, nezaindexuje ji.
Buď noindex odstraňte, aby šla stránka zaindexovat, nebo URL odeberte ze sitemapy, pokud je vyloučení záměrné. Uvádět v sitemapě URL s noindex znamená vysílat protichůdné signály.
Jaký je rozdíl mezi noindex a blokováním stránky v robots.txt?
robots.txt brání Googlebotu stránku procházet; noindex procházení povoluje, ale brání indexování. Pokud stránku zablokujete v robots.txt, Google nemůže značku noindex přečíst, takže už zaindexovaná stránka může v indexu zůstat se zastaralým obsahem. Noindex používejte k odstranění stránky z indexu a robots.txt jen tehdy, když chcete procházení zcela zabránit.
Jak zjistím, zda má stránka značku noindex?
Existují tři metody, od nejrychlejší po nejdůkladnější: použijte nástroj Kontrola URL v Search Console, zobrazte zdrojový kód stránky a vyhledejte "noindex" (Ctrl+F), nebo zkontrolujte hlavičky HTTP odpovědi v DevTools prohlížeče (karta Network, hledejte X-Robots-Tag). Noindex odeslaný v hlavičce zachytí jen nástroj Kontrola URL a DevTools.
Mám se znepokojovat, když má mnoho stránek stav "Vyloučeno značkou 'noindex'"?
Jen pokud by tyto stránky měly být indexované. Exportujte seznam ze Search Console, porovnejte ho se záměrně vyloučenými stránkami (přihlášení, košík, administrace, děkovací stránky) a opravte jen ty, které by se měly zobrazovat ve vyhledávání. Pokud jste všechny dotčené stránky vyloučili záměrně, stav funguje správně.
Autor: David Kaufmann

Posledních 10+ let jsem byl naprosto posedlý SEO — a upřímně, jinak bych to mít ani nechtěl.
Moje kariéra dostala nový rozměr, když jsem pracoval jako senior SEO specialista pro Chess.com — jeden ze 100 nejnavštěvovanějších webů celého internetu. Pracovat v takovém měřítku, na milionech stránek, v desítkách jazyků a v jedné z nejkonkurenčnějších SERP, mě naučilo věci, které žádný kurz ani certifikát nemůže předat. Tato zkušenost změnila mou perspektivu na to, jak vypadá opravdu skvělé SEO — a stala se základem všeho, co jsem od té doby vybudoval.
Z této zkušenosti jsem založil SEO Alive — agenturu pro značky, které to s organickým růstem myslí vážně. Nejsme tady, abychom prodávali dashboardy a měsíční reporty. Jsme tady, abychom stavěli strategie, které opravdu pohnou výsledky, kombinací toho nejlepšího z klasického SEO se vzrušujícím novým světem Generative Engine Optimization (GEO) — abychom zajistili, že se vaše značka objeví nejen v modrých odkazech Googlu, ale i uvnitř odpovědí generovaných AI, které ChatGPT, Perplexity a Google AI Overviews každý den dodávají milionům lidí.
A protože jsem nenašel nástroj, který by oba tyto světy zvládal pořádně, postavil jsem si vlastní — SEOcrawl AI, enterprise SEO intelligence platformu, která spojuje rankings, technické audity, monitoring backlinků, zdraví crawlu a sledování viditelnosti značky v AI na jednom místě. Je to platforma, kterou jsem si vždy přál, aby existovala.
Objevte další obsah od tohoto autora