Как обнаружить и устранить дублированный контент?
Если вы работаете в мире SEO, вы наверняка попадали в ситуацию, когда приходится разбираться с одной из самых частых проблем, которая влияет на позиции в поисковых системах и может привести к санкциям: дублированным контентом. Главная цель поисковых систем вроде Google, Bing или Yahoo — показать самую релевантную информацию под поисковое намерение пользователя. Для этого они ранжируют по убыванию, вознаграждая оригинальный качественный контент и понижая контент, который скопирован, продублирован, нерелевантен или подкручен ради более высоких позиций на страницах результатов.
В этой статье мы разберём, что такое дублированный контент, как его обнаружить и устранить, как он влияет на SEO и какими инструментами с ним можно работать. Присоединитесь? Начинаем! ?
Что такое дублированный контент?
Как мы уже упоминали, поисковые системы вроде Google понижают страницы с дублированным контентом, под которым понимаются две страницы с разными URL, но одинаковым содержимым. Поэтому по возможности избегайте копирования контента с чужого сайта и вставки его к себе (вы сэкономите себе кучу нервов с Google и избежите возможных судебных претензий от владельцев сайтов, откуда вы это взяли!?).
Совет SEO Alive**:** Как агентство, специализирующееся на поисковой оптимизации, мы настоятельно рекомендуем заботиться о контенте на вашем сайте и избегать этой дурной практики. Будьте терпеливы и настойчивы, пишите оригинальные тексты — и результаты придут скорее раньше, чем позже. В этом вопросе Google предельно ясно обозначает свою позицию, что видно в его официальной документации о дублированном контенте, так что с текстами, которые мы пишем, нужно быть очень внимательными.
В SEO-продвижении можно выделить два типа дублированного контента: внутренний и внешний.
Внутренний дублированный контент
Этот тип дублей обычно возникает из-за плохой реализации параметров URL или плохого управления таксономиями категорий и меток. Возможные причины, порождающие внутренние дубли:
- Ошибки при создании категорий и меток: эта ошибка типична для блогов, где есть большой список статей, а категории и метки создаются без какого-либо порядка и логики. Посмотрим на примере:
Представим, что у нас есть блог о digital-маркетинге с несколькими категориями:
https://myblogdigital.com/category-a/topic/
https://myblogdigital.com/category-b/topic/
https://myblogdigital.com/category-c/topic/
Чтобы избежать дублей, нужно обозначить, какая из них основная, а две другие канонизировать на основной URL.
- Домены «без www» против «www» и «http» против «https»: это ещё одна ошибка, на которую надо обратить внимание. Возможно, что если мы не указали поисковым системам, какой домен канонический, они смогут добраться до других версий и породить дубли. Поэтому в SEO Alive мы рекомендуем определить, какой домен будет у вас каноническим, и настроить 301 редиректы на ту версию, которую вы хотите сделать предпочтительной.
- Параметризованные URL: эта ошибка типична для интернет-магазинов, где URL с параметрами позволяют фильтровать и давать информацию пользователям. Допустим, у нас есть сайт по продаже часов и такой URL:
https://www.mywatchstore.com/watches/garmin?color=black
Эта страница показывала бы все часы модели «Garmin» в чёрном цвете.
Возможность задавать фильтры на страницах может обернуться серьёзной проблемой, если ей неправильно управлять, поскольку поисковые системы могут показывать несколько комбинаций URL:
https://www.mywatchstore.com/watches/garmin?color=black&type=sport
https://www.mywatchstore.com/watches/garmin?type=sport&color=black
Поэтому в SEO Alive мы рекомендуем ставить каноническую версию на страницу без фильтров, чтобы остальные параметризованные URL сохраняли авторитет страницы (URL Ratio).
Внешний дублированный контент
Внешний дублированный контент — это любой контент, который извлечён, полностью или частично скопирован с одного или нескольких сайтов, принадлежащих другим вебмастерам или администраторам.
Такая практика считается спамом в глазах поисковых систем, поэтому, как мы говорили в начале статьи, её нужно избегать любой ценой.
Ещё одной причиной внешних дублей могут быть стратегии синдикации, когда сайты гонят трафик на другие площадки, чтобы манипулировать поисковыми системами. Алгоритм Google сегодня достаточно умён, чтобы выявлять такие практики.
Как проверить, есть ли на нашем сайте дублированный контент?
Умение обнаруживать дубли критически важно в контент-стратегии сайта. Если не контролировать этот фактор, есть риск, что наши страницы постепенно уйдут из топа Google, ведь Google непрерывно шлифует выдачу в поисках оригинального качественного контента. Поэтому мы покажем пример того, как можно обнаружить контент на нашем сайте, и дадим несколько стратегий, как избежать такого контента.
Допустим, у нас есть интернет-магазин (ecommerce), где для каждой карточки товара есть версия для печати. Это считается дублем, поскольку есть две «версии» одного и того же содержимого под разными URL:
Страница карточки товара:
https://mywebsite.com/product3560Страница версии для печати:
https://mywebsite.com/product3560_printЧтобы избежать такого типа дублей, можно применить следующие стратегии:
Стратегия №1: использование 301 редиректов
Если мы перестроили структуру сайта, можно настроить 301 редиректы (постоянные редиректы) через SEO-плагины, доступные в репозиториях разных систем управления контентом (CMS), или через файл .htaccess, чтобы грамотно перенаправлять пользователей, ботов поисковых систем и другие инструменты с функцией краулера.
Стратегия №2: использование тега canonical
Тег rel="canonical" используется, чтобы сообщить поисковым системам, какая страница оригинальная (каноническая версия), а какие — копия. Так паук поисковой системы сосредоточит бюджет сканирования на странице, помеченной этим мета-тегом.
Чтобы использовать canonical, сначала нужно выбрать, какую страницу мы хотим показывать в поисковых системах, и добавить следующую строку в HTML-код в секции </head> (посмотрим пример canonical на карточке товара сайта Zalando):
<link rel="canonical" href="https://www.zalando.es/adidas-originals-stripe-circle-camiseta-estampada-white-ad121000k-a11.html"/>
Например, если на одном URL мы показываем детали товара, а на другом — те же детали в других цветах, мы можем сообщить Google, какой URL канонический и какой мы хотим показывать пользователям.
Стратегия №3: использование файла robots.txt
Отредактировав этот файл, мы можем сказать ботам поисковых систем не сканировать определённые страницы или разделы нашего сайта. Представим, что у нас на сайте есть такие страницы товаров:
https://www.mywebsite.com/category/product-page.html/
https://www.mywebsite.com/category/product-page1.html/ (версия с дублированным контентом)
Со следующей директивой в файле robots.txt:
- Disallow /product-page.1html/
мы можем предотвратить появление дублей — вдобавок, разумеется, к назначению первого URL канонической версией.
Влияние дублированного контента на SEO-позиции
После выхода первой версии алгоритма Google Panda ещё в 2011 году, который понижал домены с thin content и дублированным контентом, Matt Cutts опубликовал в 2013 году видео о том, как Google обрабатывает дублированный контент и какие негативные последствия для позиций это может иметь с точки зрения SEO:
Из видео Matt Cutts можно сделать вывод: хотя, по данным Google, 25-30% веба — это дублированный контент, поисковая система не трактует его напрямую как спам, если только намерение не состоит в мошенническом создании или копировании контента в больших объёмах либо в прямой манипуляции позициями на страницах результатов поиска тактиками «black hat».
Словом, создание такого контента может генерировать сигналы низкого качества для поисковых систем вроде Google, а также мешать консолидации ссылочных метрик (таких как авторитет, релевантность или доверие) этого контента с точки зрения внешних ссылок (бэклинков), которые могут вести на разные версии этого контента.
Инструменты для обнаружения дублированного контента
Когда речь заходит об обнаружении дублей, на рынке есть бесчисленное множество инструментов, которые облегчают эту задачу. Посмотрим на них! ?
Инструменты для поиска дублей на нашем сайте
- Ahrefs: в Ahrefs, внутри функции «site audit» и при условии что мы добавили проект для SEO-аудита, можно увидеть, есть ли на нашем сайте дублированный контент. Для этого переходим во вкладку «duplicate content». Там нам покажут график, по которому можно определить возможные ошибки, требующие исправления:
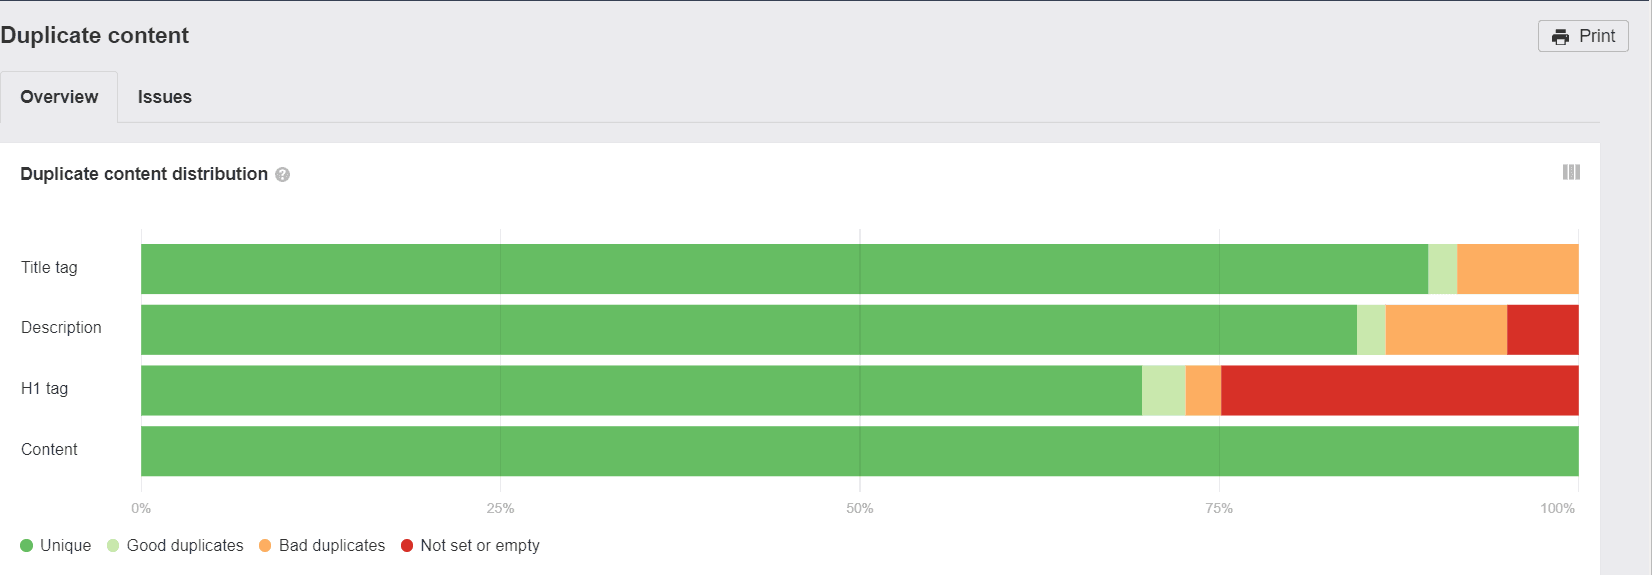
Вид функции «Duplicate Content» в Ahrefs
- Screaming Frog: с помощью этого известного краулера-софта также можно обнаружить дубли. Для этого нужно ввести домен для парсинга и экспортировать данные «internal» в формат .csv. Уже в таблице можно смотреть, сортировать и фильтровать, у каких страниц дублируются заголовки, meta description, заголовки уровней и т. д.
Совет SEO Alive: используйте правила условного форматирования в таблице, чтобы определить, какие URL вы будете исправлять, исходя из уровня дублирования и из важности и значимости каждой страницы.
- Safecont: этот инструмент действительно интересен, поскольку сфокусирован исключительно на анализе контента и использует «machine learning» для обнаружения кластеров и схожести текстов. Он довольно полный, и его использование может дать нам много пользы, если мы хотим найти дубли на нашем сайте.
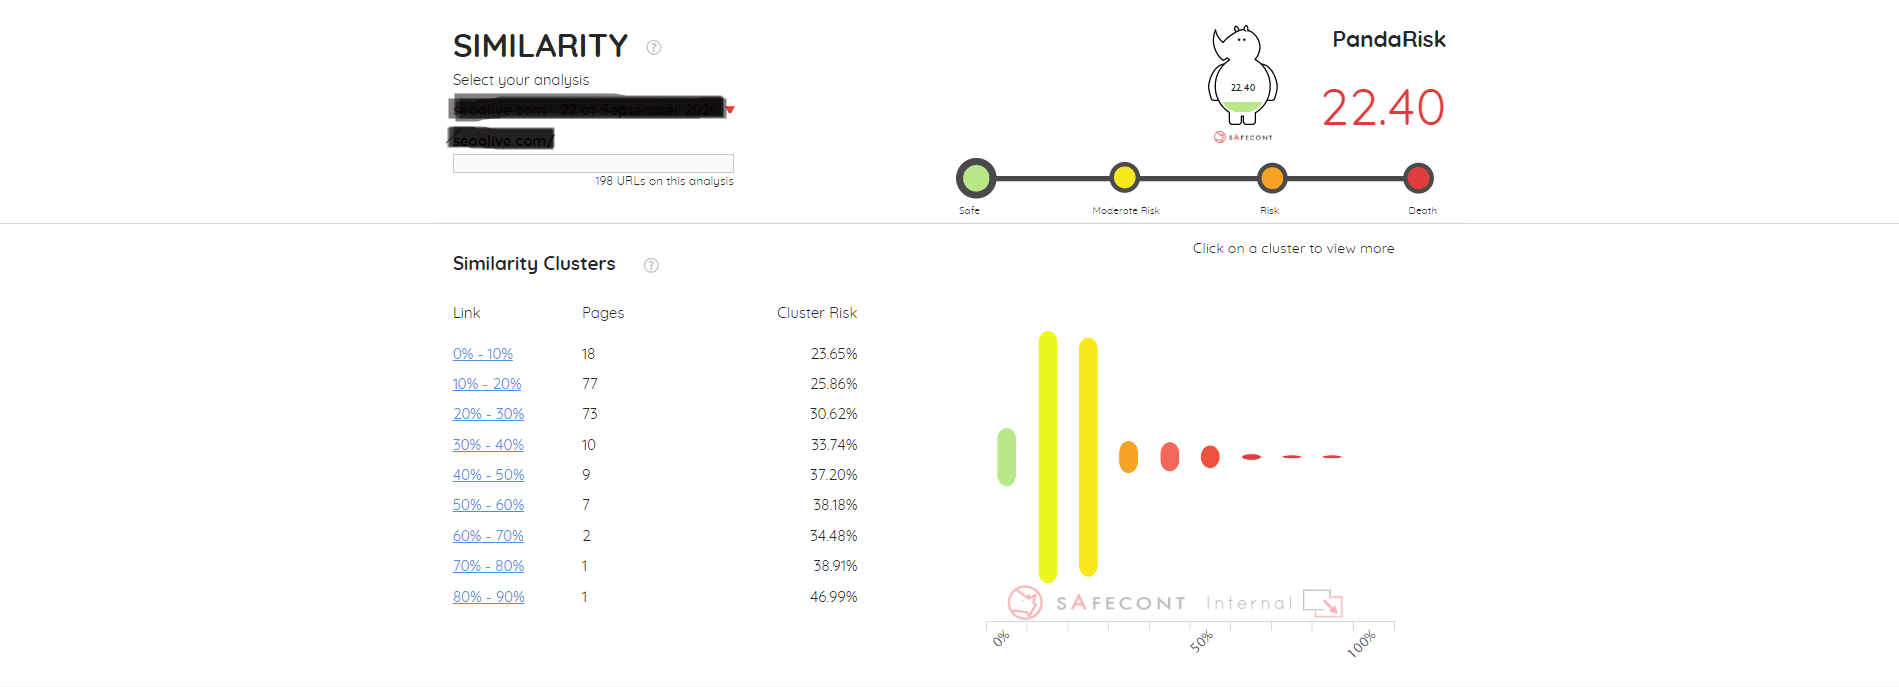
Вид функции «Similarity» в Safecont
Инструменты для поиска дублей с другого сайта
- Copyscape: если мы хотим узнать, дублируется ли контент относительно другого сайта, Copyscape — это поисковик, специализирующийся на выявлении страниц, которые плагиатят контент. В нём достаточно ввести URL, где размещён проверяемый контент, и инструмент вернёт страницы, которые этот контент разделяют, отсортированные по степени совпадения от большей к меньшей.
- Plagium: ещё один инструмент, очень похожий на Copyscape, с той разницей, что вводить нужно текст для проверки, а не URL. Стоит отметить, что у него есть платная версия, поэтому в «бесплатной» действует лимит до 5 000 символов на проверку.
Выводы
В SEO Alive мы на 100% агентство «White Hat SEO», поэтому наша рекомендация в конце статьи — всегда избегать дублированного контента. Если вы обнаружили такой контент на своём сайте, опирайтесь на все стратегии и советы, которые мы дали. ? Помните: Google любит оригинальный качественный контент!
А у вас был неудачный опыт с дублированным контентом или санкции из-за него? Как вы это решили? Расскажите, если захотите, в комментариях! Будем рады ответить. До встречи!
Автор: David Kaufmann

Последние 10 с лишним лет я полностью одержим SEO — и, честно говоря, не хотел бы иначе.
Моя карьера вышла на новый уровень, когда я работал старшим SEO-специалистом в Chess.com — одном из ста самых посещаемых сайтов интернета. Работа в таком масштабе: миллионы страниц, десятки языков и одна из самых конкурентных выдач — научила меня тому, чему не научит ни один курс и ни один сертификат. Этот опыт изменил моё представление о том, как выглядит по-настоящему сильное SEO, и лёг в основу всего, что я построил потом.
Из него выросло SEO Alive — агентство для брендов, которые всерьёз занимаются органическим ростом. Мы не продаём дашборды и ежемесячные отчёты. Мы строим стратегии, которые реально двигают цифры, соединяя классическое SEO с новым и захватывающим миром Generative Engine Optimization (GEO): чтобы ваш бренд появлялся не только в синих ссылках Google, но и внутри ответов, которые ChatGPT, Perplexity и Google AI Overviews каждый день выдают миллионам людей.
А поскольку инструмента, который нормально закрывает оба этих мира, я так и не нашёл, я сделал его сам — SEOcrawl AI, платформу SEO-аналитики корпоративного уровня, где в одном месте собраны позиции, технические аудиты, мониторинг ссылок, здоровье краулинга и отслеживание видимости бренда в ИИ. Это та платформа, которой мне всегда не хватало.
Откройте больше материалов этого автора