Canonical: что это такое и как его использовать
Когда у вас один или несколько сайтов — посвящённых товарам, услугам или разделам разного рода, — часто оказывается, что многие страницы на платформе похожи или почти идентичны по самым разным причинам. Особенно часто это бывает в электронной коммерции, но мы видели это и в консалтинговой работе — на тегах блога и на контенте разных типов.
Легко представить, что проблемы с дублированным контентом могут возникнуть у любого сайта. Google наказывает сайты с дублированным контентом, и это, без сомнения, влияет на их позиции в результатах поиска.
Так как же получается, что у сайтов бывает дублированный контент, а их вебмастерам не приходится бояться санкций?
Ответ кроется в том, что известно как атрибут canonical, или каноническая ссылка, о которой мы подробно поговорим в следующих разделах: что это, зачем нужно, какие даёт преимущества, как применять, когда стоит использовать и какие возможные минусы связаны с атрибутом canonical, когда его применяют, чтобы избежать санкций за дублированный контент.
Что такое каноническая ссылка и атрибут canonical?
В общем виде каноническая ссылка — это ссылка, которая с помощью тега или атрибута описывается как «основная» или «исходная» ссылка на сайте и позволяет указывать на неё с URL страниц с похожим контентом. Благодаря этому ссылка воспринимается ботами Google и поисковыми алгоритмами как предпочтительная, приоритетная версия.
Так контент, который мог бы считаться дублированным, обрабатывается корректно и относительно просто. Если бы он не был описан как канонический, это могло бы повлиять на позиции платформы и привести к санкциям. Такое случается, даже когда дублированный контент появился не намеренно, а естественно и органически — через продажу товаров, предложение услуг, связанные разделы и так далее.
С технической точки зрения канонический URL — это ссылка, прописанная в HTML-коде, которая включает тег canonical и тем самым получает атрибут canonical. Из-за этого боты Google видят её как основной, исходный адрес, как мы говорили выше, и похожие ссылки не считаются повторяющимися или дублированными.
Ниже — пример того, как мы объявляем URL каноническим, то есть основным:
<link rel="canonical" href="/en/">
Происхождение канонических ссылок и их польза для SEO
Канонические ссылки начали использовать в 2009 году, когда три главные поисковые компании интернета — Google, Bing и Yahoo — совместно представили атрибут canonical.
Логично, что у канонической ссылки огромный потенциал с точки зрения SEO: она помогает избежать упомянутых санкций и обозначить для Google наши важнейшие URL.
Поэтому, когда речь идёт о SEO сайта и применении соответствующих стратегий, добавление канонических ссылок всегда входит в план, особенно для большого сайта со значительным числом URL, которые могут быть идентичными.
Как сделать URL каноническим
Когда у вас есть сайт или вы его оптимизируете и обнаруживаете, что похожих URL очень много, нужно запустить процесс канонизации. Он состоит в том, чтобы выбрать лучший URL и присвоить ему атрибут canonical.
Иногда выбрать лучший URL просто, потому что у него самый оптимизированный контент и техническая структура. Однако в других случаях выбор бывает сложнее, особенно когда страницы очень похожи и различить их трудно.
В любом случае есть простая рекомендация: при наличии похожих разделов или страниц всегда лучше выбрать канонический URL. Иначе возможны негативные последствия для позиций и санкции, которые могут навсегда ударить по трафику.
Чтобы сделать URL каноническим, первый шаг — сравнить URL, которые могут быть похожими. Это частая история в интернет-магазинах, где пользователи попадают на товары и списки услуг разными путями, из-за чего появляются URL вроде таких:
-
https://example.com/wordpress/seoplugin/ -
https://example.com/wordpress/pluginseo/
Поскольку оба URL имеют ценность для сайта или ведут к одному и тому же товару или странице, нужно выбрать, какой из двух более значим, вот так:
-
Выберите самый значимый URL — по визитам, трафику и авторитету.
-
Когда ссылка выбрана, добавьте атрибут canonical на неканонической странице так, чтобы он указывал на каноническую. Выглядеть это должно примерно так:
<link rel="canonical" href="https://example.com/wordpress/seo-plugin/">
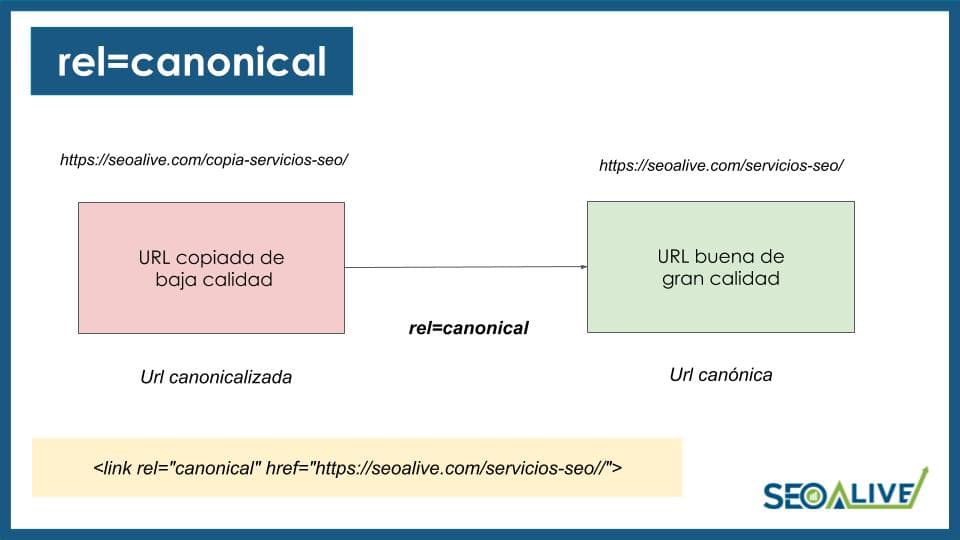
Этим мы говорим Google, какой URL канонизирован (тот, который мы считаем копией оригинала), а какой является каноническим, то есть оригиналом. Эта ссылка размещается на URL-«копии» и указывает на URL-оригинал.
Иначе говоря, схема такая:
Когда стоит использовать канонические URL
Когда у вас сайты с большим числом страниц или разделов — товары, услуги, прочая информация и публикации, — очень вероятно, что часть этих страниц и URL будут очень похожи, и тогда использовать канонические URL крайне желательно.
Однако в таких случаях можно использовать и настоящие 301 редиректы вместо тегов canonical. Это особенно полезно, когда редиректы будут постоянными и происходит миграция сайта. При этом в случае технических проблем или санкций простановка canonical всегда остаётся следующим по рекомендуемости вариантом.
Более того, можно использовать теги canonical на URL разных сайтов — например, для контента, который без изменений переопубликован на других площадках, при наличии соответствующего разрешения, всегда указывая на оригинал, чтобы избежать санкций.
Важное замечание про rel=canonical
То, что мы оставили это напоследок, не делает его менее важным. Нужно чётко понимать: атрибут canonical — это РЕКОМЕНДАЦИЯ для Google, а не директива. Это значит, что Google может её проигнорировать, если сигналы, которые мы шлём на остальном сайте, противоречат тому, как мы её задали.
Иначе говоря, если мы ставим canonical с URL A на URL B, но внутри все ссылки ведут на A, и внешние ссылки тоже ведут на A, Google может проигнорировать этот canonical и считать хорошим именно A. Тогда B окажется копией A и потенциально попадёт под санкции.
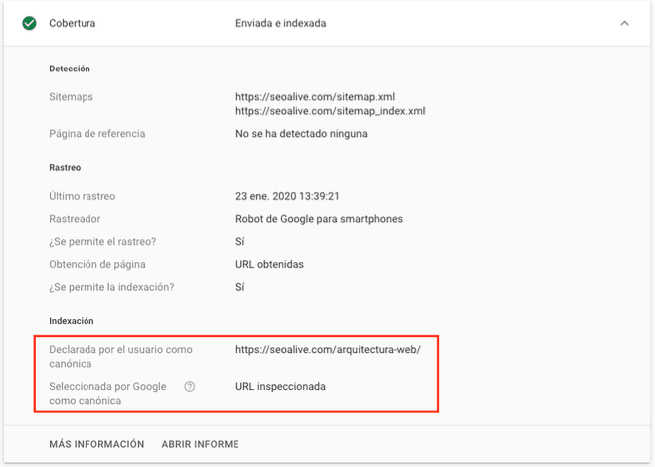
Чтобы узнать, какой URL Google считает оригиналом, а какой каноническим, нужно зайти в Search Console, добавить URL в инспектор и изучить информацию, которую даёт Google Search Console
И там мы получаем такие данные:
Частые ошибки с каноническими URL
С каноническими URL связаны разные проблемы и часто совершаемые ошибки, которые становятся типичными и особенно заметны при неправильном использовании этого инструмента, например:
-
Не нужно канонизировать страницы пагинации на страницу 1. Точно так же тег canonical страницы должен указывать на эту же страницу, например: со страницы 2 на страницу 2, иначе у поисковых систем могут быть трудности с индексацией более глубоких страниц архива.
-
Канонические URL нужно делать эксклюзивными и уникальными, даже если для этого придётся сменить протокол с HTTP на HTTPS.
-
Тег canonical нужно строить на основе нужного URL**, без переменных и напрямую**.
-
Когда у страницы несколько связанных канонических URL, это может быть контрпродуктивно и непредсказуемо. Не забываем, что Google должен понимать наш сайт быстро и ясно, — так давайте ему это упростим.
-
Ещё одна важная ошибка может быть связана с использованием атрибута canonical в body вместо /head или заголовка. В своих официальных сообщениях Google рекомендует использовать атрибут в head как можно раньше, чтобы избежать проблем при разборе всего контента, ведь его могут и не обнаружить.
-
Использование noindex и rel=canonical вместе. Джон Мюллер прямо разбирал это на одном из своих многочисленных хэнгаутов, объясняя, что оба сигнала противоречат друг другу и запутают Google, который возьмёт атрибут canonical, а не noindex. Так что использовать их вместе НИКОГДА не стоит.
-
Указание атрибутов canonical на страницы 404 или 30x. Задумаемся на секунду: если мы ставим атрибут на URL A, указывающий на B, который отдаёт ошибку или делает редирект, разве мы не шлём Google неверные сигналы? Мы говорим ему, что «оригинальный» URL — это страница ошибки или редирект... в этом нет смысла.
Продвинутые способы использования атрибута canonical
У атрибута canonical есть и другие функции и продвинутые применения, например:
- Каноническая ссылка в HTTP-заголовке: такие заголовки очень полезны, когда нужно канонизировать PDF-документы: они не HTML, поэтому, если мы хотим их канонизировать, приходится выбирать этот вариант. Выглядит это так:
Link: <http://www.example.com/downloads/seoguide.pdf>; rel="canonical"
-
Использование canonical на страницах, которые не так уж похожи: технически можно ставить теги canonical на страницы, которые на самом деле не идентичны и даже заметно различаются. Это может помочь общему авторитету сайта, но так делать не рекомендуется, потому что Google умеет выявлять злоупотребление canonical, наказывать сайт и затем игнорировать его настоящие канонические URL.
-
Использование атрибута canonical вместе с Hreflang: можно применять стратегии с Hreflang одновременно с тегом canonical — и при грамотном применении с хорошим результатом. Но нужно чётко понимать: при использовании Hreflang языковая реализация canonical должна быть безупречной и всегда указывать сама на себя, чтобы избежать непредсказуемых проблем или конфликтов, которые принесут обеим стратегиям больше вреда, чем пользы.
Остались вопросы об этом увлекательном SEO-теге? Будем рады помочь!
Автор: David Kaufmann

Последние 10 с лишним лет я полностью одержим SEO — и, честно говоря, не хотел бы иначе.
Моя карьера вышла на новый уровень, когда я работал старшим SEO-специалистом в Chess.com — одном из ста самых посещаемых сайтов интернета. Работа в таком масштабе: миллионы страниц, десятки языков и одна из самых конкурентных выдач — научила меня тому, чему не научит ни один курс и ни один сертификат. Этот опыт изменил моё представление о том, как выглядит по-настоящему сильное SEO, и лёг в основу всего, что я построил потом.
Из него выросло SEO Alive — агентство для брендов, которые всерьёз занимаются органическим ростом. Мы не продаём дашборды и ежемесячные отчёты. Мы строим стратегии, которые реально двигают цифры, соединяя классическое SEO с новым и захватывающим миром Generative Engine Optimization (GEO): чтобы ваш бренд появлялся не только в синих ссылках Google, но и внутри ответов, которые ChatGPT, Perplexity и Google AI Overviews каждый день выдают миллионам людей.
А поскольку инструмента, который нормально закрывает оба этих мира, я так и не нашёл, я сделал его сам — SEOcrawl AI, платформу SEO-аналитики корпоративного уровня, где в одном месте собраны позиции, технические аудиты, мониторинг ссылок, здоровье краулинга и отслеживание видимости бренда в ИИ. Это та платформа, которой мне всегда не хватало.
Откройте больше материалов этого автора