


«Descoperită, momentan neindexată»: ce înseamnă și cum o rezolvi
Google știe că URL-ul tău există și încă nu l-a vizitat. Iată cum îți dai seama dacă să aștepți sau să acționezi și ce remedii încerci mai întâi pe un site mic și pe unul mare.
Descoperită, momentan neindexată înseamnă că Google a găsit URL-ul, dar nu l-a accesat încă cu crawlerul. Așa descrie Ajutorul pentru raportul Indexarea paginilor al Google situația. De obicei, Google a vrut să facă crawling și l-a amânat ca să nu-ți suprasolicite site-ul, de aceea data ultimului crawling rămâne goală în raport.
Este o stare de prioritate de crawling, nu o sentință asupra conținutului tău, pentru că Google nu a citit încă pagina. Mai jos vezi cum diferă de «Accesată cu crawlerul», ce am descoperit verificându-ne propriul site și o listă de remedii ordonată după dimensiunea site-ului. Abia începi cu raportul? Pornește de la acest ghid Google Search Console.
Ce înseamnă «Descoperită, momentan neindexată»
Google duce un URL prin patru etape: găsește, accesează cu crawlerul, indexează și apoi, eventual, afișează în rezultate. Două stări din Search Console descriu un URL rămas blocat pe drum.
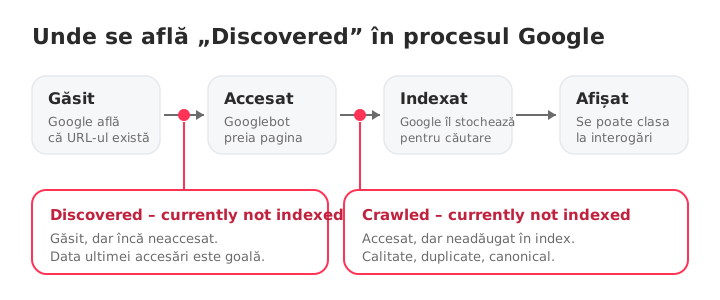
Un URL ajunge la «găsit» prin sitemap sau prin linkuri de pe alte pagini. Apoi Google decide când îl accesează. «Descoperită» înseamnă că decizia aceea nu a fost încă luată.
Cum diferă de «Accesată cu crawlerul, momentan neindexată»
Cele două stări seamănă, dar cer remedii diferite.
| Descoperită, momentan neindexată | Accesată cu crawlerul, momentan neindexată | |
|---|---|---|
| Accesată de Google? | Nu | Da |
| Data ultimului crawling | Goală | O dată |
| A citit Google pagina? | Nu | Da |
| Motiv obișnuit | Crawling amânat sau prioritate scăzută | Google a citit pagina și a ignorat-o |
| Ce verifici mai întâi | Linkuri interne, sitemap, capacitate de crawling | Calitatea conținutului, duplicate, canonicale |
Diagnosticul complet al celei de-a doua stări este în ghidul despre Accesată cu crawlerul, momentan neindexată.
Cum arată lista pe un site real
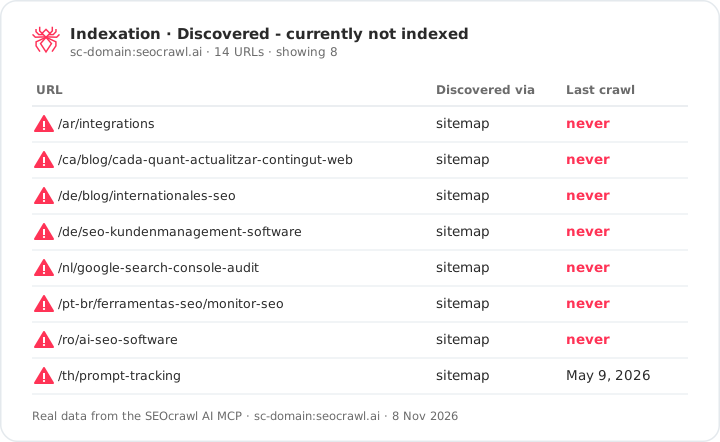
Am verificat seocrawl.ai în raportul Indexare din SEOcrawl. Din cele 1.000 de URL-uri pe care le monitorizează SEOcrawl (sitemap-ul nostru declară 6.310), 823 sunt indexate, adică 82,3%. 128 sunt în «Accesată cu crawlerul, momentan neindexată» și 14 în «Descoperită, momentan neindexată».
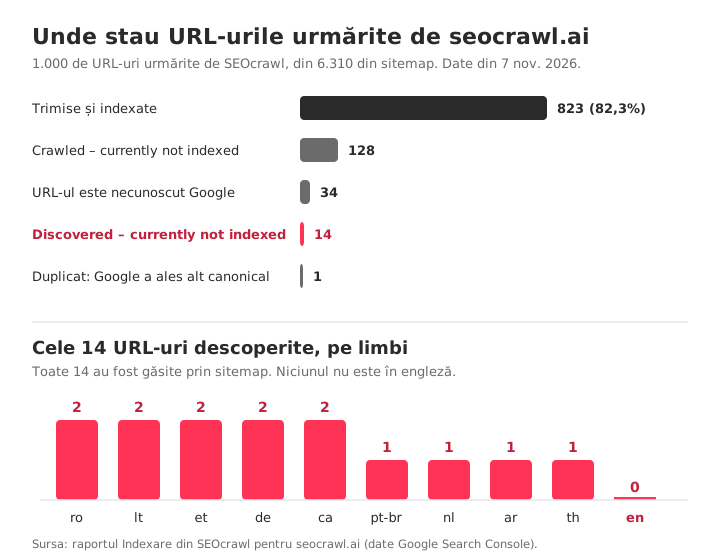
Ce au în comun cele 14 este partea utilă:
- Toate sunt pagini traduse: arabă, catalană, germană, estonă, lituaniană, neerlandeză, portugheză braziliană, română și thailandeză. Niciuna nu este în engleză.
- Google le-a găsit pe toate 14 prin sitemap, nu printr-un link de pe altă pagină.
- Una dintre ele arată o dată de crawling anterioară (9 mai 2026), deci starea descrie unde se află URL-ul acum, nu că Google nu l-a vizitat niciodată.
Este un tipar de verificat, nu un diagnostic. O pagină care există în 26 de limbi și este atinsă mai ales prin sitemap este un candidat firesc pentru linkuri interne slabe, așa că linkurile interne sunt primul lucru la care te uiți. Lecția e valabilă pentru orice site: nu citi lista URL cu URL. Grupate pe limbi, 14 URL-uri au devenit o singură întrebare.
Cifrele acoperă cele 1.000 de URL-uri pe care le monitorizează SEOcrawl, un eșantion din tot sitemap-ul. Grupul mai mare, de 128 de URL-uri, este cealaltă stare și are propriul ghid.
De ce amână Google un crawling
Ghidul bugetului de crawling al Google explică cum decide cât accesează: o limită de capacitate pe care o suportă serverul tău și cererea pentru URL-urile tale. Majoritatea URL-urilor descoperite se reduc la una dintre aceste cinci cauze.
- Capacitatea de crawling. Google spune că limita scade când site-ul devine lent sau returnează erori de server. Un server lent înseamnă mai puține crawlinguri.
- Cerere scăzută de crawling. Cererea depinde de dimensiunea site-ului, de cât de des este actualizat și de calitatea și relevanța paginilor. Un URL cu puține linkuri interne sau fără niciunul îi dă Google puține motive să revină curând.
- Crawling irosit. URL-urile duplicate, parametrii, fațetele, lanțurile lungi de redirecționări și soft 404 concurează cu paginile tale reale. Google observă că soft 404 continuă să fie accesate și irosesc buget și că o pagină cu noindex tot este solicitată înainte de a fi abandonată.
- Găsit doar prin sitemap. Un sitemap îi spune lui Google că un URL există. Nu îl face prioritar, iar Google tratează sitemap-ul ca pe un indiciu. Paginile găsite doar acolo sunt primele care așteaptă.
- Un site sau o secțiune nouă. Orice site pornește cu aceeași limită de capacitate implicită, prudentă, care crește pe măsură ce site-ul se dovedește sănătos.
Bugetul de crawling în sine merită atenția ta doar pe site-urile foarte mari. Estimarea aproximativă a Google: 1.000.000+ de pagini unice actualizate cam săptămânal sau 10.000+ de pagini care se schimbă zilnic. Pe site-urile mai mici, cauzele 2 și 4 sunt mult mai frecvente.
Este o problemă? Trei întrebări înainte să repari ceva
- Ar trebui acest URL să fie indexat? Dacă este o vizualizare filtrată, o pagină de căutare internă sau un URL de test, e normal să lipsească. Ca să o faci explicit, aplică noindex sau returnează 404 ori 410 (vezi Excluded by 'noindex' tag).
- Câte URL-uri și cu ce tipar? Google spune că, la sub 500 de pagini, probabil nici nu ai nevoie de acest raport. Lista este și limitată la 1.000 de rânduri, deci pe un site mare este un eșantion.
- Sunt noi? Un URL publicat săptămâna trecută nu este încă o problemă. Intervalele de timp ale Google sunt în tabelul de mai jos.
Cum o rezolvi, în funcție de dimensiunea site-ului
Prima măsură corectă depinde de dimensiunea site-ului tău, așa că începe din coloana potrivită.
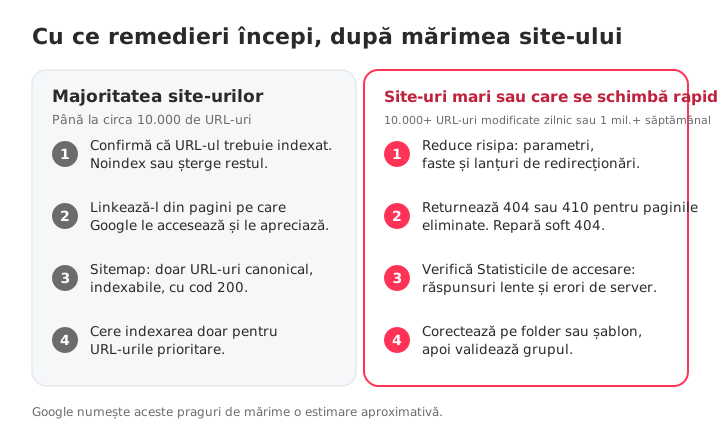
Majoritatea site-urilor: până la aprox. 10.000 de URL-uri
- Confirmă că URL-ul merită indexat. Dacă nu, aplică noindex sau șterge-l și scoate-l din listă.
- Fă linkuri de pe paginile pe care Google le accesează deja. Adaugă linkuri contextuale, cu text de ancoră descriptiv, de pe pagini indexate care primesc trafic. Orice crawler îți arată paginile orfane filtrând paginile cu zero linkuri interne, iar acest ghid despre linkuri interne conține metoda completă.
- Păstrează sitemap-ul curat. Include doar URL-uri care returnează 200, sunt indexabile și reprezintă versiunea canonical, cu un
lastmodcorect. Google ignoră priority și changefreq. Dacă ai nevoie mai întâi de fișier, găsește-ți sitemap-ul. Dacă Search Console spune că nu găsește niciunul, vezi No referring sitemaps detected. - Cere indexarea câtorva URL-uri prioritare. Deschide instrumentul de inspectare a URL-urilor și dă clic pe Solicită indexarea. Google aplică o cotă și spune că cererile repetate nu accelerează nimic, așa că păstrează-o pentru paginile care contează cel mai mult.
Site-uri mari sau care se schimbă rapid: 10.000+ URL-uri modificate pe zi sau 1 mil.+ pe săptămână
- Reduce crawlingul irosit. Blochează în robots.txt spațiile de URL fără valoare de căutare (parametri, fațete, căutare internă) și consolidează duplicatele cu canonicale și redirecționări 301. Nu te baza pe noindex pentru a economisi buget: Google continuă să solicite acele pagini.
- Returnează 404 sau 410 pentru paginile șterse și repară soft 404. Google numește 404 un semnal puternic de a nu mai accesa URL-ul, în timp ce URL-urile blocate rămân mai mult în coadă. Scurtează orice lanț lung de redirecționări.
- Verifică statisticile de crawling. La Setări, raportul Statistici despre crawling arată timpii de răspuns și erorile de server. Dacă sunt mari, Google îți reduce limita de capacitate, iar nicio reparație de conținut nu ajută până nu se îmbunătățește serverul.
- Repară pe folder sau șablon, apoi validează grupul. Ia o singură decizie pe tipar, creează un sitemap doar cu URL-urile reparate și dă clic pe Validează remedierea. Citește mai mult despre bugetul de crawling dacă site-ul tău se încadrează aici.
Aștepți sau acționezi?
Partea cea mai grea nu este remedierea, ci să știi când să nu mai aștepți. Folosește intervalele Google și propria ta tendință.
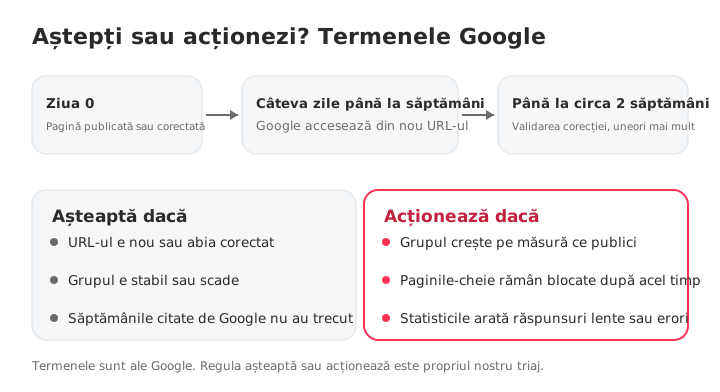
| Ce ai făcut | Ce spune Google | Sursa |
|---|---|---|
| Ai cerut Google să acceseze din nou | De la câteva zile la câteva săptămâni | Cere Google să acceseze din nou |
| Ai solicitat indexarea | De obicei cam o zi, până la una-două săptămâni, cu cotă zilnică | Ajutor pentru inspectarea URL-urilor |
| Ai validat remedierea | Până la aprox. două săptămâni, uneori mult mai mult | Ajutor pentru indexarea paginilor |
Intervalele de timp sunt ale Google. Regula de a aștepta sau a acționa este a noastră: așteaptă cât timp URL-ul e nou și grupul e stabil sau scade și acționează când grupul continuă să crească sau paginile-cheie rămân blocate după acele săptămâni.
Cum o monitorizezi în timp
Search Console arată cea mai recentă stare a fiecărui URL și o listă limitată la 1.000 de rânduri, așa că construiește-ți propria rutină:
- Exportă lista o dată pe lună și compar-o cu cea anterioară. Grupul crește, e stabil sau scade?
- Grupează pe tipar (limbă, folder, șablon) înainte să te uiți la URL-uri izolate.
- Vezi cum a găsit Google fiecare URL. O listă în care scrie peste tot «sitemap» și nicăieri «pagină de trimitere», ca în cele 14 URL-uri ale noastre, arată direct spre linkurile interne.
Vizualizarea Indexare din SEOcrawl AI îți dă lista gata făcută: filtrează după starea de acoperire ca să vezi URL-urile din ea, cu data ultimului crawling, clicuri și afișări. Prin MCP, fiecare URL vine și cu canonicalul ales de Google față de cel declarat și cu informația dacă a fost găsit prin sitemap sau printr-o pagină de trimitere. Crawler-ul auditează paginile tale, deci vezi ce e slab la un URL înainte să-i ceri Google să se mai uite o dată, iar SEO Monitor te avertizează când o pagină-cheie primește noindex, își schimbă canonicalul, returnează 404 sau dispare din sitemap.
Iată lista aceea pentru propriul nostru site, direct din vizualizarea Indexare:
Poți și să sari peste panou. Cu MCP-ul SEOcrawl AI conectat la Claude sau ChatGPT, întreabă: «Arată-mi URL-urile din Descoperită, momentan neindexată și grupează-le pe folder.» Aici ai pașii pentru a conecta Search Console la Claude și ChatGPT.
Întrebări frecvente
Ce înseamnă «Descoperită, momentan neindexată»?
Înseamnă că Google ți-a găsit URL-ul, dar nu l-a accesat încă cu crawlerul. De obicei, Google a vrut să facă crawling și l-a amânat, de aceea data ultimului crawling este goală (ajutor pentru indexarea paginilor). Google nu a citit pagina, deci starea nu spune nimic despre calitatea ei. Nu este o penalizare.
Cât durează «Descoperită, momentan neindexată»?
Google nu publică un termen pentru această stare. Spune că o nouă accesare solicitată durează de la câteva zile la câteva săptămâni, iar validarea unei remedieri până la aprox. două săptămâni, uneori mult mai mult. Un URL nou poate avea pur și simplu nevoie de acele săptămâni. Dacă grupul continuă să crească pe măsură ce publici, nu mai aștepta și acționează.
Rezolvă solicitarea indexării problema?
Poate ajuta la câteva URL-uri prioritare, pentru că îi cere lui Google să pună pagina la coadă. Nu elimină cauza, deci pagina poate reveni la aceeași stare. Cererile sunt supuse unei cote zilnice, iar Google spune că trimiterea repetată a aceluiași URL nu accelerează nimic. Folosește-o după ce îmbunătățești linkurile interne, niciodată ca instrument în masă.
Este o penalizare?
Nu. Acțiunile manuale apar într-un raport separat. Această stare înseamnă că Google a găsit URL-ul și nu l-a accesat încă, deci pagina nu a fost evaluată. Cauza este de obicei prioritatea de crawling: linkuri interne slabe, un server lent sau o grămadă de URL-uri de valoare mică ce concurează pentru crawlinguri.
De ce sunt atât de multe pagini descoperite, dar neindexate?
Un număr mare indică de obicei un tipar, nu pagini izolate: parametri de URL sau fațete, duplicate, un sitemap cu URL-uri care nu-și au locul acolo, linkuri interne slabe către o secțiune întreagă sau un server care încetinește Googlebot. Grupează URL-urile pe folder, limbă sau șablon înainte să te uiți la vreunul în parte.
Trebuie să-mi fac griji pe un site mic?
De obicei nu. Google spune că, dacă site-ul tău are sub 500 de pagini, probabil nici nu ai nevoie de raportul Indexarea paginilor. Câteva URL-uri noi în această stare au de cele mai multe ori nevoie de timp și de câteva linkuri interne de pe pagini pe care Google le accesează deja.
Cum poate ajuta SEOcrawl AI cu URL-urile descoperite?
Vizualizarea Indexare din SEOcrawl AI listează URL-urile blocate în fiecare stare de acoperire a Google, cu data ultimului crawling, clicuri și afișări. Prin MCP-ul SEOcrawl AI poți cere și lui Claude sau ChatGPT această listă cu canonicalul Google față de cel declarat și informația dacă Google a găsit fiecare URL prin sitemap sau printr-o pagină de trimitere, grupată pe folder.
Mai mult SEOcrawl AI în Google
Alege-ne ca sursă preferată și vei vedea mai multe articole de-ale noastre în Știrile principale Google.
Autor: David Kaufmann
Am petrecut ultimii peste 10 ani complet obsedat de SEO — și, sincer, nu mi-aș dori să fie altfel.
Cariera mea a atins un nou nivel când am lucrat ca specialist SEO senior pentru Chess.com — unul dintre primele 100 de cele mai vizitate site-uri din întregul internet. Să lucrez la o asemenea scară, pe milioane de pagini, în zeci de limbi și în unul dintre cele mai competitive SERP-uri care există, m-a învățat lucruri pe care niciun curs sau certificare nu ar fi putut vreodată să mi le predea. Acea experiență mi-a schimbat perspectiva asupra a ceea ce înseamnă cu adevărat un SEO de excepție — și a devenit fundația pentru tot ceea ce am construit de atunci.
Din acea experiență am fondat SEO Alive — o agenție pentru brandurile care iau în serios creșterea organică. Nu suntem aici ca să vindem dashboard-uri și rapoarte lunare. Suntem aici ca să construim strategii care chiar fac diferența, combinând ce e mai bun din SEO-ul clasic cu noua și captivanta lume a Generative Engine Optimization (GEO) — asigurându-ne că brandul tău apare nu doar în linkurile albastre din Google, ci și în răspunsurile generate de AI pe care ChatGPT, Perplexity și Google AI Overviews le livrează zilnic la milioane de oameni.
Și pentru că nu am reușit să găsesc un instrument care să acopere corect ambele lumi, mi-am construit unul singur — SEOcrawl AI, o platformă enterprise de SEO intelligence care reunește într-un singur loc pozițiile în clasamente, auditurile tehnice, monitorizarea backlinkurilor, sănătatea crawl-ului și urmărirea vizibilității brandului în AI. Este platforma pe care mi-am dorit dintotdeauna să existe.
Descoperă mai mult conținut de la acest autor
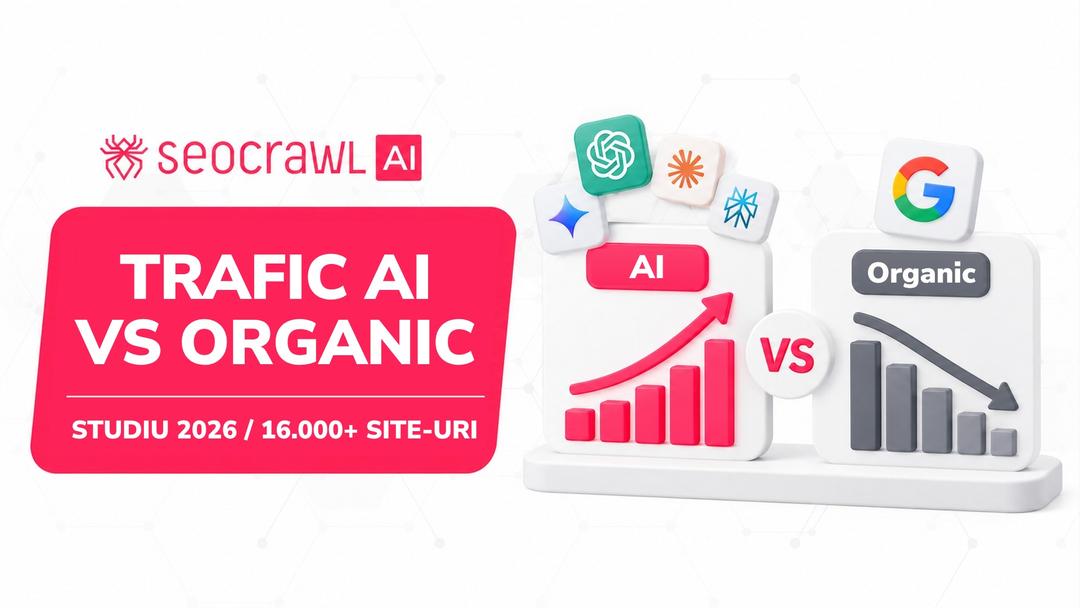
Am măsurat clicurile din Google și traficul trimis de asistenții AI pe peste 16.000 de site-uri din 15 industrii. Traficul din AI crește cu 45% pe an, dar încă înseamnă circa 1 vizită la fiecare 100 din Google, în timp ce clicurile din Google au scăzut cu 15%.

Până pe 30 noiembrie, primul an al oricărui plan anual SEOcrawl AI costă jumătate cu codul BLACKFRIDAY2026. Ce primești, ce acoperă prompturile fiecărui plan și cum vezi în 15 minute unde te menționează ChatGPT, Gemini, Claude și Perplexity.