Excluded by 'noindex' tag: ce înseamnă și cum îl rezolvi
Ai deschis Google Search Console, ai observat un grup de URL-uri marcate „Excluded by 'noindex' tag”, iar acum acele pagini sunt invizibile în căutare.
Dacă ai găsit în Google Search Console un grup de URL-uri etichetate „Excluded by 'noindex' tag”, paginile tale sunt ținute în mod deliberat în afara indexului Google, iar soluția este de obicei mai simplă decât pare: găsește directiva, elimin-o și cere-i lui Google să acceseze din nou pagina.
Acest ghid explică exact ce declanșează acest status, cum identifici directiva noindex care îl provoacă și pașii preciși pentru a o elimina în fiecare CMS important, ca paginile tale să se poată clasa din nou. Aceeași verificare rulează automat în Crawler-ul SEOcrawl AI, care semnalează directivele noindex pe tot site-ul, fără verificări URL cu URL.
Ce înseamnă „Excluded by 'noindex' tag” în Google Search Console?
Statusul „Excluded by 'noindex' tag” înseamnă că Googlebot a accesat pagina ta, a găsit o directivă noindex și a respectat-o, ținând pagina în afara indexului Google. Pagina nu va apărea în rezultatele căutării cât timp directiva rămâne acolo.
Unde apare acest status în GSC
În vechiul raport Coverage (înlocuit în 2022 de raportul Page indexing), acest status apărea la „Excluded”. În actualul raport Page indexing (Indexing › Pages), îl găsești la „Not indexed”, în tabelul „Why pages aren't indexed”, cu motivul „Excluded by 'noindex' tag”. Google grupează toate URL-urile afectate sub această etichetă, ca să le poți exporta și analiza în bloc.
Cum descoperă și respectă Google directiva noindex
Documentația Google despre blocarea indexării cu noindex descrie două metode de transmitere: o etichetă <meta name="robots" content="noindex"> în secțiunea HTML <head> a paginii sau o directivă X-Robots-Tag: noindex în antetele de răspuns HTTP. Când Googlebot întâlnește oricare dintre ele, elimină complet pagina din index, chiar dacă pagina fusese indexată anterior. Pentru noțiunile de bază despre eticheta în sine, vezi ghidul nostru despre eticheta meta noindex.
Este întotdeauna o problemă? Când excluderea este intenționată
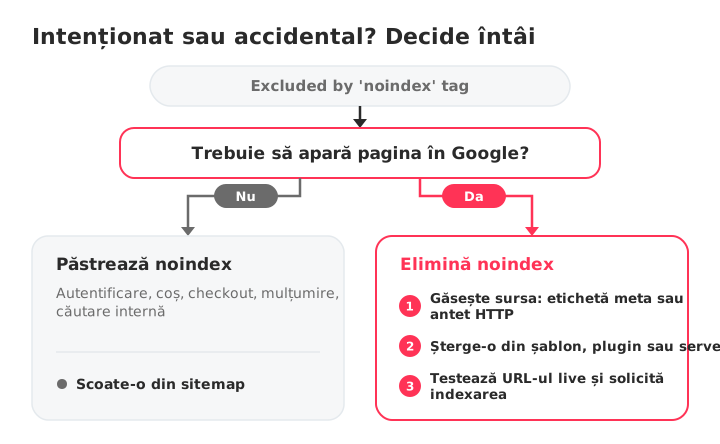
Nu orice URL cu „Excluded by 'noindex' tag” este o eroare. Paginile de administrare, ecranele de autentificare, coșul și fluxul de finalizare a comenzii, paginile de mulțumire și rezultatele căutării interne sunt ținute intenționat în afara indexului Google. Dacă acele pagini au acest status, sistemul funcționează așa cum a fost gândit. Problema reală începe când eticheta apare pe pagini pe care vrei să le clasezi.
Cauze frecvente ale statusului „Excluded by 'noindex' tag”
O directivă noindex poate ajunge pe pagina ta pe mai multe căi diferite. Soluția depinde de cea care este activă pe site-ul tău.
Eticheta meta robots cu „noindex” în <head>
Cea mai frecventă sursă. O linie precum <meta name="robots" content="noindex"> în HTML-ul paginii îi spune lui Googlebot să n-o indexeze. Poate fi scrisă direct în șablon sau injectată dinamic de un CMS, un plugin sau o funcție a temei.
X-Robots-Tag în antetele de răspuns HTTP
X-Robots-Tag funcționează exact ca eticheta meta, dar se află în antetul de răspuns HTTP, nu în HTML. Îl pot adăuga configurațiile serverului, regulile CDN sau directivele din .htaccess. De exemplu:
Header set X-Robots-Tag "noindex"
Acest lucru afectează fiecare fișier care corespunde regulii, inclusiv PDF-urile și imaginile care nu au o secțiune HTML <head>. Mulți proprietari de site-uri ignoră complet această cale, pentru că directiva nu este vizibilă în codul sursă al paginii.
Setări din CMS care blochează accidental indexarea
WordPress are o casetă de bifat la Setări › Citire numită „Discourage search engines from indexing this site”. Când este bifată, WordPress adaugă o etichetă robots noindex pe fiecare pagină a site-ului. Mulți o activează în timpul dezvoltării și uită s-o debifeze după lansare.
Shopify poate aplica noindex prin codul temei sau prin aplicații. Unele pagini de cont și de sistem sunt ținute în afara indexului chiar de Shopify, ceea ce este corect, dar o modificare a temei sau o aplicație SEO poate adăuga din greșeală noindex pe paginile de produs, colecție sau blog.
Wix aplică noindex oricărei pagini ale cărei setări SEO împiedică motoarele de căutare s-o indexeze. O cauză frecventă este duplicarea unei pagini, care moștenește setarea noindex a originalului fără să-ți dai seama.
Conflicte de pluginuri sau teme care adaugă noindex
Pluginurile SEO îți permit să setezi noindex pe articol, pagină sau tip de conținut. O regulă globală configurată greșit, o actualizare de plugin care resetează setările sau o temă care suprascrie directivele pluginului pot împinge noindex pe zeci de pagini deodată. Dacă ai actualizat recent un plugin sau ai schimbat tema, verifică mai întâi asta.
Setări din mediul de staging ajunse în producție
O sursă surprinzător de frecventă de etichete noindex accidentale. Site-ul tău de staging folosește noindex ca să rămână în afara Google. Când pipeline-ul de build duce configurația de staging în producție, directiva noindex merge odată cu ea. De obicei, asta afectează secțiuni întregi ale site-ului deodată și este una dintre cele mai greu de diagnosticat cauze dacă verifici doar pagini individuale.
Cum afli ce pagini sunt afectate
Un flux de diagnosticare repetabil găsește toate URL-urile afectate fără ghicit. Începe cu Search Console pentru listă, apoi coboară la nivel de pagină ca să găsești sursa.
Folosește raportul Page indexing pentru a exporta URL-urile afectate
Deschide Google Search Console și mergi la Indexing › Pages. Dă clic pe „Excluded by 'noindex' tag” în tabelul „Why pages aren't indexed”. Search Console îți arată un eșantion de URL-uri afectate; folosește butonul Export ca să descarci lista pentru procesare.
Inspectează un singur URL cu instrumentul URL Inspection
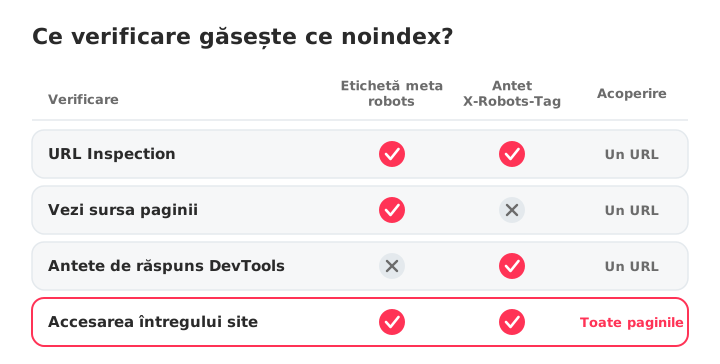
Lipește orice URL în bara de căutare din partea de sus a Search Console. Instrumentul URL Inspection arată dacă Google a văzut o directivă noindex și unde a găsit-o: la „Indexing allowed?” îți spune dacă noindex a venit din eticheta meta robots sau din antetul HTTP X-Robots-Tag. Dă clic pe View crawled page ca să vezi exact HTML-ul primit de Googlebot. Este cea mai rapidă verificare pentru o singură pagină.
Verifică în codul sursă al paginii etichetele meta noindex
Deschide pagina în browser, dă clic dreapta și alege Vezi sursa paginii, apoi caută „noindex” (Ctrl+F sau Cmd+F). Dacă găsești <meta name="robots" content="noindex"> sau ceva asemănător, eticheta meta este vinovata. Dacă nu o găsești în sursă, directiva poate veni în schimb din antetul HTTP.
Folosește DevTools din browser pentru a verifica antetele HTTP
Deschide DevTools (F12 sau clic dreapta › Inspectează), mergi la fila Network, reîncarcă pagina și dă clic pe cererea documentului principal. Caută în secțiunea Response Headers X-Robots-Tag: noindex. Este singura modalitate direct din browser de a prinde directivele noindex din antete, care nu apar în HTML.
Accesează tot site-ul cu Screaming Frog sau SEOcrawl AI
Pentru diagnosticarea întregului site, un crawler găsește toate paginile afectate dintr-o singură trecere. Screaming Frog SEO Spider poate filtra paginile după indexabilitate, ținând cont de etichetele meta și de antete. Crawler-ul SEOcrawl AI accesează fiecare pagină, o semnalează pe fiecare care are o directivă noindex la Indexability și îți oferă un Audit Health Score, așa că vezi amploarea completă fără să exporți și să filtrezi manual.
Cum rezolvi „Excluded by 'noindex' tag”: pas cu pas
Aceasta este secțiunea cea mai practică. Aplică soluția care corespunde diagnosticului din secțiunea anterioară.
Eliminarea etichetei meta noindex din codul sursă
Editează șablonul sau conținutul paginii ca să elimini <meta name="robots" content="noindex"> din secțiunea HTML <head>. Pe site-urile construite la comandă, verifică direct fișierele de șablon. Dacă eticheta este injectată prin JavaScript, găsește scriptul responsabil și elimină-l sau pune-l sub o condiție.
Înainte:
<meta name="robots" content="noindex">
După:
<meta name="robots" content="index, follow">
Sau pur și simplu elimină eticheta complet. Google tratează absența unei directive noindex ca „indexare permisă”.
Corectarea X-Robots-Tag în configurația serverului sau a CDN-ului
Verifică fișierul .htaccess (Apache), nginx.conf (Nginx) sau regulile CDN pentru eventuale directive X-Robots-Tag: noindex. Elimină-le sau limitează-le la căile specifice care trebuie excluse, nu la paginile pe care vrei să le indexezi. De exemplu, poți păstra noindex pe /staging/ și îl poți elimina de pe /blog/.
Cum rezolvi în WordPress
Două verificări, în această ordine:
- Setarea pentru tot site-ul: mergi la Setări › Citire și debifează „Discourage search engines from indexing this site”. Este cea mai frecventă cauză a problemelor noindex la nivelul întregului site în WordPress.
- Setările pe pagină din pluginurile SEO:
- Yoast SEO: deschide articolul sau pagina, derulează până la caseta Yoast, dă clic pe fila Advanced și setează „Allow search engines to show this content in search results?” la „Yes”.
- Rank Math: deschide articolul, mergi la caseta Rank Math, dă clic pe fila Advanced și setează „Robots Meta” la „Index”.
- All in One SEO: editează articolul, deschide fila Advanced din setările AIOSEO și asigură-te că „No Index” nu este bifat în setările robots.
Verifică și setările globale ale fiecărui plugin pentru tipuri întregi de conținut (etichete, categorii, tipuri de articole personalizate) setate pe noindex. Pentru restul configurării WordPress, vezi ghidul nostru despre conectarea WordPress la Google Search Console.
Cum rezolvi în Shopify
În Shopify, noindex vine de obicei din codul temei sau dintr-o aplicație. Deschide Online Store › Themes › Edit code și caută în theme.liquid și în șabloanele de pagină o etichetă meta robots cu noindex. Apoi verifică aplicațiile SEO pentru reguli care ascund produse, colecții sau articole de blog, precum și orice produs sau pagină care folosește metacâmpul seo.hidden. Paginile de cont și celelalte pagini de sistem sunt ținute în afara indexului de Shopify și ar trebui să rămână așa.
Cum rezolvi în Wix, Squarespace și alți constructori de site-uri
Wix: deschide setările SEO ale paginii (din meniul paginii) și activează „Let search engines index this page”. Dacă ai duplicat o pagină, copia poate să fi moștenit setarea noindex de la original.
Squarespace: verifică setările SEO ale întregului site pentru orice opțiune care ascunde site-ul de motoarele de căutare. Pentru pagini individuale, deschide setările paginii și caută „Hide page from search results” în fila SEO. Squarespace ține, de asemenea, implicit unele pagini de sistem, cum ar fi coșul, în afara rezultatelor căutării.
După corectare: solicitarea reindexării în Google Search Console
Eliminarea etichetei noindex îi spune lui Google că poate indexa pagina, dar tot ai nevoie ca Googlebot s-o acceseze din nou ca să confirme schimbarea.
Folosirea instrumentului URL Inspection pentru a solicita indexarea
Lipește URL-ul corectat în bara de căutare din Search Console. Dă clic pe Test live URL ca să confirmi că indexarea este acum permisă, apoi dă clic pe Request indexing. Google va pune URL-ul în coada de reaccesare. Poți trimite astfel mai multe URL-uri, dar Search Console limitează câte poți solicita pe zi.
Cât durează până când Google reindexează o pagină?
De obicei de la câteva zile la câteva săptămâni, în funcție de cât de des accesează Googlebot site-ul tău. Site-urile cu trafic mare și actualizate frecvent sunt reaccesate mai repede; site-urile noi sau cu trafic redus pot aștepta săptămâni. Solicitarea indexării este cel mai rapid semnal pe care îl poți trimite, dar nu este o garanție: îți pune URL-ul în coada de accesare, nu forțează o reaccesare imediată.
Trimiterea unui sitemap XML actualizat pentru a grăbi accesarea
Dacă ai corectat multe pagini deodată, trimite un sitemap XML actualizat în secțiunea Sitemaps din Search Console. Asta semnalează că site-ul tău s-a schimbat și încurajează o reaccesare mai amplă. Un sitemap curat, fără URL-uri cu noindex, evită și semnalele contradictorii, despre care vorbim mai jos.
Când ar trebui să păstrezi eticheta noindex (excluderi intenționate)
Nu orice etichetă noindex trebuie eliminată. Unele pagini nu ar trebui să apară niciodată în rezultatele căutării, iar indexarea lor adaugă pagini slabe sau duplicate în imaginea pe care o are Google despre site-ul tău și irosește atenția crawlerului.
Pagini care nu ar trebui indexate niciodată
- Paginile de autentificare și de înregistrare
- Paginile de coș, de finalizare a comenzii și de confirmare a comenzii
- Paginile cu rezultatele căutării interne (pentru a evita conținutul duplicat)
- Paginile de mulțumire (lead magnets, trimiteri de formulare)
- Paginile de administrare și de backend
- Mediile de staging și de dezvoltare
- Paginile de filtre și parametri care generează URL-uri duplicate
noindex vs. robots.txt: diferențele esențiale
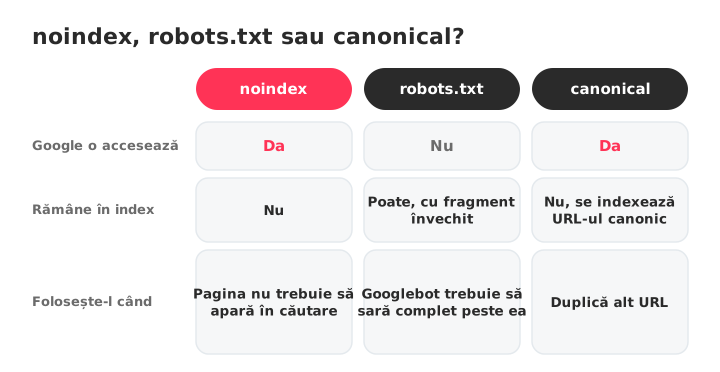
robots.txt blochează accesarea. noindex permite accesarea, dar blochează indexarea. Dacă blochezi o pagină în robots.txt, Googlebot n-o citește niciodată, ceea ce înseamnă că nu vede niciodată nici eticheta noindex. Dacă vrei ca o pagină să iasă din index, folosește noindex. Dacă vrei ca Googlebot să sară complet peste pagină (ca să economisești bugetul de accesare), folosește robots.txt.
O greșeală frecventă: folosirea robots.txt pentru a bloca o pagină care este deja indexată. Google nu poate vedea eticheta noindex dacă nu poate accesa pagina, așa că URL-ul poate rămâne în index cu un titlu și un fragment învechite. Abordarea corectă este să permiți accesarea și să folosești noindex ca să scoți pagina din index.
Etichete canonical vs. noindex: alegerea directivei potrivite
O etichetă canonical (rel="canonical") îi spune lui Google „această pagină este o copie a celuilalt URL, clasează-l pe acela”. O etichetă noindex îi spune lui Google „nu indexa deloc această pagină”. Au scopuri diferite:
- Folosește canonical când ai conținut duplicat sau aproape duplicat și vrei să consolidezi semnalele de clasare pe un singur URL.
- Folosește noindex când pagina nu trebuie să apară în rezultatele căutării în nicio situație.
Combinarea ambelor pe aceeași pagină transmite semnale contradictorii: una spune „unește această pagină cu alt URL”, cealaltă spune „renunță la ea”. Alege-o pe cea care corespunde scopului tău.
Cum previi pe viitor etichetele noindex accidentale
Corectarea problemelor noindex după ce apar este necesară, dar prevenirea lor îți economisește ore de diagnosticare și trafic pierdut.
Configurarea alertelor Search Console pentru scăderi ale indexării
Google Search Console trimite e-mailuri proprietarilor și utilizatorilor verificați când detectează probleme noi de indexare pe o proprietate. Asigură-te că notificările prin e-mail sunt activate în preferințele de e-mail din Search Console. Dacă numărul de pagini indexate scade brusc, alerta îți oferă un avans înainte să scadă și traficul.
Adăugarea verificărilor noindex în checklistul QA dinainte de lansare
Înainte de a lansa orice site sau de a duce staging-ul în producție, verifică existența directivelor noindex. O verificare de 30 de secunde cu „Vezi sursa paginii” și o căutare după „noindex” prinde cea mai frecventă greșeală de lansare. Pentru site-urile mai mari, accesează site-ul înainte și după lansare și compară numărul de pagini cu noindex. Adaugă verificarea în checklistul tău de SEO tehnic, ca nimeni să n-o sară.
Accesări programate pentru a prinde directivele noindex nedorite
Rulează o accesare completă după un program și după fiecare actualizare de plugin, schimbare de temă sau migrare, ca să prinzi etichetele noindex nedorite înainte să te coste trafic. Crawler-ul SEOcrawl AI îți permite să compari accesările, așa că vezi ce pagini au primit noindex și când, iar SEO Monitor te alertează în momentul în care una dintre paginile tale importante primește o etichetă noindex.
Întrebări frecvente
Ce înseamnă „Excluded by 'noindex' tag” în Google Search Console?
Înseamnă că Google a găsit și a respectat o directivă noindex pe pagina ta, așa că pagina nu va apărea în rezultatele căutării. Statusul apare în raportul Page indexing din Search Console, la „Not indexed”.
Nu este întotdeauna o eroare: paginile pe care le excluzi intenționat, cum ar fi paginile de autentificare sau de finalizare a comenzii, ar trebui să aibă acest status.
Cum rezolv „Excluded by 'noindex' tag” în WordPress?
Verifică două locuri, în această ordine. Mai întâi, mergi la Setări › Citire și asigură-te că opțiunea „Discourage search engines from indexing this site” nu este bifată. Apoi, deschide fiecare articol sau pagină afectată în pluginul tău SEO (Yoast, Rank Math, All in One SEO) și confirmă că setarea robots a paginii permite indexarea.
Cât durează până când Google indexează o pagină după eliminarea noindex?
De obicei de la câteva zile la câteva săptămâni, în funcție de cât de des accesează Googlebot site-ul tău. După ce elimini directiva, solicită indexarea cu instrumentul URL Inspection și trimite un sitemap XML actualizat ca să grăbești procesul. Site-urile cu trafic mare sunt reaccesate mai repede decât cele noi sau cu trafic redus.
Poate fi o pagină exclusă prin noindex chiar dacă este în sitemap-ul meu?
Da. Directiva noindex are prioritate față de includerea în sitemap. Google poate accesa în continuare URL-ul din sitemap, dar nu îl va indexa cât timp noindex este prezent.
Fie elimini noindex ca pagina să poată fi indexată, fie scoți URL-ul din sitemap dacă excluderea este intenționată. URL-urile cu noindex dintr-un sitemap transmit semnale contradictorii.
Care este diferența dintre noindex și blocarea unei pagini în robots.txt?
robots.txt îl împiedică pe Googlebot să acceseze pagina; noindex permite accesarea, dar împiedică indexarea. Dacă blochezi o pagină cu robots.txt, Google nu poate citi eticheta noindex, așa că o pagină deja indexată poate rămâne în index cu conținut învechit. Folosește noindex ca să scoți o pagină din index și robots.txt doar când vrei să împiedici complet accesarea.
Cum verific dacă o pagină are o etichetă noindex?
Trei metode, de la cea mai rapidă la cea mai amănunțită: folosește instrumentul URL Inspection din Search Console, vezi codul sursă al paginii și caută „noindex” (Ctrl+F) sau verifică antetele de răspuns HTTP în DevTools din browser (fila Network, caută X-Robots-Tag). Doar URL Inspection și DevTools detectează un noindex trimis în antet.
Ar trebui să mă îngrijorez dacă multe pagini au statusul „Excluded by 'noindex' tag”?
Doar dacă acele pagini ar trebui să fie indexate. Exportă lista din Search Console, compar-o cu excluderile tale intenționate (autentificare, coș, administrare, pagini de mulțumire) și rezolvă doar paginile care ar trebui să se claseze în căutare. Dacă toate paginile afectate sunt excluse de tine în mod deliberat, statusul funcționează corect.
Autor: David Kaufmann

Am petrecut ultimii peste 10 ani complet obsedat de SEO — și, sincer, nu mi-aș dori să fie altfel.
Cariera mea a atins un nou nivel când am lucrat ca specialist SEO senior pentru Chess.com — unul dintre primele 100 de cele mai vizitate site-uri din întregul internet. Să lucrez la o asemenea scară, pe milioane de pagini, în zeci de limbi și în unul dintre cele mai competitive SERP-uri care există, m-a învățat lucruri pe care niciun curs sau certificare nu ar fi putut vreodată să mi le predea. Acea experiență mi-a schimbat perspectiva asupra a ceea ce înseamnă cu adevărat un SEO de excepție — și a devenit fundația pentru tot ceea ce am construit de atunci.
Din acea experiență am fondat SEO Alive — o agenție pentru brandurile care iau în serios creșterea organică. Nu suntem aici ca să vindem dashboard-uri și rapoarte lunare. Suntem aici ca să construim strategii care chiar fac diferența, combinând ce e mai bun din SEO-ul clasic cu noua și captivanta lume a Generative Engine Optimization (GEO) — asigurându-ne că brandul tău apare nu doar în linkurile albastre din Google, ci și în răspunsurile generate de AI pe care ChatGPT, Perplexity și Google AI Overviews le livrează zilnic la milioane de oameni.
Și pentru că nu am reușit să găsesc un instrument care să acopere corect ambele lumi, mi-am construit unul singur — SEOcrawl AI, o platformă enterprise de SEO intelligence care reunește într-un singur loc pozițiile în clasamente, auditurile tehnice, monitorizarea backlinkurilor, sănătatea crawl-ului și urmărirea vizibilității brandului în AI. Este platforma pe care mi-am dorit dintotdeauna să existe.
Descoperă mai mult conținut de la acest autor