Crawled – currently not indexed: ce înseamnă și cum rezolvi problema

Google ți-a vizitat URL-ul, l-a citit și l-a lăsat în afara căutării. Iată cum afli ce pagini merită o a doua șansă și cum spune Google să le aduci înapoi în index.
Crawled – currently not indexed (accesată, momentan neindexată) înseamnă că Googlebot ți-a preluat pagina și a decis să n-o adauge în indexul Google, așa că nu poate apărea în căutare. Ajutorul pentru raportul Page indexing o spune așa: pagina a fost accesată, dar nu a fost indexată, și „poate fi sau nu indexată în viitor”.
Cauza este de obicei pagina însăși, nu o blocare tehnică. Mai jos vei vedea cum decizi, URL cu URL, dacă o pagină trebuie corectată, pusă pe noindex sau ștearsă și cât durează o corectare, potrivit Google. Ești nou în acest raport? Începe cu acest ghid Google Search Console.
Ce înseamnă „Crawled – currently not indexed”?
Statusul înseamnă că Google a accesat pagina și a ales să n-o indexeze. Nimic nu l-a blocat pe Googlebot: Google a decis să lase pagina deoparte deocamdată. Două distincții te ajută să citești corect statusul.
Accesată vs. indexată
Crawling-ul înseamnă că Googlebot descarcă o pagină. Indexarea înseamnă că Google o stochează ca să poată apărea în căutări. O pagină poate fi accesată de multe ori și totuși să nu fie indexată niciodată.
Ajutorul pentru instrumentul URL Inspection spune că o pagină trebuie să aibă o calitate „suficient de ridicată pentru a justifica indexarea”, iar testul live nu poate verifica deloc acest status.
Prin ce diferă de „Discovered – currently not indexed”
Discovered – currently not indexed (descoperită, momentan neindexată) vine cu un pas mai devreme: Google a găsit URL-ul, dar a amânat accesarea ca să nu-ți suprasolicite site-ul, așa că data ultimei accesări este goală.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Accesată de Google? | Nu | Da |
| Data ultimei accesări | Goală | O dată |
| Motivul obișnuit | Accesare amânată ca să nu suprasolicite site-ul | Google a citit pagina și a sărit-o |
| Verifică întâi | Capacitatea de accesare, pe site-urile foarte mari | Calitatea conținutului, duplicatele, canonicals |
Google mai spune: „Faptul că o pagină nu este indexată nu e neapărat rău.” Paginile cu noindex, URL-urile blocate în robots.txt, duplicatele și 404-urile fără înlocuitor trebuie să rămână în afară.
De ce accesează Google pagini fără să le indexeze
Indexarea are o ștachetă de calitate pe care crawling-ul nu o are. Ghidul Google despre bugetul de crawl spune că cererea de crawl crește odată cu valoarea și unicitatea conținutului tău.
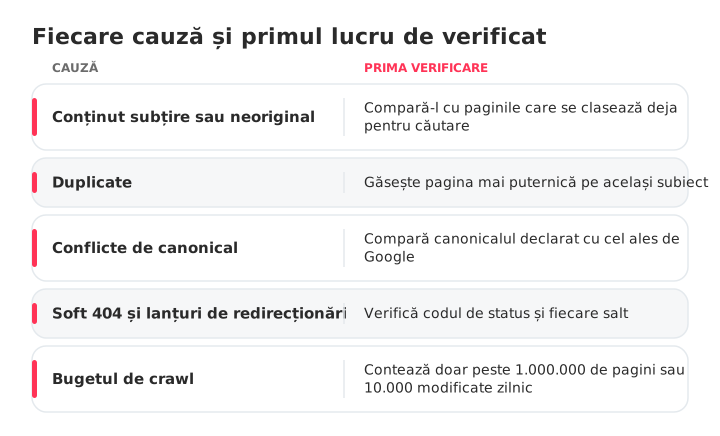
Majoritatea URL-urilor afectate intră la una dintre aceste cauze, fiecare cu prima verificare:
- Conținut subțire sau neoriginal: pagina repetă ce se clasează deja.
- Duplicate: arhive de etichete, URL-uri sortate, două articole pe același subiect. Iată cum identifici și rezolvi canibalizarea cuvintelor cheie.
- Conflicte de canonical: compară canonicalul declarat de tine cu cel selectat de Google. Când Google alege alt URL, pagina trece de obicei la Alternate page with proper canonical tag sau la un status de duplicat.
- Soft 404 și lanțuri de redirecționări: Google spune că soft 404-urile irosesc bugetul de crawl.
- Bugetul de crawl: contează pentru site-urile cu peste 1.000.000 de pagini care se schimbă săptămânal sau peste 10.000 care se schimbă zilnic. Pentru majoritatea site-urilor, nu este cauza.
Ștacheta a crescut în doi pași datați. Pe 18 august 2022, Google a anunțat actualizarea pentru conținut util, un semnal la nivelul întregului site, și a spus că eliminarea conținutului nefolositor poate ajuta restul site-ului. Pe 5 martie 2024, Google a anunțat o actualizare de bază care să afișeze mai puțin conținut creat pentru a atrage clicuri, împreună cu o nouă politică anti-spam împotriva abuzului de conținut la scară.
Recomandările Google despre conținutul util spun că E-E-A-T nu este un factor de clasare anume, că încrederea contează cel mai mult și că nu există un număr preferat de cuvinte. Umplutura nu rezolvă problema.
Cum găsești și diagnostichezi paginile afectate în GSC
Deschide raportul Page indexing (fostul Coverage), inspectează un eșantion, apoi grupează lista după tipare. Google observă că site-urile sub 500 de pagini probabil nu au nevoie de acest raport.
Găsește URL-urile afectate în raportul Pages
- În Google Search Console, mergi la Indexing › Pages.
- În „Why pages aren't indexed” (de ce nu sunt indexate paginile), dă clic pe Crawled – currently not indexed.
- Dă clic pe Export și descarcă lista.
Raportul arată până la 1.000 de URL-uri exemplu, nu neapărat pe toate, așa că pe un site mare exportul este un eșantion.
Verifică paginile cu instrumentul URL Inspection
Inspectează cinci până la zece URL-uri exportate pentru data ultimei accesări și Google-selected canonical (canonicalul selectat de Google). Un canonical care trimite în altă parte înseamnă că Google vede un duplicat; o dată de accesare veche de câteva luni sugerează că Google revine rar.
Identifică tipare în sute de URL-uri
Sortează exportul după folder, șablon și parametru de URL, apoi numără fiecare grup. Să zicem că 300 de URL-uri se împart în 180 de pagini /tag/, 70 de URL-uri ?sort= și 50 de articole: asta înseamnă trei decizii, nu 300.
Corectezi, pui noindex sau ștergi: decide ce merită fiecare URL
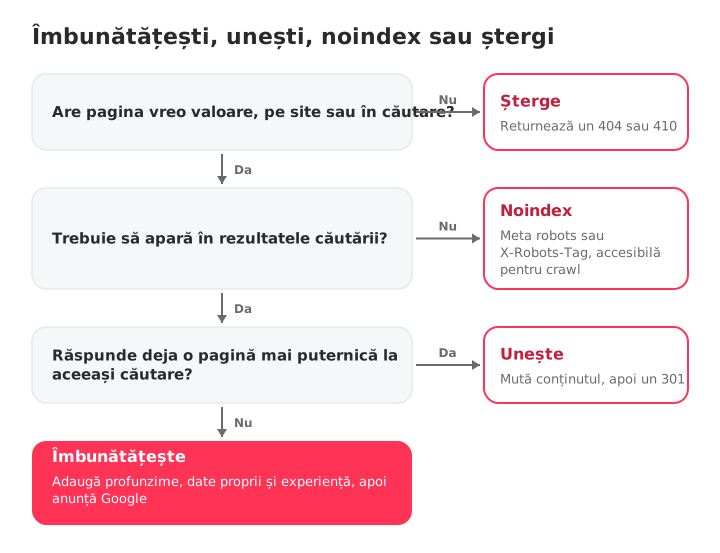
Fiecare URL merită unul dintre patru deznodăminte. Întreabă-te: s-ar bucura cineva care caută să ajungă aici și este aceasta singura pagină de pe site care răspunde la căutare?
| Tip de pagină | Exemplu | Decizie | Cum |
|---|---|---|---|
| Utilă și unică, dar subțire | Un ghid de 300 de cuvinte pe un subiect pe care îl cunoști | Îmbunătățește | Adaugă profunzime și detalii din experiență proprie |
| Duplicat al unei pagini mai puternice | Două articole pe aceeași căutare | Unește | Mută conținutul, apoi redirecționare 301 |
| Utilă pe site, nu în căutare | Arhive de etichete, căutare internă, pagini de mulțumire | Noindex | Meta tag robots sau X-Robots-Tag |
| Fără valoare, fără înlocuitor | Promoții expirate, pagini de test | Șterge | Returnează un 404 sau 410 |
Ghidul Google despre bugetul de crawl susține ultimele două rânduri: returnează 404 sau 410 pentru paginile eliminate și consolidează duplicatele. Un 404 în Search Console este normal pentru paginile eliminate intenționat.
La noindex se greșește cel mai des în triere:
Nu așa: un tag noindex pe paginile /tag/ în timp ce robots.txt blochează /tag/. Googlebot nu poate prelua paginile, deci nu vede niciodată tagul.
Ci așa: /tag/ rămâne accesibil pentru crawl și poartă noindex ca meta tag sau ca header X-Robots-Tag.
Potrivit documentației Google despre noindex, regula nu funcționează în robots.txt, iar pe paginile vizitate rar noua accesare poate dura luni. După ce tagul este citit, acele URL-uri trec la Excluded by 'noindex' tag, exact ce vrei pentru ele.
Cum repari paginile care merită indexate
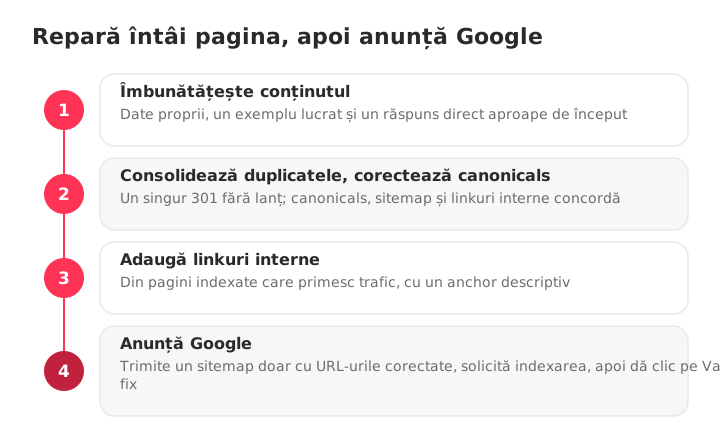
Fă întâi pagina demnă de indexare, apoi anunță Google. Să soliciți indexarea unei pagini nemodificate înseamnă să-i ceri lui Google să repete o decizie pe care a luat-o deja. Ordinea:
- Îmbunătățește conținutul.
- Consolidează duplicatele și corectează canonicals.
- Adaugă linkuri interne.
- Trimite un sitemap țintit și solicită indexarea.
Îmbunătățește profunzimea și originalitatea conținutului
Rescrie pentru căutare, nu pentru un număr de cuvinte: adaugă date proprii, capturi de ecran, un exemplu lucrat și un răspuns direct aproape de început.
De exemplu, ia un ghid subțire de 300 de cuvinte: adaugă un set de date din experiență proprie și un exemplu lucrat, pune linkuri către el din două articole care primesc deja trafic și abia apoi adaugă-l într-un sitemap țintit.
Consolidează duplicatele și corectează canonicals
Când două URL-uri acoperă același lucru, păstrează unul, mută în el conținutul util și fă o redirecționare 301 de la celălalt direct către el, fără lanț. Apoi verifică dacă canonicals, sitemap-ul și linkurile interne concordă și dacă n-a rămas vreun noindex uitat.
Adaugă linkuri interne din pagini pe care Google le apreciază deja
Pune link către fiecare pagină corectată din pagini indexate care primesc trafic, cu un anchor descriptiv. Orice crawler de site poate lista paginile orfane (zero linkuri interne) filtrând după zero linkuri primite. Metoda completă este în acest ghid de strategie de linkuri interne.
Verifică pagina și pe telefon și în raportul Core Web Vitals: o pagină mobilă defectă este rapid de exclus.
Trimite un sitemap țintit și solicită indexarea
Creează un sitemap doar cu URL-urile corectate, trimite-l și filtrează raportul Pages după el înainte să dai clic pe Validate fix. Google sugerează asta ca să accelereze validarea. Dacă ai nevoie mai întâi de fișierul actual, găsește sitemap-ul site-ului tău.
Google ignoră priority și changefreq, așa că ține mai degrabă lastmod corect. Apoi dă clic pe Request indexing în instrumentul URL Inspection pentru URL-urile prioritare: Google aplică o cotă și spune că solicitările repetate nu grăbesc nimic.
Cât durează indexarea după o corectare?
Așteaptă-te la o zi până la câteva săptămâni, iar indexarea nu este niciodată garantată. Google dă intervale diferite în pagini diferite, așa că iată-le unul lângă altul:
| Ce ai făcut | Ce spune Google | Sursă |
|---|---|---|
| I-ai cerut lui Google o nouă accesare | Câteva zile până la câteva săptămâni | Cere-i lui Google o nouă accesare |
| Request indexing | De obicei aproximativ o zi, până la una-două săptămâni, cu limită zilnică | Ajutor URL Inspection |
| Validate fix | Până la aproximativ două săptămâni, uneori mult mai mult | Ajutor Page indexing |
Acestea sunt termenele Google, nu cazuri de recuperare. Verifică raportul Pages săptămânal; dacă URL-urile corectate nu s-au mișcat după ce trec aceste intervale, întoarce-te la conținut.
Cum împiedici ca paginile noi să ajungă în acest status
Prevenția este o rutină: verifică fiecare pagină înainte să fie publicată și analizează Search Console lunar. Înainte de publicare, confirmă că pagina:
- Răspunde la o căutare la care nu răspunde nicio altă pagină de pe site.
- Aduce date, exemple sau experiență proprie.
- Are un canonical autoreferențial și niciun noindex uitat.
- Este în sitemap cu un lastmod corect.
- Are un autor cu nume și, unde se aplică, date structurate.
- Primește un link de la o pagină înrudită și indexată.
O dată pe lună, compară raportul Pages cu luna anterioară; o problemă rămâne listată 90 de zile după ce ultima ei apariție a dispărut. Site-urile cu peste o mie de pagini ar trebui să urmărească și raportul Crawl Stats (statistici de crawl).
SEOcrawl AI se ocupă de partea tehnică la scară. Crawler-ul scanează fiecare pagină și returnează un Audit Health Score, cu problemele împărțite pe Indexability, Crawlability, On-Page și altele. Vizualizarea Indexation îți grupează URL-urile după starea de acoperire din Search Console, ca să vezi câte se află în „Crawled – currently not indexed” și să urmărești numărul în timp.
Între crawl-uri, SEO Monitor te alertează când o pagină-cheie primește un noindex, își schimbă canonicalul, returnează un 404 sau iese din sitemap. Aceeași platformă urmărește vizibilitatea brandului tău în ChatGPT, Claude, Gemini, Perplexity și Copilot, ca SEO și GEO să stea împreună.
Întrebări frecvente
Ce înseamnă „Crawled – currently not indexed”?
Înseamnă că Googlebot ți-a preluat pagina și a decis să n-o adauge în indexul Google, așa că nu poate apărea în căutare. Nimic nu a blocat accesarea: Google a citit pagina și a ales s-o lase deoparte deocamdată. Nu este o acțiune manuală, iar pagina poate fi sau nu indexată în viitor.
Este același lucru cu „Discovered – currently not indexed”?
Nu. „Discovered” înseamnă că Google cunoaște URL-ul, dar a amânat accesarea, așa că data ultimei accesări este goală. „Crawled” înseamnă că Google a vizitat și a citit deja pagina, apoi a decis să n-o indexeze. La Discovered, uită-te la capacitatea de accesare pe site-urile foarte mari; la Crawled, la calitatea conținutului, la duplicate și la canonicals.
„Crawled – currently not indexed” îmi afectează SEO-ul?
Nu în sine: statusul nu este o penalizare, iar pagina afectată pierde doar propriul trafic din căutare. Riscul ține de volum, pentru că Google tratează o proporție mare de conținut nefolositor ca pe un semnal la nivelul întregului site. O arhivă de etichete în afara indexului nu costă nimic; o pagină de produs, da. Dacă numărul crește la fiecare publicare, tratează-l ca pe o problemă de conținut a site-ului, nu ca pe o listă de URL-uri izolate.
Cât durează până când o pagină este indexată după o corectare?
Așteaptă-te la orice între o zi și câteva săptămâni, iar indexarea nu este niciodată garantată. Google spune că o nouă accesare durează între câteva zile și câteva săptămâni, un Request indexing este procesat de obicei în aproximativ o zi, dar poate dura una-două săptămâni, iar un Validate fix durează de regulă până la aproximativ două săptămâni.
Ajută dacă solicit indexarea?
Doar după ce modifici pagina. Să soliciți indexarea unei pagini nemodificate înseamnă să-i ceri lui Google să repete o decizie pe care a luat-o deja. Solicitările au o cotă zilnică, iar Google spune că trimiterea aceluiași URL de mai multe ori nu grăbește nimic.
Ajută dacă adaug pagina în sitemap-ul XML?
Ajută Google să găsească un URL, nu să-l indexeze. Google numește un sitemap trimis „doar un indiciu”, iar aceste pagini au fost deja găsite și citite. După o corectare, rolul sitemap-ului este să grupeze URL-urile pe care vrei să le verifice din nou. Fiecare fișier sitemap conține cel mult 50.000 de URL-uri sau 50 MB.
De ce a eșuat validarea pentru „Crawled – currently not indexed”?
Validarea se oprește imediat ce Google găsește în grup un URL încă nerezolvat, așa că o singură pagină rămasă poate face să eșueze tot lotul. Rezolvă fiecare URL din grup sau restrânge grupul filtrând raportul cu un sitemap care conține doar URL-urile corectate, apoi validează din nou.
Cum te ajută SEOcrawl AI cu paginile pe care Google le accesează, dar nu le indexează?
SEOcrawl AI găsește cauzele de pe site din spatele statusului. Crawler-ul arată pentru fiecare URL scorul de sănătate, codul de status HTTP și adâncimea de crawl, ca să identifici paginile la care Google ajunge greu. Vizualizarea Indexation îți grupează URL-urile după starea de acoperire din Search Console, iar SEO Monitor te alertează când o pagină-cheie primește un noindex, își schimbă canonicalul, returnează un 404 sau iese din sitemap.
Autor: David Kaufmann

Am petrecut ultimii peste 10 ani complet obsedat de SEO — și, sincer, nu mi-aș dori să fie altfel.
Cariera mea a atins un nou nivel când am lucrat ca specialist SEO senior pentru Chess.com — unul dintre primele 100 de cele mai vizitate site-uri din întregul internet. Să lucrez la o asemenea scară, pe milioane de pagini, în zeci de limbi și în unul dintre cele mai competitive SERP-uri care există, m-a învățat lucruri pe care niciun curs sau certificare nu ar fi putut vreodată să mi le predea. Acea experiență mi-a schimbat perspectiva asupra a ceea ce înseamnă cu adevărat un SEO de excepție — și a devenit fundația pentru tot ceea ce am construit de atunci.
Din acea experiență am fondat SEO Alive — o agenție pentru brandurile care iau în serios creșterea organică. Nu suntem aici ca să vindem dashboard-uri și rapoarte lunare. Suntem aici ca să construim strategii care chiar fac diferența, combinând ce e mai bun din SEO-ul clasic cu noua și captivanta lume a Generative Engine Optimization (GEO) — asigurându-ne că brandul tău apare nu doar în linkurile albastre din Google, ci și în răspunsurile generate de AI pe care ChatGPT, Perplexity și Google AI Overviews le livrează zilnic la milioane de oameni.
Și pentru că nu am reușit să găsesc un instrument care să acopere corect ambele lumi, mi-am construit unul singur — SEOcrawl AI, o platformă enterprise de SEO intelligence care reunește într-un singur loc pozițiile în clasamente, auditurile tehnice, monitorizarea backlinkurilor, sănătatea crawl-ului și urmărirea vizibilității brandului în AI. Este platforma pe care mi-am dorit dintotdeauna să existe.
Descoperă mai mult conținut de la acest autor

O pagină de listare a produselor (PLP) afișează o întreagă categorie de produse dintr-odată. Află prin ce diferă de o PDP, ce o face să convertească și cum îți indexezi paginile de listare fără haosul navigării fațetate.
