


«Ontdekt – momenteel niet geïndexeerd»: wat het betekent en hoe je het oplost
Google weet dat je URL bestaat en heeft hem nog niet bezocht. Zo bepaal je of je moet wachten of ingrijpen, en welke fixes je eerst probeert op een kleine en een grote site.
Ontdekt – momenteel niet geïndexeerd betekent dat Google de URL heeft gevonden maar hem nog niet heeft gecrawld. Zo beschrijft de Help bij het rapport Paginaindexering van Google het. Meestal wilde Google crawlen en heeft het dat uitgesteld om je site niet te overbelasten, en daarom blijft de datum van de laatste crawl leeg in het rapport.
Het is een status over crawlprioriteit, geen oordeel over je content, omdat Google de pagina nog niet heeft gelezen. Hieronder zie je hoe het verschilt van «Gecrawld», wat we vonden toen we onze eigen site controleerden en een lijst fixes op volgorde van sitegrootte. Net begonnen met het rapport? Begin dan met deze gids over Google Search Console.
Wat «Ontdekt – momenteel niet geïndexeerd» betekent
Google brengt een URL door vier stappen: vinden, crawlen, indexeren en daarna eventueel tonen in de resultaten. Twee Search Console-statussen beschrijven een URL die onderweg is blijven steken.
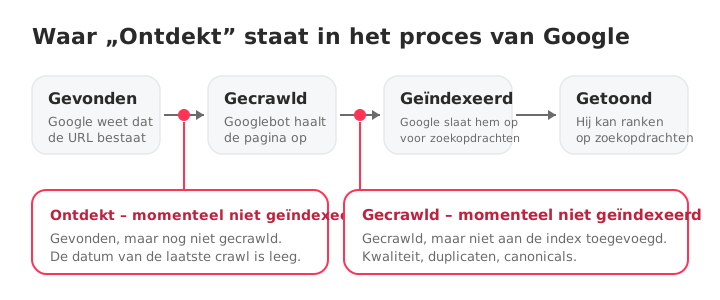
Een URL komt bij «gevonden» via je sitemap of via links op andere pagina's. Daarna beslist Google wanneer hij crawlt. «Ontdekt» betekent dat die beslissing nog niet is genomen.
Het verschil met «Gecrawld – momenteel niet geïndexeerd»
De twee statussen lijken op elkaar en vragen om verschillende fixes.
| Ontdekt – momenteel niet geïndexeerd | Gecrawld – momenteel niet geïndexeerd | |
|---|---|---|
| Door Google gecrawld? | Nee | Ja |
| Datum laatste crawl | Leeg | Een datum |
| Heeft Google de pagina gelezen? | Nee | Ja |
| Gebruikelijke reden | Crawl uitgesteld of lage prioriteit | Google las de pagina en liet hem links liggen |
| Eerst kijken naar | Interne links, sitemap, crawlcapaciteit | Kwaliteit van de inhoud, duplicaten, canonicals |
De volledige diagnose van de tweede status staat in de gids over Gecrawld – momenteel niet geïndexeerd.
Hoe de lijst eruitziet op een echte site
We hebben seocrawl.ai gecontroleerd in het Indexatie-rapport van SEOcrawl. Van de 1.000 URL's die SEOcrawl volgt (onze sitemap meldt er 6.310) zijn er 823 geïndexeerd, oftewel 82,3%. Er staan 128 in «Gecrawld – momenteel niet geïndexeerd» en 14 in «Ontdekt – momenteel niet geïndexeerd».
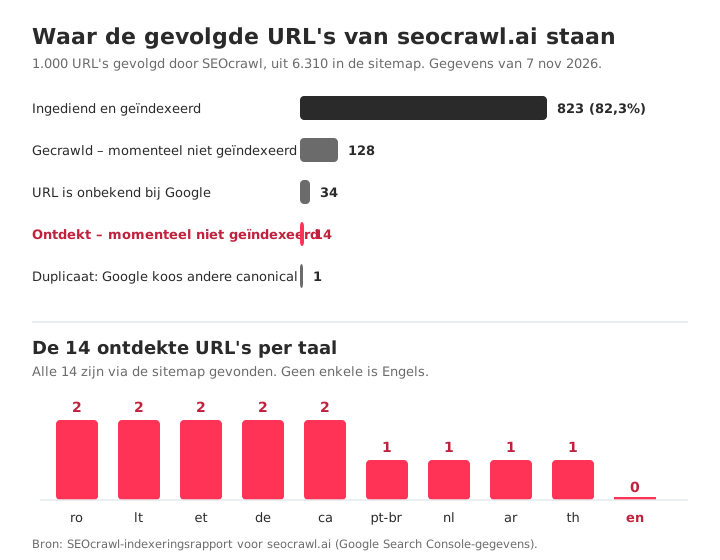
Wat de 14 gemeen hebben, is het nuttige deel:
- Allemaal zijn het vertaalde pagina's: Arabisch, Catalaans, Duits, Ests, Litouws, Nederlands, Braziliaans Portugees, Roemeens en Thai. Geen enkele is Engels.
- Google vond alle 14 via de sitemap, en niet via een link van een andere pagina.
- Eén ervan toont een eerdere crawldatum (9 mei 2026), dus de status beschrijft waar de URL nu staat, niet dat Google hem nooit heeft bezocht.
Dat is een patroon om te controleren, geen diagnose. Een pagina die in 26 talen bestaat en vooral via de sitemap wordt bereikt, is een natuurlijke kandidaat voor zwakke interne links, dus interne links zijn het eerste wat je bekijkt. De les geldt voor elke site: lees de lijst niet URL voor URL. Gegroepeerd op taal werden 14 URL's één vraag.
De cijfers gelden voor de 1.000 URL's die SEOcrawl volgt, een steekproef uit de hele sitemap. De grotere groep van 128 URL's is de andere status en heeft een eigen gids.
Waarom Google een crawl uitstelt
De crawlbudgetgids van Google legt uit hoe hij bepaalt hoeveel hij crawlt: een capaciteitslimiet die je server aankan en de vraag naar je URL's. De meeste ontdekte URL's komen uit op een van deze vijf oorzaken.
- Crawlcapaciteit. Google zegt dat de limiet daalt wanneer je site traag wordt of serverfouten geeft. Een trage server betekent minder crawls.
- Lage crawlvraag. De vraag hangt af van de omvang van de site, hoe vaak hij wordt bijgewerkt, en de kwaliteit en relevantie van de pagina's. Een URL met weinig of geen interne links geeft Google weinig reden om snel terug te komen.
- Verspild crawlen. Dubbele URL's, parameters, facetten, lange redirectketens en soft 404's concurreren met je echte pagina's. Google merkt op dat soft 404's blijven worden gecrawld en budget verspillen, en dat hij een pagina met noindex nog steeds opvraagt voordat hij hem laat vallen.
- Alleen via de sitemap gevonden. Een sitemap vertelt Google dat een URL bestaat. Het maakt hem geen prioriteit, en Google behandelt de sitemap als een hint. Pagina's die alleen daar te vinden zijn, komen als eerste in de wachtrij.
- Een nieuwe site of sectie. Elke site begint met dezelfde conservatieve standaardcapaciteit, die groeit naarmate de site zich gezond toont.
Het crawlbudget zelf verdient alleen bij zeer grote sites je aandacht. Google's ruwe schatting: 1.000.000+ unieke pagina's die ongeveer wekelijks worden bijgewerkt, of 10.000+ pagina's die dagelijks veranderen. Op kleinere sites komen oorzaak 2 en 4 veel vaker voor.
Is het een probleem? Drie vragen voordat je iets oplost
- Hoort deze URL eigenlijk geïndexeerd te worden? Als het een gefilterde weergave, een interne zoekpagina of een test-URL is, is het normaal dat hij ontbreekt. Wil je dat expliciet maken, pas dan noindex toe of geef 404 of 410 terug (zie Excluded by 'noindex' tag).
- Hoeveel URL's, en met welk patroon? Google zegt dat je bij minder dan 500 pagina's dit rapport waarschijnlijk niet eens nodig hebt. De lijst is bovendien beperkt tot 1.000 rijen, dus op een grote site is het een steekproef.
- Zijn ze nieuw? Een URL die vorige week is gepubliceerd, is nog geen probleem. De termijnen van Google zelf staan in de tabel hieronder.
Hoe je het oplost, afhankelijk van de sitegrootte
De juiste eerste stap hangt af van de omvang van je site, dus begin bij de juiste kolom.
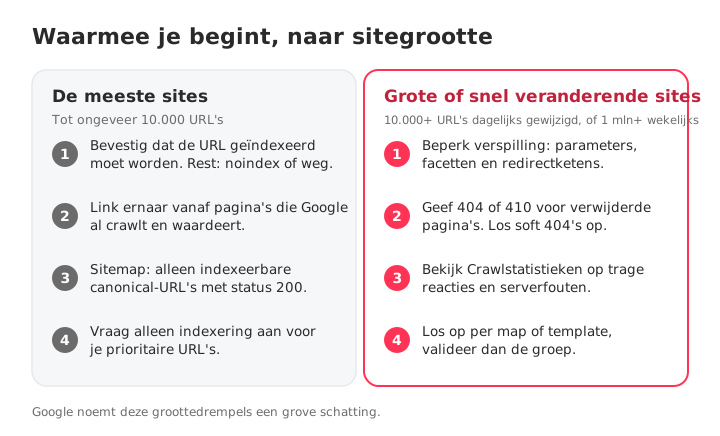
De meeste sites: tot circa 10.000 URL's
- Bevestig dat de URL indexering verdient. Zo niet, pas dan noindex toe of verwijder hem en haal hem van je lijst.
- Link vanaf pagina's die Google al crawlt. Voeg contextuele links met beschrijvende ankerteksten toe vanaf geïndexeerde pagina's die verkeer krijgen. Elke crawler toont je weespagina's door te filteren op pagina's zonder interne links, en deze gids over interne links bevat de volledige methode.
- Houd de sitemap schoon. Neem alleen URL's op die 200 teruggeven, indexeerbaar zijn en de canonical-versie vormen, met een juiste
lastmod. Google negeert priority en changefreq. Heb je het bestand eerst nodig, zoek dan je sitemap. Zegt Search Console dat er geen is gevonden, zie dan No referring sitemaps detected. - Vraag om indexering van enkele prioritaire URL's. Open de URL-inspectietool en klik op Indexering aanvragen. Google past een quotum toe en zegt dat herhaalde verzoeken niets versnellen, dus bewaar het voor de pagina's die het meest tellen.
Grote of snel veranderende sites: 10.000+ URL's gewijzigd per dag, of 1 mln+ per week
- Beperk verspild crawlen. Blokkeer in robots.txt de URL-ruimtes zonder zoekwaarde (parameters, facetten, interne zoekopdrachten) en bundel duplicaten met canonicals en 301-redirects. Reken niet op noindex om budget te besparen: Google blijft die pagina's opvragen.
- Geef 404 of 410 voor verwijderde pagina's en los soft 404's op. Google noemt 404 een sterk signaal om de URL niet opnieuw te crawlen, terwijl geblokkeerde URL's langer in de wachtrij blijven staan. Verkort elke lange redirectketen.
- Controleer de crawlstatistieken. Onder Instellingen toont het rapport Crawlstatistieken responstijden en serverfouten. Zijn die hoog, dan verlaagt Google je capaciteitslimiet, en geen enkele contentfix helpt tot de server beter presteert.
- Repareer per map of template en valideer daarna de groep. Neem één besluit per patroon, maak een sitemap met alleen de gerepareerde URL's en klik op Oplossing valideren. Lees meer over crawlbudget als je site in deze categorie valt.
Wachten of ingrijpen?
Het moeilijkste is niet de fix maar weten wanneer je moet ophouden met wachten. Gebruik de bandbreedtes van Google zelf en je eigen trend.
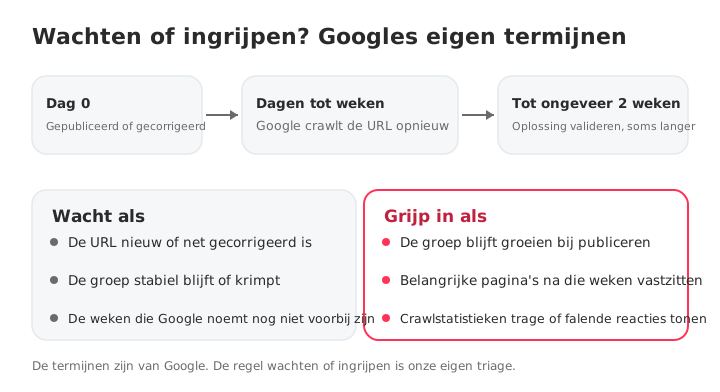
| Wat je deed | Wat Google zegt | Bron |
|---|---|---|
| Google gevraagd opnieuw te crawlen | Enkele dagen tot enkele weken | Google vragen opnieuw te crawlen |
| Indexering aangevraagd | Meestal ongeveer een dag, tot een of twee weken, met een dagelijks quotum | Help bij URL-inspectie |
| De oplossing gevalideerd | Tot ongeveer twee weken, soms veel langer | Help bij Paginaindexering |
De tijdbandbreedtes komen van Google. De regel voor wachten of ingrijpen is van ons: wacht zolang de URL nieuw is en de groep stabiel is of krimpt, en grijp in wanneer de groep blijft groeien of je sleutelpagina's na die weken nog vastzitten.
Hoe je het in de loop van de tijd volgt
Search Console toont de meest recente staat van elke URL en een lijst die beperkt is tot 1.000 rijen, dus bouw je eigen routine:
- Exporteer de lijst één keer per maand en vergelijk hem met de vorige. Groeit de groep, blijft hij stabiel of krimpt hij?
- Groepeer op patroon (taal, map, template) voordat je naar losse URL's kijkt.
- Kijk hoe Google elke URL vond. Een lijst die helemaal «sitemap» zegt en nergens «verwijzende pagina», zoals bij onze 14 URL's, wijst rechtstreeks naar interne links.
De weergave Indexatie van SEOcrawl AI levert die lijst kant-en-klaar: filter op dekkingsstatus om de URL's daarbinnen te zien, met datum van de laatste crawl, klikken en vertoningen. Via MCP komt elke URL ook met de door Google gekozen canonical tegenover de opgegeven canonical en of hij via de sitemap of via een verwijzende pagina is gevonden. De Crawler controleert je eigen pagina's, zodat je ziet wat zwak is aan een URL voordat je Google om een nieuwe blik vraagt, en de SEO Monitor waarschuwt wanneer een sleutelpagina noindex krijgt, van canonical wisselt, 404 teruggeeft of uit de sitemap verdwijnt.
Zo ziet die lijst eruit voor onze eigen site, rechtstreeks uit de weergave Indexatie:
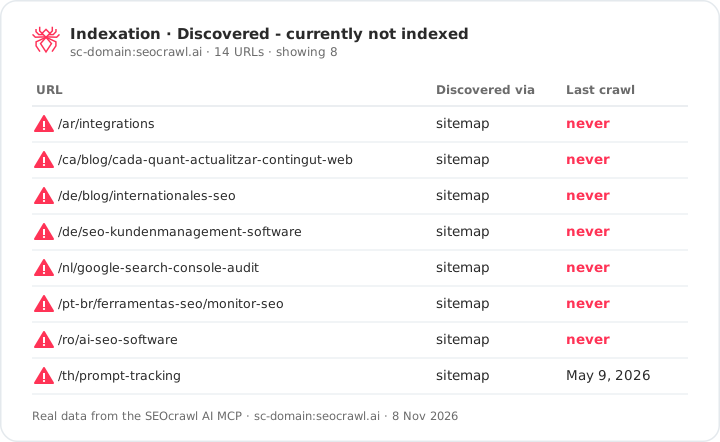
Het dashboard kun je ook overslaan. Met de SEOcrawl AI MCP gekoppeld aan Claude of ChatGPT vraag je: «Toon de URL's in Ontdekt – momenteel niet geïndexeerd en groepeer ze per map.» Hier staat de stapsgewijze uitleg om Search Console te koppelen aan Claude en ChatGPT.
Veelgestelde vragen
Wat betekent «Ontdekt – momenteel niet geïndexeerd»?
Het betekent dat Google je URL heeft gevonden maar hem nog niet heeft gecrawld. Meestal wilde Google crawlen en heeft het dat uitgesteld, en daarom is de datum van de laatste crawl leeg (Help bij Paginaindexering). Google heeft de pagina niet gelezen, dus de status zegt niets over de kwaliteit ervan. Het is geen penalty.
Hoe lang duurt «Ontdekt – momenteel niet geïndexeerd»?
Google publiceert geen termijn voor deze status. Hij zegt dat een aangevraagde nieuwe crawl enkele dagen tot enkele weken duurt, en dat de validatie van een oplossing tot ongeveer twee weken kost, soms veel langer. Een nieuwe URL heeft die weken misschien gewoon nodig. Blijft de groep groeien naarmate je publiceert, stop dan met wachten en grijp in.
Lost indexering aanvragen het op?
Het kan helpen bij enkele prioritaire URL's, omdat het Google vraagt de pagina in de wachtrij te zetten. Het neemt de oorzaak niet weg, dus de pagina kan terugkeren naar dezelfde status. Verzoeken vallen onder een dagelijks quotum en Google zegt dat dezelfde URL meermaals indienen niets versnelt. Gebruik het nadat je de interne links hebt verbeterd, nooit als massagereedschap.
Is het een penalty?
Nee. Handmatige acties staan in een eigen rapport. Deze status betekent dat Google de URL heeft gevonden en nog niet heeft gecrawld, dus de pagina is niet beoordeeld. De oorzaak is meestal crawlprioriteit: zwakke interne links, een trage server of een hoop URL's met weinig waarde die om crawls concurreren.
Waarom zijn zoveel van mijn pagina's ontdekt maar niet geïndexeerd?
Een hoog aantal wijst meestal op een patroon, niet op losse pagina's: URL-parameters of facetten, duplicaten, een sitemap met URL's die er niet in horen, zwakke interne links naar een hele sectie of een server die Googlebot afremt. Groepeer de URL's per map, taal of template voordat je er één afzonderlijk bekijkt.
Moet ik me zorgen maken bij een kleine site?
Meestal niet. Google zegt dat je bij minder dan 500 pagina's het rapport Paginaindexering waarschijnlijk niet eens nodig hebt. Enkele nieuwe URL's in deze status hebben meestal tijd en een paar interne links nodig vanaf pagina's die Google al crawlt.
Hoe kan SEOcrawl AI helpen bij ontdekte URL's?
De weergave Indexatie van SEOcrawl AI toont de URL's die in elke dekkingsstatus van Google zijn blijven hangen, met datum van de laatste crawl, klikken en vertoningen. Via de SEOcrawl AI MCP kun je Claude of ChatGPT ook om die lijst vragen, met de canonical van Google tegenover de opgegeven canonical en of Google elke URL via de sitemap of via een verwijzende pagina vond, en hem per map laten groeperen.
Meer SEOcrawl AI in Google
Kies ons als voorkeursbron en je ziet meer van onze artikelen in Topverhalen van Google.
Auteur: David Kaufmann
Ik heb de afgelopen 10+ jaar volledig in het teken van SEO gestaan — en eerlijk gezegd zou ik het voor geen goud anders willen.
Mijn carrière bereikte een nieuw niveau toen ik als senior SEO-specialist werkte voor Chess.com — een van de 100 meest bezochte websites van het hele internet. Werken op die schaal, verspreid over miljoenen pagina's, tientallen talen en in een van de meest competitieve SERPs die er bestaan, heeft me dingen geleerd die geen cursus of certificering ooit zou kunnen. Die ervaring veranderde mijn kijk op hoe geweldige SEO er echt uitziet — en werd de basis voor alles wat ik sindsdien heb gebouwd.
Vanuit die ervaring heb ik SEO Alive opgericht — een bureau voor merken die serieus werk willen maken van organische groei. Wij zijn er niet om dashboards en maandelijkse rapporten te verkopen. Wij zijn er om strategieën te bouwen die daadwerkelijk het verschil maken, door het beste van klassieke SEO te combineren met de spannende nieuwe wereld van Generative Engine Optimization (GEO) — zodat jouw merk niet alleen opduikt in de blauwe links van Google, maar ook binnen de AI-gegenereerde antwoorden die ChatGPT, Perplexity en Google AI Overviews elke dag opnieuw aan miljoenen mensen leveren.
En omdat ik geen tool kon vinden die beide werelden goed aanpakte, heb ik er zelf een gebouwd — SEOcrawl AI, een enterprise SEO intelligence platform dat rankings, technische audits, backlinks-monitoring, crawl-gezondheid en AI brand visibility tracking op één plek samenbrengt. Het is het platform waarvan ik altijd had gewild dat het bestond.
Ontdek meer content van deze auteur
We hebben Google-klikken en AI-referralverkeer gemeten op meer dan 16.000 websites in 15 branches. AI-verkeer groeit met 45% per jaar, maar staat nog steeds gelijk aan ongeveer 1 bezoek per 100 bezoeken uit Google, terwijl het aantal Google-klikken met 15% daalde.

Tot 30 november kost het eerste jaar van elk jaarabonnement van SEOcrawl AI de helft met de code BLACKFRIDAY2026. Dit krijg je, wat de prompts van elk abonnement dekken en hoe je in 15 minuten ziet waar ChatGPT, Gemini, Claude en Perplexity je noemen.