Uitgesloten door 'noindex'-tag: wat het betekent en hoe je het oplost
Je opende Google Search Console, zag een reeks URL's met de melding "Uitgesloten door 'noindex'-tag" en nu zijn die pagina's onzichtbaar in de zoekresultaten.
Zie je een reeks URL's met de status "Uitgesloten door 'noindex'-tag" in Google Search Console, dan worden je pagina's bewust buiten de index van Google gehouden, en de oplossing is meestal eenvoudiger dan het lijkt: vind de richtlijn, verwijder hem en vraag Google om opnieuw te crawlen.
Deze gids legt precies uit wat deze status veroorzaakt, hoe je de noindex-richtlijn opspoort die erachter zit en welke stappen je in elk groot CMS neemt om hem te verwijderen, zodat je pagina's weer kunnen ranken. Dezelfde controle draait automatisch in de SEOcrawl AI Crawler, die noindex-richtlijnen op je hele site signaleert zonder dat je URL voor URL hoeft te controleren.
Wat betekent "Uitgesloten door 'noindex'-tag" in Google Search Console?
De status "Uitgesloten door 'noindex'-tag" betekent dat Googlebot je pagina heeft gecrawld, een noindex-richtlijn heeft gevonden en die heeft opgevolgd door de pagina buiten de index van Google te houden. Je pagina verschijnt niet in de zoekresultaten zolang die richtlijn aanwezig is.
Waar deze status verschijnt in GSC
In het oude Dekkingsrapport (in 2022 vervangen door het rapport Pagina-indexering) stond deze status onder "Uitgesloten". In het huidige rapport Pagina-indexering (Indexering › Pagina's) vind je hem onder "Niet geïndexeerd", in de tabel "Waarom pagina's niet worden geïndexeerd", met als reden "Uitgesloten door 'noindex'-tag". Google groepeert alle getroffen URL's onder dit label, zodat je ze in bulk kunt exporteren en bekijken.
Hoe Google de noindex-richtlijn ontdekt en respecteert
De documentatie van Google over indexering blokkeren met noindex beschrijft twee manieren om de richtlijn mee te geven: een <meta name="robots" content="noindex">-tag in de HTML-<head> van de pagina, of een X-Robots-Tag: noindex-richtlijn in de HTTP-responsheaders. Wanneer Googlebot een van beide tegenkomt, verwijdert het de pagina volledig uit de index, ook als de pagina eerder geïndexeerd was. Voor de basis van de tag zelf, zie onze gids over de noindex-metatag.
Is dit altijd een probleem? Wanneer uitsluiting bewust is
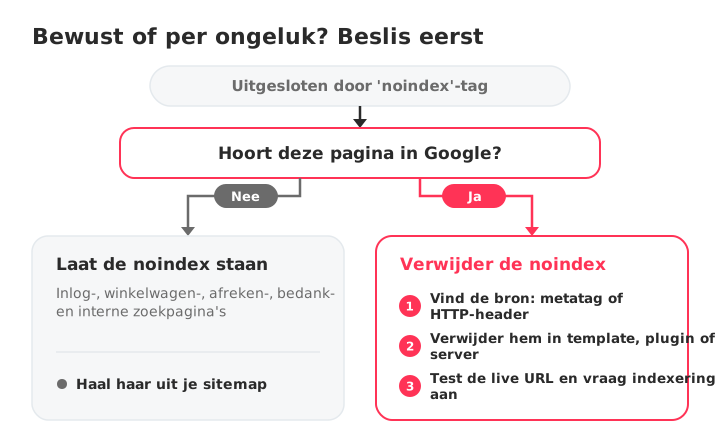
Niet elke URL met "Uitgesloten door 'noindex'-tag" is een fout. Beheerpagina's, inlogschermen, winkelwagen- en afrekenstappen, bedankpagina's en interne zoekresultaten worden bewust buiten de index van Google gehouden. Tonen die pagina's deze status, dan werkt het systeem zoals bedoeld. Het echte probleem begint wanneer pagina's die je wilt laten ranken dit label krijgen.
Veelvoorkomende oorzaken van de status "Uitgesloten door 'noindex'-tag"
Een noindex-richtlijn kan je pagina via verschillende routes bereiken. Weten welke route op je site actief is, bepaalt de oplossing.
Robots-metatag met "noindex" in de <head>
De meest voorkomende bron. Een regel als <meta name="robots" content="noindex"> in de HTML van je pagina vertelt Googlebot dat de pagina niet geïndexeerd mag worden. Hij kan hard in de template staan of dynamisch worden toegevoegd door een CMS, een plugin of een themafunctie.
X-Robots-Tag in HTTP-responsheaders
De X-Robots-Tag werkt precies zoals de metatag, maar staat in de HTTP-responsheader in plaats van in de HTML. Serverconfiguraties, CDN-regels of .htaccess-richtlijnen kunnen hem toevoegen. Bijvoorbeeld:
Header set X-Robots-Tag "noindex"
Dit raakt elk bestand dat aan de regel voldoet, inclusief pdf's en afbeeldingen die geen HTML-<head> hebben. Veel site-eigenaren zien deze route volledig over het hoofd, omdat de richtlijn niet zichtbaar is in de paginabron.
CMS-instellingen die indexering per ongeluk blokkeren
WordPress heeft onder Instellingen › Lezen een selectievakje "Zoekmachines ontmoedigen deze site te indexeren". Als het is aangevinkt, voegt WordPress een robots-noindex-tag toe aan elke pagina van de site. Veel site-eigenaren zetten het aan tijdens de ontwikkeling en vergeten het na de lancering weer uit te vinken.
Shopify kan noindex toepassen via themacode of apps. Sommige account- en systeempagina's houdt Shopify zelf buiten de index, en dat is terecht, maar een themawijziging of een SEO-app kan per ongeluk noindex toevoegen aan product-, collectie- of blogpagina's.
Wix past noindex toe op elke pagina waarvan de SEO-instellingen zoekmachines verhinderen de pagina te indexeren. Een veelvoorkomende oorzaak is een pagina dupliceren en ongemerkt de noindex-instelling van het origineel overnemen.
Plugin- of themaconflicten die noindex toevoegen
Met SEO-plugins kun je noindex instellen per bericht, pagina of contenttype. Een verkeerd ingestelde globale regel, een plugin-update die instellingen terugzet of een thema dat de richtlijnen van de plugin overschrijft, kan noindex in één keer over tientallen pagina's verspreiden. Heb je onlangs een plugin bijgewerkt of van thema gewisseld, controleer dit dan eerst.
Stagingomgeving-instellingen die naar productie zijn gezet
Een verrassend vaak voorkomende bron van onbedoelde noindex-tags. Je stagingsite gebruikt noindex om buiten Google te blijven. Wanneer de build-pipeline de stagingconfiguratie naar productie zet, gaat de noindex-richtlijn mee. Dit raakt meestal hele secties van een site tegelijk en is een van de lastigste oorzaken om te vinden als je alleen losse pagina's controleert.
Zo stel je vast welke pagina's getroffen zijn
Een herhaalbare diagnoseaanpak vindt alle getroffen URL's zonder giswerk. Begin in Search Console voor de lijst en zoom daarna in op afzonderlijke pagina's om de bron te vinden.
Het rapport Pagina-indexering gebruiken om getroffen URL's te exporteren
Open Google Search Console en ga naar Indexering › Pagina's. Klik op "Uitgesloten door 'noindex'-tag" in de tabel "Waarom pagina's niet worden geïndexeerd". Search Console toont een steekproef van getroffen URL's; gebruik de knop Exporteren om de lijst te downloaden en te verwerken.
Eén URL controleren met de URL-inspectietool
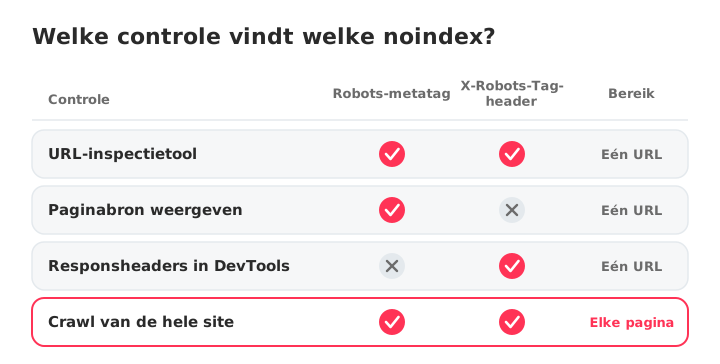
Plak een URL in de zoekbalk bovenaan Search Console. De URL-inspectietool laat zien of Google een noindex-richtlijn heeft gezien en waar die is gevonden: onder "Indexering toegestaan?" staat of de noindex uit de robots-metatag of uit de X-Robots-Tag HTTP-header kwam. Klik op Gecrawlde pagina bekijken om de exacte HTML te zien die Googlebot heeft ontvangen. Dit is de snelste controle voor een enkele pagina.
De paginabron controleren op noindex-metatags
Open de pagina in je browser, klik met de rechtermuisknop en kies Paginabron weergeven, en zoek dan naar "noindex" (Ctrl+F of Cmd+F). Vind je <meta name="robots" content="noindex"> of iets vergelijkbaars, dan is de metatag de boosdoener. Vind je hem niet in de bron, dan komt de richtlijn mogelijk uit de HTTP-header.
Browser-DevTools gebruiken om HTTP-headers te controleren
Open DevTools (F12, of rechtermuisknop › Inspecteren), ga naar het tabblad Network, laad de pagina opnieuw en klik op het verzoek voor het hoofddocument. Zoek in de sectie Response Headers naar X-Robots-Tag: noindex. Dit is de enige manier in de browser om noindex-richtlijnen in de header op te sporen die niet in de HTML staan.
Je site crawlen met Screaming Frog of SEOcrawl AI
Voor een diagnose van de hele site vindt een crawler alle getroffen pagina's in één keer. Screaming Frog SEO Spider kan pagina's filteren op indexeerbaarheid, op basis van metatags en headers. De SEOcrawl AI Crawler crawlt elke pagina, markeert elke pagina met een noindex-richtlijn onder Indexeerbaarheid en geeft een Audit Health Score, zodat je de volledige omvang ziet zonder handmatig te exporteren en te filteren.
Zo los je "Uitgesloten door 'noindex'-tag" op: stap voor stap
Dit is het meest praktische deel. Pas de oplossing toe die past bij je diagnose uit de vorige sectie.
De noindex-metatag uit de paginabron verwijderen
Bewerk de template of de content van de pagina om <meta name="robots" content="noindex"> uit de HTML-<head> te verwijderen. Bij maatwerksites controleer je de templatebestanden direct. Wordt de tag via JavaScript toegevoegd, zoek dan het verantwoordelijke script en verwijder het of voeg een voorwaarde toe.
Voor:
<meta name="robots" content="noindex">
Na:
<meta name="robots" content="index, follow">
Of verwijder de tag gewoon helemaal. Google behandelt het ontbreken van een noindex-richtlijn als "indexering toegestaan".
De X-Robots-Tag in je server- of CDN-configuratie repareren
Controleer je .htaccess (Apache), nginx.conf (Nginx) of CDN-regels op X-Robots-Tag: noindex-richtlijnen. Verwijder ze, of beperk ze tot de specifieke paden die uitgesloten moeten worden in plaats van de pagina's die je geïndexeerd wilt hebben. Je kunt bijvoorbeeld noindex op /staging/ laten staan en hem van /blog/ verwijderen.
Zo los je het op in WordPress
Twee controles, in deze volgorde:
- Instelling voor de hele site: ga naar Instellingen › Lezen en vink "Zoekmachines ontmoedigen deze site te indexeren" uit. Dit is in WordPress de meest voorkomende oorzaak van noindex-problemen op de hele site.
- Instellingen per pagina in SEO-plugins:
- Yoast SEO: open het bericht of de pagina, scrol naar de Yoast-metabox, klik op het tabblad Advanced en zet "Allow search engines to show this content in search results?" op "Yes".
- Rank Math: open het bericht, ga naar de Rank Math-metabox, klik op het tabblad Advanced en zet "Robots Meta" op "Index".
- All in One SEO: bewerk het bericht, open het tabblad Advanced van de AIOSEO-instellingen en zorg dat "No Index" niet is aangevinkt in de robots-instellingen.
Controleer ook de globale instellingen van elke plugin op complete contenttypes (tags, categorieën, custom post types) die op noindex staan. Voor de rest van de WordPress-configuratie, zie onze gids over WordPress koppelen aan Google Search Console.
Zo los je het op in Shopify
In Shopify komt noindex meestal uit themacode of een app. Open Online Store › Themes › Edit code en doorzoek theme.liquid en de paginatemplates op een robots-metatag met noindex. Controleer daarna je SEO-apps op regels die producten, collecties of blogberichten verbergen, en elk product of elke pagina die het metaveld seo.hidden gebruikt. Account- en andere systeempagina's houdt Shopify buiten de index, en dat moet zo blijven.
Zo los je het op in Wix, Squarespace en andere websitebouwers
Wix: open de SEO-instellingen van de pagina (via het paginamenu) en zet "Let search engines index this page" aan. Heb je een pagina gedupliceerd, dan kan de kopie een noindex-instelling van het origineel hebben overgenomen.
Squarespace: controleer de SEO-instellingen voor de hele site op een optie die de site verbergt voor zoekmachines. Open voor afzonderlijke pagina's de pagina-instellingen en zoek naar "Hide page from search results" op het tabblad SEO. Squarespace houdt standaard ook sommige systeempagina's, zoals de winkelwagen, buiten de zoekresultaten.
Na de oplossing: herindexering aanvragen in Google Search Console
Door de noindex-tag te verwijderen, vertel je Google dat het de pagina mag indexeren, maar Googlebot moet de pagina nog opnieuw crawlen om de wijziging te bevestigen.
De URL-inspectietool gebruiken om indexering aan te vragen
Plak de gerepareerde URL in de zoekbalk van Search Console. Klik op Live URL testen om te bevestigen dat indexering nu is toegestaan en klik daarna op Indexering aanvragen. Google zet de URL in de wachtrij om opnieuw te crawlen. Je kunt op deze manier meerdere URL's indienen, maar Search Console beperkt het aantal aanvragen per dag.
Hoe lang duurt het voordat Google een pagina opnieuw indexeert?
Meestal een paar dagen tot een paar weken, afhankelijk van hoe vaak Googlebot je site crawlt. Sites met veel verkeer die vaak worden bijgewerkt, worden sneller opnieuw gecrawld; nieuwe sites of sites met weinig verkeer moeten soms weken wachten. Indexering aanvragen is het snelste signaal dat je kunt geven, maar geen garantie: het zet je URL in de crawlwachtrij, het dwingt geen directe nieuwe crawl af.
Een bijgewerkte XML-sitemap indienen om crawlen te versnellen
Heb je veel pagina's tegelijk gerepareerd, dien dan een bijgewerkte XML-sitemap in via het onderdeel Sitemaps van Search Console. Dat laat zien dat je site is veranderd en stimuleert een bredere nieuwe crawl. Een schone sitemap zonder URL's met noindex voorkomt bovendien tegenstrijdige signalen, waar we hierna op ingaan.
Wanneer je de noindex-tag moet laten staan (bewuste uitsluitingen)
Niet elke noindex-tag hoeft weg. Sommige pagina's horen nooit in de zoekresultaten te verschijnen, en ze laten indexeren voegt dunne of dubbele pagina's toe aan het beeld dat Google van je site heeft en verspilt crawlaandacht.
Pagina's die nooit geïndexeerd horen te worden
- Inlog- en registratiepagina's
- Winkelwagen-, afreken- en orderbevestigingspagina's
- Interne zoekresultatenpagina's (om dubbele content te voorkomen)
- Bedankpagina's (leadmagnets, verzonden formulieren)
- Beheer- en backendpagina's
- Staging- en ontwikkelomgevingen
- Filter- en parameterpagina's die dubbele URL's genereren
noindex vs. robots.txt: de belangrijkste verschillen
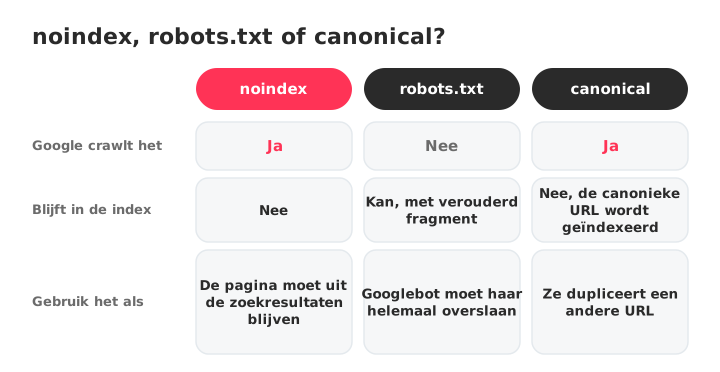
robots.txt blokkeert crawlen. noindex staat crawlen toe, maar blokkeert indexering. Blokkeer je een pagina in robots.txt, dan leest Googlebot haar nooit, wat betekent dat het de noindex-tag ook nooit ziet. Wil je een pagina uit de index, gebruik dan noindex. Wil je dat Googlebot de pagina volledig overslaat (om crawlbudget te besparen), gebruik dan robots.txt.
Een veelgemaakte fout: robots.txt gebruiken om een pagina te blokkeren die al geïndexeerd is. Google kan de noindex-tag niet zien als het de pagina niet mag crawlen, dus de URL kan met een verouderde titel en snippet in de index blijven. De juiste aanpak is crawlen toestaan en noindex gebruiken om de pagina uit de index te halen.
Canonical-tags vs. noindex: de juiste richtlijn kiezen
Een canonical-tag (rel="canonical") vertelt Google "deze pagina is een kopie van die andere URL, rank liever die". Een noindex-tag vertelt Google "indexeer deze pagina helemaal niet". Ze dienen verschillende doelen:
- Gebruik canonical als je dubbele of bijna-dubbele content hebt en rankingsignalen wilt bundelen op één URL.
- Gebruik noindex als de pagina onder geen enkele omstandigheid in de zoekresultaten mag verschijnen.
Beide op dezelfde pagina combineren geeft tegenstrijdige signalen: de ene zegt "voeg deze pagina samen met een andere URL", de andere zegt "laat haar vallen". Kies de richtlijn die past bij wat je wilt.
Onbedoelde noindex-tags in de toekomst voorkomen
Noindex-problemen achteraf oplossen is nodig, maar ze voorkomen bespaart uren diagnose en verloren verkeer.
Search Console-meldingen instellen voor dalingen in indexering
Google Search Console mailt geverifieerde eigenaren en gebruikers wanneer het nieuwe indexeringsproblemen in een property ontdekt. Zorg dat e-mailmeldingen zijn ingeschakeld in je e-mailvoorkeuren van Search Console. Daalt het aantal geïndexeerde pagina's plotseling, dan geeft de melding je een voorsprong voordat het verkeer volgt.
Noindex-controles toevoegen aan je QA-checklist vóór de lancering
Controleer op noindex-richtlijnen voordat je een site live zet of staging naar productie pusht. Een controle van 30 seconden met "Paginabron weergeven" en een zoekopdracht naar "noindex" vangt de meest voorkomende fout bij een deploy. Crawl bij grotere sites vóór en na de deploy en vergelijk het aantal pagina's met noindex. Zet het op je technische SEO-checklist zodat niemand het overslaat.
Geplande crawls om ongewenste noindex-richtlijnen te vangen
Voer volgens een schema een volledige crawl uit, en ook na elke plugin-update, themawijziging of migratie, om ongewenste noindex-tags te vangen voordat ze je verkeer kosten. Met de SEOcrawl AI Crawler kun je crawls vergelijken, zodat je ziet welke pagina's noindex kregen en wanneer, en SEO Monitor waarschuwt je zodra een van je belangrijkste pagina's een noindex-tag krijgt.
Veelgestelde vragen
Wat betekent "Uitgesloten door 'noindex'-tag" in Google Search Console?
Het betekent dat Google een noindex-richtlijn op je pagina heeft gevonden en gerespecteerd, waardoor de pagina niet in de zoekresultaten verschijnt. De status staat in het rapport Pagina-indexering van Search Console, onder "Niet geïndexeerd".
Het is niet altijd een fout: pagina's die je bewust uitsluit, zoals inlog- of afrekenpagina's, horen deze status te tonen.
Hoe los ik "Uitgesloten door 'noindex'-tag" op in WordPress?
Controleer twee plekken, in deze volgorde. Ga eerst naar Instellingen › Lezen en zorg dat "Zoekmachines ontmoedigen deze site te indexeren" is uitgevinkt. Open daarna elk getroffen bericht of elke pagina in je SEO-plugin (Yoast, Rank Math, All in One SEO) en controleer of de robots-instelling per pagina indexering toestaat.
Hoe lang duurt het voordat Google een pagina indexeert nadat noindex is verwijderd?
Meestal een paar dagen tot een paar weken, afhankelijk van hoe vaak Googlebot je site crawlt. Vraag indexering aan met de URL-inspectietool nadat je de richtlijn hebt verwijderd, en dien een bijgewerkte XML-sitemap in om het proces te versnellen. Sites met veel verkeer worden sneller opnieuw gecrawld dan nieuwe sites of sites met weinig verkeer.
Kan een pagina door noindex worden uitgesloten, ook al staat ze in mijn sitemap?
Ja. De noindex-richtlijn gaat boven opname in de sitemap. Google kan de URL vanuit je sitemap nog steeds crawlen, maar indexeert hem niet zolang noindex aanwezig is.
Verwijder de noindex zodat de pagina geïndexeerd kan worden, of haal de URL uit de sitemap als de uitsluiting bewust is. URL's met noindex in een sitemap opnemen geeft tegenstrijdige signalen.
Wat is het verschil tussen noindex en een pagina blokkeren in robots.txt?
robots.txt verhindert dat Googlebot de pagina crawlt; noindex staat crawlen toe, maar voorkomt indexering. Als je een pagina blokkeert met robots.txt, kan Google de noindex-tag niet lezen, dus een al geïndexeerde pagina kan met verouderde inhoud in de index blijven. Gebruik noindex om een pagina uit de index te halen en robots.txt alleen als je crawlen volledig wilt voorkomen.
Hoe controleer ik of een pagina een noindex-tag heeft?
Drie methoden, van snelst tot grondigst: gebruik de URL-inspectietool in Search Console, bekijk de paginabron en zoek naar "noindex" (Ctrl+F), of controleer de HTTP-responsheaders in de DevTools van je browser (tabblad Network, zoek naar X-Robots-Tag). Alleen de URL-inspectietool en DevTools vangen een noindex op die in de header wordt verstuurd.
Moet ik me zorgen maken als veel pagina's "Uitgesloten door 'noindex'-tag" tonen?
Alleen als die pagina's geïndexeerd zouden moeten worden. Exporteer de lijst uit Search Console, vergelijk hem met je bewuste uitsluitingen (inlog-, winkelwagen-, beheer- en bedankpagina's) en los alleen de pagina's op die in de zoekresultaten moeten ranken. Als elke getroffen pagina er een is die je bewust hebt uitgesloten, werkt de status precies zoals bedoeld.
Auteur: David Kaufmann
Ik heb de afgelopen 10+ jaar volledig in het teken van SEO gestaan — en eerlijk gezegd zou ik het voor geen goud anders willen.
Mijn carrière bereikte een nieuw niveau toen ik als senior SEO-specialist werkte voor Chess.com — een van de 100 meest bezochte websites van het hele internet. Werken op die schaal, verspreid over miljoenen pagina's, tientallen talen en in een van de meest competitieve SERPs die er bestaan, heeft me dingen geleerd die geen cursus of certificering ooit zou kunnen. Die ervaring veranderde mijn kijk op hoe geweldige SEO er echt uitziet — en werd de basis voor alles wat ik sindsdien heb gebouwd.
Vanuit die ervaring heb ik SEO Alive opgericht — een bureau voor merken die serieus werk willen maken van organische groei. Wij zijn er niet om dashboards en maandelijkse rapporten te verkopen. Wij zijn er om strategieën te bouwen die daadwerkelijk het verschil maken, door het beste van klassieke SEO te combineren met de spannende nieuwe wereld van Generative Engine Optimization (GEO) — zodat jouw merk niet alleen opduikt in de blauwe links van Google, maar ook binnen de AI-gegenereerde antwoorden die ChatGPT, Perplexity en Google AI Overviews elke dag opnieuw aan miljoenen mensen leveren.
En omdat ik geen tool kon vinden die beide werelden goed aanpakte, heb ik er zelf een gebouwd — SEOcrawl AI, een enterprise SEO intelligence platform dat rankings, technische audits, backlinks-monitoring, crawl-gezondheid en AI brand visibility tracking op één plek samenbrengt. Het is het platform waarvan ik altijd had gewild dat het bestond.
Ontdek meer content van deze auteur
Zie je "Alternatieve pagina met juiste canonieke tag" in Search Console? Meestal doet Google precies wat je hebt gevraagd. Zo onderscheid je de normale gevallen van de echte problemen, en zo los je de problemen op die ertoe doen.