Gecrawld – momenteel niet geïndexeerd: betekenis en oplossing

Google heeft je URL bezocht, gelezen en buiten de zoekresultaten gelaten. Zo zie je welke pagina's een tweede kans verdienen, en hoe Google adviseert ze alsnog geïndexeerd te krijgen.
Gecrawld – momenteel niet geïndexeerd betekent dat Googlebot je pagina heeft opgehaald en besloot hem niet aan de index van Google toe te voegen, waardoor hij niet in de zoekresultaten kan verschijnen. De Help-pagina over het rapport Pagina-indexering zegt het zo: de pagina is gecrawld maar niet geïndexeerd, en wordt "in de toekomst misschien wel of misschien niet geïndexeerd".
De oorzaak is meestal de pagina zelf, geen technische blokkade. Hieronder zie je hoe je per URL beslist of je een pagina oplost, op noindex zet of verwijdert, en hoe lang een oplossing volgens Google duurt. Nieuw met dit rapport? Begin met deze gids over Google Search Console.
Wat betekent "Gecrawld – momenteel niet geïndexeerd"?
De status betekent dat Google de pagina heeft gecrawld en besloot hem niet te indexeren. Niets blokkeerde Googlebot: Google besloot de pagina voorlopig buiten de index te laten. Twee verschillen helpen je de status goed te lezen.
Gecrawld vs. geïndexeerd
Crawlen is Googlebot die een pagina downloadt. Indexeren is Google die hem opslaat zodat hij in zoekresultaten kan verschijnen. Een pagina kan vele keren gecrawld worden en toch nooit geïndexeerd raken.
De Help-pagina over de URL-inspectietool zegt dat de kwaliteit van een pagina "hoog genoeg moet zijn om indexering te rechtvaardigen", en de livetest kan deze status helemaal niet controleren.
Het verschil met "Ontdekt – momenteel niet geïndexeerd"
Ontdekt – momenteel niet geïndexeerd komt een stap eerder: Google heeft de URL gevonden maar de crawl uitgesteld om je site niet te overbelasten, dus de datum van de laatste crawl is leeg.
| Ontdekt – momenteel niet geïndexeerd | Gecrawld – momenteel niet geïndexeerd | |
|---|---|---|
| Gecrawld door Google? | Nee | Ja |
| Datum laatste crawl | Leeg | Een datum |
| Gebruikelijke reden | Crawl uitgesteld om de site niet te overbelasten | Google las de pagina en sloeg hem over |
| Kijk eerst naar | Crawlcapaciteit, op zeer grote sites | Contentkwaliteit, duplicaten, canonicals |
Google zegt ook: "Niet geïndexeerd is niet per se slecht." Pagina's met noindex, URL's die in robots.txt geblokkeerd zijn, duplicaten en 404's zonder vervanging horen buiten de index te blijven.
Waarom Google pagina's crawlt zonder ze te indexeren
Indexering heeft een kwaliteitslat die crawlen niet heeft. De gids van Google over crawlbudget zegt dat de crawlvraag stijgt met de waarde en uniciteit van je content.
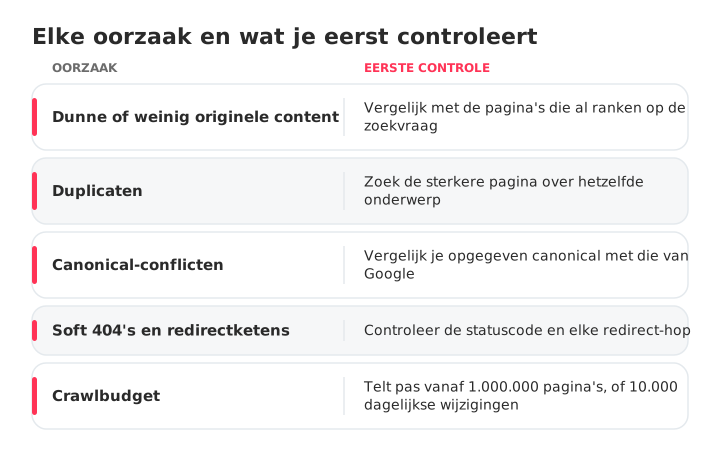
De meeste getroffen URL's vallen onder een van deze oorzaken, elk met de eerste controle:
- Dunne of weinig originele content: de pagina herhaalt wat al rankt.
- Duplicaten: tagarchieven, gesorteerde URL's, twee artikelen over hetzelfde onderwerp. Zo herken en los je keyword-kannibalisatie op.
- Canonical-conflicten: vergelijk de canonical die je opgeeft met de canonical die Google heeft geselecteerd. Kiest Google een andere URL, dan verschuift de pagina meestal naar Alternatieve pagina met juiste canonieke tag of een duplicaatstatus.
- Soft 404's en redirectketens: volgens Google verspillen soft 404's crawlbudget.
- Crawlbudget: dat telt voor sites met meer dan 1.000.000 pagina's die wekelijks veranderen of meer dan 10.000 die dagelijks veranderen. Voor de meeste sites is het niet de oorzaak.
De lat ging in twee gedateerde stappen omhoog. Op 18 augustus 2022 kondigde Google de helpful content update aan, een signaal voor de hele site, en zei dat het verwijderen van weinig nuttige content de rest van een site kan helpen. Op 5 maart 2024 kondigde Google een core update aan om minder content te tonen die gemaakt is om klikken te trekken, samen met een nieuw spambeleid tegen misbruik van content op schaal.
De richtlijnen van Google over nuttige content zeggen dat E-E-A-T geen specifieke rankingfactor is, dat betrouwbaarheid het zwaarst weegt en dat er geen voorkeursaantal woorden bestaat. Een pagina opvullen lost het niet op.
Getroffen pagina's vinden en diagnosticeren in GSC
Open het rapport Pagina-indexering (voorheen Dekking), inspecteer een steekproef en groepeer de lijst daarna op patroon. Google merkt op dat sites met minder dan 500 pagina's het rapport waarschijnlijk niet nodig hebben.
Getroffen URL's vinden in het rapport Pagina's
- Ga in Google Search Console naar Indexering › Pagina's.
- Klik onder "Waarom pagina's niet worden geïndexeerd" op Gecrawld – momenteel niet geïndexeerd.
- Klik op Exporteren en download de lijst.
Het rapport toont maximaal 1.000 voorbeeld-URL's, niet per se allemaal, dus op een grote site is de export een steekproef.
Pagina's controleren met de URL-inspectietool
Inspecteer vijf tot tien geëxporteerde URL's op de datum van de laatste crawl en de door Google geselecteerde canonieke URL. Een canonical die elders naar wijst, betekent dat Google een duplicaat ziet; een crawldatum van maanden geleden wijst erop dat Google zelden terugkomt.
Patronen herkennen in honderden URL's
Sorteer de export op map, template en URL-parameter en tel elke groep. Stel dat 300 URL's uiteenvallen in 180 /tag/-pagina's, 70 ?sort=-URL's en 50 artikelen: dat zijn drie beslissingen, geen 300.
Oplossen, noindex of verwijderen: beslis wat elke URL verdient
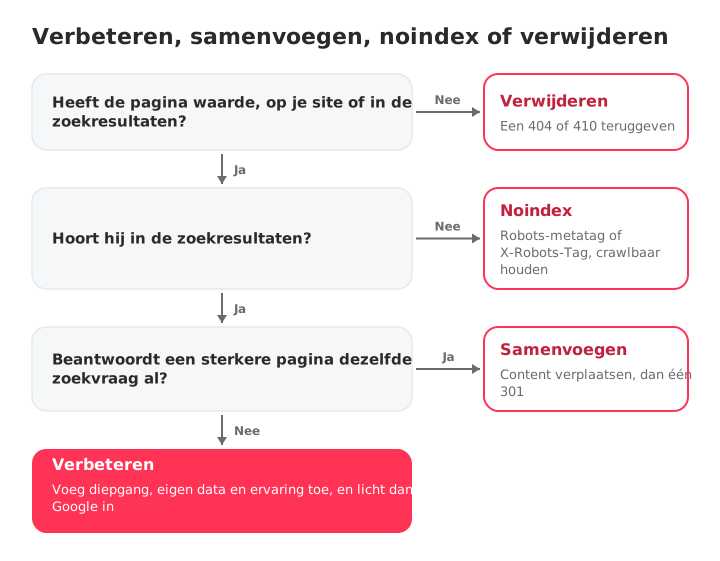
Elke URL verdient een van vier uitkomsten. Vraag je af: zou een zoeker blij zijn hier te landen, en is dit de enige pagina op je site die de zoekvraag beantwoordt?
| Paginatype | Voorbeeld | Beslissing | Hoe |
|---|---|---|---|
| Nuttig en uniek, maar dun | Een gids van 300 woorden over een onderwerp dat je kent | Verbeteren | Diepgang en details uit eigen ervaring toevoegen |
| Duplicaat van een sterkere pagina | Twee artikelen over dezelfde zoekvraag | Samenvoegen | Content verplaatsen, daarna een 301-redirect |
| Nuttig op de site, niet in de zoekresultaten | Tagarchieven, interne zoekfunctie, bedankpagina's | Noindex | Robots-metatag of X-Robots-Tag |
| Geen waarde, geen vervanging | Verlopen acties, testpagina's | Verwijderen | Een 404 of 410 teruggeven |
De crawlbudgetgids van Google onderbouwt de laatste twee rijen: geef een 404 of 410 terug voor verwijderde pagina's en voeg duplicaten samen. Een 404 in Search Console is normaal voor pagina's die je bewust hebt verwijderd.
Bij noindex gaat de triage het vaakst mis:
Niet zo: een noindex-tag op je /tag/-pagina's terwijl robots.txt /tag/ blokkeert. Googlebot kan de pagina's niet ophalen en ziet de tag dus nooit.
Wel zo: /tag/ blijft crawlbaar en draagt de noindex als metatag of X-Robots-Tag-header.
Volgens de documentatie van Google over noindex werkt de regel niet in robots.txt, en op zelden bezochte pagina's kan de nieuwe crawl maanden duren. Zodra de tag gelezen is, verhuizen die URL's naar Uitgesloten door 'noindex'-tag, en dat is precies wat je voor ze wilt.
Pagina's oplossen die indexering verdienen
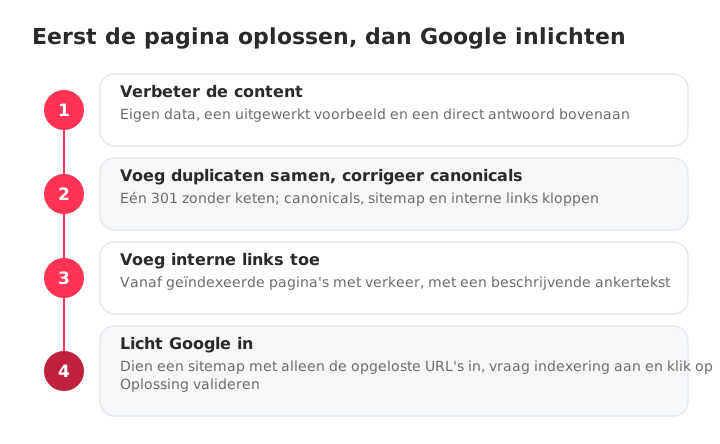
Maak de pagina eerst het indexeren waard en laat het Google daarna weten. Indexering aanvragen voor een ongewijzigde pagina vraagt Google een beslissing te herhalen die al genomen is. De volgorde:
- Verbeter de content.
- Voeg duplicaten samen en corrigeer canonicals.
- Voeg interne links toe.
- Dien een gerichte sitemap in en vraag indexering aan.
Verbeter de diepgang en originaliteit van de content
Herschrijf voor de zoekvraag, niet voor een aantal woorden: voeg je eigen data, screenshots, een uitgewerkt voorbeeld en een direct antwoord bovenaan toe.
Neem bijvoorbeeld een dunne gids van 300 woorden: voeg een eigen dataset en een uitgewerkt voorbeeld toe, link ernaar vanuit twee artikelen die al verkeer krijgen, en zet hem pas daarna in een gerichte sitemap.
Voeg duplicaten samen en corrigeer canonicals
Behandelen twee URL's hetzelfde, houd er dan één, verplaats de nuttige content daarheen en stuur de andere met een 301-redirect er direct naartoe, zonder keten. Controleer daarna of canonicals, sitemap en interne links overeenkomen en of er geen vergeten noindex is achtergebleven.
Voeg interne links toe vanaf pagina's die Google al waardeert
Link naar elke opgeloste pagina vanaf geïndexeerde pagina's met verkeer, met een beschrijvende ankertekst. Elke sitecrawler kan weespagina's (nul interne links) opsommen door te filteren op nul inkomende links. De volledige methode staat in deze gids over interne links.
Controleer de pagina ook op een telefoon en in het rapport Core Web Vitals: een kapotte mobiele pagina is snel uit te sluiten.
Dien een gerichte sitemap in en vraag indexering aan
Maak een sitemap met alleen de URL's die je hebt opgelost, dien hem in en filter het rapport Pagina's erop voordat je op Oplossing valideren klikt. Google raadt dit aan om de validatie te versnellen. Heb je eerst je huidige bestand nodig, vind dan de sitemap van je site.
Google negeert priority en changefreq, dus houd lastmod liever nauwkeurig. Klik daarna in de URL-inspectietool op Indexering aanvragen voor je prioritaire URL's: Google hanteert een quotum en zegt dat herhaalde aanvragen niets versnellen.
Hoe lang duurt indexering na een oplossing?
Reken op een dag tot enkele weken, en indexering is nooit gegarandeerd. Google noemt op verschillende pagina's verschillende termijnen, dus hier staan ze naast elkaar:
| Wat je deed | Wat Google zegt | Bron |
|---|---|---|
| Google gevraagd opnieuw te crawlen | Een paar dagen tot een paar weken | Google vragen opnieuw te crawlen |
| Indexering aanvragen | Meestal ongeveer een dag, tot een à twee weken, met een daglimiet | Help bij URL-inspectie |
| Oplossing valideren | Tot ongeveer twee weken, soms veel langer | Help bij Pagina-indexering |
Dit zijn de termijnen van Google, geen herstelcases. Bekijk het rapport Pagina's wekelijks; zijn opgeloste URL's na die termijnen niet verschoven, ga dan terug naar de content.
Voorkomen dat nieuwe pagina's in deze status belanden
Preventie is een routine: controleer elke pagina voordat hij live gaat en bekijk Search Console maandelijks. Controleer vóór publicatie of de pagina:
- Een zoekvraag beantwoordt die geen andere pagina op je site beantwoordt.
- Je eigen data, voorbeelden of ervaring toevoegt.
- Een naar zichzelf verwijzende canonical en geen vergeten noindex heeft.
- In de sitemap staat met een nauwkeurige lastmod.
- Een auteur met naam heeft en, waar van toepassing, gestructureerde gegevens.
- Een link krijgt vanaf een verwante, geïndexeerde pagina.
Vergelijk eens per maand het rapport Pagina's met de vorige maand; een probleem blijft 90 dagen in de lijst staan nadat het laatste exemplaar verdwenen is. Sites met meer dan duizend pagina's doen er goed aan ook het rapport Crawlstatistieken in de gaten te houden.
SEOcrawl AI regelt de technische kant op schaal. De Crawler scant elke pagina en geeft een Audit Health Score, met problemen uitgesplitst naar Indexability, Crawlability, On-Page en meer. De Indexation-weergave groepeert je URL's per dekkingsstatus in Search Console, zodat je ziet hoeveel er onder "Gecrawld – momenteel niet geïndexeerd" vallen en het aantal in de tijd kunt volgen.
Tussen crawls door waarschuwt SEO Monitor je wanneer een belangrijke pagina een noindex krijgt, haar canonical wijzigt, een 404 teruggeeft of uit de sitemap verdwijnt. Hetzelfde platform volgt de zichtbaarheid van je merk in ChatGPT, Claude, Gemini, Perplexity en Copilot, zodat SEO en GEO samenkomen.
Veelgestelde vragen
Wat betekent "Gecrawld – momenteel niet geïndexeerd"?
Het betekent dat Googlebot je pagina heeft opgehaald en besloot hem niet aan de index van Google toe te voegen, waardoor hij niet in de zoekresultaten kan verschijnen. Niets blokkeerde de crawl: Google heeft de pagina gelezen en hem voorlopig buiten de index gelaten. Het is geen handmatige actie, en de pagina wordt in de toekomst misschien wel of misschien niet geïndexeerd.
Is het hetzelfde als "Ontdekt – momenteel niet geïndexeerd"?
Nee. "Ontdekt" betekent dat Google de URL kent maar de crawl heeft uitgesteld, dus de datum van de laatste crawl is leeg. "Gecrawld" betekent dat Google de pagina al heeft bezocht en gelezen en daarna besloot hem niet te indexeren. Bij Ontdekt kijk je op zeer grote sites naar de crawlcapaciteit; bij Gecrawld naar de contentkwaliteit, duplicaten en canonicals.
Schaadt "Gecrawld – momenteel niet geïndexeerd" mijn SEO?
Niet op zichzelf: de status is geen straf, en de betreffende pagina verliest alleen haar eigen zoekverkeer. Het risico zit in het volume, want Google behandelt een groot aandeel weinig nuttige content als een signaal voor de hele site. Een tagarchief buiten de index kost niets; een productpagina wel. Stijgt het aantal bij elke publicatie, behandel het dan als een contentprobleem van de hele site, niet als een lijst losse URL's.
Hoe lang duurt het voordat een pagina na een oplossing geïndexeerd wordt?
Reken op een dag tot enkele weken, en indexering is nooit gegarandeerd. Volgens Google duurt een nieuwe crawl een paar dagen tot een paar weken, wordt een indexeringsaanvraag meestal binnen ongeveer een dag verwerkt maar kan die een à twee weken duren, en duurt het valideren van een oplossing meestal tot ongeveer twee weken.
Helpt het om indexering aan te vragen?
Alleen nadat je de pagina hebt aangepast. Indexering aanvragen voor een ongewijzigde pagina vraagt Google een beslissing te herhalen die al genomen is. Aanvragen vallen onder een dagelijks quotum, en volgens Google versnelt het niets als je dezelfde URL meerdere keren indient.
Helpt het om de pagina aan mijn XML-sitemap toe te voegen?
Het helpt Google een URL te vinden, niet om hem te indexeren. Google noemt een ingediende sitemap "slechts een hint", en deze pagina's zijn al gevonden en gelezen. Na een oplossing is de taak van de sitemap om de URL's te bundelen die je opnieuw wilt laten controleren. Elk sitemapbestand bevat maximaal 50.000 URL's of 50 MB.
Waarom is mijn validatie van "Gecrawld – momenteel niet geïndexeerd" mislukt?
De validatie stopt zodra Google in de groep één URL vindt die nog niet is opgelost, dus één achtergebleven pagina kan de hele batch laten mislukken. Los elke URL in de groep op, of verklein de groep door het rapport te filteren met een sitemap met alleen je opgeloste URL's, en valideer daarna opnieuw.
Hoe helpt SEOcrawl AI bij pagina's die Google crawlt maar niet indexeert?
SEOcrawl AI vindt de oorzaken op je eigen site achter de status. De Crawler toont per URL de health score, de HTTP-statuscode en de crawldiepte, zodat je pagina's ziet die Google moeilijk bereikt. De Indexation-weergave groepeert je URL's per dekkingsstatus in Search Console, en SEO Monitor waarschuwt je wanneer een belangrijke pagina een noindex krijgt, haar canonical wijzigt, een 404 teruggeeft of uit de sitemap verdwijnt.
Auteur: David Kaufmann

Ik heb de afgelopen 10+ jaar volledig in het teken van SEO gestaan — en eerlijk gezegd zou ik het voor geen goud anders willen.
Mijn carrière bereikte een nieuw niveau toen ik als senior SEO-specialist werkte voor Chess.com — een van de 100 meest bezochte websites van het hele internet. Werken op die schaal, verspreid over miljoenen pagina's, tientallen talen en in een van de meest competitieve SERPs die er bestaan, heeft me dingen geleerd die geen cursus of certificering ooit zou kunnen. Die ervaring veranderde mijn kijk op hoe geweldige SEO er echt uitziet — en werd de basis voor alles wat ik sindsdien heb gebouwd.
Vanuit die ervaring heb ik SEO Alive opgericht — een bureau voor merken die serieus werk willen maken van organische groei. Wij zijn er niet om dashboards en maandelijkse rapporten te verkopen. Wij zijn er om strategieën te bouwen die daadwerkelijk het verschil maken, door het beste van klassieke SEO te combineren met de spannende nieuwe wereld van Generative Engine Optimization (GEO) — zodat jouw merk niet alleen opduikt in de blauwe links van Google, maar ook binnen de AI-gegenereerde antwoorden die ChatGPT, Perplexity en Google AI Overviews elke dag opnieuw aan miljoenen mensen leveren.
En omdat ik geen tool kon vinden die beide werelden goed aanpakte, heb ik er zelf een gebouwd — SEOcrawl AI, een enterprise SEO intelligence platform dat rankings, technische audits, backlinks-monitoring, crawl-gezondheid en AI brand visibility tracking op één plek samenbrengt. Het is het platform waarvan ik altijd had gewild dat het bestond.
Ontdek meer content van deze auteur

Een productlijstpagina (PLP) toont een hele productcategorie in één keer. Ontdek hoe die verschilt van een PDP, wat haar laat converteren en hoe je lijstpagina's geïndexeerd krijgt zonder de chaos van gefacetteerde navigatie.

Domain Authority voorspelt hoe goed een site zal ranken, maar is geen rankingfactor van Google. Hier lees je wat DA echt meet, hoe het zich verhoudt tot DR en Authority Score en welke metrics in plaats daarvan je aandacht verdienen.