「検出 - インデックス未登録」とは?意味と対処法
Googleはあなたの URL の存在を知っていますが、まだ訪れていません。待つべきか動くべきかの見極め方と、小規模サイトと大規模サイトで最初に試す対処法を紹介します。
検出 - インデックス未登録は、Googleが URL を見つけたもののまだクロールしていないことを意味します。Googleのページのインデックス登録レポートのヘルプはこのように説明しています。多くの場合、Googleはクロールを予定していたものの、サイトに過度な負荷をかけないよう延期しており、そのためレポートでは最終クロール日が空白になります。
これは**クロールの優先度に関するステータスであり、コンテンツへの評価ではありません。**Googleがまだページを読んでいないからです。以下では、「クロール済み」との違い、自社サイトを調べて分かったこと、サイト規模別の対処法を紹介します。レポートを使い始めたばかりなら、まずこのGoogle Search Consoleガイドをご覧ください。
「検出 - インデックス未登録」の意味
Googleは URL を4つの段階で処理します。検出、クロール、インデックス登録、そして検索結果への表示です。Search Console の2つのステータスは、途中で止まっている URL を示します。
URL は、サイトマップや他のページからのリンクによって「検出」に至ります。その後、Googleがいつクロールするかを決めます。「検出」とは、その決定がまだ下されていないという意味です。
「クロール済み - インデックス未登録」との違い
2つのステータスは似ていますが、必要な対処は異なります。
| 検出 - インデックス未登録 | クロール済み - インデックス未登録 | |
|---|---|---|
| Googleはクロール済みか | いいえ | はい |
| 最終クロール日 | 空白 | 日付あり |
| Googleはページを読んだか | いいえ | はい |
| よくある理由 | クロールが延期された、または優先度が低い | Googleがページを読んだうえで見送った |
| 最初に確認すること | 内部リンク、サイトマップ、クロール容量 | コンテンツの品質、重複、canonical |
2つ目のステータスの詳しい診断は、クロール済み - インデックス未登録のガイドにまとめています。
実際のサイトでの一覧
SEOcrawl のインデックスレポートで seocrawl.ai を確認しました。SEOcrawl が監視する1,000件の URL(サイトマップの申告は6,310件)のうち、**823件がインデックス登録済みで、割合は82.3%**です。128件が「クロール済み - インデックス未登録」、**14件が「検出 - インデックス未登録」**でした。
この14件の共通点が参考になります。
- すべて翻訳ページで、アラビア語、カタロニア語、ドイツ語、エストニア語、リトアニア語、オランダ語、ブラジルポルトガル語、ルーマニア語、タイ語です。英語のページは1件もありません。
- **Googleは14件すべてをサイトマップ経由で見つけており、**他のページからのリンクではありません。
- **そのうち1件は過去のクロール日(2026年5月9日)が表示されています。**つまりこのステータスは URL の現在地を示すもので、Googleが一度も訪れていないという意味ではありません。
これは確認すべきパターンであり、診断ではありません。26言語で存在し、主にサイトマップ経由で到達されるページは、内部リンクが弱い典型的な候補なので、まず内部リンクを見てください。この教訓はどのサイトにも当てはまります。**一覧を URL ごとに読まないでください。**言語別にグループ化すると、14件の URL が1つの問いになりました。
数値は、サイトマップ全体のサンプルである SEOcrawl が監視する1,000件の URL を対象としています。128件という大きなグループは別のステータスで、専用のガイドがあります。
Googleがクロールを延期する理由
Googleのクロールバジェットのガイドでは、クロール量の決め方が説明されています。サーバーが耐えられる容量の上限と、URL への需要です。検出された URL の多くは、次の5つの原因のいずれかに行き着きます。
- **クロール容量。**Googleによると、サイトが遅くなったりサーバーエラーを返したりすると上限が下がります。サーバーが遅ければクロールは減ります。
- **クロール需要の低さ。**需要は、サイトの規模、更新頻度、ページの品質と関連性で決まります。内部リンクが少ない、またはない URL には、Googleがすぐ戻る理由がほとんどありません。
- **無駄なクロール。**重複 URL、パラメータ、ファセット、長いリダイレクトチェーン、ソフト404が、本来のページと競合します。Googleは、ソフト404はクロールが続いてバジェットを浪費すること、noindex のページも見送る前に取得されることを指摘しています。
- **サイトマップ経由でのみ検出。**サイトマップは URL の存在をGoogleに伝えます。しかし優先度を上げるわけではなく、Googleはサイトマップをヒントとして扱います。そこでしか見つからないページは真っ先に待たされます。
- **新しいサイトやセクション。**どのサイトも、慎重な同じ初期設定の容量上限から始まり、サイトの健全さが示されるにつれて上がります。
クロールバジェット自体が問題になるのは非常に大規模なサイトだけです。Googleの目安は、おおむね週1回更新される100万ページ以上のユニークページ、または毎日変わる1万ページ以上です。それより小さいサイトでは、原因2と4のほうがはるかに多く見られます。
問題なのか?修正する前の3つの質問
- **この URL は本当にインデックス登録すべきですか。**フィルター済みのビュー、サイト内検索ページ、テスト用 URL なら、登録されていなくて当然です。それを明示するには、noindex を設定するか、404 または 410 を返してください(Excluded by 'noindex' tag を参照)。
- 何件あり、どんなパターンですか。Googleは、500ページ未満であればこのレポートはおそらく不要だとしています。また一覧は1,000行までに制限されているため、大規模サイトでは一部のサンプルになります。
- **新しい URL ですか。**先週公開した URL はまだ問題ではありません。Google自身が示す期間は下の表にあります。
サイト規模別の対処法
最初に取るべき対策はサイトの規模で変わるため、該当する列から始めてください。
ほとんどのサイト:約1万件の URL まで
- **その URL がインデックス登録に値するか確認します。**値しなければ noindex を設定するか削除し、リストから外してください。
- **Googleがすでにクロールしているページからリンクします。**トラフィックのあるインデックス登録済みページから、内容が分かるアンカーテキストでコンテキストに沿ったリンクを追加します。どのクローラーでも、内部リンクがゼロのページを絞り込めば孤立ページを確認でき、この内部リンクのガイドに手順の全体があります。
- **サイトマップを整えます。**200 を返し、インデックス可能で、canonical である URL だけを、正確な
lastmodとともに含めます。Googleは priority と changefreq を無視します。まずファイルが必要ならサイトマップの見つけ方を、Search Console が見つけられないと表示する場合は No referring sitemaps detected を参照してください。 - **優先度の高い数件の URL でインデックス登録をリクエストします。**URL検査ツールを開き、インデックス登録をリクエストをクリックします。Googleは割り当て制限を設けており、繰り返しのリクエストは何も早めないとしているため、最も重要なページのために取っておきましょう。
大規模または変化の速いサイト:1日に1万件以上、または週に100万件以上の URL が変わる
- **無駄なクロールを減らします。**検索価値のない URL 空間(パラメータ、ファセット、サイト内検索)は robots.txt でブロックし、重複は canonical と 301リダイレクトで統合します。バジェットの節約を noindex に頼らないでください。Googleはそれらのページを取得し続けます。
- **削除したページは 404 または 410 を返し、ソフト404を修正します。**Googleは404を URL を再クロールしない強いシグナルとしており、ブロックされた URL はキューに長く残ります。長いリダイレクトチェーンは短くしてください。
- **クロールの統計を確認します。**設定内のクロールの統計レポートで、応答時間とサーバーエラーが分かります。数値が高いとGoogleは容量の上限を下げ、サーバーが改善するまでコンテンツの修正は効果がありません。
- **フォルダまたはテンプレート単位で修正し、グループを検証します。**パターンごとに1つの判断を下し、修正済みの URL だけのサイトマップを作成して、修正を検証をクリックします。サイトがこのカテゴリに当てはまるなら、クロールバジェットについても読んでみてください。
待つか、動くか
難しいのは修正ではなく、待つのをやめる時期を知ることです。Google自身が示す期間と、自社の推移を使いましょう。
| 行ったこと | Googleの説明 | 出典 |
|---|---|---|
| Googleに再クロールを依頼した | 数日から数週間 | Googleに再クロールを依頼する |
| インデックス登録をリクエストした | 通常は約1日、長くても1~2週間、1日あたりの割り当てあり | URL検査のヘルプ |
| 修正を検証した | 最大で約2週間、場合によってはさらに長い | ページのインデックス登録のヘルプ |
期間の目安はGoogleのものです。待つか動くかの基準は当社のものです。URL が新しく、グループが安定または縮小している間は待ちます。グループが増え続ける場合や、重要なページがその期間を過ぎても引っかかったままの場合は動きます。
時間をかけて監視する方法
Search Console は各 URL の最新の状態と、1,000行に制限された一覧しか表示しないため、独自の運用を作りましょう。
- 月に1回、一覧をエクスポートして前回と比較します。グループは増えているか、安定しているか、縮小しているか。
- 個別の URL を見る前に、パターンでグループ化します(言語、フォルダ、テンプレート)。
- **Googleが各 URL をどう見つけたかを確認します。**当社の14件の URL のように、すべて「サイトマップ」で「参照元ページ」が1つもない一覧は、内部リンクを直接指し示しています。
SEOcrawl AI のインデックスビューは、この一覧をそのまま提供します。カバレッジの状態で絞り込むと、その中の URL が最終クロール日、クリック数、表示回数とともに表示されます。MCP 経由なら、各 URL にGoogleが選んだ canonical と宣言された canonical の比較、さらにサイトマップと参照元ページのどちらで見つかったかも付いてきます。クローラーは自社のページを監査するので、Googleにもう一度見てもらう前に URL のどこが弱いかが分かります。SEO Monitorは、重要なページに noindex が付いた、canonical が変わった、404 を返した、サイトマップから消えた場合に通知します。
当社のサイトの一覧を、インデックスビューからそのまま紹介します。
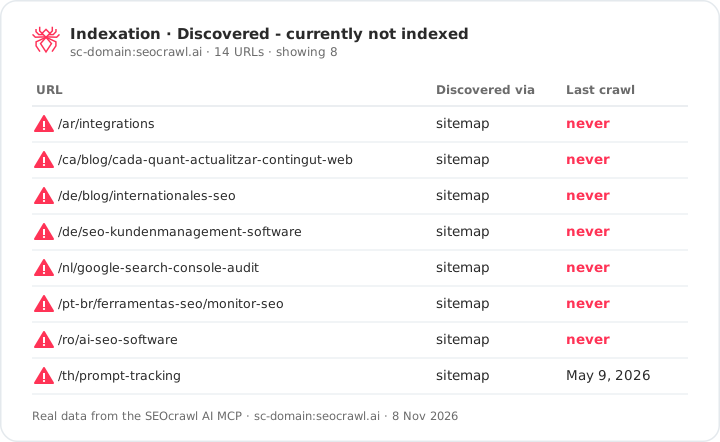
ダッシュボードを開かなくても構いません。SEOcrawl AI MCP を Claude または ChatGPT に接続して、こう尋ねてください。「検出 - インデックス未登録の URL を一覧にして、フォルダごとにグループ化して。」Search Console を Claude と ChatGPT に接続する手順はこちらです。
よくある質問
「検出 - インデックス未登録」とは何ですか?
Googleがあなたの URL を見つけたものの、まだクロールしていないという意味です。多くの場合、Googleはクロールを予定して延期しており、そのため最終クロール日は空白になります(ページのインデックス登録のヘルプ)。Googleはページを読んでいないので、**このステータスはページの品質について何も示しません。**ペナルティではありません。
「検出 - インデックス未登録」はどのくらい続きますか?
**Googleはこのステータスの期限を公表していません。**依頼した再クロールには数日から数週間、修正の検証には最大で約2週間、場合によってはさらに長くかかるとしています。新しい URL は、単にその期間が必要なだけかもしれません。公開するたびにグループが増え続ける場合は、待つのをやめて動いてください。
インデックス登録のリクエストで解決しますか?
優先度の高い数件の URL には役立つことがあります。Googleにページをキューに入れるよう依頼するものだからです。ただし原因は取り除かないため、ページが同じステータスに戻る可能性があります。リクエストには1日あたりの割り当てがあり、Googleは同じ URL を何度送っても何も早まらないとしています。内部リンクを改善した後で使い、一括処理のツールとしては決して使わないでください。
ペナルティですか?
**いいえ。**手動による対策は専用のレポートに表示されます。このステータスは、Googleが URL を見つけたもののまだクロールしておらず、ページを評価していないという意味です。原因は通常クロールの優先度で、内部リンクが弱い、サーバーが遅い、価値の低い URL が大量にクロールを奪い合っている、などです。
なぜこんなに多くのページが検出済みでも未登録なのですか?
数が多い場合、通常は個々のページではなくパターンを示しています。URL パラメータやファセット、重複、載せるべきでない URL を含むサイトマップ、セクション全体への弱い内部リンク、Googlebot を遅らせるサーバーなどです。個別に見る前に、フォルダ、言語、テンプレートで URL をグループ化してください。
小規模サイトでも心配すべきですか?
通常は不要です。Googleは、サイトが500ページ未満であれば、ページのインデックス登録レポートはおそらく必要ないとしています。このステータスの新しい URL が少数あっても、たいていは時間と、Googleがすでにクロールしているページからのいくつかの内部リンクがあれば足ります。
SEOcrawl AI は検出された URL にどう役立ちますか?
SEOcrawl AI のインデックスビューは、Googleの各カバレッジ状態で止まっている URL を、最終クロール日、クリック数、表示回数とともに一覧にします。SEOcrawl AI MCP を使えば、Claude や ChatGPT に、Googleの canonical と宣言された canonical の比較、そしてGoogleが各 URL をサイトマップと参照元ページのどちらで見つけたかを付けて、フォルダごとにグループ化した一覧を出してもらうこともできます。
Google で SEOcrawl AI をもっと見る
優先ソースに選ぶと、Google のトップニュースで私たちの記事が表示されやすくなります。
著者: David Kaufmann
私はこの10年以上、SEOに完全に夢中になって過ごしてきました。正直なところ、他の生き方は考えられません。
私のキャリアが新たな次元に到達したのは、Chess.com でシニアSEOスペシャリストとして働いたときでした。Chess.com はインターネット全体で最も訪問数の多い上位100サイトの1つです。数百万ページ、数十言語、そして最も競争の激しい SERPs の1つという規模で仕事をした経験は、どんなコースや資格でも得られないことを教えてくれました。あの経験は、本当に優れたSEOとは何かという私の視点を一変させ、それ以降に私が築いてきたすべての土台となりました。
その経験から、私は SEO Alive を創業しました。オーガニック成長に本気で取り組むブランドのためのエージェンシーです。私たちは dashboards や月次レポートを売るためにここにいるのではありません。本当に成果を動かす戦略を構築するためにここにいます。クラシカルなSEOの最良の部分と、Generative Engine Optimization (GEO) というエキサイティングな新しい世界を組み合わせ、あなたのブランドが Google の青いリンクだけでなく、ChatGPT、Perplexity、Google AI Overviews が毎日何百万人もの人々に届けている AI 生成の回答の中にも確実に表示されるようにします。
そして、この両方の世界をきちんと扱えるツールが見つからなかったので、自分で作りました。それが SEOcrawl AI です。rankings、テクニカル監査、backlinks モニタリング、crawl ヘルス、そして AI ブランド可視性トラッキングを1つの場所に統合した、エンタープライズ向けのSEOインテリジェンスプラットフォームです。まさに、ずっと存在してほしいと願っていたプラットフォームです。
この著者の他のコンテンツをご覧ください