


«Opdaget – ikke indekseret i øjeblikket»: hvad det betyder, og hvordan du løser det
Google ved, at din URL findes, men har ikke besøgt den endnu. Sådan afgør du, om du skal vente eller handle, og hvilke rettelser du prøver først på et lille og et stort website.
Opdaget – ikke indekseret i øjeblikket betyder, at Google har fundet URL'en, men endnu ikke har crawlet den. Sådan beskriver Googles hjælp til rapporten Sideindeksering det. Normalt ville Google crawle og udsatte det for ikke at overbelaste dit website, og derfor er datoen for sidste crawl tom i rapporten.
Det er en status om crawlprioritet, ikke en dom over dit indhold, fordi Google ikke har læst siden endnu. Nedenfor kan du se, hvordan den adskiller sig fra «Crawlet», hvad vi fandt, da vi tjekkede vores eget website, og en liste over rettelser sorteret efter websitets størrelse. Er du ny i rapporten? Start med denne guide til Google Search Console.
Hvad «Opdaget – ikke indekseret i øjeblikket» betyder
Google fører en URL gennem fire trin: finde, crawle, indeksere og derefter eventuelt vise i resultaterne. To Search Console-statusser beskriver en URL, der er gået i stå undervejs.
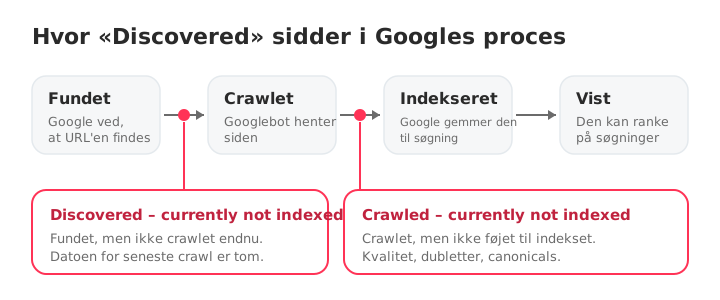
En URL når til «fundet» via dit sitemap eller via links fra andre sider. Derefter beslutter Google, hvornår den skal crawles. «Opdaget» betyder, at den beslutning endnu ikke er truffet.
Forskellen fra «Crawlet – ikke indekseret i øjeblikket»
De to statusser ligner hinanden og kræver forskellige rettelser.
| Opdaget – ikke indekseret i øjeblikket | Crawlet – ikke indekseret i øjeblikket | |
|---|---|---|
| Crawlet af Google? | Nej | Ja |
| Dato for sidste crawl | Tom | En dato |
| Har Google læst siden? | Nej | Ja |
| Sædvanlig årsag | Crawl udsat eller lav prioritet | Google læste siden og valgte den fra |
| Se først på | Interne links, sitemap, crawlkapacitet | Indholdets kvalitet, dubletter, canonicals |
Den fulde diagnose af den anden status finder du i guiden til Crawlet – ikke indekseret i øjeblikket.
Sådan ser listen ud på et rigtigt website
Vi tjekkede seocrawl.ai i SEOcrawls Indekseringsrapport. Af de 1.000 URL'er, som SEOcrawl overvåger (vores sitemap angiver 6.310), er 823 indekseret, altså 82,3 %. 128 står i «Crawlet – ikke indekseret i øjeblikket» og 14 i «Opdaget – ikke indekseret i øjeblikket».
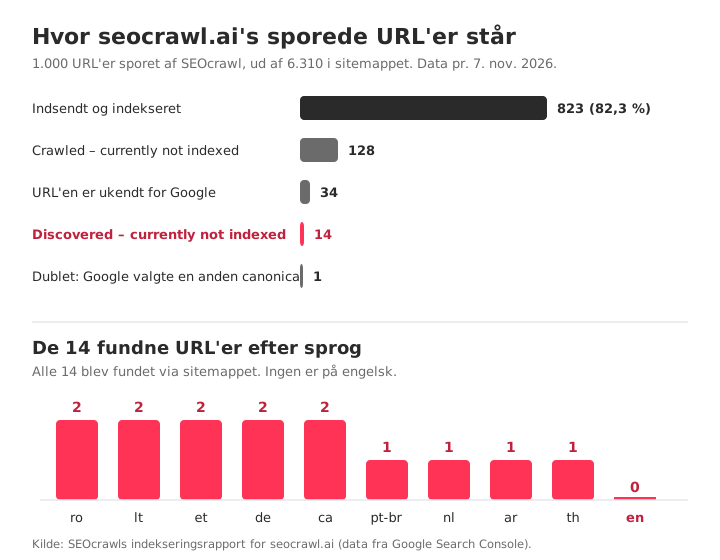
Det, de 14 har til fælles, er den nyttige del:
- Alle er oversatte sider: arabisk, catalansk, tysk, estisk, litauisk, hollandsk, brasiliansk portugisisk, rumænsk og thai. Ingen er på engelsk.
- Google fandt alle 14 via sitemappet og ikke via et link fra en anden side.
- Én af dem viser en tidligere crawldato (9. maj 2026), så statussen beskriver, hvor URL'en står nu, ikke at Google aldrig har besøgt den.
Det er et mønster, der skal tjekkes, ikke en diagnose. En side, der findes på 26 sprog og hovedsageligt nås via sitemappet, er en naturlig kandidat til svage interne links, så interne links er det første, du bør se på. Lektien gælder for ethvert website: læs ikke listen URL for URL. Grupperet efter sprog blev 14 URL'er til ét spørgsmål.
Tallene dækker de 1.000 URL'er, SEOcrawl overvåger, en stikprøve af hele sitemappet. Den større gruppe på 128 URL'er er den anden status og har sin egen guide.
Hvorfor Google udsætter et crawl
Googles guide til crawlbudget forklarer, hvordan Google beslutter, hvor meget der skal crawles: en kapacitetsgrænse, som din server kan klare, og efterspørgslen efter dine URL'er. De fleste opdagede URL'er kan føres tilbage til en af disse fem årsager.
- Crawlkapacitet. Google siger, at grænsen falder, når dit website bliver langsomt eller returnerer serverfejl. En langsom server giver færre crawls.
- Lav crawlefterspørgsel. Efterspørgslen afhænger af websitets størrelse, hvor ofte det opdateres, og sidernes kvalitet og relevans. En URL med få eller ingen interne links giver Google lidt grund til at vende hurtigt tilbage.
- Spildt crawl. Dublerede URL'er, parametre, facetter, lange redirectkæder og soft 404 konkurrerer med dine rigtige sider. Google bemærker, at soft 404 bliver ved med at blive crawlet og spilder budget, og at Google stadig anmoder om en side med noindex, før den droppes.
- Kun fundet via sitemap. Et sitemap fortæller Google, at en URL findes. Det gør den ikke til en prioritet, og Google behandler sitemappet som et hint. Sider, der kun findes dér, er de første, der må vente.
- Et nyt website eller en ny sektion. Alle websites starter med den samme forsigtige standardkapacitet, som vokser, i takt med at websitet viser sig sundt.
Selve crawlbudgettet fortjener kun din opmærksomhed på meget store websites. Googles grove skøn: 1.000.000+ unikke sider, der opdateres omtrent ugentligt, eller 10.000+ sider, der ændres dagligt. På mindre websites er årsag 2 og 4 langt mere almindelige.
Er det et problem? Tre spørgsmål, før du retter noget
- Skal denne URL overhovedet indekseres? Hvis det er en filtreret visning, en intern søgeside eller en test-URL, er det normalt, at den mangler. For at gøre det eksplicit kan du bruge noindex eller returnere 404 eller 410 (se Excluded by 'noindex' tag).
- Hvor mange URL'er, og med hvilket mønster? Google siger, at du ved under 500 sider sandsynligvis ikke engang har brug for denne rapport. Listen er desuden begrænset til 1.000 rækker, så på et stort website er den en stikprøve.
- Er de nye? En URL udgivet i sidste uge er endnu ikke et problem. Googles egne tidsrammer står i tabellen nedenfor.
Sådan retter du det, afhængigt af websitets størrelse
Den rigtige første handling afhænger af dit websites størrelse, så start i den rette kolonne.
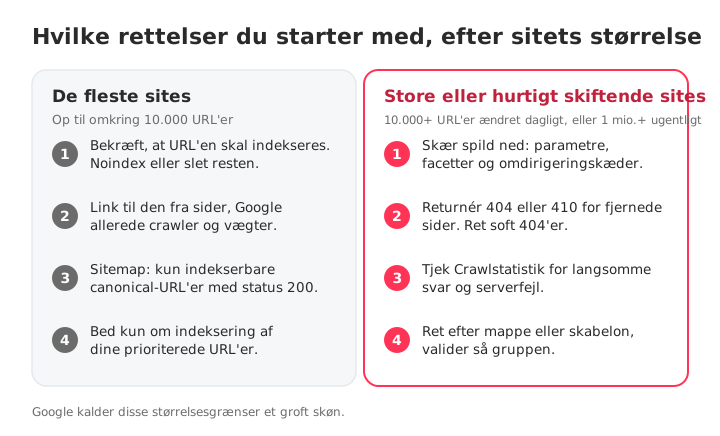
De fleste websites: op til cirka 10.000 URL'er
- Bekræft, at URL'en fortjener indeksering. Hvis ikke, så brug noindex eller fjern den og tag den af din liste.
- Link fra sider, som Google allerede crawler. Tilføj kontekstuelle links med beskrivende ankertekst fra indekserede sider, der får trafik. Enhver crawler viser dine forældreløse sider ved at filtrere dem uden interne links, og denne guide til intern linking har hele metoden.
- Hold sitemappet rent. Medtag kun URL'er, der returnerer 200, er indekserbare og er den kanoniske version, med en korrekt
lastmod. Google ignorerer priority og changefreq. Hvis du først skal bruge filen, så find dit sitemap. Hvis Search Console siger, at den ikke finder noget, så se No referring sitemaps detected. - Anmod om indeksering af nogle få prioriterede URL'er. Åbn URL-inspektionsværktøjet, og klik på Anmod om indeksering. Google anvender en kvote og siger, at gentagne anmodninger ikke fremskynder noget, så gem det til de sider, der betyder mest.
Store eller hurtigt skiftende websites: 10.000+ URL'er ændret om dagen eller 1 mio.+ om ugen
- Reducer spildt crawl. Bloker i robots.txt de URL-områder uden søgeværdi (parametre, facetter, intern søgning), og saml dubletter med canonicals og 301-redirects. Regn ikke med noindex for at spare budget: Google bliver ved med at anmode om de sider.
- Returnér 404 eller 410 for fjernede sider, og ret soft 404. Google kalder 404 et stærkt signal om ikke at crawle URL'en igen, mens blokerede URL'er bliver længere i køen. Forkort enhver lang redirectkæde.
- Tjek crawlstatistikken. Under Indstillinger viser rapporten Crawlstatistik svartider og serverfejl. Hvis de er høje, sænker Google din kapacitetsgrænse, og ingen indholdsrettelse hjælper, før serveren bliver bedre.
- Ret pr. mappe eller skabelon, og valider derefter gruppen. Tag én beslutning pr. mønster, opret et sitemap kun med de rettede URL'er, og klik på Valider rettelse. Læs mere om crawlbudget, hvis dit website hører til i denne kategori.
Vente eller handle?
Det sværeste er ikke rettelsen, men at vide, hvornår man skal holde op med at vente. Brug Googles egne intervaller og din egen tendens.
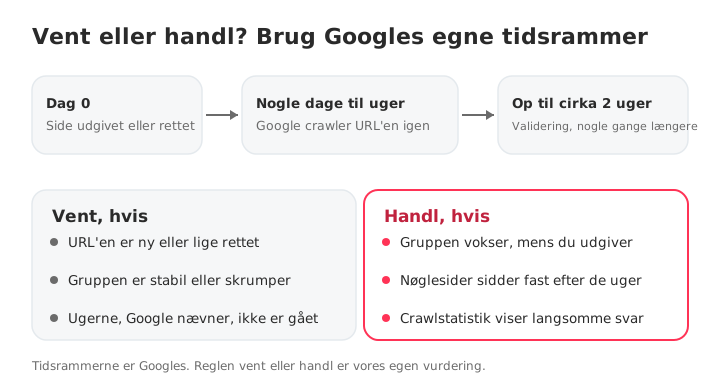
| Hvad du gjorde | Hvad Google siger | Kilde |
|---|---|---|
| Bad Google om at crawle igen | Fra nogle dage til nogle uger | Bed Google om at crawle igen |
| Anmodede om indeksering | Normalt omkring en dag, op til en eller to uger, med daglig kvote | Hjælp til URL-inspektion |
| Validerede rettelsen | Op til cirka to uger, nogle gange meget længere | Hjælp til Sideindeksering |
Tidsintervallerne kommer fra Google. Reglen om at vente eller handle er vores: vent, så længe URL'en er ny, og gruppen er stabil eller skrumper, og handl, når gruppen bliver ved med at vokse, eller dine nøglesider sidder fast efter de uger.
Sådan følger du det over tid
Search Console viser den seneste tilstand for hver URL og en liste begrænset til 1.000 rækker, så byg din egen rutine:
- Eksportér listen én gang om måneden, og sammenlign med den forrige. Vokser gruppen, er den stabil, eller skrumper den?
- Grupper efter mønster (sprog, mappe, skabelon), før du ser på enkelte URL'er.
- Se, hvordan Google fandt hver URL. En liste, der kun siger «sitemap» og aldrig «henvisende side», som vores 14 URL'er, peger direkte på interne links.
Visningen Indeksering i SEOcrawl AI leverer den liste færdig: filtrér efter dækningstilstand for at se URL'erne i den, med dato for sidste crawl, klik og visninger. Via MCP kommer hver URL også med Googles valgte canonical over for den angivne og om den blev fundet via sitemappet eller en henvisende side. Crawleren auditerer dine egne sider, så du kan se, hvad der er svagt ved en URL, før du beder Google kigge igen, og SEO Monitor advarer, når en nøgleside får noindex, skifter canonical, returnerer 404 eller forsvinder fra sitemappet.
Her er den liste for vores eget website, direkte fra visningen Indeksering:
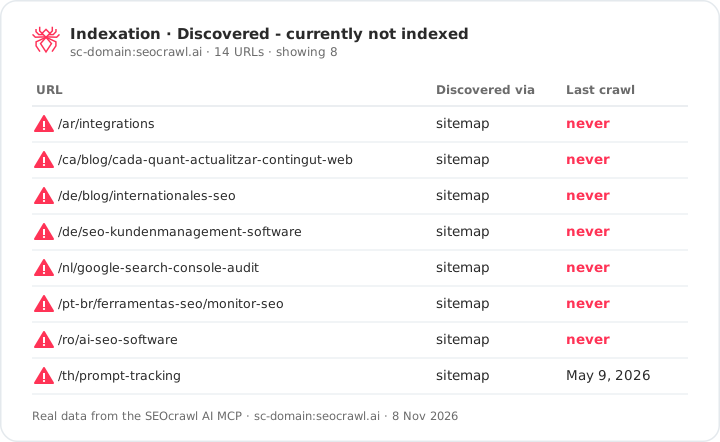
Du kan også springe dashboardet over. Med SEOcrawl AI MCP forbundet til Claude eller ChatGPT kan du spørge: «Vis URL'erne i Opdaget – ikke indekseret i øjeblikket, og grupper dem efter mappe.» Her er trin-for-trin-guiden til at forbinde Search Console med Claude og ChatGPT.
Ofte stillede spørgsmål
Hvad betyder «Opdaget – ikke indekseret i øjeblikket»?
Det betyder, at Google har fundet din URL, men endnu ikke har crawlet den. Normalt ville Google crawle og udsatte det, og derfor er datoen for sidste crawl tom (hjælp til Sideindeksering). Google har ikke læst siden, så statussen siger intet om dens kvalitet. Det er ikke en straf.
Hvor længe varer «Opdaget – ikke indekseret i øjeblikket»?
Google offentliggør ikke en tidsfrist for denne status. Google siger, at et anmodet nyt crawl tager fra nogle dage til nogle uger, og at validering af en rettelse tager op til cirka to uger, nogle gange meget længere. En ny URL kan simpelthen have brug for de uger. Hvis gruppen bliver ved med at vokse, efterhånden som du udgiver, skal du holde op med at vente og handle.
Løser det problemet at anmode om indeksering?
Det kan hjælpe på nogle få prioriterede URL'er, fordi det beder Google sætte siden i kø. Det fjerner ikke årsagen, så siden kan vende tilbage til samme status. Anmodninger er underlagt en daglig kvote, og Google siger, at det ikke fremskynder noget at indsende den samme URL flere gange. Brug det efter at have forbedret de interne links, aldrig som masseværktøj.
Er det en straf?
Nej. Manuelle handlinger står i en separat rapport. Denne status betyder, at Google har fundet URL'en og endnu ikke har crawlet den, så siden er ikke vurderet. Årsagen er som regel crawlprioritet: svage interne links, en langsom server eller en masse URL'er med lav værdi, der konkurrerer om crawls.
Hvorfor er så mange af mine sider opdaget, men ikke indekseret?
Et højt tal peger normalt på et mønster og ikke på enkeltsider: URL-parametre eller facetter, dubletter, et sitemap med URL'er, der ikke hører hjemme, svage interne links til en hel sektion eller en server, der bremser Googlebot. Grupper URL'erne efter mappe, sprog eller skabelon, før du ser på nogen af dem alene.
Skal jeg være bekymret på et lille website?
Normalt ikke. Google siger, at hvis dit website har under 500 sider, har du sandsynligvis ikke engang brug for rapporten Sideindeksering. Nogle få nye URL'er i denne status har oftest brug for tid og et par interne links fra sider, Google allerede crawler.
Hvordan kan SEOcrawl AI hjælpe med opdagede URL'er?
Visningen Indeksering i SEOcrawl AI viser de URL'er, der sidder fast i hver af Googles dækningstilstande, med dato for sidste crawl, klik og visninger. Via SEOcrawl AI MCP kan du også bede Claude eller ChatGPT om den liste med Googles canonical over for den angivne og om Google fandt hver URL via sitemappet eller en henvisende side, og få den grupperet efter mappe.
Mere SEOcrawl AI på Google
Vælg os som foretrukken kilde, og se flere af vores artikler i Googles tophistorier.
Forfatter: David Kaufmann
Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter
Vi har målt klik fra Google og henvisningstrafik fra AI på over 16.000 websites i 15 brancher. AI-trafikken vokser med 45 % om året, men svarer stadig kun til omkring 1 besøg for hver 100 fra Google, mens klikkene fra Google faldt med 15 %.

Frem til 30. november koster det første år af ethvert årligt SEOcrawl AI-abonnement det halve med koden BLACKFRIDAY2026. Det får du, hvad promptsene i hvert abonnement dækker, og hvordan du på 15 minutter ser, hvor ChatGPT, Gemini, Claude og Perplexity nævner dig.