Crawled – currently not indexed: hvad det betyder, og hvordan du løser det

Google har besøgt din URL, læst den og ladet den være uden for søgningen. Her ser du, hvilke sider der fortjener en ny chance, og hvordan Google siger, du får dem indekseret.
Crawled – currently not indexed (crawlet, men i øjeblikket ikke indekseret) betyder, at Googlebot har hentet din side og besluttet ikke at føje den til Googles indeks, så den ikke kan vises i søgningen. Googles hjælp til rapporten Sideindeksering siger det sådan: Siden er crawlet, men ikke indekseret, og den "bliver måske indekseret i fremtiden, måske ikke".
Årsagen er som regel siden selv, ikke en teknisk blokering. Herunder ser du, hvordan du URL for URL beslutter, om en side skal rettes, sættes på noindex eller slettes, og hvor lang tid en rettelse ifølge Google tager. Ny i rapporten? Start med denne guide til Google Search Console.
Hvad betyder "Crawled – currently not indexed"?
Statussen betyder, at Google har crawlet siden og valgt ikke at indeksere den. Intet blokerede Googlebot: Google besluttede at lade siden være ude indtil videre. To skel hjælper dig med at læse statussen rigtigt.
Crawlet vs. indekseret
Crawling er, når Googlebot downloader en side. Indeksering er, når Google gemmer den, så den kan vises i søgninger. En side kan blive crawlet mange gange og alligevel aldrig blive indekseret.
Hjælpen til værktøjet URL Inspection siger, at en sides kvalitet skal være "høj nok til at berettige indeksering", og at livetesten slet ikke kan tjekke for denne status.
Sådan adskiller den sig fra "Discovered – currently not indexed"
Discovered – currently not indexed (fundet, men i øjeblikket ikke indekseret) kommer et trin tidligere: Google har fundet URL'en, men udskudt crawlet for ikke at overbelaste dit website, så datoen for seneste crawl er tom.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Crawlet af Google? | Nej | Ja |
| Dato for seneste crawl | Tom | En dato |
| Typisk årsag | Crawl udskudt for ikke at overbelaste websitet | Google læste siden og sprang den over |
| Se først på | Crawlkapacitet, på meget store websites | Indholdskvalitet, dubletter, canonicals |
Google siger også: "Ikke indekseret er ikke nødvendigvis dårligt." Sider med noindex, URL'er blokeret i robots.txt, dubletter og 404'er uden erstatning skal blive ude.
Hvorfor Google crawler sider uden at indeksere dem
Indeksering har en kvalitetsbarre, som crawling ikke har. Googles guide til crawlbudget siger, at crawlbehovet stiger med værdien og det unikke i dit indhold.
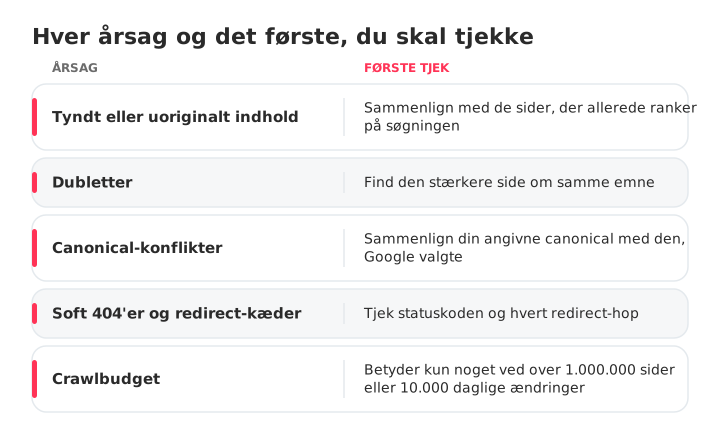
De fleste berørte URL'er falder ind under en af disse årsager, hver med sit første tjek:
- Tyndt eller uoriginalt indhold: siden gentager det, der allerede ranker.
- Dubletter: tag-arkiver, sorterede URL'er, to indlæg om samme emne. Sådan finder og løser du keyword-kannibalisering.
- Canonical-konflikter: sammenlign din angivne canonical med den, Google har valgt. Når Google vælger en anden URL, flytter siden som regel til Alternate page with proper canonical tag eller en dubletstatus.
- Soft 404'er og redirect-kæder: ifølge Google spilder soft 404'er crawlbudget.
- Crawlbudget: det betyder noget for websites med over 1.000.000 sider, der ændres ugentligt, eller over 10.000, der ændres dagligt. For de fleste websites er det ikke årsagen.
Barren er hævet i to daterede trin. Den 18. august 2022 annoncerede Google helpful content-opdateringen, et signal for hele websitet, og sagde, at det at fjerne uhjælpsomt indhold kunne hjælpe resten af et website. Den 5. marts 2024 annoncerede Google en core update, der skulle vise mindre indhold lavet for at tiltrække klik, sammen med en ny spampolitik mod misbrug af indhold i stor skala.
Googles vejledning om hjælpsomt indhold siger, at E-E-A-T ikke er en specifik rankingfaktor, at troværdighed vejer tungest, og at der ikke findes et foretrukket antal ord. Det hjælper ikke at fylde en side ud.
Sådan finder og diagnosticerer du berørte sider i GSC
Åbn rapporten Sideindeksering (tidligere Dækning), inspicér et udsnit, og gruppér listen efter mønster. Google bemærker, at websites med under 500 sider sandsynligvis ikke har brug for rapporten.
Find berørte URL'er i rapporten Sider
- Gå til Indeksering › Sider i Google Search Console.
- Klik på Crawled – currently not indexed under "Hvorfor sider ikke indekseres".
- Klik på Eksportér, og download listen.
Rapporten viser op til 1.000 eksempel-URL'er, ikke nødvendigvis dem alle, så på et stort website er eksporten et udsnit.
Tjek siderne med værktøjet URL Inspection
Inspicér fem til ti eksporterede URL'er for datoen for seneste crawl og Google-selected canonical (den canonical, Google har valgt). En canonical, der peger et andet sted hen, betyder, at Google ser en dublet; en crawldato, der er flere måneder gammel, tyder på, at Google sjældent kommer tilbage.
Find mønstre på tværs af hundredvis af URL'er
Sortér eksporten efter mappe, skabelon og URL-parameter, og tæl hver gruppe. Lad os sige, at 300 URL'er fordeler sig på 180 /tag/-sider, 70 ?sort=-URL'er og 50 indlæg: Det er tre beslutninger, ikke 300.
Ret, noindex eller slet: beslut, hvad hver URL fortjener
Hver URL fortjener ét af fire udfald. Spørg dig selv: Ville en søgende være glad for at lande her, og er dette den eneste side på dit website, der besvarer søgningen?
| Sidetype | Eksempel | Beslutning | Hvordan |
|---|---|---|---|
| Nyttig og unik, men tynd | En guide på 300 ord om et emne, du kender | Forbedr | Tilføj dybde og detaljer fra egen erfaring |
| Dublet af en stærkere side | To indlæg om samme søgning | Flet | Flyt indholdet, og lav derefter en 301-redirect |
| Nyttig på websitet, ikke i søgningen | Tag-arkiver, intern søgning, takkesider | Noindex | Robots-metatag eller X-Robots-Tag |
| Ingen værdi, ingen erstatning | Udløbne kampagner, testsider | Slet | Returnér en 404 eller 410 |
Googles guide til crawlbudget bakker de to sidste rækker op: Returnér 404 eller 410 for fjernede sider, og saml dubletter. En 404 i Search Console er forventet for sider, du har fjernet med vilje.
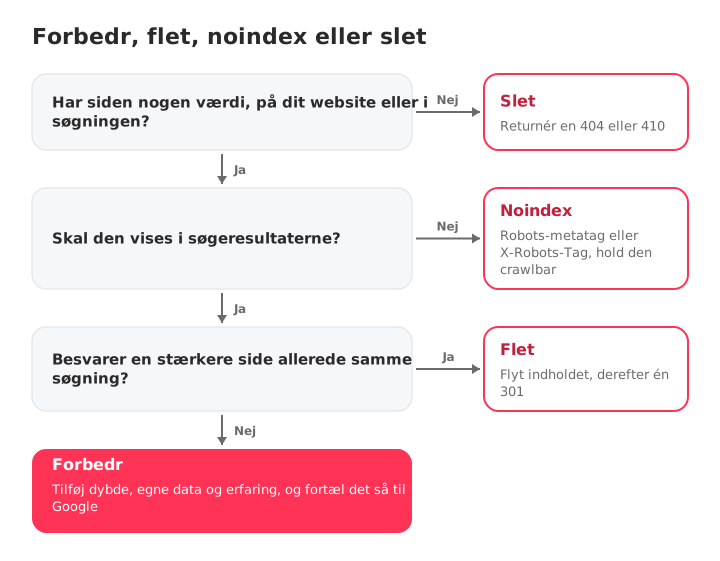
Det er ved noindex, at sorteringen oftest går galt:
Ikke sådan: et noindex-tag på dine /tag/-sider, mens robots.txt blokerer /tag/. Googlebot kan ikke hente siderne, så den ser aldrig tagget.
Sådan: /tag/ forbliver crawlbar og har noindex som metatag eller X-Robots-Tag-header.
Ifølge Googles dokumentation om noindex virker reglen ikke i robots.txt, og på sjældent besøgte sider kan den nye crawl tage måneder. Når tagget er læst, flytter de URL'er til Excluded by 'noindex' tag, og det er netop det, du vil have for dem.
Sådan retter du de sider, der fortjener at blive indekseret
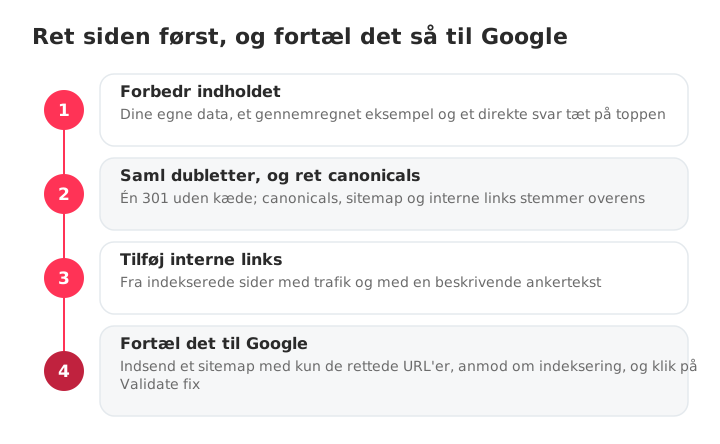
Gør først siden værd at indeksere, og fortæl det derefter til Google. At anmode om indeksering af en uændret side beder Google om at gentage en beslutning, den allerede har truffet. Rækkefølgen:
- Forbedr indholdet.
- Saml dubletter, og ret canonicals.
- Tilføj interne links.
- Indsend et fokuseret sitemap, og anmod om indeksering.
Forbedr indholdets dybde og originalitet
Skriv om med udgangspunkt i søgningen, ikke et antal ord: tilføj dine egne data, skærmbilleder, et gennemregnet eksempel og et direkte svar tæt på toppen.
Tag for eksempel en tynd guide på 300 ord: tilføj et datasæt fra egen hånd og et gennemregnet eksempel, link til den fra to indlæg, der allerede får trafik, og føj den først derefter til et fokuseret sitemap.
Saml dubletter, og ret canonicals
Når to URL'er dækker det samme, så behold den ene, flyt det nyttige indhold over i den, og lav en 301-redirect fra den anden direkte til den, uden kæde. Tjek derefter, at canonicals, sitemap og interne links stemmer overens, og at der ikke er et overset noindex tilbage.
Tilføj interne links fra sider, Google allerede værdsætter
Link til hver rettet side fra indekserede sider med trafik og med en beskrivende ankertekst. Enhver website-crawler kan liste forældreløse sider (nul interne links) ved at filtrere på nul indgående links. Hele metoden finder du i denne guide til intern linkstrategi.
Tjek også siden på en telefon og i Core Web Vitals-rapporten: En defekt mobilside er hurtig at udelukke.
Indsend et fokuseret sitemap, og anmod om indeksering
Lav et sitemap med kun de URL'er, du har rettet, indsend det, og filtrér rapporten Sider efter det, før du klikker på Validate fix. Google foreslår det for at gøre valideringen hurtigere. Hvis du først skal bruge din nuværende fil, så find dit websites sitemap.
Google ignorerer priority og changefreq, så hold i stedet lastmod præcis. Klik derefter på Request indexing i værktøjet URL Inspection for dine prioriterede URL'er: Google anvender en kvote og siger, at gentagne anmodninger ikke gør noget hurtigere.
Hvor lang tid tager indeksering efter en rettelse?
Regn med en dag til flere uger, og indeksering er aldrig garanteret. Google angiver forskellige tidsrum på forskellige sider, så her står de side om side:
| Hvad du gjorde | Hvad Google siger | Kilde |
|---|---|---|
| Bad Google om at crawle igen | Få dage til få uger | Bed Google om at crawle igen |
| Request indexing | Typisk cirka en dag, op til en til to uger, med en daglig grænse | Hjælp til URL Inspection |
| Validate fix | Op til cirka to uger, nogle gange meget længere | Hjælp til Sideindeksering |
Det er Googles tidsrammer, ikke eksempler på genopretning. Tjek rapporten Sider hver uge; hvis rettede URL'er ikke har flyttet sig, når de tidsrum er gået, så gå tilbage til indholdet.
Sådan undgår du, at nye sider havner i denne status
Forebyggelse er en rutine: tjek hver side, før den går live, og gennemgå Search Console hver måned. Før du udgiver, så bekræft, at siden:
- Besvarer en søgning, som ingen anden side på dit website besvarer.
- Tilføjer dine egne data, eksempler eller erfaringer.
- Har en selvrefererende canonical og intet overset noindex.
- Står i sitemappet med en præcis lastmod.
- Har en navngiven forfatter og, hvor det er relevant, strukturerede data.
- Får et link fra en relateret, indekseret side.
Sammenlign en gang om måneden rapporten Sider med måneden før; et problem bliver stående på listen i 90 dage, efter at det sidste tilfælde er væk. Websites med over tusind sider bør også holde øje med Crawl Stats-rapporten (crawlstatistik).
SEOcrawl AI klarer den tekniske side i stor skala. Crawleren scanner hver side og giver en Audit Health Score med problemer fordelt på Indexability, Crawlability, On-Page og mere. Visningen Indexation grupperer dine URL'er efter dækningsstatus i Search Console, så du kan se, hvor mange der står under "Crawled – currently not indexed", og følge tallet over tid.
Mellem crawls advarer SEO Monitor dig, når en vigtig side får et noindex, skifter canonical, returnerer en 404 eller forsvinder fra sitemappet. Den samme platform følger dit brands synlighed i ChatGPT, Claude, Gemini, Perplexity og Copilot, så SEO og GEO samles ét sted.
Ofte stillede spørgsmål
Hvad betyder "Crawled – currently not indexed"?
Det betyder, at Googlebot har hentet din side og besluttet ikke at føje den til Googles indeks, så den ikke kan vises i søgningen. Intet blokerede crawlet: Google læste siden og valgte at lade den være ude indtil videre. Det er ikke en manuel handling, og siden bliver måske indekseret i fremtiden, måske ikke.
Er det det samme som "Discovered – currently not indexed"?
Nej. "Discovered" betyder, at Google kender URL'en, men har udskudt crawlet, så datoen for seneste crawl er tom. "Crawled" betyder, at Google allerede har besøgt og læst siden og derefter besluttet ikke at indeksere den. Ved Discovered skal du se på crawlkapaciteten på meget store websites; ved Crawled på indholdskvalitet, dubletter og canonicals.
Skader "Crawled – currently not indexed" min SEO?
Ikke i sig selv: statussen er ikke en straf, og den berørte side mister kun sin egen søgetrafik. Risikoen ligger i mængden, fordi Google behandler en stor andel uhjælpsomt indhold som et signal for hele websitet. Et tag-arkiv uden for indekset koster ingenting; en produktside gør. Hvis tallet stiger, hver gang du udgiver, så behandl det som et indholdsproblem for hele websitet, ikke som en liste over enkelte URL'er.
Hvor lang tid tager det, før en side bliver indekseret efter en rettelse?
Regn med alt fra en dag til flere uger, og indeksering er aldrig garanteret. Ifølge Google tager en ny crawl fra få dage til få uger, en Request indexing behandles typisk inden for cirka en dag, men kan tage en til to uger, og en Validate fix tager som regel op til cirka to uger.
Hjælper det at anmode om indeksering?
Kun efter at du har ændret siden. At anmode om indeksering af en uændret side beder Google om at gentage en beslutning, den allerede har truffet. Anmodninger er underlagt en daglig kvote, og Google siger, at det ikke går hurtigere af at sende den samme URL flere gange.
Hjælper det at tilføje siden til mit XML-sitemap?
Det hjælper Google med at finde en URL, ikke med at indeksere den. Google kalder et indsendt sitemap "blot et hint", og disse sider er allerede fundet og læst. Efter en rettelse er sitemappets opgave at samle de URL'er, du vil have tjekket igen. Hver sitemapfil kan rumme op til 50.000 URL'er eller 50 MB.
Hvorfor fejlede min validering af "Crawled – currently not indexed"?
Valideringen stopper, så snart Google finder én URL i gruppen, der stadig ikke er rettet, så en enkelt overset side kan få hele batchen til at fejle. Ret alle URL'er i gruppen, eller gør gruppen mindre ved at filtrere rapporten med et sitemap, der kun indeholder dine rettede URL'er, og validér derefter igen.
Hvordan kan SEOcrawl AI hjælpe med sider, som Google crawler, men ikke indekserer?
SEOcrawl AI finder årsagerne på dit eget website bag statussen. Crawleren viser hver URL's health score, HTTP-statuskode og crawldybde, så du kan se sider, som Google har svært ved at nå. Visningen Indexation grupperer dine URL'er efter dækningsstatus i Search Console, og SEO Monitor advarer dig, når en vigtig side får et noindex, skifter canonical, returnerer en 404 eller forsvinder fra sitemappet.
Forfatter: David Kaufmann

Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter

En produktlisteside (PLP) viser en hel produktkategori på én gang. Lær, hvordan den adskiller sig fra en PDP, hvad der får den til at konvertere, og hvordan du får listesider indekseret uden rodet fra facetteret navigation.

Domain Authority forudsiger, hvor godt et website vil ranke, men det er ikke en rankingfaktor hos Google. Her kan du se, hvad DA faktisk måler, hvordan det adskiller sig fra DR og Authority Score, og hvilke tal du hellere skal holde øje med.