Excluded by 'noindex' tag: hvad det betyder, og hvordan du løser det
Du åbnede Google Search Console, så en række URL'er markeret med "Excluded by 'noindex' tag", og nu er de sider usynlige i søgningen.
Hvis du har fundet en række URL'er med statussen "Excluded by 'noindex' tag" i Google Search Console, bliver dine sider bevidst holdt ude af Googles indeks, og løsningen er som regel enklere, end den ser ud: find direktivet, fjern det, og bed Google om at crawle igen.
Denne guide forklarer præcis, hvad der udløser statussen, hvordan du finder det noindex-direktiv, der står bag, og de præcise trin til at fjerne det i alle de store CMS'er, så dine sider kan ranke igen. Det samme tjek kører automatisk i SEOcrawl AI's Crawler, som markerer noindex-direktiver på hele dit website uden at tjekke URL for URL.
Hvad betyder "Excluded by 'noindex' tag" i Google Search Console?
Statussen "Excluded by 'noindex' tag" betyder, at Googlebot har crawlet din side, fundet et noindex-direktiv og respekteret det ved at holde siden ude af Googles indeks. Din side vises ikke i søgeresultaterne, så længe direktivet er der.
Hvor statussen vises i GSC
I den gamle Dækningsrapport (erstattet af rapporten Sideindeksering i 2022) stod statussen under "Ekskluderet". I den nuværende Sideindeksering-rapport (Indeksering › Sider) finder du den under "Ikke indekseret" i tabellen "Hvorfor sider ikke indekseres" med årsagen "Excluded by 'noindex' tag". Google samler alle berørte URL'er under denne etiket, så du kan eksportere og gennemgå dem samlet.
Hvordan Google finder og respekterer noindex-direktivet
Googles dokumentation om at blokere indeksering med noindex beskriver to måder at levere det på: et <meta name="robots" content="noindex">-tag i sidens HTML-<head> eller et X-Robots-Tag: noindex-direktiv i HTTP-svarheaderne. Når Googlebot støder på en af dem, fjerner den siden helt fra indekset, også selvom siden var indekseret før. Det grundlæggende om selve tagget finder du i vores guide til noindex-metatagget.
Er det altid et problem? Når udelukkelsen er tilsigtet
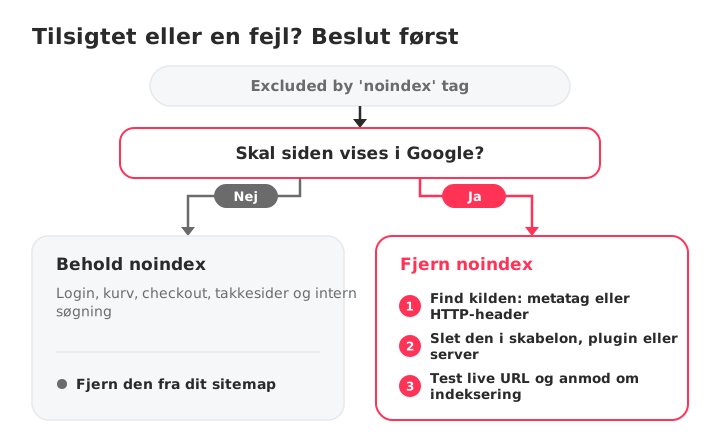
Ikke alle URL'er med "Excluded by 'noindex' tag" er en fejl. Adminsider, loginsider, kurv og checkout, takkesider og interne søgeresultater holdes bevidst ude af Googles indeks. Hvis de sider har statussen, fungerer systemet efter hensigten. Det reelle problem opstår, når sider, du gerne vil have til at ranke, får etiketten.
Almindelige årsager til statussen "Excluded by 'noindex' tag"
Et noindex-direktiv kan nå din side ad flere forskellige veje. Hvilken der er aktiv på dit website, afgør løsningen.
Robots-metatag med "noindex" i <head>
Den mest almindelige kilde. En linje som <meta name="robots" content="noindex"> i sidens HTML fortæller Googlebot, at siden ikke må indekseres. Den kan være hardcodet i skabelonen eller indsat dynamisk af et CMS, et plugin eller en temafunktion.
X-Robots-Tag i HTTP-svarheadere
X-Robots-Tag virker præcis som metatagget, men ligger i HTTP-svarheaderen i stedet for i HTML'en. Serverkonfigurationer, CDN-regler eller .htaccess-direktiver kan tilføje den. For eksempel:
Header set X-Robots-Tag "noindex"
Det påvirker alle filer, der matcher reglen, også PDF'er og billeder, som ikke har en HTML-<head>-sektion. Mange websiteejere overser denne vej helt, fordi direktivet ikke er synligt i sidens kildekode.
CMS-indstillinger, der ved en fejl blokerer indeksering
WordPress har et afkrydsningsfelt under Indstillinger › Læsning, der hedder "Discourage search engines from indexing this site". Når det er markeret, tilføjer WordPress et robots-noindex-tag på alle sider på websitet. Mange slår det til under udviklingen og glemmer at fjerne markeringen efter lanceringen.
Shopify kan tilføje noindex via temakode eller apps. Nogle konto- og systemsider holder Shopify selv ude af indekset, hvilket er korrekt, men en temaændring eller en SEO-app kan ved en fejl tilføje noindex på produkt-, kollektions- eller blogsider.
Wix tilføjer noindex på alle sider, hvis SEO-indstillinger forhindrer søgemaskiner i at indeksere dem. En typisk udløser er, at en side duplikeres og arver originalens noindex-indstilling, uden at man opdager det.
Plugin- eller temakonflikter, der tilføjer noindex
SEO-plugins lader dig sætte noindex pr. indlæg, side eller indholdstype. En forkert konfigureret global regel, en pluginopdatering, der nulstiller indstillinger, eller et tema, der overskriver pluginets direktiver, kan sprede noindex til snesevis af sider på én gang. Hvis du for nylig har opdateret et plugin eller skiftet tema, så tjek det først.
Staging-indstillinger, der er skubbet til produktion
En overraskende almindelig kilde til utilsigtede noindex-tags. Dit staging-website bruger noindex for at holde sig ude af Google. Når build-pipelinen skubber staging-konfigurationen til produktion, følger noindex-direktivet med. Det rammer typisk hele sektioner af et website på én gang og er en af de sværeste årsager at diagnosticere, hvis du kun tjekker enkelte sider.
Sådan finder du ud af, hvilke sider der er berørt
En gentagelig diagnoseproces fanger alle berørte URL'er uden gætværk. Start med Search Console for at få listen, og gå derefter ned på de enkelte sider for at finde kilden.
Brug rapporten Sideindeksering til at eksportere berørte URL'er
Åbn Google Search Console, og gå til Indeksering › Sider. Klik på "Excluded by 'noindex' tag" i tabellen "Hvorfor sider ikke indekseres". Search Console viser et udsnit af de berørte URL'er; brug knappen Eksportér til at downloade listen til videre behandling.
Inspicér en enkelt URL med værktøjet URL Inspection
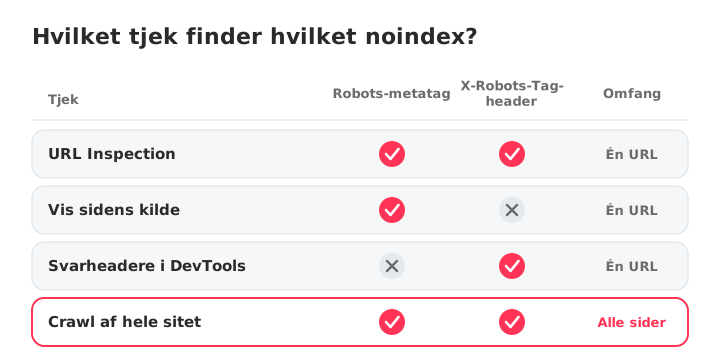
Indsæt en URL i søgefeltet øverst i Search Console. Værktøjet URL Inspection viser, om Google så et noindex-direktiv, og hvor det blev fundet: under "Indexing allowed?" står der, om noindex kom fra robots-metatagget eller fra X-Robots-Tag-HTTP-headeren. Klik på View crawled page for at se den præcise HTML, Googlebot modtog. Det er det hurtigste tjek af en enkelt side, du har.
Tjek sidens kildekode for noindex-metatags
Åbn siden i din browser, højreklik og vælg Vis sidens kilde, og søg derefter efter "noindex" (Ctrl+F eller Cmd+F). Hvis du finder <meta name="robots" content="noindex"> eller noget lignende, er metatagget synderen. Hvis du ikke finder det i kildekoden, kommer direktivet måske fra HTTP-headeren i stedet.
Brug browserens DevTools til at tjekke HTTP-headere
Åbn DevTools (F12 eller højreklik › Inspicér), gå til fanen Network, genindlæs siden, og klik på anmodningen for hoveddokumentet. Kig i sektionen Response Headers efter X-Robots-Tag: noindex. Det er den eneste måde direkte i browseren at fange header-baserede noindex-direktiver på, som ikke vises i HTML'en.
Crawl dit website med Screaming Frog eller SEOcrawl AI
Til diagnose af hele websitet fanger en crawler alle berørte sider i én gennemgang. Screaming Frog SEO Spider kan filtrere sider efter indekserbarhed på tværs af metatags og headere. SEOcrawl AI's Crawler crawler alle sider, markerer hver side med et noindex-direktiv under Indexability og giver dig en Audit Health Score, så du ser hele omfanget uden at eksportere og filtrere manuelt.
Sådan løser du "Excluded by 'noindex' tag": trin for trin
Dette er den mest handlingsorienterede sektion. Følg den løsning, der passer til din diagnose fra forrige sektion.
Fjern noindex-metatagget fra sidens kildekode
Redigér sidens skabelon eller indhold, og fjern <meta name="robots" content="noindex"> fra HTML-<head>. På specialudviklede websites skal du tjekke skabelonfilerne direkte. Hvis tagget indsættes med JavaScript, så find det ansvarlige script, og fjern det eller gør det betinget.
Før:
<meta name="robots" content="noindex">
Efter:
<meta name="robots" content="index, follow">
Eller fjern blot tagget helt. Google tolker fraværet af et noindex-direktiv som "indeksering tilladt".
Ret X-Robots-Tag i din server- eller CDN-konfiguration
Tjek din .htaccess (Apache), nginx.conf (Nginx) eller dine CDN-regler for X-Robots-Tag: noindex-direktiver. Fjern dem, eller begræns dem til de specifikke stier, der skal udelukkes, i stedet for de sider, du vil have indekseret. Du kan for eksempel beholde noindex på /staging/ og fjerne det fra /blog/.
Sådan løser du det i WordPress
To tjek i denne rækkefølge:
- Indstilling for hele websitet: gå til Indstillinger › Læsning, og fjern markeringen i "Discourage search engines from indexing this site". Det er den hyppigste årsag til noindex-problemer på hele websitet i WordPress.
- Indstillinger pr. side i SEO-plugins:
- Yoast SEO: åbn indlægget eller siden, rul ned til Yoast-boksen, klik på fanen Advanced, og sæt "Allow search engines to show this content in search results?" til "Yes".
- Rank Math: åbn indlægget, gå til Rank Math-boksen, klik på fanen Advanced, og sæt "Robots Meta" til "Index".
- All in One SEO: redigér indlægget, åbn fanen Advanced i AIOSEO-indstillingerne, og sørg for, at "No Index" ikke er markeret i robots-indstillingerne.
Tjek også hvert plugins globale indstillinger for hele indholdstyper (tags, kategorier, brugerdefinerede indlægstyper), der er sat til noindex. Resten af WordPress-opsætningen finder du i vores guide til at forbinde WordPress med Google Search Console.
Sådan løser du det i Shopify
I Shopify kommer noindex som regel fra temakode eller en app. Åbn Online Store › Themes › Edit code, og søg i theme.liquid og sideskabelonerne efter et robots-metatag med noindex. Tjek derefter dine SEO-apps for regler, der skjuler produkter, kollektioner eller blogindlæg, og alle produkter eller sider, der bruger metafeltet seo.hidden. Konto- og andre systemsider holder Shopify selv ude af indekset, og sådan skal det blive ved med at være.
Sådan løser du det i Wix, Squarespace og andre websitebyggere
Wix: åbn sidens SEO-indstillinger (fra sidemenuen), og slå "Let search engines index this page" til. Hvis du har duplikeret en side, kan kopien have arvet en noindex-indstilling fra originalen.
Squarespace: tjek SEO-indstillingerne for hele websitet for en indstilling, der skjuler websitet for søgemaskiner. For enkelte sider skal du åbne sideindstillingerne og kigge efter "Hide page from search results" under fanen SEO. Squarespace holder også som standard nogle systemsider, for eksempel kurven, ude af søgeresultaterne.
Efter rettelsen: anmod om genindeksering i Google Search Console
Når du fjerner noindex-tagget, fortæller du Google, at siden må indekseres, men Googlebot skal stadig crawle den igen for at bekræfte ændringen.
Brug værktøjet URL Inspection til at anmode om indeksering
Indsæt den rettede URL i søgefeltet i Search Console. Klik på Test live URL for at bekræfte, at indeksering nu er tilladt, og klik derefter på Request indexing. Google sætter URL'en i kø til ny crawling. Du kan indsende flere URL'er på denne måde, men Search Console begrænser, hvor mange du kan anmode om pr. dag.
Hvor lang tid tager det Google at genindeksere en side?
Typisk fra et par dage til et par uger, afhængigt af hvor ofte Googlebot crawler dit website. Websites med meget trafik og hyppige opdateringer bliver crawlet hurtigere; nye websites eller websites med lidt trafik kan vente i ugevis. En anmodning om indeksering er det hurtigste signal, du kan sende, men det er ingen garanti: den sætter din URL i crawlkøen og fremtvinger ikke en øjeblikkelig crawl.
Indsend et opdateret XML-sitemap for at fremskynde crawlingen
Hvis du har rettet mange sider på én gang, så indsend et opdateret XML-sitemap i sektionen Sitemaps i Search Console. Det signalerer, at dit website er ændret, og opfordrer til en bredere ny crawl. Et rent sitemap uden noindex-URL'er undgår også modstridende signaler, som vi ser på nedenfor.
Hvornår du skal beholde noindex-tagget (tilsigtede udelukkelser)
Ikke alle noindex-tags skal fjernes. Nogle sider bør aldrig vises i søgeresultaterne, og hvis de indekseres, tilføjer de tynde eller duplikerede sider til Googles billede af dit website og spilder crawlerens opmærksomhed.
Sider, der aldrig bør indekseres
- Login- og registreringssider
- Kurv-, checkout- og ordrebekræftelsessider
- Interne søgeresultatsider (for at undgå duplikeret indhold)
- Takkesider (lead magnets, formularindsendelser)
- Admin- og backend-sider
- Staging- og udviklingsmiljøer
- Filter- og parametersider, der skaber duplikerede URL'er
noindex vs. robots.txt: de vigtigste forskelle
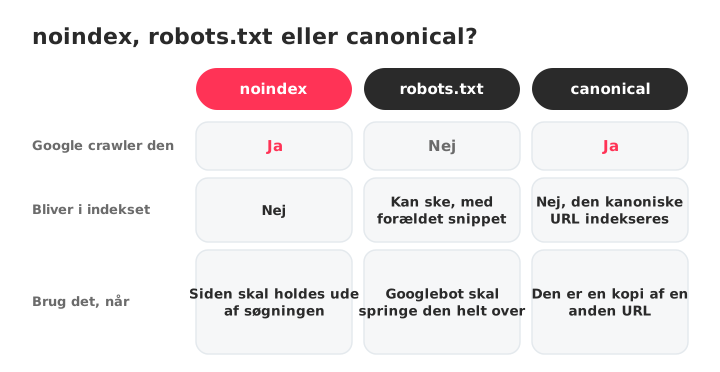
robots.txt blokerer crawling. noindex tillader crawling, men blokerer indeksering. Hvis du blokerer en side i robots.txt, læser Googlebot den aldrig, hvilket betyder, at den heller aldrig ser noindex-tagget. Hvis du vil have en side ud af indekset, så brug noindex. Hvis du vil have Googlebot til helt at springe siden over (for at spare crawlbudget), så brug robots.txt.
En almindelig fejl: at bruge robots.txt til at blokere en side, der allerede er indekseret. Google kan ikke se noindex-tagget, hvis den ikke kan crawle siden, så URL'en kan blive i indekset med en forældet titel og et forældet snippet. Den rigtige fremgangsmåde er at tillade crawling og bruge noindex til at fjerne siden fra indekset.
Canonical-tags vs. noindex: vælg det rigtige direktiv
Et canonical-tag (rel="canonical") fortæller Google: "denne side er en kopi af den anden URL, rank den i stedet". Et noindex-tag fortæller Google: "indeksér slet ikke denne side". De har forskellige formål:
- Brug canonical, når du har duplikeret eller næsten duplikeret indhold og vil samle rankingsignalerne på én URL.
- Brug noindex, når siden under ingen omstændigheder skal vises i søgeresultaterne.
Hvis du kombinerer begge på samme side, sender du modstridende signaler: det ene siger "læg denne side sammen med en anden URL", det andet siger "drop den". Vælg det, der passer til det, du vil opnå.
Sådan undgår du utilsigtede noindex-tags fremover
Det er nødvendigt at rette noindex-problemer, når de opstår, men at forebygge dem sparer timevis af fejlfinding og tabt trafik.
Opsæt Search Console-advarsler om fald i indekseringen
Google Search Console sender e-mails til verificerede ejere og brugere, når den opdager nye indekseringsproblemer på en ejendom. Sørg for, at e-mailnotifikationer er slået til i dine e-mailindstillinger i Search Console. Hvis antallet af indekserede sider pludselig falder, giver advarslen dig et forspring, før trafikken følger med.
Tilføj noindex-tjek til din QA-tjekliste før lancering
Tjek for noindex-direktiver, før du udruller et website eller skubber staging til produktion. Et tjek på 30 sekunder med "Vis sidens kilde" og en søgning efter "noindex" fanger den mest almindelige fejl ved udrulning. På større websites bør du crawle før og efter udrulningen og sammenligne antallet af noindex-sider. Føj det til din tekniske SEO-tjekliste, så ingen springer det over.
Planlagte crawls, der fanger uønskede noindex-direktiver
Kør en fuld crawl efter en fast plan og efter hver pluginopdatering, temaændring eller migrering for at fange uønskede noindex-tags, før de koster dig trafik. Med SEOcrawl AI's Crawler kan du sammenligne crawls, så du kan se, hvilke sider der fik noindex og hvornår, og SEO Monitor giver dig besked, så snart en af dine vigtige sider får et noindex-tag.
Ofte stillede spørgsmål
Hvad betyder "Excluded by 'noindex' tag" i Google Search Console?
Det betyder, at Google har fundet og respekteret et noindex-direktiv på din side, så siden ikke vises i søgeresultaterne. Statussen står i rapporten Sideindeksering i Search Console under "Ikke indekseret".
Det er ikke altid en fejl: sider, du bevidst udelukker, som login- eller checkout-sider, bør have denne status.
Hvordan løser jeg "Excluded by 'noindex' tag" i WordPress?
Tjek to steder i denne rækkefølge. Gå først til Indstillinger › Læsning, og sørg for, at "Discourage search engines from indexing this site" ikke er markeret. Åbn derefter hvert berørt indlæg eller hver berørt side i dit SEO-plugin (Yoast, Rank Math, All in One SEO), og bekræft, at robots-indstillingen for siden tillader indeksering.
Hvor lang tid tager det Google at indeksere en side, efter at noindex er fjernet?
Typisk fra et par dage til et par uger, afhængigt af hvor ofte Googlebot crawler dit website. Anmod om indeksering med værktøjet URL Inspection, når du har fjernet direktivet, og indsend et opdateret XML-sitemap for at sætte fart på processen. Websites med meget trafik bliver crawlet hurtigere igen end nye websites eller websites med lidt trafik.
Kan en side være udelukket af noindex, selvom den står i mit sitemap?
Ja. Noindex-direktivet vejer tungere end, at siden står i sitemappet. Google kan stadig crawle URL'en fra dit sitemap, men indekserer den ikke, så længe noindex er til stede.
Fjern enten noindex, så siden kan indekseres, eller fjern URL'en fra sitemappet, hvis udelukkelsen er tilsigtet. Noindex-URL'er i et sitemap sender modstridende signaler.
Hvad er forskellen på noindex og at blokere en side i robots.txt?
robots.txt forhindrer Googlebot i at crawle siden; noindex tillader crawling, men forhindrer indeksering. Hvis du blokerer en side med robots.txt, kan Google ikke læse noindex-tagget, så en side, der allerede er indekseret, kan blive i indekset med forældet indhold. Brug noindex til at fjerne en side fra indekset og robots.txt kun, når du helt vil forhindre crawling.
Hvordan tjekker jeg, om en side har et noindex-tag?
Tre metoder, fra hurtigst til mest grundig: brug værktøjet URL Inspection i Search Console, se sidens kildekode og søg efter "noindex" (Ctrl+F), eller tjek HTTP-svarheaderne i din browsers DevTools (fanen Network, kig efter X-Robots-Tag). Kun URL Inspection og DevTools fanger et noindex, der sendes i headeren.
Skal jeg være bekymret, hvis mange sider viser "Excluded by 'noindex' tag"?
Kun hvis de sider burde være indekseret. Eksportér listen fra Search Console, sammenlign den med dine bevidste udelukkelser (login, kurv, admin, takkesider), og ret kun de sider, der skal ranke i søgningen. Hvis alle berørte sider er nogle, du bevidst har udelukket, fungerer statussen korrekt.
Forfatter: David Kaufmann

Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter