Forældreløse sider: Hvad de er, og hvordan du finder dem
For at et website kan fungere og vise de sider, det rummer, så brugerne kan se dem, skal det have en ordentlig linkstruktur, der først og fremmest hjælper brugerne med at nå de sider med ét klik, og som samtidig sikrer, at de bliver crawlet af Googles bots og spiders, så de dukker op i søgeresultaterne. Når en side ikke er en del af linkstrukturen, kaldes den en »forældreløs side«.
Men hvad er en forældreløs side egentlig? Vi går i dybden med begrebet, med de konsekvenser det kan have set med SEO-briller, hvorfor det sker, hvordan du finder den slags sider, og hvordan du løser de problemer, de kan give. Lad os komme i gang!
Hvad er forældreløse sider?
Helt konkret: en forældreløs side er en side på et website, som, uanset om den er indekseret af Google eller en anden søgemaskine eller ej, ikke hænger sammen med eller linker til platformens sidestruktur, og derfor ligger helt isoleret.
På den måde er den side nærmest »svævende« på sitet uden at kunne nås af de brugere, der måtte besøge den, eller af Googles bots, så den kan vises i et søgeresultat, selv hvis den er indekseret. Selv hvis en side står i XML-sitemappet med sin URL, er der ingen garanti for, at der ikke findes forældreløse sider, for af den ene eller anden grund eller på grund af en menneskelig fejl kan den ikke nås af brugeren eller af søgemaskinernes crawlere.
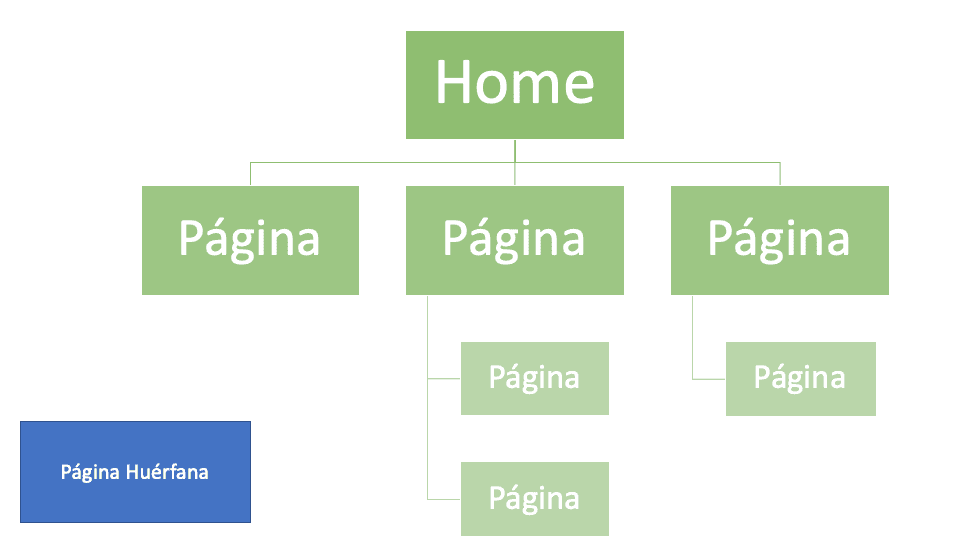
Der er for eksempel to måder, sider på et website bliver fundet på:
-
gennem crawleren, der finder alle sider ved at følge linkene mellem dem, og
-
gennem listen af URL'er i XML-sitemappet.
Findes der en isoleret forældreløs side, er den nærmest usynlig, selv hvis den står i sitemappet, for fordi ingen links peger på den, bliver den ikke fundet.
Det giver en række problemer med hensyn til:
-
trafik
-
tab af potentiale
-
SEO-problemer
-
synlighed
-
autoritet og
-
mulige straffe
...blandt andre, som vi kommer nærmere ind på senere. Indtil videre står det klart, at mulige forældreløse sider, uanset hvor stort eller lille et site er, skal rettes, og det kan lade sig gøre og er helt almindelig vedligeholdelse.
Hvorfor sker det, at et website har forældreløse sider?
Der er flere grunde til, at et website har forældreløse sider, uden at ejeren eller udvikleren nødvendigvis er klar over det eller har opdaget det på noget tidspunkt. Ofte skyldes den slags sider, som ingen ønsker på en webplatform, ændringer lavet på en dårlig måde, og det bunder som regel i en menneskelig fejl.
Nedenfor viser vi de vigtigste scenarier, hvor forældreløse sider opstår eller bliver skabt på et website:
-
Nogle gange ændres den interne linkbuilding mellem et websites sider, og det får nogle URL'er til at blive fjernet, fordi der ikke længere er brug for dem, fordi de er gamle, eller på grund af optimering af sitet. Mange gange bliver siderne liggende på sitet og svæver, selv når linkene er fjernet, uden at blive fjernet helt.
-
A/B-testsider, som slutbrugeren ikke kommer i kontakt med, og som efter at have været brugt i udviklingen af sitet bliver liggende uden at blive fjernet.
-
Når der midlertidigt laves en landingsside for at få brugere til at blive kunder på et site, for eksempel i kampagneperioder, til jul eller andet, og siden bliver slettet efter den periode, men den indekserede URL bliver liggende.
-
Når en kategori fjernes fra menuen på sitet, men ikke bliver redirected ordentligt til en anden, der er lavet i stedet, så den tilbageværende side ligger uden links på platformen.
-
Under en sitemigrering opstår der ofte mange forældreløse sider, der skifter format, URL og parametre, men ikke bliver fjernet og ender afkoblet og isoleret fra sitet.
-
Når der bruges en skabelon til at bygge et website, og der bliver standardsider fra skabelonen tilbage, som man senere glemmer alt om og ikke får fjernet.
På den anden side er der to almindelige årsager til forældreløse sider, som skal tages op og håndteres med det samme; det er i bund og grund dubletsider, der konsekvent bør redirecte automatisk til én enkelt URL. Konkret taler vi om konsekvent brug af HTTPS og HTTP på canonical og ikke-canonical sider samt brugen af skråstreg til sidst.
Ellers er det sandsynligt, at nogle versioner af siden ikke bliver linket og som følge deraf bliver forældreløse. I det tilfælde er det ikke hovedproblemet, at de er forældreløse, men at de er dubletter og vil give problemer med straf eller tabt indeksering, blandt andet, hvilket i Google oversættes til kopieret indhold eller indhold af lav kvalitet. Det tager vi op senere i afsnittet om at løse forældreløse sider.
Gavner eller skader forældreløse sider SEO?
Forældreløse sider er et problem set med SEO-briller, og også for synlighed, autoritet, tabt indhold og trafik, alt efter hvor mange af dem der findes på en platform. Har en platform én, to eller nogle få forældreløse sider, giver det måske slet ingen problemer, men når de udgør en stor procentdel af sitet, er det der, problemerne begynder.
At optimere et site, så det ikke har forældreløse sider, er vigtigt for SEO og i andre henseender, og man kunne aldrig sige, at de gavner sitet; de skader det snarere, når der er for mange.
For det første kan søgemaskinerne ikke finde forældreløse sider gennem links, så forældreløse sider bliver ofte ikke indekseret og dukker aldrig op i søgeresultaterne, og det går ud over deres trafik, synlighed og potentiale, men det ser vi nærmere på senere i et afsnit for sig.
Generelle problemer som forældreløse sider giver
Nedenfor er nogle generelle problemer, som forældreløse sider giver, især når de dækker en betydelig del af sitets linkstruktur og URL'er:
-
Brugeroplevelse: forældreløse sider påvirker, hvor usandsynligt det end lyder, brugeroplevelsen på et site meget, for brugerne kan ikke naturligt besøge en side gennem en menu eller et link, der fører dem hen til det, de leder efter, selv hvis siden findes og har indhold af kvalitet.
-
Autoritet: bliver vigtige sider forældreløse og mister deres links til de øvrige URL'er på sitet, går al den autoritet, de måtte have, til spilde, og det rammer direkte placeringen i Googles søgeresultater, for det er en vigtig SEO-faktor i den måde, søgemaskinen sorterer resultater for et bestemt søgeord på.
-
Kontekst: den interne linkbuilding på et site giver Googles crawlere kontekst, så de ved, hvordan siden skal indekseres, og hvilke søgninger den er vigtig og relevant for. Forældreløse sider gør, at sitet og siderne selv mister kontekst og semantisk mening, hvis de bliver indekseret.
Men er der mange forældreløse sider, er deres effekt langt mere mærkbar, når det gælder placeringer, trafik og crawl, så det er problemer, der skal tages op hver for sig og mere grundigt.
Problemet med sider med lav synlighed og trafik
Forældreløse sider har en markant negativ effekt, når det gælder direkte på placeringen af sitet og den konkrete side, det handler om, og på dens trafik. Og det er, fordi en forældreløs side, som nævnt før, er isoleret og bliver usynlig, både for brugeren, der ikke naturligt kan finde den på sitet med en knap eller et klik, og for Googles crawlere eller andre søgemaskiners.
Det rammer klart trafikken på sitet og siden og dens synlighed, fordi den ikke får mange brugere og også på grund af den dårlige eller ikke-eksisterende plads, forældreløse sider har i søgeresultaterne. Som konsekvens står man med et totalt tab af potentiale for sitet og siden, især hvis den rummer indhold af kvalitet om produkter, ydelser og andre emner. Effekten på trafik og synlighed giver også tab af autoritet og relevans for et site i forhold til dets niche eller branche sammenlignet med konkurrenterne.
Problemet med tabt crawl
Google indekserer som søgemaskine siderne på et site efter det, der kaldes crawl budget eller Crawl Budget, som kan beskrives som den tid, søgemaskinens crawlere eller spiders bruger på at finde sider at indeksere. Jo flere sider et site har, jo mere tid kræver det, altså mere crawl budget.
Det er her, optimeringen af websitets struktur, arkitektur og andre elementer kommer i spil, som forældreløse sider. Har et site irrelevante forældreløse sider, æder de crawl budget på lige fod, og det går til spilde og kunne betyde, at sider med godt helbred og godt indhold ikke bliver indekseret, hvilket rammer søgeresultater og trafik. Kort sagt er forældreløse sider spild af ressourcer, som Google ikke er villig til at bruge.
Forskellen på forældreløse sider og Dead End-sider
Inden for SEO kan begrebet forældreløs side** forveksles med begrebet blindgydeside eller »Dead End«**, fordi de udgør lignende problemer, men de er ikke det samme. Vi har allerede defineret ovenfor, hvad Orphan Pages er, lad os gå videre med blindgyder:
En blindgydeside er en side, der ikke er linket til nogen anden fra sitets interne linkbuilding, og heller ikke til nogen ekstern webplatform, altså: når du først er landet på den, kan du ikke andet end at lukke den og gå igen.
Når crawlerne fra en søgemaskine som Google lander på en blindgydeside, kan de ikke komme nogen vegne, og derfra kommer navnet, som trækker en parallel til en blind vej.
Hvordan finder du forældreløse sider på dit site?
For at komme i gang med at løse problemerne med forældreløse sider eller Orphan Pages skal vi først finde dem, for de bliver naturligvis ikke vist ved første øjekast, hverken som bruger af sitet eller som udvikler. Heldigvis findes der forskellige værktøjer som SEO-software, der kan analysere hele vores websitestruktur i detaljer og gennem serverlogs få det fulde billede af dem alle.
Har du brug for en stærk SEO-software, der ikke bare hjælper dig med at finde forældreløse sider, men også med at løfte og forbedre din SEO-strategi, så kig endelig på det program, SEO Alive selv har udviklet!
Sådan genkender du forældreløse sider med Screaming Frog
Som nævnt findes der flere programmer på markedet, der hjælper dig med at finde de forældreløse sider; vi koncentrerer os om på en enkel måde at forklare hvordan du gør med et af de bedst kendte, Screaming Frog.
Screaming Frog har to forskellige programmer: det, alle kender bedst, som crawler hele websitet ved at følge de interne links, det finder, og log analyser, som analyserer serverens access-logs, altså de registreringer, der bliver tilbage, når Googlebot (eller en anden user agent) går ind og besøger en af vores sider.
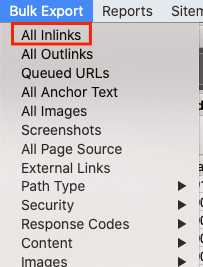
Med det første trækker vi en fil ud, der lister de samlede URL'er, crawleren finder undervejs; det bliver en Excel-fil, som vi finder i rapportsektionen under »all inlinks«:
Når vi har den fil, tager vi logs fra vores server, som normalt er en komprimeret fil med de nævnte registreringer, og lægger den ind i log analyser i Screaming Frog, så vi her får et panel, hvor alle de URL'er, Googlebot har besøgt i den periode, vi lægger ind, dukker op, uanset om de er linket eller ej.
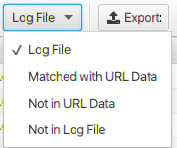
Sidste skridt er at lægge Excel-filen fra det forrige trin ind i den sektion i log analyser, der er lavet til formålet, og når vi gør det, bliver et nyt faneblad slået til med følgende muligheder:
-
Matched with URL data: Det er de URL'er, der er linket internt og er blevet besøgt af Google.
-
Not in log file: De URL'er, der er linket, men af en eller anden grund ikke får events (besøg) fra Google.
-
Not in URL data: Det er den gruppe, vi er interesseret i her; det er URL'er, som Google besøger og efterlader en registrering i logs om, men som crawleren ikke har kunnet finde under simuleringen, fordi de ikke er linket internt, altså vores eftersøgte Orphan Pages.
Fra den tredje gruppe trækker vi listen over sider, vi vil kategorisere som forældreløse, og dem, der giver statuskode 200, er grundlæggende dem, vi skal optimere.
Hvordan løser du problemet med forældreløse sider?
Generelt og manuelt er der fire ting, du kan gøre, hvis du har URL'er, der ikke er en del af den interne linkbuilding, og hvor der skal træffes nogle beslutninger:
-
For det første: er der efter en migrering forældreløse sider, som der sandsynligvis er, og de bliver gennemgået, og mange af dem har lidt relevant, intet eller dubleret indhold, er det bedste at slette dem og, hvor det giver mening, lægge en 301-redirect til lignende eller fremhævede sider på sitet med mere autoritet.
-
For det andet: vil du af en eller anden grund beholde en forældreløs side på grund af godt indhold, autoritet og trafik, er næste skridt at linke til den fra en URL på sitet med beslægtet indhold, som er let at nå for brugerne og for Google. Det skal selvfølgelig nævnes, at sidens URL skal med i sitemappet.
-
For det tredje: dukker der mange forældreløse sider op, men deres natur er midlertidig, og deres indhold allerede er udløbet, fordi det rummede kampagner og indhold knyttet til et bestemt tidspunkt, så gør vi det samme som i det forrige trin og linker siden til en anden intern side med relevans, som er tilgængelig. Men i det tilfælde sørger vi for, at den URL ikke bliver indekseret, ved at lægge et »noindex«-metatag ind, så den ikke tælles med af crawlerne.
-
Til sidst: i tilfælde af forældreløse sider med dubleret eller næsten dubleret indhold er det værd at overveje at slette den side og lægge indholdet ind i en anden, så det ikke går tabt, og man stadig kan trække på dets generelle potentiale.
Konklusion
Forældreløse sider er et naturligt element, der dukker op på et website af forskellige grunde, og når de ikke er for mange, eller deres antal ikke vokser eksponentielt, er de slet ikke et problem.
Omvendt, når en stor procentdel af et website og dets interne linkbuilding består af den slags sider, kan det give mange problemer med crawl, placeringer og trafik knyttet til SEO, og også med autoritet, brugeroplevelse og andre ting, der skal tages hånd om.
Den gode nyhed er, at forældreløse sider kan løses på forskellige måder, men altid i en analyseproces, hvor du skal spørge dig selv, om hver enkelt forældreløs side er relevant for placeringer, for indhold og kan linkes til en anden, og når det ikke er tilfældet, så bare slette dem.
Og du, kære læser... kendte du til forældreløse sider? Er du stødt på det her i et af dine projekter eller hos dine kunder? Skriv en kommentar, så vender vi tilbage om det. Tusind tak og på gensyn!
Forfatter: David Kaufmann

Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter