SEO-integrationer til hele din stak
Dine SEO- og AI-synlighedsdata, uanset hvor du bygger.
Kobl data fra Search Console, placeringer og AI Tracker på dit produkt, dine AI-agenter eller din terminal — alle læser fra det samme kanoniske datalag. Hent dem via REST-API'et, spørg til dem i almindeligt sprog via MCP-serveren, eller script dem fra kommandolinjen. Samme tal, uanset flade.
Ét datalag · Bearer-auth · Ingen scraping · Samme tal overalt


Vælg hvordan du kobler dine data på
SEO API (REST)
En Bearer-autentificeret REST v1 til dit eget produkt, dashboard eller data warehouse. Typet JSON, dokumenterede rate limits, én nøgle. Dækker GSC, placeringer og AI Tracker over HTTP med sca_live_-nøgler, du selv laver i dit dashboard.
Udforsk API'et
MCP-server (AI-agenter)
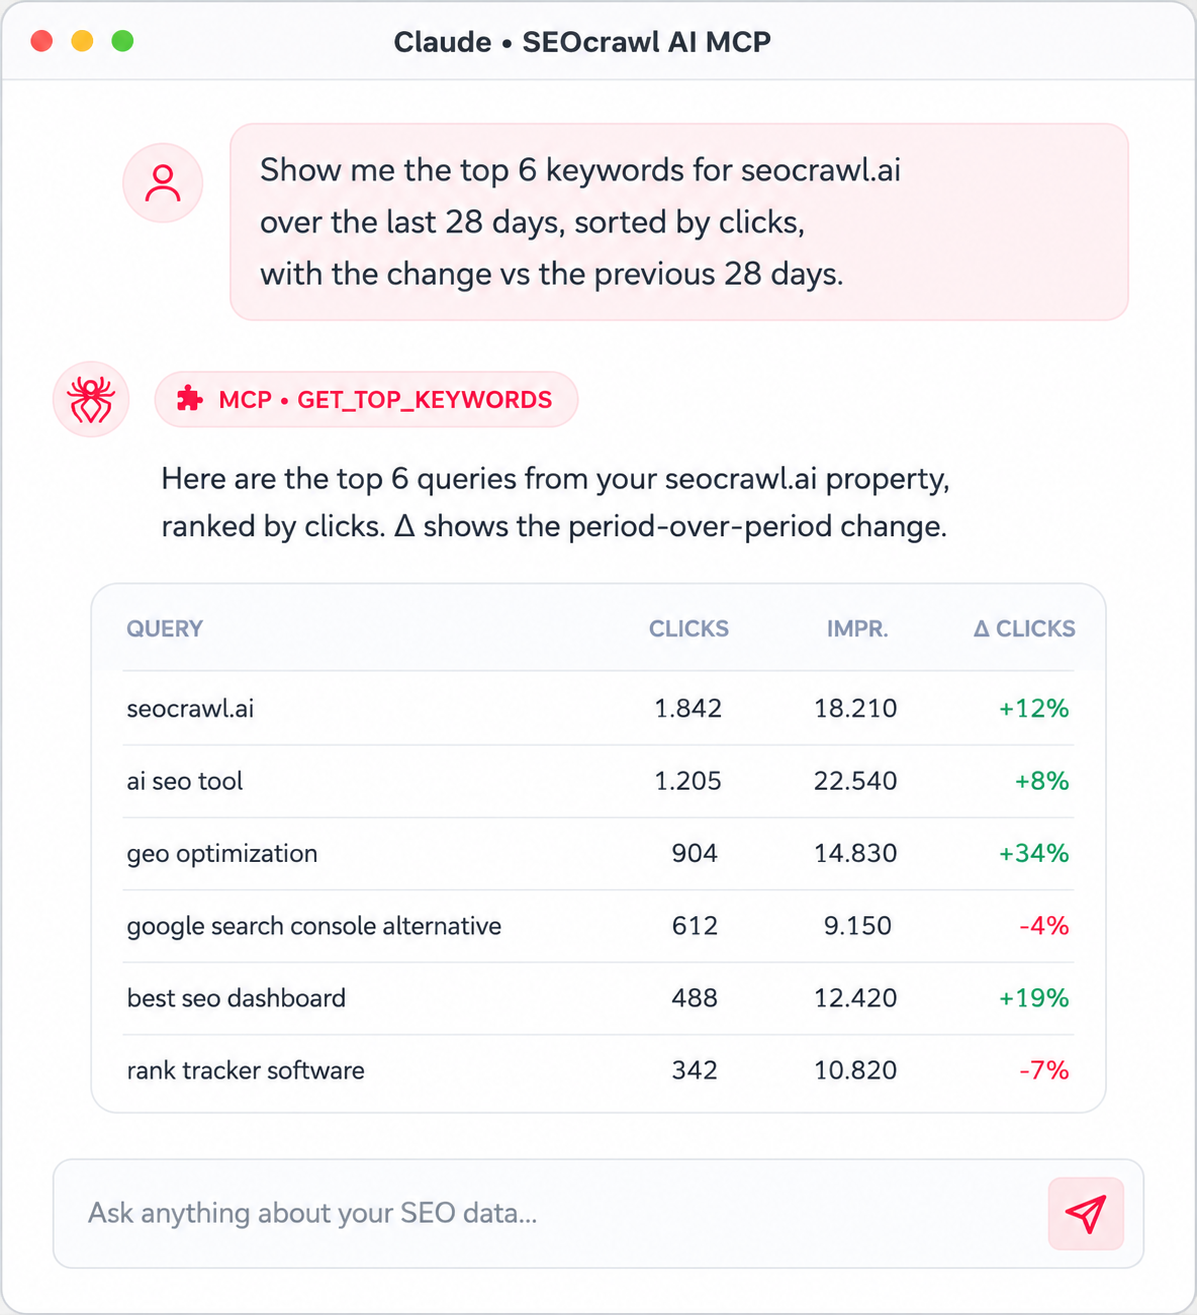
Forbind Claude, ChatGPT eller en hvilken som helst MCP-klient, og spørg til dine SEO- og AI-synlighedsdata i almindeligt sprog. 85 værktøjer, ét endpoint, OAuth-login uden nøgler at klistre ind.
Se MCP'en
Terminal og CLI
Styr de samme data fra enhver MCP-klar terminalagent som Claude Code, Codex eller Cursor. Automatisér rapporter, og læg tjek ind i din CI/CD.
Se CLI'enAlle dine SEO-data, ét kanonisk lag
Uanset hvilken flade du vælger, læser den fra det samme kanoniske lag — så dit dashboard og dine agenter aldrig modsiger hinanden.
Search Console
Klik, visninger, CTR og gennemsnitlig position pr. søgning, side, land og dato — med sammenligning periode mod periode.
Placeringer og positioner
Positionsdata, fremgang og tilbagegang og positionshistorik udledt af dine Search Console-data — klar til dine rapporter.
Søgeord
Hver søgning, du er synlig på, koblingen mellem søgeord og side, og analyser pr. søgeord på tværs af alle dine properties.
Sider
Topsider, koblingen mellem side og søgeord og performanceanalyser pr. side for hver URL på dit site.
AI Tracker
De prompts, du holder øje med for brandomtaler i ChatGPT, Claude, Gemini og Perplexity — med kørsler og citeringer.
Opgaver
Læs og skriv på dit SEO-opgavebræt — opret, opdatér og kommentér, og hold det i sync med din egen projektstyring.
Indeksdækning
Hvad Google rent faktisk indekserer: dækningsstatusser, indekseringshistorik og live URL-inspektion.
GA4 og AI-henvisninger
Sessioner, konverteringer, trafik pr. kilde og de besøg, ChatGPT, Perplexity og andre AI-motorer sender dig.
Site audit
Crawl-status, fejl on-page og teknisk, detaljer pr. side og crawls på bestilling — hele datasættet fra auditten.
Tags og Smart Views
Opdel dine data med dine egne tags, gemte Smart Views og annotationer på tidslinjen, så hver ændring får kontekst.
SEO Monitor
Code Monitor følger ændringer i HTML og indhold på de sider, du holder øje med — fundne ændringer, hele ændringshistorikken og snapshots af siderne.
Rapportering
Output, der er klar til rapporten: scorecards, datatabeller og tidsseriegrafer renderet direkte fra dine data til dashboards og eksport.
Live = tilgængeligt i dag · Snart = på vej ud. MCP-serveren giver allerede adgang til 85 værktøjer; REST-dækningen vokser løbende.
Kobl de værktøjer på, du allerede rapporterer i
Det her er ting, du bygger oven på API'et og MCP'en — ikke indbyggede ét-kliks-connectorer. Og det er netop pointen: du bestemmer selv, hvordan data flyder.
BI og dashboards
Send live tal til Looker Studio, Google Sheets eller Power BI via REST-API'et. Ingen manuel eksport, altid opdateret.
Pipelines til data warehouse
Hent GSC-, placerings- og AI Tracker-data efter en fast plan ind i BigQuery, Snowflake eller Postgres, og læg dem sammen med jeres omsætningstal.
Automatisering uden kode
Kobl API'et på Zapier, Make eller n8n, og flyt SEO-data mellem de apps, dit team allerede bruger.
AI-agenter og copilots
Giv Claude, ChatGPT eller jeres egen assistent forankret adgang til jeres SEO- og AI-synlighedsdata via MCP'en.
CI/CD
Script tjek, alarmer og rapporter fra din terminal eller din pipeline.
Ét datalag, ingen scraping
Hver flade hviler på den samme kilde, så tallene stemmer overalt. Bearer-auth, dokumenterede endpoints og det samme sca_live_-token til både REST-API'et og MCP'en. Kobl dine SEO-data på i dag — udforsk API'et, forbind MCP'en, eller automatisér fra din terminal.
Ofte stillede spørgsmål
Hvilke integrationer har SEOcrawl AI?
Tre måder at koble dine data på din egen stak: et Bearer-autentificeret REST-API til produkter og dashboards, en MCP-server til AI-agenter og adgang fra terminal og CLI til scripts og CI/CD. Alle tre læser fra det samme kanoniske datalag, så tallene stemmer overalt.
Findes der et SEO-API?
Ja. Et REST /v1-API er live i early access med Bearer-nøgler af typen sca_live_, som du selv laver i dit dashboard. I dag dækker det performance i Search Console, properties, prompts i AI Tracker og opgaver, mens GA4, indeksering og eksport fra site audit er på vej ud. Se SEO API-siden for endpoints og autentificering.
Kan jeg koble SEOcrawl AI på Looker Studio, Google Sheets eller et warehouse?
Ja, via REST-API'et. Hent typet JSON efter en fast plan ind i Looker Studio, Sheets, Power BI, BigQuery eller Snowflake, og byg præcis det rapporteringslag, du vil have. Det er ting, du bygger oven på API'et — ikke indbyggede ét-kliks-connectorer.
Kan jeg bruge det med Zapier, Make eller n8n?
Ja. Fordi API'et returnerer typet JSON over HTTP med Bearer-auth, kan du kalde det fra Zapier, Make, n8n eller enhver anden platform, der kan sende HTTP-requests, og dermed flytte dine SEO-data over i de værktøjer, dit team allerede bruger.
Hvad er forskellen på API'et, MCP'en og CLI'en?
Samme data, forskellig flade. REST-API'et er til kode: produkter, dashboards, pipelines. MCP'en er til AI-agenter, der spørger i naturligt sprog. CLI'en styrer den samme MCP fra din kommandolinje til scripts og CI/CD. Vælg den, der passer til måden, du bygger på.
Deler API'et og MCP'en den samme nøgle?
Ja. Det samme sca_live_-Bearer-token autentificerer begge dele, fordi de ligger oven på ét kanonisk datalag: ét credential, to flader, identiske tal.
Hvordan er API'et fra SEOcrawl AI i forhold til et rå SEO-data-API?
Det giver dig dine egne forbundne data (Search Console, placeringer, AI Tracker) i stedet for en generisk søgeordsdatabase, så du spørger til din reelle performance og ikke til tredjepartsestimater. Én nøgle dækker både REST-API'et og MCP'en, og der er ikke scraping involveret.