


«Виявлено – наразі не проіндексовано»: що це означає і як виправити
Google знає, що ваш URL існує, але ще не заходив на нього. Ось як зрозуміти, чекати чи діяти, і які виправлення пробувати насамперед на невеликому та великому сайті.
Виявлено – наразі не проіндексовано означає, що Google знайшов URL, але ще не просканував його. Так це описує довідка щодо звіту про індексування сторінок від Google. Зазвичай Google збирався сканувати й відклав це, щоб не перевантажувати ваш сайт, тому у звіті дата останнього сканування порожня.
Це статус пріоритету сканування, а не вирок вашому контенту, бо Google сторінку ще не читав. Нижче ви побачите, чим він відрізняється від «Проскановано», що ми виявили, перевіривши власний сайт, і список виправлень, упорядкований за розміром сайту. Лише починаєте працювати зі звітом? Почніть із цього посібника з Google Search Console.
Що означає «Виявлено – наразі не проіндексовано»
Google проводить URL через чотири кроки: знаходить, сканує, індексує і лише потім може показати в результатах. Два статуси Search Console описують URL, що застряг дорогою.
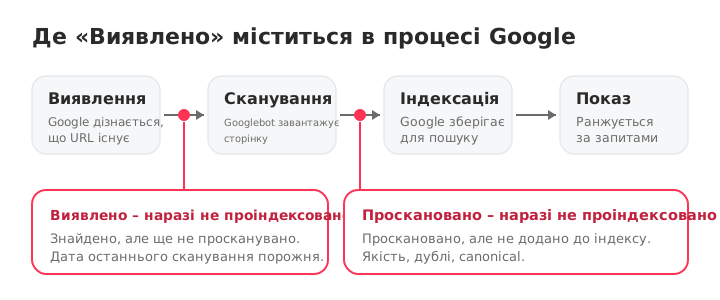
URL потрапляє до «знайдено» через sitemap або за посиланнями з інших сторінок. Далі Google вирішує, коли його сканувати. «Виявлено» означає, що це рішення ще не ухвалено.
Чим відрізняється від «Проскановано – наразі не проіндексовано»
Ці два статуси схожі, але потребують різних виправлень.
| Виявлено – наразі не проіндексовано | Проскановано – наразі не проіндексовано | |
|---|---|---|
| Чи сканував Google? | Ні | Так |
| Дата останнього сканування | Порожньо | Є дата |
| Чи читав Google сторінку? | Ні | Так |
| Звичайна причина | Сканування відкладено або низький пріоритет | Google прочитав сторінку й відклав її вбік |
| На що дивитися насамперед | Внутрішні посилання, sitemap, місткість сканування | Якість контенту, дублікати, canonical |
Повну діагностику другого статусу наведено в посібнику з Проскановано – наразі не проіндексовано.
Як виглядає список на реальному сайті
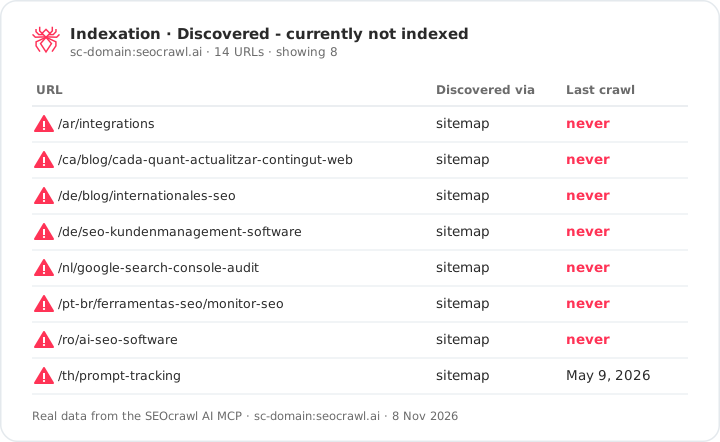
Ми перевірили seocrawl.ai у звіті про індексацію SEOcrawl. Із 1000 URL, які відстежує SEOcrawl (наш sitemap заявляє 6310), 823 проіндексовано, тобто 82,3 %. 128 перебувають у «Проскановано – наразі не проіндексовано» і 14 — у «Виявлено – наразі не проіндексовано».
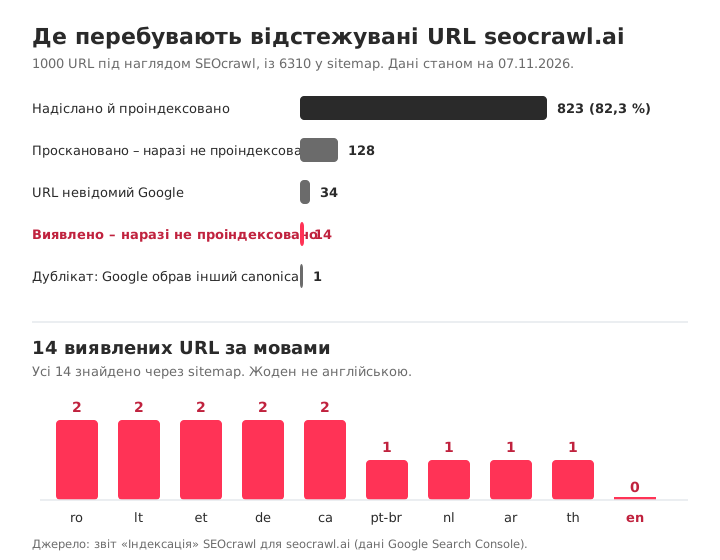
Корисна саме спільна риса цих 14:
- Усі вони — перекладені сторінки: арабська, каталанська, німецька, естонська, литовська, нідерландська, бразильська португальська, румунська та тайська. Жодної англійською.
- Google знайшов усі 14 через sitemap, а не за посиланням з іншої сторінки.
- В одної з них указано ранішу дату сканування (9 травня 2026), тож статус описує, де URL перебуває зараз, а не те, що Google його ніколи не відвідував.
Це закономірність, яку потрібно перевірити, а не діагноз. Сторінка, що існує 26 мовами й досяжна переважно через sitemap, — природний кандидат на слабкі внутрішні посилання, тому внутрішні посилання — перше, на що варто глянути. Урок слушний для будь-якого сайту: не читайте список URL за URL. Згруповані за мовами, 14 URL стали одним питанням.
Цифри охоплюють 1000 URL, які відстежує SEOcrawl, тобто вибірку з усього sitemap. Більша група зі 128 URL — це інший статус, і вона має власний посібник.
Чому Google відкладає сканування
Посібник із краулінгового бюджету від Google пояснює, як він вирішує, скільки сканувати: ліміт місткості, який витримує ваш сервер, і попит на ваші URL. Більшість виявлених URL зводяться до однієї з цих п'яти причин.
- Місткість сканування. Google повідомляє, що ліміт знижується, коли сайт сповільнюється або повертає помилки сервера. Повільний сервер — менше сканувань.
- Низький попит на сканування. Попит залежить від розміру сайту, частоти оновлень, якості й актуальності сторінок. URL із малою кількістю внутрішніх посилань або зовсім без них дає Google мало приводів швидко повернутися.
- Марне сканування. Дубльовані URL, параметри, фасети, довгі ланцюжки редиректів і soft 404 конкурують з вашими справжніми сторінками. Google зазначає, що soft 404 і далі скануються та марнують бюджет, а сторінку з noindex він усе одно запитує, перш ніж відмовитися від неї.
- Знайдено лише через sitemap. Sitemap повідомляє Google, що URL існує. Пріоритетним він його не робить, а Google сприймає sitemap як підказку. Сторінки, знайдені лише там, чекають першими.
- Новий сайт або розділ. Кожен сайт починає з того самого обережного ліміту місткості за замовчуванням, який зростає, коли сайт доводить свою справність.
Сам краулінговий бюджет заслуговує на вашу увагу лише на дуже великих сайтах. Груба оцінка Google: 1 000 000+ унікальних сторінок, що оновлюються приблизно раз на тиждень, або 10 000+ сторінок, що змінюються щодня. На менших сайтах причини 2 і 4 трапляються набагато частіше.
Це проблема? Три питання, перш ніж щось виправляти
- Чи має цей URL взагалі індексуватися? Якщо це відфільтроване подання, сторінка внутрішнього пошуку чи тестовий URL, його відсутність нормальна. Щоб зафіксувати це явно, застосуйте noindex або поверніть 404 чи 410 (див. Excluded by 'noindex' tag).
- Скільки URL і за якою закономірністю? Google каже, що за менш ніж 500 сторінок цей звіт вам, імовірно, навіть не потрібен. Список також обмежений 1000 рядками, тож на великому сайті це вибірка.
- Вони нові? URL, опублікований минулого тижня, ще не проблема. Часові рамки самого Google наведено в таблиці нижче.
Як виправляти залежно від розміру сайту
Правильний перший крок залежить від розміру вашого сайту, тож почніть із потрібної колонки.
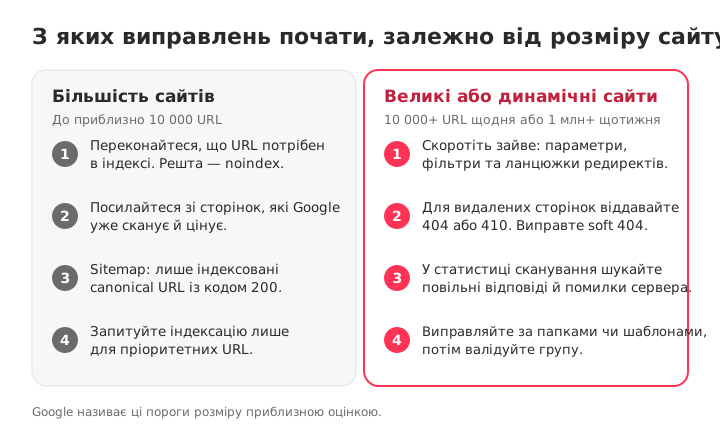
Більшість сайтів: до приблизно 10 000 URL
- Переконайтеся, що URL заслуговує на індексацію. Якщо ні — застосуйте noindex або видаліть його й викресліть зі списку.
- Ставте посилання зі сторінок, які Google уже сканує. Додайте контекстні посилання з описовим анкором зі сторінок, що вже в індексі та отримують трафік. Будь-який краулер покаже ваші сторінки-сироти, якщо відфільтрувати сторінки без внутрішніх посилань, а в цьому посібнику з внутрішніх посилань описано весь метод.
- Тримайте sitemap чистим. Включайте лише URL, які віддають 200, індексуються й є canonical-версією, з точним
lastmod. Google ігнорує priority і changefreq. Якщо спершу потрібен сам файл, знайдіть свій sitemap. Якщо Search Console пише, що не знаходить жодного, див. No referring sitemaps detected. - Запросіть індексацію для кількох пріоритетних URL. Відкрийте інструмент перевірки URL і натисніть Запросити індексування. Google застосовує квоту і повідомляє, що повторні запити нічого не прискорюють, тож зберігайте це для найважливіших сторінок.
Великі або швидкозмінні сайти: 10 000+ URL змінюється на день або 1 млн+ на тиждень
- Скоротіть марне сканування. Закрийте в robots.txt простори URL без пошукової цінності (параметри, фасети, внутрішній пошук) і об'єднуйте дублікати через canonical і редиректи 301. Не покладайтеся, що noindex заощадить бюджет: Google і далі запитує ці сторінки.
- Для вилучених сторінок повертайте 404 або 410 і виправляйте soft 404. Google називає 404 сильним сигналом більше не сканувати URL, тоді як заблоковані URL лишаються в черзі довше. Скоротіть кожен довгий ланцюжок редиректів.
- Перевірте статистику сканування. У Налаштуваннях звіт «Статистика сканування» показує час відповіді та помилки сервера. Якщо вони високі, Google знижує ваш ліміт місткості, і жодні правки контенту не допоможуть, доки сервер не покращиться.
- Виправляйте за папками чи шаблонами, потім перевіряйте групу. Ухвалюйте одне рішення на закономірність, створіть sitemap лише з виправленими URL і натисніть Перевірити виправлення. Докладніше про краулінговий бюджет, якщо ваш сайт належить до цієї категорії.
Чекати чи діяти?
Найважче не виправлення, а розуміння, коли час перестати чекати. Використовуйте власні діапазони Google і свою динаміку.
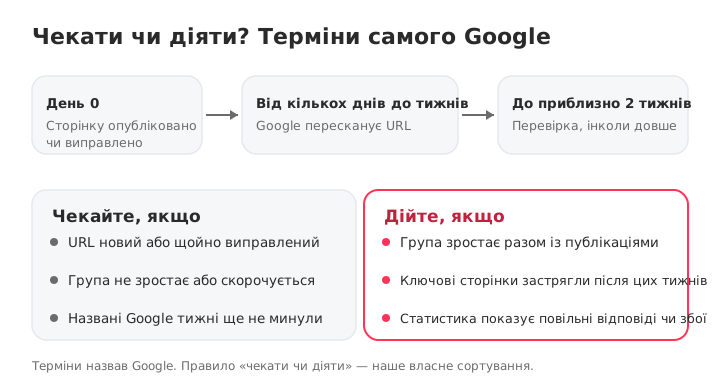
| Що ви зробили | Що каже Google | Джерело |
|---|---|---|
| Попросили Google пересканувати | Від кількох днів до кількох тижнів | Запит на повторне сканування |
| Запросили індексацію | Зазвичай близько доби, до одного-двох тижнів, із денною квотою | Довідка з перевірки URL |
| Перевірили виправлення | До приблизно двох тижнів, іноді значно довше | Довідка з індексування сторінок |
Часові діапазони належать Google. Правило «чекати чи діяти» — наше: чекайте, доки URL новий, а група стабільна або зменшується, і дійте, коли група продовжує зростати або ваші ключові сторінки лишаються застряглими після цих тижнів.
Як відстежувати з часом
Search Console показує останній стан кожного URL і список, обмежений 1000 рядками, тож вибудуйте власну рутину:
- Раз на місяць експортуйте список і порівнюйте з попереднім. Група зростає, стабільна чи зменшується?
- Групуйте за закономірністю (мова, папка, шаблон), перш ніж дивитися на окремі URL.
- Дивіться, як Google знайшов кожен URL. Список, де скрізь «sitemap» і ніде «сторінка-джерело», як у наших 14 URL, прямо вказує на внутрішні посилання.
Подання Індексація в SEOcrawl AI дає цей список готовим: фільтруйте за станом покриття, щоб побачити URL у ньому, з датою останнього сканування, кліками та показами. Через MCP кожен URL надходить також із canonical, обраним Google, у порівнянні із заявленим, і з позначкою, чи знайдено його через sitemap або сторінку-джерело. Crawler проводить аудит ваших власних сторінок, тож ви бачите, що слабке в URL, перш ніж просити Google глянути ще раз, а SEO Monitor попереджає, коли ключова сторінка отримує noindex, змінює canonical, віддає 404 або зникає з sitemap.
Ось цей список для нашого власного сайту просто з подання «Індексація»:
Можна обійтися й без панелі. З MCP SEOcrawl AI, підключеним до Claude або ChatGPT, запитайте: «Покажи URL зі статусом Виявлено – наразі не проіндексовано й згрупуй їх за папками.» Ось покрокова інструкція з підключення Search Console до Claude і ChatGPT.
Поширені запитання
Що означає «Виявлено – наразі не проіндексовано»?
Це означає, що Google знайшов ваш URL, але ще не просканував його. Зазвичай Google збирався сканувати й відклав це, тому дата останнього сканування порожня (довідка з індексування сторінок). Google сторінку не читав, тож статус нічого не каже про її якість. Це не штраф.
Як довго триває «Виявлено – наразі не проіндексовано»?
Google не публікує строку для цього статусу. Він повідомляє, що запитане повторне сканування займає від кількох днів до кількох тижнів, а перевірка виправлення — приблизно до двох тижнів, іноді значно довше. Новому URL ці тижні можуть просто знадобитися. Якщо група продовжує зростати в міру ваших публікацій, перестаньте чекати й дійте.
Чи розв'яже проблему запит індексації?
Він може допомогти для кількох пріоритетних URL, бо просить Google поставити сторінку в чергу. Він не усуває причину, тож сторінка може повернутися до того самого статусу. Запити підпорядковані денній квоті, а Google повідомляє, що повторне надсилання того самого URL нічого не прискорює. Використовуйте його після поліпшення внутрішніх посилань, але ніколи як масовий інструмент.
Це штраф?
Ні. Ручні дії відображаються в окремому звіті. Цей статус означає, що Google знайшов URL і ще не сканував його, тобто сторінку не оцінювали. Причина зазвичай у пріоритеті сканування: слабкі внутрішні посилання, повільний сервер або безліч малоцінних URL, що конкурують за сканування.
Чому так багато моїх сторінок виявлено, але не проіндексовано?
Велике число зазвичай вказує на закономірність, а не на окремі сторінки: параметри URL чи фасети, дублікати, sitemap з URL, яким там не місце, слабкі внутрішні посилання на цілий розділ або сервер, що гальмує Googlebot. Згрупуйте URL за папками, мовами чи шаблонами, перш ніж дивитися на будь-який окремо.
Чи варто турбуватися на невеликому сайті?
Зазвичай ні. Google каже, що якщо на вашому сайті менш ніж 500 сторінок, звіт про індексування сторінок вам, імовірно, навіть не потрібен. Кільком новим URL у цьому статусі найчастіше потрібні час і кілька внутрішніх посилань зі сторінок, які Google уже сканує.
Чим SEOcrawl AI допоможе з виявленими URL?
Подання Індексація в SEOcrawl AI перелічує URL, що застрягли в кожному стані покриття Google, з датою останнього сканування, кліками та показами. Через MCP SEOcrawl AI ви також можете попросити Claude або ChatGPT видати цей список із canonical Google у порівнянні із заявленим і з позначкою, чи знайшов Google кожен URL через sitemap або сторінку-джерело, згрупований за папками.
Більше SEOcrawl AI у Google
Оберіть нас бажаним джерелом, і ви бачитимете більше наших статей у головних новинах Google.
Автор: David Kaufmann
Останні 10+ років я повністю занурений у SEO — і чесно кажучи, не хотів би інакше.
Моя кар'єра вийшла на новий рівень, коли я працював старшим SEO-спеціалістом у Chess.com — одному зі 100 найвідвідуваніших сайтів у всьому інтернеті. Робота в такому масштабі навчила мене того, чого не дав би жоден курс чи сертифікат.
З цього досвіду я заснував SEO Alive — агенцію для брендів, які серйозно ставляться до органічного зростання. І оскільки не знайшов інструмента, що добре справляється з обома світами — класичним і AI, побудував SEOcrawl AI. Якщо ви шукаєте досвідченого SEO-партнера, який любить цю справу — буду радий поговорити!
Дізнайтесь більше контенту цього автора
Ми виміряли кліки з Google і переходи з ШІ на 16 000+ сайтах у 15 галузях. Трафік із ШІ зростає на 45% на рік, але досі дорівнює приблизно 1 візиту на кожні 100 з Google, тоді як кліки з Google скоротилися на 15%.

До 30 листопада перший рік будь-якого річного тарифу SEOcrawl AI коштує вдвічі дешевше з кодом BLACKFRIDAY2026. Що ви отримуєте, що покривають промпти кожного тарифу і як за 15 хвилин побачити, де вас згадують ChatGPT, Gemini, Claude та Perplexity.