Виключено тегом 'noindex': що це означає і як це виправити
Ви відкрили Google Search Console, побачили групу URL-адрес зі статусом «Виключено тегом 'noindex'», і тепер ці сторінки невидимі в пошуку.
Якщо ви помітили групу URL-адрес зі статусом «Виключено тегом 'noindex'» у Google Search Console, ваші сторінки свідомо не допускаються до індексу Google, а рішення зазвичай простіше, ніж здається: знайдіть директиву, видаліть її та попросіть Google просканувати сторінку знову.
У цьому посібнику пояснено, що саме спричиняє цей статус, як знайти директиву noindex, яка за нього відповідає, і точні кроки, щоб видалити її в кожній популярній CMS і повернути сторінки в ранжування. Та сама перевірка автоматично виконується в Crawler від SEOcrawl AI, який позначає директиви noindex на всьому сайті без перевірки кожної URL-адреси окремо.
Що означає «Виключено тегом 'noindex'» у Google Search Console?
Статус «Виключено тегом 'noindex'» означає, що Googlebot просканував вашу сторінку, знайшов директиву noindex і виконав її, не додавши сторінку до індексу Google. Сторінка не з'являтиметься в результатах пошуку, доки ця директива залишається на місці.
Де цей статус відображається в GSC
У старому звіті «Покриття» (у 2022 році його замінив звіт «Індексування сторінок») цей статус був у розділі «Виключено». У поточному звіті «Індексування сторінок» (Індексування › Сторінки) ви знайдете його в розділі «Не проіндексовано», у таблиці «Чому сторінки не індексуються», з причиною «Виключено тегом 'noindex'». Google групує всі уражені URL-адреси під цим статусом, щоб ви могли експортувати й переглянути їх оптом.
Як Google виявляє та виконує директиву noindex
У документації Google про блокування індексування за допомогою noindex описано два способи передачі: тег <meta name="robots" content="noindex"> у розділі <head> HTML-коду сторінки або директива X-Robots-Tag: noindex у заголовках HTTP-відповіді. Коли Googlebot натрапляє на будь-який із них, він повністю видаляє сторінку з індексу, навіть якщо раніше вона була проіндексована. Основи самого тегу описано в нашому посібнику про метатег noindex.
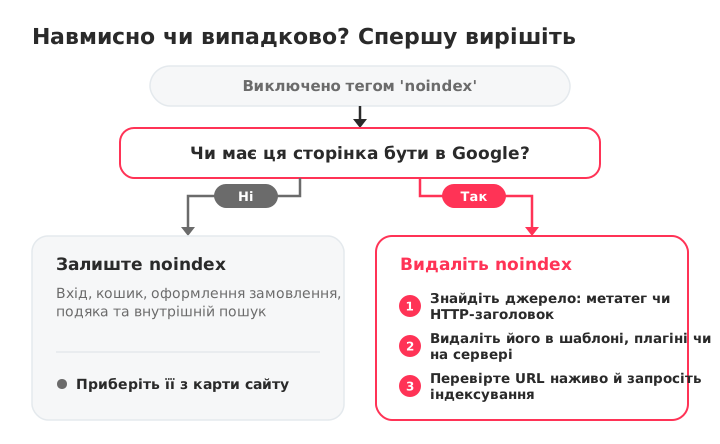
Чи це завжди проблема? Коли виключення навмисне
Не кожна URL-адреса зі статусом «Виключено тегом 'noindex'» є помилкою. Сторінки адмінпанелі, екрани входу, кошик і оформлення замовлення, сторінки подяки та результати внутрішнього пошуку навмисно не допускаються до індексу Google. Якщо такі сторінки мають цей статус, система працює як задумано. Справжня проблема починається тоді, коли цей статус мають сторінки, які ви хочете ранжувати.
Поширені причини статусу «Виключено тегом 'noindex'»
Директива noindex може потрапити на сторінку кількома різними шляхами. Від того, який із них активний на вашому сайті, залежить рішення.
Метатег robots із «noindex» у <head>
Найпоширеніше джерело. Рядок на кшталт <meta name="robots" content="noindex"> в HTML-коді сторінки повідомляє Googlebot, що її не слід індексувати. Його можуть жорстко прописати в шаблоні або динамічно додавати CMS, плагін чи функція теми.
X-Robots-Tag у заголовках HTTP-відповіді
X-Robots-Tag працює так само, як метатег, але розміщується в заголовку HTTP-відповіді, а не в HTML. Його можуть додавати конфігурація сервера, правила CDN або директиви .htaccess. Наприклад:
Header set X-Robots-Tag "noindex"
Це впливає на кожен файл, що відповідає правилу, зокрема на PDF-файли та зображення, які не мають розділу <head> в HTML. Багато власників сайтів повністю ігнорують цей шлях, бо директиву не видно у вихідному коді сторінки.
Налаштування CMS, які випадково блокують індексування
У WordPress у розділі Налаштування › Читання є прапорець «Попросити пошукові системи не індексувати сайт». Коли його встановлено, WordPress додає тег robots noindex на кожну сторінку сайту. Багато власників вмикають його під час розробки й забувають зняти після запуску.
Shopify може застосовувати noindex через код теми або застосунки. Деякі сторінки облікового запису та системні сторінки Shopify сам виключає з індексу, і це правильно, але редагування теми чи SEO-застосунок може помилково додати noindex на сторінки товарів, колекцій або блогу.
Wix застосовує noindex до будь-якої сторінки, SEO-налаштування якої забороняють пошуковим системам її індексувати. Типова причина: сторінку дублюють, і копія непомітно успадковує налаштування noindex оригіналу.
Конфлікти плагінів або теми, що додають noindex
SEO-плагіни дають змогу встановлювати noindex для окремого запису, сторінки чи типу вмісту. Неправильно налаштоване глобальне правило, оновлення плагіна, яке скидає налаштування, або тема, що перевизначає директиви плагіна, можуть одночасно поширити noindex на десятки сторінок. Якщо ви нещодавно оновили плагін або змінили тему, перевірте це насамперед.
Налаштування staging-середовища, перенесені в продакшн
Напрочуд поширене джерело випадкових тегів noindex. Ваш staging-сайт використовує noindex, щоб не потрапити в Google. Коли процес збирання переносить конфігурацію staging у продакшн, директива noindex потрапляє туди разом із нею. Зазвичай це зачіпає цілі розділи сайту одночасно і є однією з найважчих для діагностики причин, якщо ви перевіряєте лише окремі сторінки.
Як визначити, яких сторінок це стосується
Повторюваний процес діагностики виявляє всі уражені URL-адреси без здогадок. Почніть із Search Console, щоб отримати список, а потім перейдіть до окремих сторінок, щоб знайти джерело.
Експорт уражених URL-адрес через звіт «Індексування сторінок»
Відкрийте Google Search Console і перейдіть до Індексування › Сторінки. Натисніть «Виключено тегом 'noindex'» у таблиці «Чому сторінки не індексуються». Search Console показує вибірку уражених URL-адрес; скористайтеся кнопкою Експортувати, щоб завантажити список для подальшої роботи.
Перевірка однієї URL-адреси інструментом перевірки URL-адрес
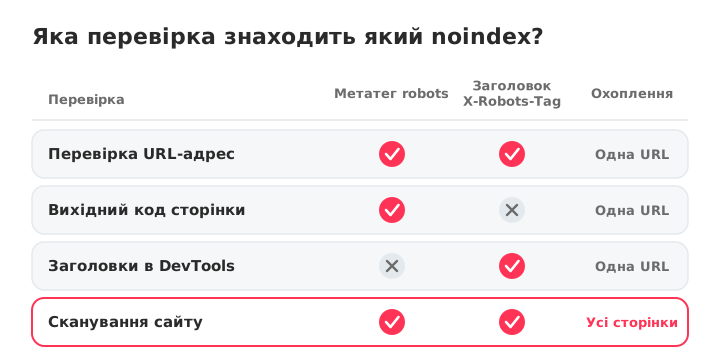
Вставте будь-яку URL-адресу в рядок пошуку вгорі Search Console. Інструмент перевірки URL-адрес показує, чи бачив Google директиву noindex і де саме її знайшов: у пункті «Індексування дозволено?» зазначено, чи noindex надійшов із метатегу robots, чи з HTTP-заголовка X-Robots-Tag. Натисніть View crawled page («Переглянути проскановану сторінку»), щоб побачити точний HTML, який отримав Googlebot. Це найшвидша доступна перевірка однієї сторінки.
Пошук метатегів noindex у вихідному коді сторінки
Відкрийте сторінку в браузері, клацніть правою кнопкою миші та виберіть Переглянути вихідний код сторінки, а потім пошукайте «noindex» (Ctrl+F або Cmd+F). Якщо ви знайдете <meta name="robots" content="noindex"> або щось подібне, винуватцем є метатег. Якщо у вихідному коді його немає, директива, імовірно, надходить з HTTP-заголовка.
Перевірка HTTP-заголовків у DevTools браузера
Відкрийте DevTools (F12 або клацання правою кнопкою › Дослідити), перейдіть на вкладку Network, перезавантажте сторінку та натисніть на запит основного документа. Шукайте X-Robots-Tag: noindex у розділі Response Headers. Це єдиний спосіб у браузері виявити директиви noindex у заголовках, які не відображаються в HTML.
Сканування сайту за допомогою Screaming Frog або SEOcrawl AI
Для діагностики всього сайту краулер виявляє кожну уражену сторінку за один прохід. Screaming Frog SEO Spider може фільтрувати сторінки за можливістю індексування з урахуванням метатегів і заголовків. Crawler від SEOcrawl AI сканує кожну сторінку, позначає всі сторінки з директивою noindex у розділі Indexability і повертає Audit Health Score, тож ви бачите повний масштаб проблеми без ручного експорту та фільтрації.
Як виправити «Виключено тегом 'noindex'»: крок за кроком
Це найпрактичніший розділ. Застосуйте рішення, яке відповідає вашій діагностиці з попереднього розділу.
Видалення метатегу noindex із коду сторінки
Відредагуйте шаблон або вміст сторінки, щоб прибрати <meta name="robots" content="noindex"> з розділу <head> HTML. На сайтах, розроблених під замовлення, перевірте безпосередньо файли шаблонів. Якщо тег додає JavaScript, знайдіть відповідальний скрипт і видаліть його або додайте умову.
До:
<meta name="robots" content="noindex">
Після:
<meta name="robots" content="index, follow">
Або просто повністю видаліть тег. Google вважає відсутність директиви noindex дозволом на індексування.
Виправлення X-Robots-Tag у конфігурації сервера або CDN
Перевірте .htaccess (Apache), nginx.conf (Nginx) або правила CDN на наявність директив X-Robots-Tag: noindex. Видаліть їх або обмежте конкретними шляхами, які мають бути виключені, а не сторінками, які ви хочете індексувати. Наприклад, можна залишити noindex на /staging/ і прибрати його з /blog/.
Як виправити у WordPress
Дві перевірки в такому порядку:
- Налаштування для всього сайту: перейдіть до Налаштування › Читання і зніміть прапорець «Попросити пошукові системи не індексувати сайт». Це найпоширеніша причина проблем із noindex на всьому сайті у WordPress.
- Налаштування окремих сторінок у SEO-плагінах:
- Yoast SEO: відкрийте запис або сторінку, прокрутіть до блоку Yoast, відкрийте вкладку Advanced і встановіть для «Allow search engines to show this content in search results?» значення «Yes».
- Rank Math: відкрийте запис, перейдіть до блоку Rank Math, відкрийте вкладку Advanced і встановіть для «Robots Meta» значення «Index».
- All in One SEO: відредагуйте запис, відкрийте вкладку Advanced у налаштуваннях AIOSEO і переконайтеся, що в налаштуваннях robots не позначено «No Index».
Також перевірте глобальні налаштування кожного плагіна: чи не встановлено noindex для цілих типів вмісту (позначок, категорій, користувацьких типів записів). Решту налаштувань WordPress описано в нашому посібнику про підключення WordPress до Google Search Console.
Як виправити в Shopify
У Shopify noindex зазвичай походить із коду теми або застосунку. Відкрийте Online Store › Themes › Edit code і пошукайте у theme.liquid та шаблонах сторінок метатег robots із noindex. Потім перевірте SEO-застосунки на правила, що приховують товари, колекції або публікації блогу, а також будь-які товари чи сторінки з метаполем seo.hidden. Сторінки облікового запису та інші системні сторінки Shopify виключає з індексу сам, і так має залишатися.
Як виправити у Wix, Squarespace та інших конструкторах сайтів
Wix: відкрийте SEO-налаштування сторінки (з меню сторінки) і ввімкніть «Let search engines index this page». Якщо ви дублювали сторінку, копія могла успадкувати налаштування noindex від оригіналу.
Squarespace: перевірте SEO-налаштування всього сайту на наявність опції, яка приховує сайт від пошукових систем. Для окремих сторінок відкрийте налаштування сторінки та знайдіть «Hide page from search results» на вкладці SEO. Squarespace також за замовчуванням виключає з результатів пошуку деякі системні сторінки, наприклад кошик.
Після виправлення: запит на повторне індексування в Google Search Console
Видалення тегу noindex повідомляє Google, що він може індексувати сторінку, але Googlebot усе одно має просканувати її повторно, щоб підтвердити зміну.
Запит на індексування через інструмент перевірки URL-адрес
Вставте виправлену URL-адресу в рядок пошуку Search Console. Натисніть Test live URL («Перевірити URL-адресу в реальному часі»), щоб підтвердити, що індексування тепер дозволено, а потім натисніть Request indexing («Надіслати запит на індексування»). Google додасть URL-адресу до черги на повторне сканування. Так можна надіслати кілька URL-адрес, але Search Console обмежує кількість запитів на день.
Скільки часу потрібно Google, щоб повторно проіндексувати сторінку?
Зазвичай від кількох днів до кількох тижнів, залежно від того, як часто Googlebot сканує ваш сайт. Сайти з високим трафіком і частими оновленнями скануються повторно швидше; нові або маловідвідувані сайти можуть чекати тижнями. Запит на індексування є найшвидшим сигналом, який ви можете надіслати, але не гарантією: він ставить URL-адресу в чергу сканування, а не примушує до негайного повторного сканування.
Надсилання оновленої XML-карти сайту для пришвидшення сканування
Якщо ви виправили багато сторінок одночасно, надішліть оновлену XML-карту сайту у розділі Файли Sitemap у Search Console. Це сигналізує, що ваш сайт змінився, і заохочує ширше повторне сканування. Чиста карта сайту без URL-адрес із noindex також дає змогу уникнути суперечливих сигналів, про які йдеться далі.
Коли варто залишити тег noindex (навмисні виключення)
Не кожен тег noindex потрібно видаляти. Деякі сторінки ніколи не мають з'являтися в результатах пошуку, а їхнє індексування додає слабкі або дубльовані сторінки до того, як Google бачить ваш сайт, і марнує ресурс сканування.
Сторінки, які ніколи не слід індексувати
- Сторінки входу та реєстрації
- Сторінки кошика, оформлення та підтвердження замовлення
- Сторінки результатів внутрішнього пошуку (щоб уникнути дубльованого вмісту)
- Сторінки подяки (лід-магніти, надсилання форм)
- Сторінки адмінпанелі та бекенду
- Staging-середовища та середовища розробки
- Сторінки фільтрів і параметрів, що генерують дубльовані URL-адреси
noindex чи robots.txt: ключові відмінності
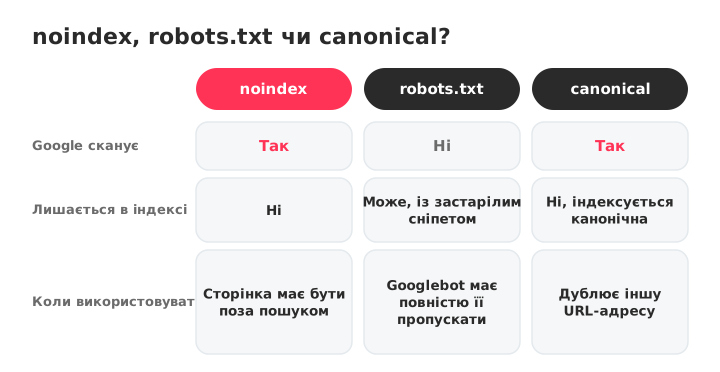
robots.txt блокує сканування. noindex дозволяє сканування, але блокує індексування. Якщо ви заблокуєте сторінку в robots.txt, Googlebot ніколи її не прочитає, а отже, ніколи не побачить і тег noindex. Якщо хочете прибрати сторінку з індексу, використовуйте noindex. Якщо хочете, щоб Googlebot повністю пропускав сторінку (щоб заощадити бюджет сканування), використовуйте robots.txt.
Поширена помилка: використовувати robots.txt, щоб заблокувати вже проіндексовану сторінку. Google не бачить тег noindex, якщо не може просканувати сторінку, тому URL-адреса може залишитися в індексі із застарілим заголовком і сніпетом. Правильний підхід: дозволити сканування й використати noindex, щоб прибрати сторінку з індексу.
Теги canonical чи noindex: вибір правильної директиви
Тег canonical (rel="canonical") каже Google: «ця сторінка є копією іншої URL-адреси, ранжуй ту». Тег noindex каже Google: «взагалі не індексуй цю сторінку». Вони мають різне призначення:
- Використовуйте canonical, коли маєте дубльований або майже дубльований вміст і хочете об'єднати сигнали ранжування на одній URL-адресі.
- Використовуйте noindex, коли сторінка за жодних умов не має з'являтися в результатах пошуку.
Поєднання обох на одній сторінці надсилає суперечливі сигнали: один каже «об'єднай цю сторінку з іншою URL-адресою», інший каже «відкинь її». Виберіть той, що відповідає вашій меті.
Як запобігти випадковим тегам noindex у майбутньому
Виправляти проблеми з noindex за фактом необхідно, але запобігання їм економить години діагностики та втраченого трафіку.
Налаштування сповіщень Search Console про падіння індексування
Google Search Console надсилає електронні листи підтвердженим власникам і користувачам, коли виявляє нові проблеми з індексуванням ресурсу. Переконайтеся, що сповіщення електронною поштою ввімкнено в налаштуваннях електронної пошти Search Console. Якщо кількість проіндексованих сторінок раптово падає, сповіщення дає вам фору, перш ніж упаде трафік.
Додавання перевірок noindex до чекліста QA перед запуском
Перш ніж розгортати будь-який сайт або переносити staging у продакшн, перевірте наявність директив noindex. 30-секундна перевірка через «Переглянути вихідний код сторінки» з пошуком «noindex» виявляє найпоширенішу помилку розгортання. Для великих сайтів проскануйте сайт до і після розгортання та порівняйте кількість сторінок із noindex. Додайте це до свого чекліста технічного SEO, щоб ніхто цього не пропускав.
Сканування за розкладом для виявлення небажаних директив noindex
Запускайте повне сканування за розкладом, а також після кожного оновлення плагінів, зміни теми чи міграції, щоб виявляти небажані теги noindex, перш ніж вони коштуватимуть вам трафіку. Crawler від SEOcrawl AI дає змогу порівнювати сканування, тож ви бачите, які сторінки отримали noindex і коли, а SEO Monitor сповіщає вас, щойно одна з ключових сторінок отримує тег noindex.
Поширені запитання
Що означає статус «Виключено тегом 'noindex'» у Google Search Console?
Це означає, що Google знайшов на вашій сторінці директиву noindex і виконав її, тому сторінка не з'являтиметься в результатах пошуку. Статус відображається у звіті «Індексування сторінок» у Search Console, у розділі «Не проіндексовано».
Це не завжди помилка: сторінки, які ви виключаєте навмисно, наприклад сторінки входу чи оформлення замовлення, і мають мати цей статус.
Як виправити «Виключено тегом 'noindex'» у WordPress?
Перевірте два місця в такому порядку. Спочатку відкрийте Налаштування › Читання і переконайтеся, що прапорець «Попросити пошукові системи не індексувати сайт» знято. Потім відкрийте кожен уражений запис чи сторінку у вашому SEO-плагіні (Yoast, Rank Math, All in One SEO) і перевірте, що налаштування robots для сторінки дозволяє індексування.
Скільки часу потрібно Google, щоб проіндексувати сторінку після видалення noindex?
Зазвичай від кількох днів до кількох тижнів, залежно від того, як часто Googlebot сканує ваш сайт. Після видалення директиви надішліть запит на індексування через інструмент перевірки URL-адрес і подайте оновлену XML-карту сайту, щоб пришвидшити процес. Сайти з високим трафіком скануються повторно швидше, ніж нові або маловідвідувані.
Чи може сторінку бути виключено через noindex, навіть якщо вона є в моїй карті сайту?
Так. Директива noindex має пріоритет над включенням до карти сайту. Google може й далі сканувати URL-адресу з карти сайту, але не індексуватиме її, доки там є noindex.
Або видаліть noindex, щоб сторінку можна було проіндексувати, або приберіть URL-адресу з карти сайту, якщо виключення навмисне. Додавання URL-адрес із noindex до карти сайту надсилає суперечливі сигнали.
Яка різниця між noindex і блокуванням сторінки в robots.txt?
robots.txt забороняє Googlebot сканувати сторінку; noindex дозволяє сканування, але забороняє індексування. Якщо ви заблокуєте сторінку в robots.txt, Google не зможе прочитати тег noindex, тож уже проіндексована сторінка може залишитися в індексі із застарілим вмістом. Використовуйте noindex, щоб прибрати сторінку з індексу, а robots.txt лише тоді, коли хочете повністю заборонити сканування.
Як перевірити, чи має сторінка тег noindex?
Три способи, від найшвидшого до найретельнішого: скористайтеся інструментом перевірки URL-адрес у Search Console, перегляньте вихідний код сторінки й пошукайте «noindex» (Ctrl+F) або перевірте заголовки HTTP-відповіді в DevTools браузера (вкладка Network, шукайте X-Robots-Tag). Лише інструмент перевірки URL-адрес і DevTools виявляють noindex, надісланий у заголовку.
Чи варто хвилюватися, якщо багато сторінок мають статус «Виключено тегом 'noindex'»?
Лише якщо ці сторінки мають бути проіндексовані. Експортуйте список із Search Console, порівняйте його зі своїми навмисними виключеннями (вхід, кошик, адмінпанель, сторінки подяки) і виправляйте лише ті сторінки, які мають ранжуватися в пошуку. Якщо кожна уражена сторінка виключена вами свідомо, статус працює правильно.
Автор: David Kaufmann

Останні 10+ років я повністю занурений у SEO — і чесно кажучи, не хотів би інакше.
Моя кар'єра вийшла на новий рівень, коли я працював старшим SEO-спеціалістом у Chess.com — одному зі 100 найвідвідуваніших сайтів у всьому інтернеті. Робота в такому масштабі навчила мене того, чого не дав би жоден курс чи сертифікат.
З цього досвіду я заснував SEO Alive — агенцію для брендів, які серйозно ставляться до органічного зростання. І оскільки не знайшов інструмента, що добре справляється з обома світами — класичним і AI, побудував SEOcrawl AI. Якщо ви шукаєте досвідченого SEO-партнера, який любить цю справу — буду радий поговорити!
Дізнайтесь більше контенту цього автора