Проскановано – наразі не проіндексовано: що це означає і як це виправити

Google відвідав вашу URL-адресу, прочитав сторінку й не включив її в пошук. Розповідаємо, як зрозуміти, які сторінки заслуговують на другий шанс, і як, за словами Google, повернути їх в індекс.
Проскановано – наразі не проіндексовано означає, що Googlebot завантажив вашу сторінку й вирішив не додавати її до індексу Google, тож вона не може з'явитися в пошуку. Довідка щодо звіту про індексування сторінок пояснює це так: сторінку проскановано, але не проіндексовано, і її «може бути проіндексовано в майбутньому, а може й ні».
Причина зазвичай у самій сторінці, а не в технічному блокуванні. Нижче ви дізнаєтеся, як для кожної URL-адреси вирішити, чи сторінку виправити, закрити noindex чи видалити, і скільки, за словами Google, триває виправлення. Тільки починаєте працювати зі звітом? Почніть із цього посібника з Google Search Console.
Що означає «Проскановано – наразі не проіндексовано»?
Статус означає, що Google просканував сторінку й вирішив її не індексувати. Ніщо не блокувало Googlebot: Google вирішив поки що не включати сторінку. Дві відмінності допоможуть правильно прочитати цей статус.
Сканування й індексування
Сканування — це завантаження сторінки роботом Googlebot. Індексування — це збереження сторінки в Google, щоб вона могла показуватися в пошуку. Сторінку можна сканувати багато разів, і вона все одно ніколи не потрапить до індексу.
Довідка щодо інструмента перевірки URL-адрес каже, що якість сторінки має бути «достатньо високою, щоб виправдати індексування», а перевірка в реальному часі взагалі не може виявити цей статус.
Чим він відрізняється від «Виявлено – наразі не проіндексовано»
Виявлено – наразі не проіндексовано — це крок раніше: Google знайшов URL-адресу, але відклав сканування, щоб не перевантажувати ваш сайт, тож дата останнього сканування порожня.
| Виявлено – наразі не проіндексовано | Проскановано – наразі не проіндексовано | |
|---|---|---|
| Чи сканував Google? | Ні | Так |
| Дата останнього сканування | Порожня | Вказана |
| Звичайна причина | Сканування відкладено, щоб не перевантажувати сайт | Google прочитав сторінку й пропустив її |
| Що перевіряти першим | Можливості сканування дуже великих сайтів | Якість контенту, дублікати, canonical |
Google також каже: «Те, що сторінку не проіндексовано, не обов'язково погано». Сторінки з noindex, URL-адреси, заблоковані в robots.txt, дублікати та 404 без заміни й мають лишатися поза індексом.
Чому Google сканує сторінки, але не індексує їх
Індексування має планку якості, якої немає в сканування. Посібник Google щодо бюджету сканування каже, що потреба в скануванні зростає разом із цінністю та унікальністю вашого контенту.
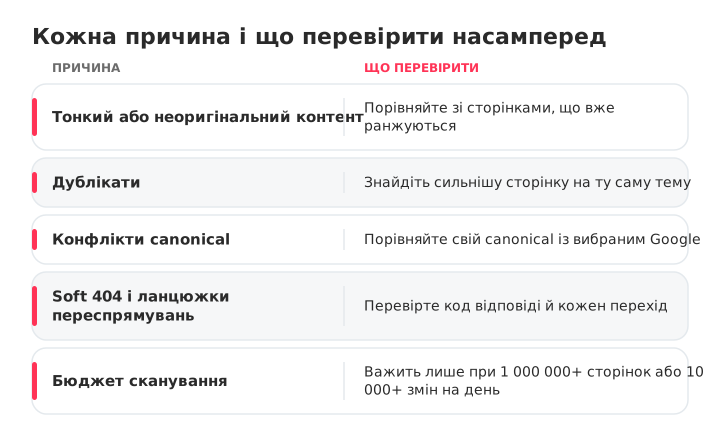
Більшість уражених URL-адрес підпадає під одну з цих причин, і в кожної своя перша перевірка:
- Тонкий або неоригінальний контент: сторінка повторює те, що вже ранжується.
- Дублікати: архіви тегів, URL-адреси із сортуванням, дві статті на одну тему. Ось як виявити й усунути канібалізацію ключових слів.
- Конфлікти canonical: порівняйте задекларовану канонічну URL-адресу з тією, яку вибрав Google. Коли Google вибирає іншу URL-адресу, сторінка зазвичай переходить у статус Альтернативна сторінка з належним канонічним тегом або в один зі статусів дублікатів.
- Soft 404 і ланцюжки переспрямувань: Google каже, що soft 404 марнують бюджет сканування.
- Бюджет сканування: він важить для сайтів із 1 000 000+ сторінок, що змінюються щотижня, або з 10 000+ сторінок, що змінюються щодня. Для більшості сайтів причина не в ньому.
Планка піднімалася у два етапи. 18 серпня 2022 року Google оголосив про helpful content update — сигнал на рівні всього сайту — і зазначив, що видалення некорисного контенту може допомогти решті сайту. 5 березня 2024 року Google оголосив про core update, який мав показувати менше контенту, створеного заради кліків, разом із новою політикою проти спаму у вигляді масово створюваного контенту.
Рекомендації Google щодо корисного контенту кажуть, що E-E-A-T не є окремим чинником ранжування, що найважливіша довіра і що бажаної кількості слів немає. Роздування тексту сторінку не виправить.
Як знайти й діагностувати уражені сторінки в GSC
Відкрийте звіт «Індексування сторінок» (раніше — звіт «Покриття»), перевірте вибірку й згрупуйте список за закономірностями. Google зазначає, що сайтам із менш ніж 500 сторінками цей звіт, імовірно, не потрібен.
Пошук уражених URL-адрес у звіті «Сторінки»
- У Google Search Console перейдіть до розділу Індексування › Сторінки.
- У таблиці «Чому сторінки не індексуються» натисніть Проскановано – наразі не проіндексовано.
- Натисніть Експортувати й завантажте список.
Звіт показує до 1000 прикладів URL-адрес, не обов'язково всі, тож на великому сайті експорт — це вибірка.
Перевірка сторінок інструментом перевірки URL-адрес
Перевірте п'ять–десять експортованих URL-адрес: подивіться дату останнього сканування та канонічну сторінку, вибрану Google. Якщо канонічна URL-адреса вказує на іншу сторінку, Google бачить дублікат; дата сканування кількамісячної давнини свідчить, що Google повертається рідко.
Пошук закономірностей серед сотень URL-адрес
Відсортуйте експорт за папкою, шаблоном і параметром URL, потім порахуйте кожну групу. Припустімо, 300 URL-адрес поділяються на 180 сторінок /tag/, 70 URL-адрес із ?sort= і 50 статей: це три рішення, а не 300.
Виправити, закрити noindex чи видалити: вирішіть, на що заслуговує кожна URL-адреса
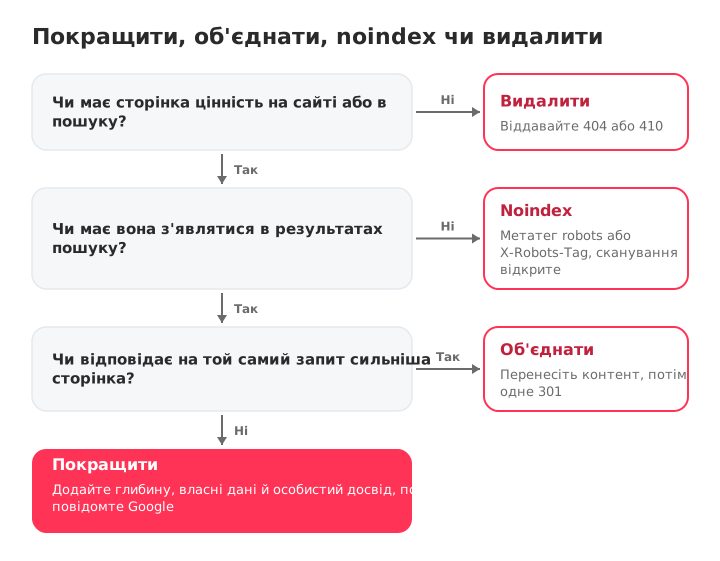
Кожна URL-адреса заслуговує на один із чотирьох результатів. Запитайте себе: чи буде користувач радий потрапити сюди і чи це єдина сторінка на сайті, яка відповідає на запит?
| Тип сторінки | Приклад | Рішення | Як |
|---|---|---|---|
| Корисна й унікальна, але тонка | Посібник на 300 слів на тему, у якій ви розбираєтеся | Покращити | Додайте глибину й особистий досвід |
| Дублює сильнішу сторінку | Дві статті під один запит | Об'єднати | Перенесіть контент, потім переспрямування 301 |
| Корисна на сайті, але не в пошуку | Архіви тегів, внутрішній пошук, сторінки подяки | Noindex | Метатег robots або X-Robots-Tag |
| Без цінності й без заміни | Прострочені акції, тестові сторінки | Видалити | Віддавайте 404 або 410 |
Посібник Google щодо бюджету сканування підтверджує два останні рядки: для видалених сторінок віддавайте 404 або 410 й об'єднуйте дублікати. Помилка 404 у Search Console очікувана для сторінок, які ви видалили навмисно.
Саме з noindex сортування найчастіше йде не так:
Не так: тег noindex на сторінках /tag/, тоді як robots.txt блокує /tag/. Googlebot не може завантажити сторінки, тож ніколи не побачить тег.
А так: /tag/ лишається доступним для сканування й містить noindex у метатегу або в заголовку X-Robots-Tag.
Згідно з документацією Google щодо noindex, це правило не працює всередині robots.txt, а на рідко відвідуваних сторінках повторне сканування може тривати місяцями. Щойно тег буде прочитано, ці URL-адреси перейдуть у статус Виключено тегом 'noindex', і для них це саме те, що потрібно.
Як виправити сторінки, варті індексування
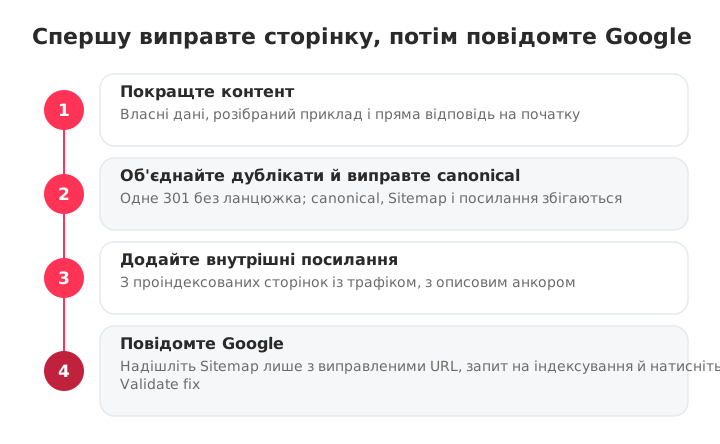
Спершу зробіть сторінку вартою індексування, потім повідомте про це Google. Запит на індексування незміненої сторінки просить Google повторити рішення, яке він уже ухвалив. Порядок:
- Покращте контент.
- Об'єднайте дублікати й виправте canonical.
- Додайте внутрішні посилання.
- Надішліть окремий Sitemap і запит на індексування.
Зробіть контент глибшим і оригінальнішим
Переписуйте під запит, а не під кількість слів: додайте власні дані, знімки екрана, розібраний приклад і пряму відповідь на початку.
Наприклад, візьміть тонкий посібник на 300 слів: додайте власний набір даних і розібраний приклад, поставте на нього посилання з двох статей, які вже мають трафік, і лише після цього додайте його до окремого Sitemap.
Об'єднайте дублікати й виправте canonical
Якщо дві URL-адреси присвячені тому самому, залиште одну, перенесіть до неї корисний контент і налаштуйте з іншої переспрямування 301 безпосередньо на неї, без ланцюжка. Потім переконайтеся, що canonical, Sitemap і внутрішні посилання узгоджені й ніде не лишився випадковий noindex.
Додайте внутрішні посилання зі сторінок, які Google уже цінує
Поставте посилання на кожну виправлену сторінку з проіндексованих сторінок із трафіком, використовуючи описовий анкор. Будь-який краулер сайту покаже сторінки-сироти (без внутрішніх посилань), якщо відфільтрувати сторінки з нулем вхідних посилань. Повна методика — у посібнику зі стратегії внутрішньої перелінковки.
Також перевірте сторінку на телефоні й у звіті «Основні веб-показники»: зламану мобільну версію легко швидко виключити.
Надішліть окремий Sitemap і запит на індексування
Створіть файл Sitemap лише з виправленими URL-адресами, надішліть його й відфільтруйте за ним звіт «Сторінки», перш ніж натиснути Validate fix («Перевірити виправлення»). Google радить так робити, щоб пришвидшити перевірку. Якщо спершу потрібен поточний файл, знайдіть Sitemap свого сайту.
Google ігнорує priority і changefreq, тож краще стежте за точністю lastmod. Потім натисніть Request indexing («Надіслати запит на індексування») в інструменті перевірки URL-адрес для пріоритетних URL-адрес: Google застосовує квоту і зазначає, що повторні запити нічого не пришвидшують.
Скільки триває індексування після виправлення?
Розраховуйте на термін від дня до кількох тижнів, і індексування ніколи не гарантоване. Google називає різні терміни на різних сторінках, тож зведемо їх разом:
| Що ви зробили | Що каже Google | Джерело |
|---|---|---|
| Попросили Google повторно просканувати | Від кількох днів до кількох тижнів | Як надіслати запит на повторне сканування |
| Request indexing | Зазвичай близько доби, до одного-двох тижнів, з денним лімітом | Довідка щодо перевірки URL-адрес |
| Validate fix | До приблизно двох тижнів, іноді значно довше | Довідка щодо індексування сторінок |
Це терміни Google, а не кейси відновлення. Перевіряйте звіт «Сторінки» щотижня; якщо після цих термінів виправлені URL-адреси не зрушили, повертайтеся до контенту.
Як не допустити, щоб нові сторінки потрапляли в цей статус
Профілактика — це рутина: перевіряйте кожну сторінку перед публікацією і щомісяця переглядайте Search Console. Перед публікацією переконайтеся, що сторінка:
- Відповідає на запит, на який не відповідає жодна інша сторінка сайту.
- Містить ваші власні дані, приклади або досвід.
- Має canonical, що вказує на саму себе, і не містить випадкового noindex.
- Є в Sitemap з точним lastmod.
- Має зазначеного автора і, де доречно, структуровані дані.
- Отримує посилання з пов'язаної проіндексованої сторінки.
Раз на місяць порівнюйте звіт «Сторінки» з попереднім місяцем; проблема лишається в списку 90 днів після зникнення останнього випадку. Сайтам із понад тисячею сторінок варто також стежити за звітом «Статистика сканування».
SEOcrawl AI бере на себе технічний бік у масштабі. Crawler сканує кожну сторінку й видає Audit Health Score із проблемами, розбитими за категоріями Indexability, Crawlability, On-Page та іншими. Його подання Indexation групує ваші URL-адреси за статусом покриття в Search Console, тож ви бачите, скільки з них мають статус «Проскановано – наразі не проіндексовано», і можете відстежувати це число в часі.
Між скануваннями SEO Monitor попереджає вас, коли важлива сторінка отримує noindex, змінює canonical, віддає 404 або випадає з Sitemap. Та сама платформа відстежує видимість вашого бренду в ChatGPT, Claude, Gemini, Perplexity і Copilot, тож SEO і GEO зібрано в одному місці.
Поширені запитання
Що означає статус «Проскановано – наразі не проіндексовано»?
Це означає, що Googlebot завантажив вашу сторінку й вирішив не додавати її до індексу Google, тож вона не може з'явитися в пошуку. Скануванню ніщо не заважало: Google прочитав сторінку й поки що вирішив її не включати. Це не ручна санкція, і сторінку може бути проіндексовано в майбутньому, а може й ні.
Це те саме, що «Виявлено – наразі не проіндексовано»?
Ні. «Виявлено» означає, що Google знає URL-адресу, але відклав сканування, тож дата останнього сканування порожня. «Проскановано» означає, що Google уже відвідав і прочитав сторінку, а потім вирішив її не індексувати. У разі «Виявлено» дивіться на можливості сканування дуже великих сайтів; у разі «Проскановано» — на якість контенту, дублікати й canonical.
Чи шкодить статус «Проскановано – наразі не проіндексовано» SEO?
Сам собою ні: статус не є санкцією, і уражена сторінка втрачає лише власний пошуковий трафік. Ризик в обсязі, бо Google сприймає велику частку некорисного контенту як сигнал на рівні всього сайту. Архів тегів поза індексом нічого не коштує; сторінка товару — коштує. Якщо кількість таких сторінок зростає з кожною публікацією, вважайте це проблемою контенту всього сайту, а не списком окремих URL-адрес.
Скільки часу потрібно, щоб сторінку проіндексували після виправлення?
Розраховуйте на термін від одного дня до кількох тижнів, і індексування ніколи не гарантоване. За словами Google, повторне сканування займає від кількох днів до кількох тижнів, Request indexing зазвичай обробляється приблизно за добу, але може тривати тиждень-два, а Validate fix зазвичай триває до приблизно двох тижнів.
Чи допоможе запит на індексування?
Лише після того, як ви зміните сторінку. Запит на індексування незміненої сторінки просить Google повторити рішення, яке він уже ухвалив. Для запитів діє денна квота, а Google зазначає, що повторне надсилання тієї самої URL-адреси нічого не пришвидшує.
Чи допоможе додавання сторінки до XML-файлу Sitemap?
Це допомагає Google знайти URL-адресу, але не проіндексувати її. Google називає надісланий файл Sitemap «лише підказкою», а ці сторінки вже знайдено й прочитано. Після виправлення завдання Sitemap — зібрати в групу URL-адреси, які ви хочете надіслати на повторну перевірку. Один файл Sitemap вміщує до 50 000 URL-адрес або 50 МБ.
Чому перевірка виправлення статусу «Проскановано – наразі не проіндексовано» не вдалася?
Перевірка зупиняється, щойно Google знаходить у групі хоча б одну невиправлену URL-адресу, тож одна забута сторінка може провалити весь пакет. Виправте всі URL-адреси в групі або звузьте групу, відфільтрувавши звіт за файлом Sitemap лише з виправленими URL-адресами, і запустіть перевірку знову.
Як SEOcrawl AI допомагає зі сторінками, які Google сканує, але не індексує?
SEOcrawl AI знаходить причини цього статусу на боці сайту. Crawler показує для кожної URL-адреси оцінку здоров'я, код відповіді HTTP і глибину сканування, тож ви помічаєте сторінки, до яких Google важко дістатися. Подання Indexation групує ваші URL-адреси за статусом покриття в Search Console, а SEO Monitor попереджає вас, коли важлива сторінка отримує noindex, змінює canonical, віддає 404 або випадає з Sitemap.
Автор: David Kaufmann

Останні 10+ років я повністю занурений у SEO — і чесно кажучи, не хотів би інакше.
Моя кар'єра вийшла на новий рівень, коли я працював старшим SEO-спеціалістом у Chess.com — одному зі 100 найвідвідуваніших сайтів у всьому інтернеті. Робота в такому масштабі навчила мене того, чого не дав би жоден курс чи сертифікат.
З цього досвіду я заснував SEO Alive — агенцію для брендів, які серйозно ставляться до органічного зростання. І оскільки не знайшов інструмента, що добре справляється з обома світами — класичним і AI, побудував SEOcrawl AI. Якщо ви шукаєте досвідченого SEO-партнера, який любить цю справу — буду радий поговорити!
Дізнайтесь більше контенту цього автора

