Как попасть в выдачу ChatGPT: руководство по ChatGPT SEO на 2026 год
ChatGPT незаметно стал одним из самых влиятельных каналов открытия нового в интернете. В 2026 году миллионы пользователей получают рекомендации брендов и продуктов прямо из ответов, сгенерированных AI, а не из привычной поисковой выдачи. Если вашего бизнеса в этих ответах нет, вы невидимы для быстро растущей части аудитории.
Что на самом деле значит «ранжироваться» в ChatGPT в 2026 году
В ChatGPT нет позиции 1. Нет выдачи, которую можно отслеживать. Когда пользователь просит ChatGPT порекомендовать инструмент или спрашивает, кто лидирует в категории, модель генерирует ответ. И либо ваш бренд в этом ответе есть, либо его нет.
Как поиск ChatGPT находит и цитирует источники
ChatGPT работает в двух режимах. Когда веб-поиск выключен, он опирается на обучающие данные: всё, что модель усвоила до даты отсечения знаний. Когда веб-поиск включён (а это всё чаще режим по умолчанию), он обращается к Bing в реальном времени, читает контент и синтезирует ответ со встроенными ссылками на источники. Важны оба режима, и реагируют они на разные сигналы.
Чем классическое SEO отличается от оптимизации под AI-поиск
Классическое SEO — это ранжирование страницы по ключевому слову в поисковой выдаче. Оптимизация под AI-поиск — это создание условий, при которых модель достаточно доверяет вашему бренду, чтобы упомянуть его в сгенерированном ответе.
Google вознаграждает релевантность на странице, авторитет ссылочной массы и техническое здоровье сайта. ChatGPT вознаграждает частоту упоминаний бренда, внешнее присутствие и контент, который можно извлечь чисто, без дополнительного контекста. Пересечение есть (бэклинки и E-E-A-T важны в обоих случаях), но веса и сам механизм разные.
Почему позиции в ChatGPT важны для трафика и видимости бренда
ChatGPT обрабатывает более 2,5 млрд сообщений в день. Всё большую их часть составляют запросы на рекомендацию товаров и услуг. Пользователи, получившие рекомендацию от ChatGPT, часто не возвращаются в Google, чтобы её проверить. Выбор AI становится выбором пользователя в 74% случаев (Growth Memo, апрель 2026).
Переходный трафик из AI-источников конвертируется непропорционально хорошо. В 88% сессий в AI Mode пользователи так и не уходили из панели ответа к внешним источникам. Бренд, которого процитировали первым, получает существенное преимущество.

Как ChatGPT выбирает, какие источники цитировать
Понимание механизма цитирования — основа всего остального. Большинство советов по ChatGPT SEO этот шаг пропускают и сразу переходят к тактикам. Это ошибка.
Обучающие данные против поиска в реальном времени
В режиме обучающих данных ChatGPT отвечает на основе того, что усвоил во время предобучения. Бренды и источники, которые часто и авторитетно встречались в вебе до даты отсечения, модель и связывает с конкретной темой. Задним числом на это не повлиять, но можно начать выстраивать сигналы, которые сработают в следующем цикле обучения.
В режиме поиска в реальном времени ChatGPT использует Retrieval-Augmented Generation (RAG): он формулирует поисковый запрос, забирает результаты из Bing, читает контент и синтезирует ответ со ссылками на источники. Именно здесь текущая работа по оптимизации даёт прямой и измеримый эффект.
Как Bing питает живую выдачу ChatGPT
87% цитирований ChatGPT в режиме поиска совпадают с топом результатов Bing (Seer Interactive). Это главная цифра для всех, кто хочет улучшить видимость в ChatGPT. Если ваш сайт хорошо ранжируется в Google, но толком не проиндексирован в Bing, в режиме поиска ChatGPT вас не существует — каким бы хорошим ни был контент.
SEO под Google и видимость в ChatGPT связаны, но это не одно и то же. Сигналы авторитета пересекаются (ссылочная масса, E-E-A-T, доверие к бренду), но механизм разный. У Bing свой краулер, свой индекс и свои факторы ранжирования.
Сигналы авторитета, на которые опирается ChatGPT (E-E-A-T, упоминания бренда, ссылки)
Анализ 2024 года по 82 факторам, коррелирующим с цитированием в ChatGPT, показал, что релевантность (r=0,91) и упоминания бренда (r=0,87) — два самых сильных сигнала, и оба внешние. Структурная оптимизация на странице в число главных драйверов не попала. Это не значит, что on-page не важен, но если вы вкладываете все силы в правки на странице и игнорируете внешнее присутствие, вы оптимизируете не тот слой.

Как retrieval-augmented generation (RAG) влияет на выбор источников
RAG — это механизм, благодаря которому работает живой поиск ChatGPT. Когда пользователь задаёт вопрос с включённым веб-поиском, модель раскладывает запрос на подзапросы, забирает релевантные результаты из Bing, читает контент и отбирает фрагменты, чтобы собрать из них ответ.
Вы можете ранжироваться по fan-out подзапросам (вспомогательным вопросам, которые модель порождает, раскладывая основной запрос), даже если по главному ключевому слову позиций нет. Кроме того, модель отбирает фрагменты, а не страницы. Страница, где нужный ответ похоронен в стене текста, проиграет странице, где ответ умещается в первые 60 слов чётко структурированного раздела.

Наращивайте тематический авторитет, которому доверяют AI-модели
Бренды, которые ChatGPT цитирует чаще всего, не обязательно те, у кого больше всего страниц или выше Domain Authority. Тематический авторитет означает, что модель многократно встречала ваш бренд как достоверный источник по конкретной теме — в вашем собственном контенте, в сторонних упоминаниях и в редакционных материалах.
- Создавайте исчерпывающий экспертный контент по своим ключевым темам. AI-модели предпочитают источники, которые стабильно дают полное освещение темы на экспертном уровне.
- Публикуйте собственные исследования и оригинальные данные. Данные из первых рук, кейсы и оригинальная аналитика — магниты для цитирования, именно они приучают модели считать вас авторитетным источником.
- Показывайте реальный опыт. Рассказы от первого лица, конкретные примеры из практики и подлинные сигналы экспертизы — всё это работает на E-E-A-T.
- Закрывайте всю воронку. Стройте контент, который ведёт тему от вопросов на уровне осведомлённости до сравнений, готовых к конверсии.

Оптимизируйте структуру контента под большие языковые модели
Ясные утвердительные предложения и прямые ответы
Первые 40–60 слов любого раздела должны сразу давать главный ответ. Не подводите к нему издалека. Модели, которая вырезает фрагмент для цитаты, нужен кусок текста, понятный без окружающего контекста.
Избегайте отсылок, зависящих от контекста: «этот подход», «описанный выше метод», «как уже упоминалось». Каждый фрагмент должен быть самодостаточным.

Форматируйте контент заголовками, списками и таблицами, понятными LLM
Структурное форматирование — это сигнал модели о том, как организована информация. Заголовок, сформулированный как вопрос, помогает модели понять, на что отвечает раздел. Маркированные списки и таблицы позволяют модели извлечь структурированную информацию, не разбирая сплошной текст.
Делайте H2 и H3 вопросами, которые пользователи реально задают, а не ключевыми фразами или ярлыками тем.
Пишите короткие определения и резюме, которые AI может взять дословно
Давайте определения технических терминов в том же предложении или в следующем за ним. Вот пример абзаца, готового к цитированию:
Retrieval-Augmented Generation (RAG) — механизм, с помощью которого ChatGPT отвечает на вопросы, используя актуальные данные из веба. Когда пользователь задаёт вопрос с включённым веб-поиском, модель обращается к Bing, забирает релевантные страницы, читает контент и синтезирует ответ со встроенными ссылками на источники. Страницы, которые легко разобрать (чёткая структура, прямые ответы, без стен жаргона), чаще выбираются в качестве источников.
Каждое предложение в этом абзаце самодостаточно. Ни одному из них не нужно предыдущее, чтобы иметь смысл.
Внедрите разметку schema и структурированные данные
Страницы, которые цитирует ChatGPT, в 71% случаев содержат структурированные данные (Rankmax). Самые релевантные схемы:
- FAQPage: хотя в мае 2026 года Google убрал расширенный результат FAQ, схема FAQPage по-прежнему полезна — LLM читают структурированные данные при индексации страниц независимо от того, что Google решил показывать. Ответы на 80–150 слов извлекаются AI лучше, чем ответы на 30 слов, написанные под аккордеон Google.
- Article с Author: явно связывает контент с проверенным человеком и его квалификацией — прямой сигнал E-E-A-T на уровне разметки.
- HowTo: полезна для пошагового контента, где чёткая последовательность облегчает извлечение.
Оптимизируйте под featured snippets (они питают ответы AI)
Контент, оптимизированный под featured snippets (прямой ответ в первом абзаце, заголовки в форме вопроса, структурное форматирование), — это ровно то, что извлекают AI-модели. Две цели оптимизации почти совпадают.
Если ваши страницы забирают featured snippets по информационным запросам в вашей категории, они уже устроены так, как нравится AI-моделям.
Усиливайте цифровой след бренда и внешние сигналы

Получайте авторитетные бэклинки с доверенных доменов
Бэклинки из уважаемых изданий работают вдвойне: они улучшают ваши позиции в Bing (прямой канал в режим поиска ChatGPT) и добавляют модели данных о связи вашего бренда с темой. Одна ссылка с авторитетного домена в вашей отрасли весит больше, чем десятки ссылок с сайтов без авторитета.
Добивайтесь упоминаний в подкастах, на YouTube и в отраслевых изданиях
Участие в профильном подкасте или на YouTube-канале в вашей категории порождает упоминания сразу в нескольких форматах (описания выпусков, расшифровки, обзорные статьи), и каждое из них — отдельная точка данных. Аудио- и видеоконтент всё чаще попадает в обучающие данные LLM.
Наращивайте стабильные упоминания бренда по всему вебу (безссылочные тоже считаются)
Название вашего бренда, встречающееся в релевантных контекстах без гиперссылки (безссылочные упоминания), приучает модель связывать бренд с темой. Частота совместной встречаемости работает независимо от наличия ссылки. Относитесь к бренд-PR, участию в сообществах и earned media как к сигналам AI SEO, а не только к активностям на узнаваемость.
Используйте присутствие в Wikipedia, Wikidata и Knowledge Graph
Wikipedia — один из самых весомых источников в обучающих данных LLM. Статья о вашем бренде в Wikipedia повышает способность модели связать ваше название с конкретной категорией, а это напрямую увеличивает вероятность цитирования. Записи в Wikidata аналогично влияют на попадание в knowledge graph.
Оптимизируйте Google Business Profile и карточки на сторонних площадках
Единообразие названия бренда, описания и категории на разных площадках (Google Business Profile, G2, Capterra, отраслевые каталоги) работает на согласованность сущности. Это говорит моделям, что ваш бренд — стабильная, реальная сущность с чёткой идентичностью, а не разовое упоминание в одном контексте.
Технические основы SEO, которые поддерживают обнаружимость в AI

Убедитесь, что сайт проиндексирован в Bing (а не только в Google)
Подключите Bing Webmaster Tools, отправьте sitemap и проверьте, что ваши самые важные страницы проиндексированы. Учитывая, что 87% цитирований ChatGPT восходят к результатам Bing, это техническое действие с самой высокой отдачей.
Оптимизируйте скорость страниц, Core Web Vitals и мобильный опыт
Медленные страницы и плохой мобильный опыт снижают приоритет сканирования у всех ботов, включая AI-краулеры. Это оптимизации, которые нужны любому контенту, который хочет быть найденным любым краулером, независимо от ChatGPT. Если не уверены, где вы стоите, начните со своих Core Web Vitals.
Используйте чистую архитектуру, доступную для сканирования
Страницы за авторизацией, рендеринг на тяжёлом JavaScript, блокирующий краулеров, или глубоко закопанные URL-структуры — всё это снижает шансы, что AI-системы доберутся до вашего контента. Плоская логичная архитектура с понятной перелинковкой облегчает любому краулеру поиск и индексацию вашего контента.
Настройте robots.txt и llms.txt, чтобы направлять AI-краулеров
Явно проверьте свой файл robots.txt на user-agent'ы AI-краулеров: GPTBot (OpenAI), ClaudeBot (Anthropic), PerplexityBot. Старые широкие правила disallow могут случайно их блокировать. Если AI-краулер заблокирован, эта система не сможет получить ваш контент в режиме поиска.
llms.txt — развивающийся стандарт, который позволяет владельцам сайтов указать, какому контенту AI-системы должны отдавать приоритет при индексации домена. В 2026 году его внедрение пока на раннем этапе, но сделать это сейчас — значит оказаться впереди, когда стандарт станет массовым.
Отправляйте и поддерживайте актуальный XML sitemap
Точный и свежий sitemap, отправленный и в Google Search Console, и в Bing Webmaster Tools, гарантирует, что краулеры найдут ваш контент эффективно. Для сайтов с частыми публикациями динамические sitemap, обновляющиеся автоматически, сокращают задержку между публикацией и индексацией.
Сигналы репутации и доверия, влияющие на рекомендации AI
Собирайте и показывайте отзывы на G2, Trustpilot и в Google
Площадки с отзывами хорошо индексируются и несут сильные сигналы тональности. ChatGPT перенимает тон того, что находит о вашем бренде. Бренд со стабильно положительными отзывами на нескольких площадках описывается иначе, чем бренд со смешанными сигналами. Важны и объём, и свежесть.
Делайте страницы авторов с проверяемой квалификацией
Страница автора с проверяемой квалификацией, историей публикаций и профессиональными профилями даёт модели явные сигналы о том, кто стоит за контентом и почему ему стоит доверять. Связывайте страницы авторов с внешними профилями (LinkedIn, членство в отраслевых ассоциациях), которые модель сможет сверить.
Попадайте в подборки «лучшее» и отраслевые обзоры
Попадание в кураторские подборки от признанных изданий соединяет внешний авторитет с прямой связкой «тема — бренд». Когда модель подтягивает статью «лучшие инструменты в [категории]», чтобы ответить на запрос о рекомендации, шанс быть процитированным получает каждый бренд из этого списка.
Отвечайте на негативные упоминания, чтобы держать тональность бренда
Оставленное без внимания негативное освещение формирует тональность, с которой AI-модели описывают ваш бренд. Бренд с неразрешёнными публичными жалобами или негативом в авторитетных источниках будет описан именно с этими ассоциациями.
Измеряйте и отслеживайте свою видимость в ChatGPT в 2026 году
Инструменты для мониторинга цитирований в AI-поиске и упоминаний бренда
В отличие от Google, для ChatGPT нет Search Console. Без специального отслеживания вы не видите, цитируют ли вас вообще и как вы выглядите на фоне конкурентов.
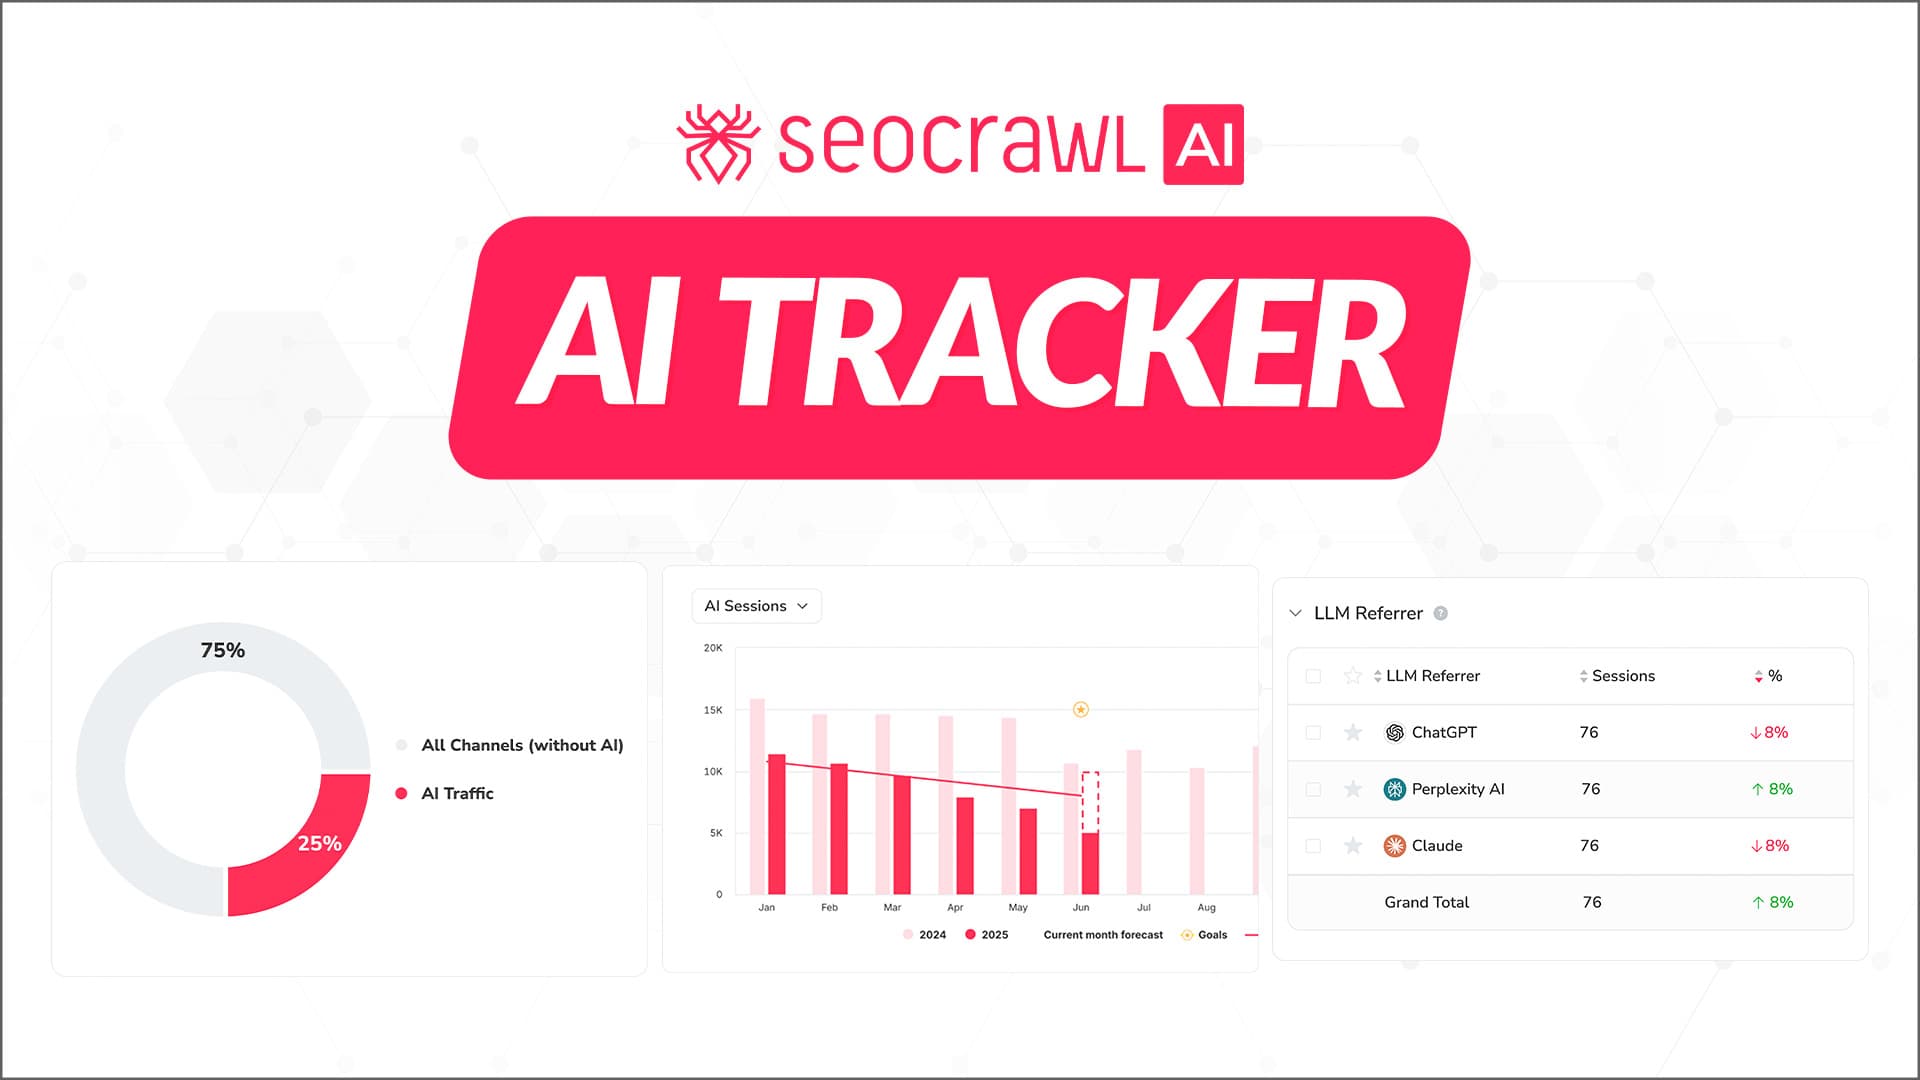
AI Tracker от SEOcrawl AI отслеживает упоминания бренда, долю голоса и тональность в ChatGPT, Claude, Gemini, Perplexity и Copilot и связывает эти данные с вашими классическими позициями и трафиком в одной панели.
Как проверить свою видимость в ChatGPT промптами
Ручной способ не требует инструментов. Задайте в ChatGPT запросы уровня категории: «Какие инструменты в [вашей категории] лидируют?», «Какими провайдерами [вашей категории] чаще всего пользуются крупные команды?», «Сравни [ваш бренд] и [конкурента]». Затем отметьте, появляется ли ваш бренд, где именно и как его описывают.
Но одна проверка может дать обманчивую картину. Для системного отслеживания в масштабе Prompt Tracker от SEOcrawl AI прогоняет ваши промпты в ChatGPT по расписанию и фиксирует каждое упоминание бренда и каждый процитированный URL, так что вы видите точные вопросы, на которых ChatGPT уже рекомендует вас.
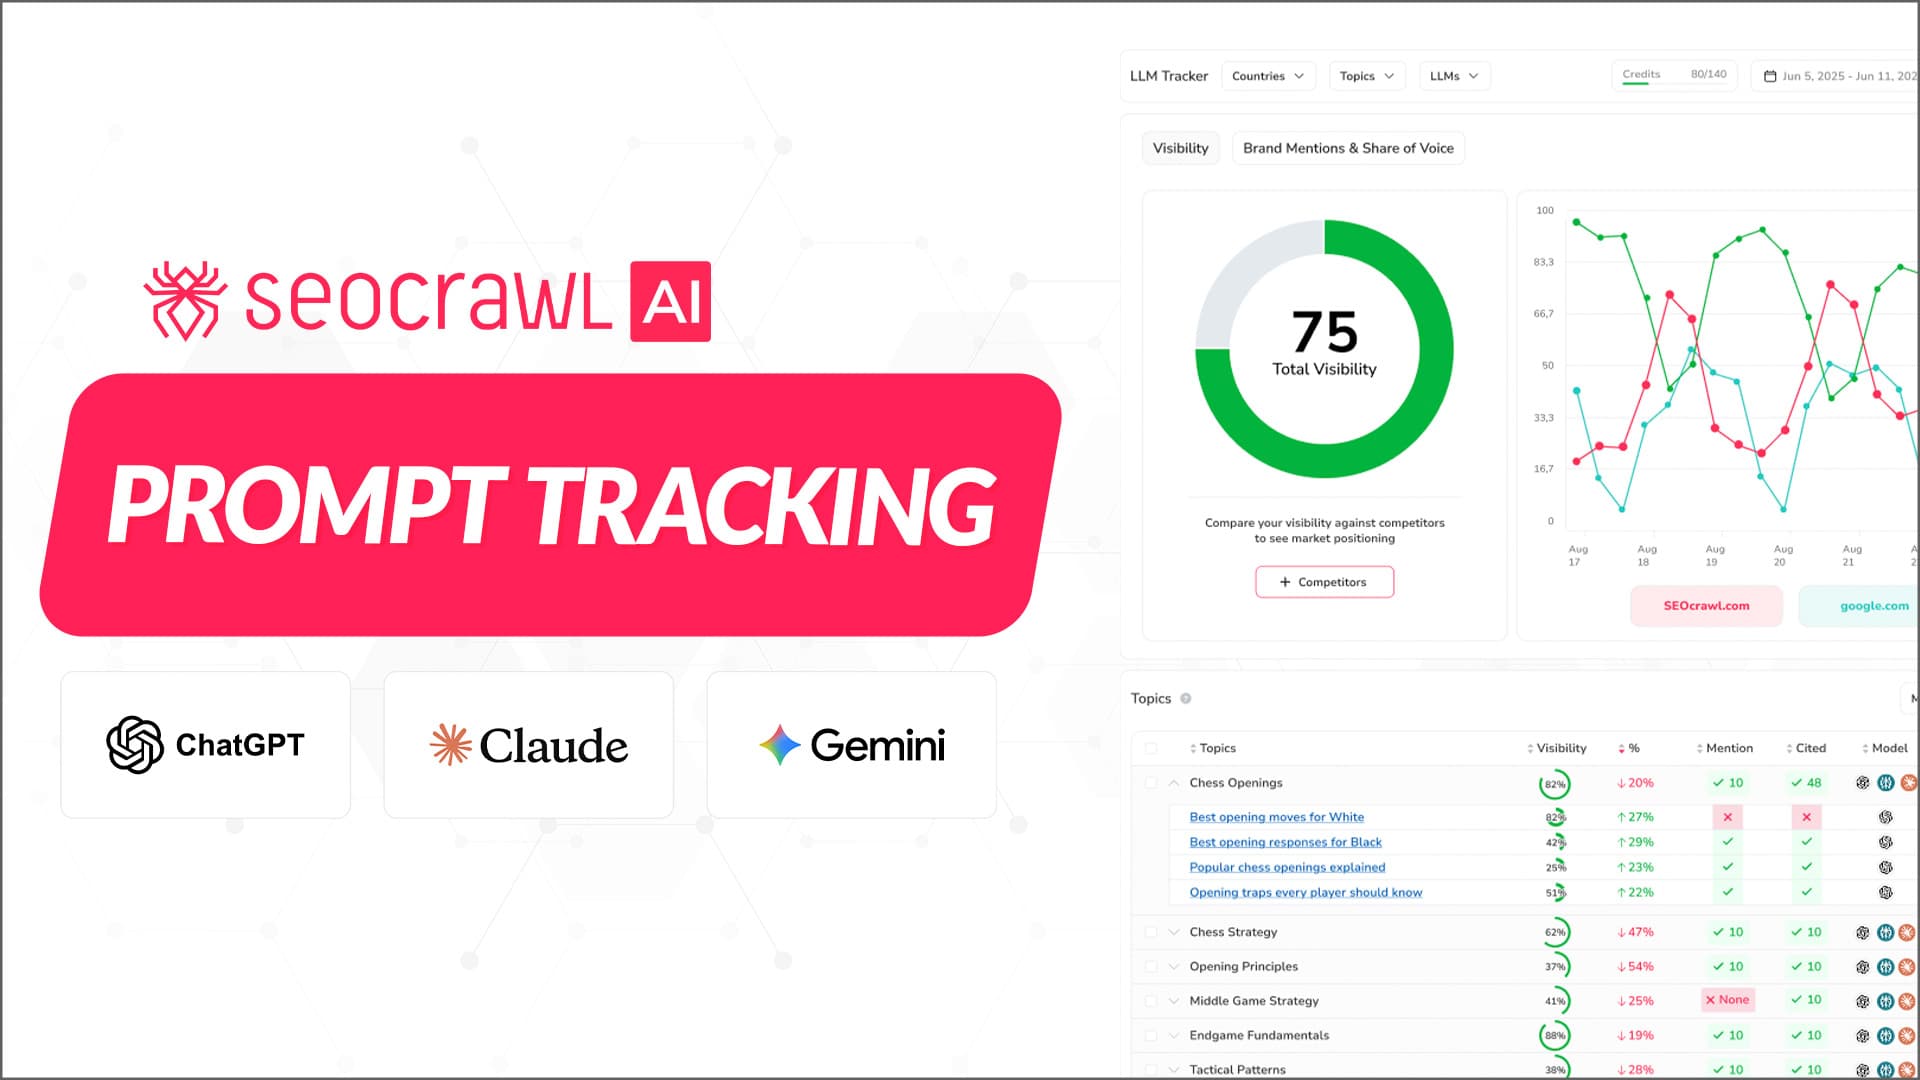
Он также оценивает вашу долю голоса относительно названных вами конкурентов и предупреждает, когда кто-то из них начинает выигрывать промпт, который раньше был вашим.
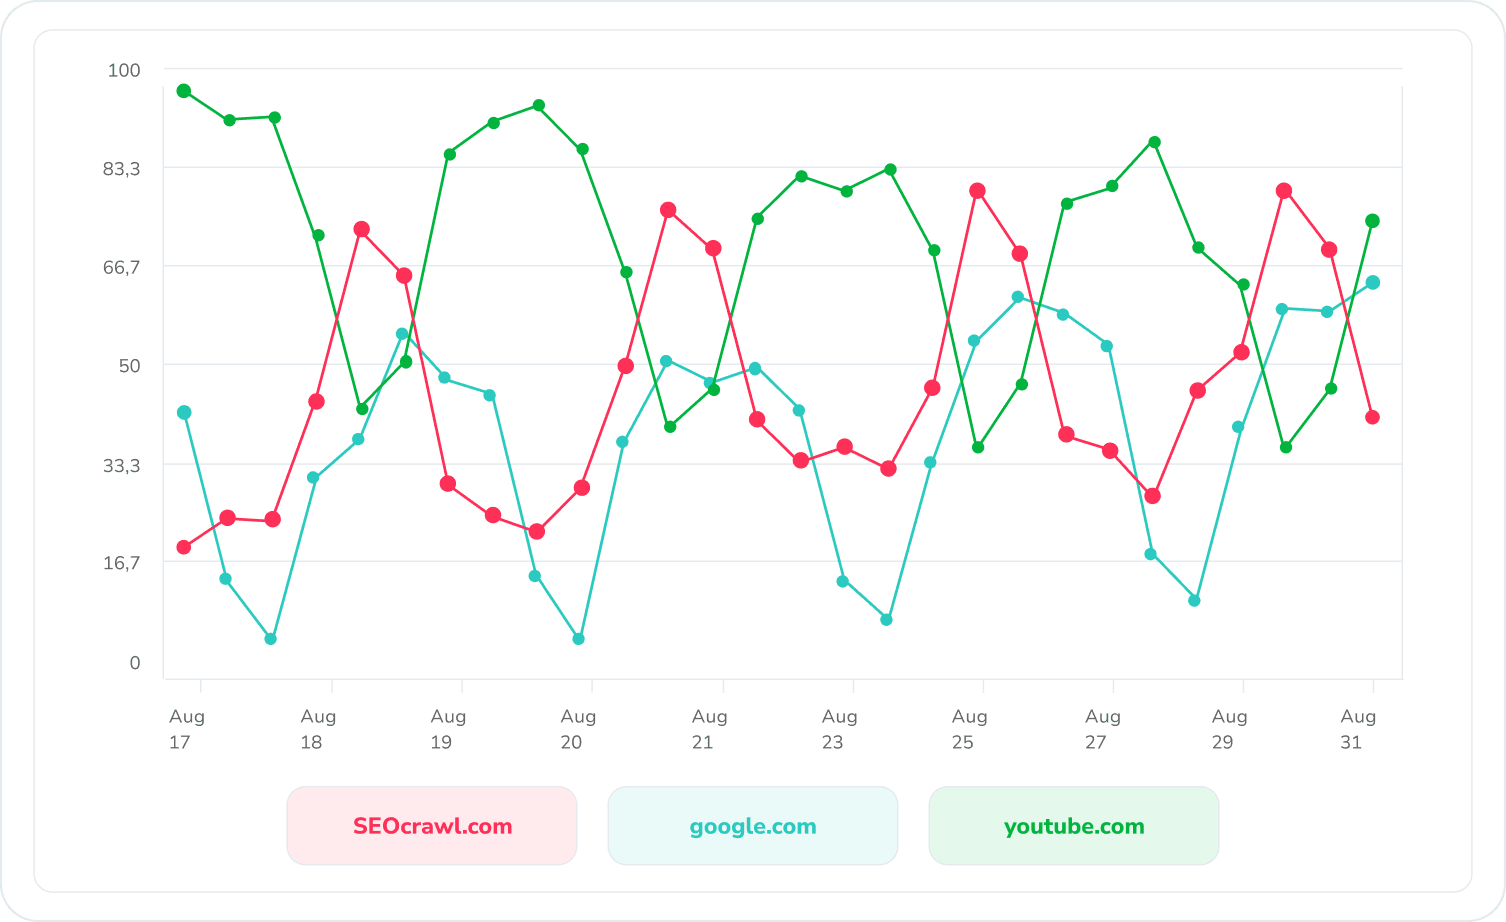
Ключевые метрики: доля голоса в AI, трафик переходов из AI-источников
- Доля голоса: какой процент релевантных промптов включает ваш бренд по сравнению с конкурентами.
- Частота цитирования: как часто ваш бренд появляется в заданном наборе промптов с течением времени.
- Тональность: описывает ли модель ваш бренд положительно, нейтрально или с оговорками.
- Процитированные URL: на какие ваши страницы модель ссылается как на источники.
- Трафик переходов из AI: сессии, отнесённые в вашей аналитике к ChatGPT, Perplexity и другим LLM, как ориентировочный индикатор эффекта от цитирований.

Как дорабатывать стратегию по данным о видимости в AI
Оптимизация видимости в AI — не разовый проект. Ассоциации модели меняются по мере выхода нового контента, обновления обучающих данных и развития вашего внешнего присутствия.
Зафиксируйте базовый замер, внесите точечные изменения (новое попадание в подборку, обновление разметки, починка индексации в Bing) и оцените эффект за 4–8 недель. Выстройте обратную связь между изменениями, которые вы делаете, и данными о видимости, которые собираете.
Частые ошибки, которые вредят вашим позициям в ChatGPT
Тонкий AI-контент без реальной экспертизы
Контент, в котором нет настоящей экспертизы, собственного взгляда или личного опыта, не наращивает тематический авторитет. Он добавляет страницы, не добавляя сигналов. Хуже того: если модель повидала достаточно низкокачественного AI-контента, она связывает шаблонные формулировки с источниками без авторитета — ровно противоположное тому, чего вы хотите.
Игнорирование Bing Webmaster Tools
У каждой SEO-команды есть рабочий процесс вокруг Google Search Console. Почти ни у кого нет его аналога для Bing. Учитывая прямой канал от Bing к ChatGPT, это один из самых значимых пробелов, которые стоит закрыть. И один из самых простых: настройка занимает минуты и ничего не стоит. Относитесь к нему с тем же приоритетом, что и к Google Search Console.
Переспам ключевыми словами против оптимизации под естественный язык
ChatGPT не вознаграждает повторение ключевых слов. Он предпочитает страницы, которые полностью отвечают на вопрос. Страница, где целевая фраза встречается десять раз, но полного извлекаемого ответа нет, проиграет странице, которая отвечает на вопрос прямо, даже если использует эту фразу реже.
Пренебрежение внешним развитием бренда
Оптимизации на странице необходимы, но недостаточны. Если у бренда нет внешнего присутствия (упоминаний в редакционных материалах, попаданий в подборки, обсуждений в сообществах), у модели нет причин его показывать — каким бы хорошо структурированным ни был ваш контент.
Случайная блокировка AI-краулеров
Файл robots.txt, написанный много лет назад, может содержать широкие правила disallow, которые сегодня блокируют GPTBot (OpenAI), ClaudeBot (Anthropic) или PerplexityBot. Проверьте его явно по user-agent каждого AI-краулера. Это та ошибка, которую не видно, пока не проверишь, и она полностью исключает ваш контент из механизма поиска.
Проверьте также, что ваши страницы не требуют авторизации для загрузки, что рендеринг JavaScript не мешает прочитать контент и что самые важные страницы отдают чистый статус 200 всем краулерам.
Частые вопросы
Можно ли на самом деле «ранжироваться» в ChatGPT так же, как в Google?
В привычном смысле — нет. Google ранжирует страницы по позициям в поисковой выдаче. ChatGPT генерирует ответ и либо включает в него ваш бренд, либо нет. Аналог «ранжирования» — это цитирование или рекомендация. Рекомендации определяются сочетанием внешнего авторитета, частоты упоминаний бренда и того, насколько легко извлечь контент, а не позицией по ключевому слову.
Помогает ли SEO под Google попадать в ответы ChatGPT?
Частично. Сильное SEO под Google формирует сигналы авторитета (ссылочная масса, E-E-A-T, доверие к бренду), которые ценят и AI-модели. Но живой поиск ChatGPT работает на Bing, а не на Google. Сайт с хорошими позициями в Google, но не проиндексированный в Bing, будет слабо виден в ChatGPT в режиме поиска.
Сколько времени нужно, чтобы начать появляться в ответах ChatGPT?
В режиме поиска улучшение позиций в Bing может дать результат за несколько недель. В режиме обучающих данных сроки зависят от цикла переобучения модели (обычно это месяцы). Надёжнее всего последовательно наращивать внешнее присутствие: попадание в подборки, упоминания в редакционных материалах и обсуждения в сообществах создают сигнал, который со временем влияет на оба режима.
Что такое generative engine optimization (GEO) и как это связано с ранжированием в ChatGPT?
GEO — это практика оптимизации контента под цитирование в ответах AI на таких площадках, как ChatGPT, Perplexity и AI Overviews в Google. Это зонтичный термин для всего, о чём эта статья. Базовые принципы (смысловая полнота, внешний авторитет, структурированный контент) работают во всех крупных LLM, с поправкой на то, как каждая модель взвешивает разные сигналы.
Помогает ли страница в Wikipedia попадать в ответы ChatGPT?
Да, и заметно. Wikipedia — один из самых весомых источников в обучающих данных LLM. Статья о вашем бренде в Wikipedia повышает способность модели связать ваше название с конкретной категорией, а это напрямую увеличивает вероятность цитирования. Записи в Wikidata аналогично влияют на попадание в knowledge graph.
Что такое llms.txt и стоит ли добавлять его на сайт?
llms.txt — развивающийся стандарт, который работает как robots.txt, но для AI-краулеров. Он позволяет владельцам сайтов указать, какому контенту AI-системы должны отдавать приоритет при индексации домена. В 2026 году его внедрение пока на раннем этапе, но добавить его сейчас — недорогой шаг на перспективу без минусов.
Как проверить, упоминает ли ChatGPT мой бренд уже сейчас?
Ручной способ: задавать в ChatGPT запросы уровня категории (например, «какие инструменты в [вашей категории] лидируют?») и смотреть, появляется ли ваш бренд и как его описывают. Для системного отслеживания по множеству промптов и LLM AI Tracker от SEOcrawl AI отслеживает упоминания бренда, долю голоса и тональность в ChatGPT, Claude, Gemini, Perplexity и Copilot в одной панели.
Влияет ли присутствие в соцсетях на ранжирование в ChatGPT?
Косвенно. Сами посты в соцсетях редко становятся прямым источником цитирования. Но активность в соцсетях разгоняет контент. Посты, которые набирают охват, порождают статьи, обсуждения и упоминания, которые уже индексируются. Сильное присутствие в соцсетях увеличивает площадь внешнего следа бренда, а это главный драйвер частоты цитирования.
Автор: David Kaufmann

Последние 10 с лишним лет я полностью одержим SEO — и, честно говоря, не хотел бы иначе.
Моя карьера вышла на новый уровень, когда я работал старшим SEO-специалистом в Chess.com — одном из ста самых посещаемых сайтов интернета. Работа в таком масштабе: миллионы страниц, десятки языков и одна из самых конкурентных выдач — научила меня тому, чему не научит ни один курс и ни один сертификат. Этот опыт изменил моё представление о том, как выглядит по-настоящему сильное SEO, и лёг в основу всего, что я построил потом.
Из него выросло SEO Alive — агентство для брендов, которые всерьёз занимаются органическим ростом. Мы не продаём дашборды и ежемесячные отчёты. Мы строим стратегии, которые реально двигают цифры, соединяя классическое SEO с новым и захватывающим миром Generative Engine Optimization (GEO): чтобы ваш бренд появлялся не только в синих ссылках Google, но и внутри ответов, которые ChatGPT, Perplexity и Google AI Overviews каждый день выдают миллионам людей.
А поскольку инструмента, который нормально закрывает оба этих мира, я так и не нашёл, я сделал его сам — SEOcrawl AI, платформу SEO-аналитики корпоративного уровня, где в одном месте собраны позиции, технические аудиты, мониторинг ссылок, здоровье краулинга и отслеживание видимости бренда в ИИ. Это та платформа, которой мне всегда не хватало.
Откройте больше материалов этого автора