Как попасть в выдачу Perplexity (это работает не как в Google)
«Ранжироваться» в Perplexity — цель невыполнимая, потому что Perplexity, по сути, ничего не ранжирует. Модель отвечает на вопрос, а затем показывает несколько страниц, из которых этот ответ взяла.
Это и есть цитирования, и попадание в этот короткий список — вся игра. В большинстве ответов их от трёх до восьми, и каждое — кликабельная ссылка.
Так что «ранжирование в Perplexity» принципиально отличается от подъёма по странице результатов, и советы, которые выглядят как переработанные тактики Google образца 2019 года, вам ничего не дадут. В этом руководстве — как Perplexity выбирает источники, какие изменения в контенте и технике двигают вашу долю цитирований и как проверить, работает ли всё это.
Как на самом деле работает Perplexity (и почему привычки из Google доводят только до середины)
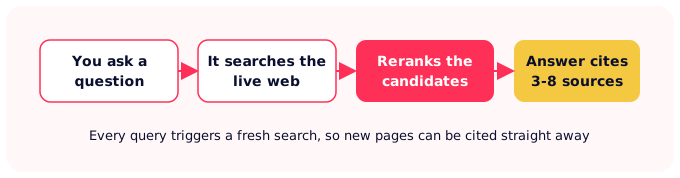
Perplexity построен на retrieval-augmented generation. Вместо того чтобы отвечать из замороженного среза обучающих данных, он ищет в живом вебе по каждому запросу, собирает страницы-кандидаты и только потом пишет ответ со ссылками на использованные страницы. Именно поэтому свежий, хорошо структурированный контент может появиться в его ответах почти сразу — не нужно ждать цикла обучения.
Кого цитируют?
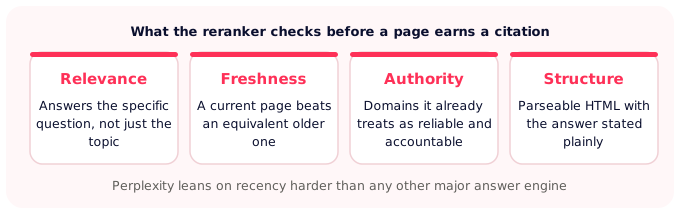
Подбор источников — не один шаг. Страницы-кандидаты проходят через конвейер переранжирования, который проверяет несколько вещей до того, как какая-то из них заработает цитирование:
- Релевантность: отвечает ли страница на конкретный вопрос, а не просто упоминает тему.
- Свежесть: Perplexity опирается на свежесть сильнее любого другого крупного ответного движка, поэтому актуальная страница обычно обходит равноценную, но более старую по тому же запросу.
- Авторитетность: он предпочитает домены, которые уже считает надёжными, — те, где есть авторы с именем и редакционная ответственность.
- Структура: чистый, разбираемый HTML, где ответ сформулирован прямо, а не закопан на три прокрутки вниз.
Что ищет Perplexity?
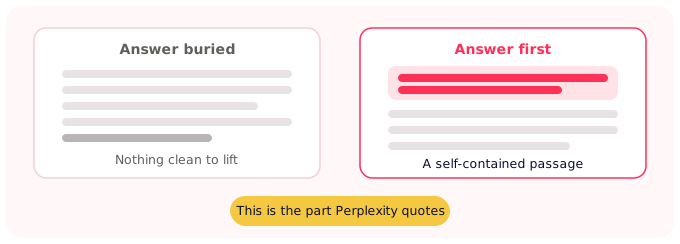
Perplexity охотится за конкретным предложением или абзацем, который отвечает на вопрос, а затем указывает его источник. Если вы оптимизируете всю страницу как один нерасчленённый ком, вы не даёте модели ничего, что можно чисто вытянуть. Пишите самодостаточными блоками, каждый из которых имеет смысл сам по себе.
Шаги по переработке контента под Perplexity
Самая полезная привычка — поместить ответ в первое-второе предложение, а потом объяснять.
1. Начинайте с ответа
Сформулируйте его прямо в начале: определение, число, «да» или «нет». Контекст, оговорки и краски оставьте на потом. Если читатель (или модель) улавливает суть из первых строк, самое трудное вы уже сделали.
2. Дайте структуру, которую он сможет разобрать
Описательные заголовки, короткие абзацы, списки там, где список уместен, и таблицы для сравнений. Аккуратный блок вопросов и ответов или определение в одну строку — ровно та форма, которую Perplexity любит цитировать. Структура здесь не украшение; именно так модель находит ответ внутри вашей страницы.
3. Целься в длинный хвост в форме вопросов
Пользователи Perplexity тяготеют к конкретным исследовательским вопросам, а не к однословным терминам. Пишите заголовки так, как люди реально формулируют вопросы.
Технические основы (чтобы PerplexityBot мог вас прочитать)
Вся работа над контентом не имеет значения, если Perplexity вообще не может получить ваши страницы.
Пустите нужных краулеров
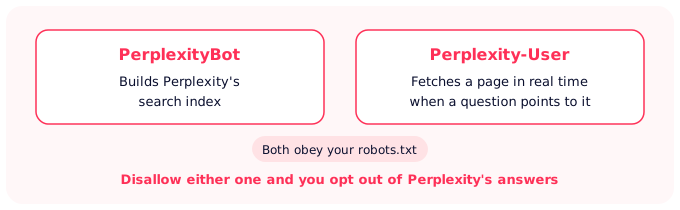
Perplexity использует два user-agent: PerplexityBot, который строит его поисковый индекс, и Perplexity-User, который получает страницу в реальном времени, когда чей-то вопрос на неё указывает. Оба читают правила robots.txt, которые вы задаёте, и Perplexity перечисляет точные обозначения в своей официальной документации по краулерам.
Запретите любого из них — и вы отказываетесь от его ответов, так что быстрый просмотр robots.txt на предмет случайного правила стоит сделать раньше всего остального.
Сделайте страницы быстрыми и доступными для сканирования
Стандартное техническое SEO по-прежнему весит. Страницу, которая проиндексирована, быстро грузится и не путает дублированным контентом, любому краулеру легче обработать, а Perplexity — легче ей доверять. Держите карту сайта актуальной, чтобы новые страницы находились быстро, а не лежали незамеченными неделями.
Добавьте структурированные данные
Микроразметка (Article, FAQPage, HowTo) помогает Perplexity разобрать, за что отвечает каждая часть вашей страницы. Это поддерживающий сигнал, а не волшебный тумблер, но добавить его дёшево, и он снимает неоднозначность. Если начинаете с нуля, наше руководство по структурированным данным для SEO объясняет, какие типы стоят усилий.
Держите контент свежим
Perplexity придаёт вес свежести, поэтому обновление и переиздание страниц, которые всё ещё актуальны, — одно из самых рычажных действий. По-настоящему обновлённое руководство (а не смена даты) может быстро вернуться в ответы, что вознаграждает команды, которые поддерживают свой лучший контент вместо того, чтобы публиковать и забывать.
Стройте авторитет, которому Perplexity уже доверяет
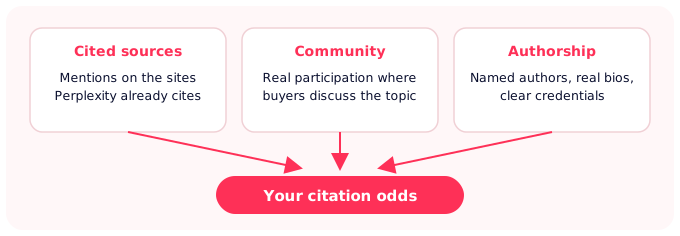
Perplexity тянется к доменам, которые считает заслуживающими доверия, поэтому добрая часть ваших шансов на цитирование решается за пределами вашего сайта. Этот внешний след — тот же самый, что двигает видимость бренда в AI во всех ответных движках, а не только в этом.
Зарабатывайте упоминания на источниках, которые он уже цитирует
Ссылки и размещения на устоявшихся сайтах с редакционной ответственностью поднимают вашу репутацию у переранжировщика. Получить цитирование от страниц, которые цитирует Perplexity, медленнее, чем работа на странице, но это накапливается, и конкуренту непросто быстро это скопировать.
Участвуйте в разговоре сообществ
Платформы сообществ, и в первую очередь Reddit, часто появляются в ответах Perplexity на запросы с мнениями и рекомендациями. Настоящее, нерекламное участие там, где ваши покупатели уже обсуждают тему, может вывести вас на глаза поисковому слою так, как никогда не сделает лендинг.
Сделайте авторство читаемым
Авторы с именем, реальные биографии и понятные регалии дают переранжировщику те самые сигналы опыта и экспертности, которые он ищет. Анонимная страница в конкуренции со страницей, где указан эксперт, обычно проигрывает место.
Ошибки, из-за которых вы не попадаете в ответ
Часть из них мы разобрали по ходу статьи, но вот короткий список, который стоит держать под рукой, пока вы не потеряли ещё больше цитирований:
- Блокировка PerplexityBot или Perplexity-User в robots.txt, обычно по недосмотру.
- Ответ, закопанный под длинным вступлением или за пейволлом, который краулер не пройдёт.
- Тонкий или общий контент, не добавляющий ничего к тому, что уже говорят цитируемые источники.
- Отсутствие реальной структуры: нет внятных заголовков, нет списков, одна длинная стена текста.
- Погоня за высокочастотными терминами вместо конкретных вопросов, которые реально задают пользователи Perplexity.
Как понять, цитирует ли вас Perplexity на самом деле
Можно задать свои вопросы в Perplexity, прочитать панель источников и посмотреть, есть ли там ваш домен. Затем проверьте в GA4 переходы с perplexity.ai. Ручной метод работает, но даёт снимок, который не масштабируется и упускает упоминания без кликов. Это тот же разрыв, из-за которого мониторинг AI-поиска становится регулярной работой, а не разовым аудитом.
SEOcrawl AI превращает этот разовый аудит в живой сигнал. Наш трекинг промптов Perplexity запускает ваши промпты по расписанию и записывает каждый URL, который цитирует Perplexity, вместе с полным промптом и меткой времени, так что вы можете воспроизвести любой ответ многонедельной давности и увидеть, как менялись его источники.
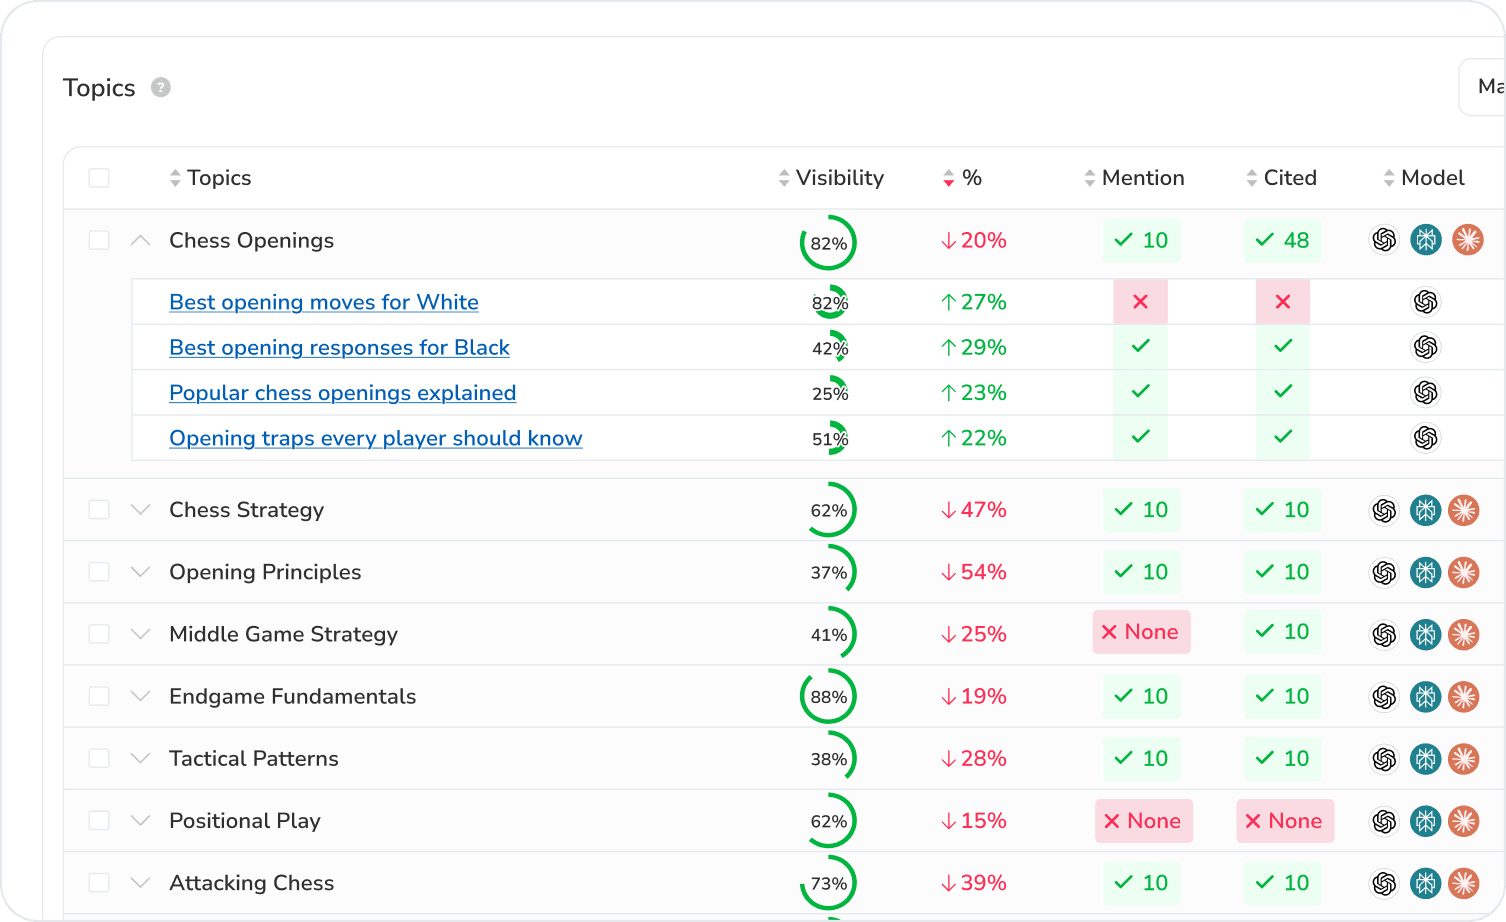
На том же экране вы видите свою долю цитирований против значимых конкурентов и ровно те URL конкурентов, на которые Perplexity отправляет ваших покупателей вместо вас.
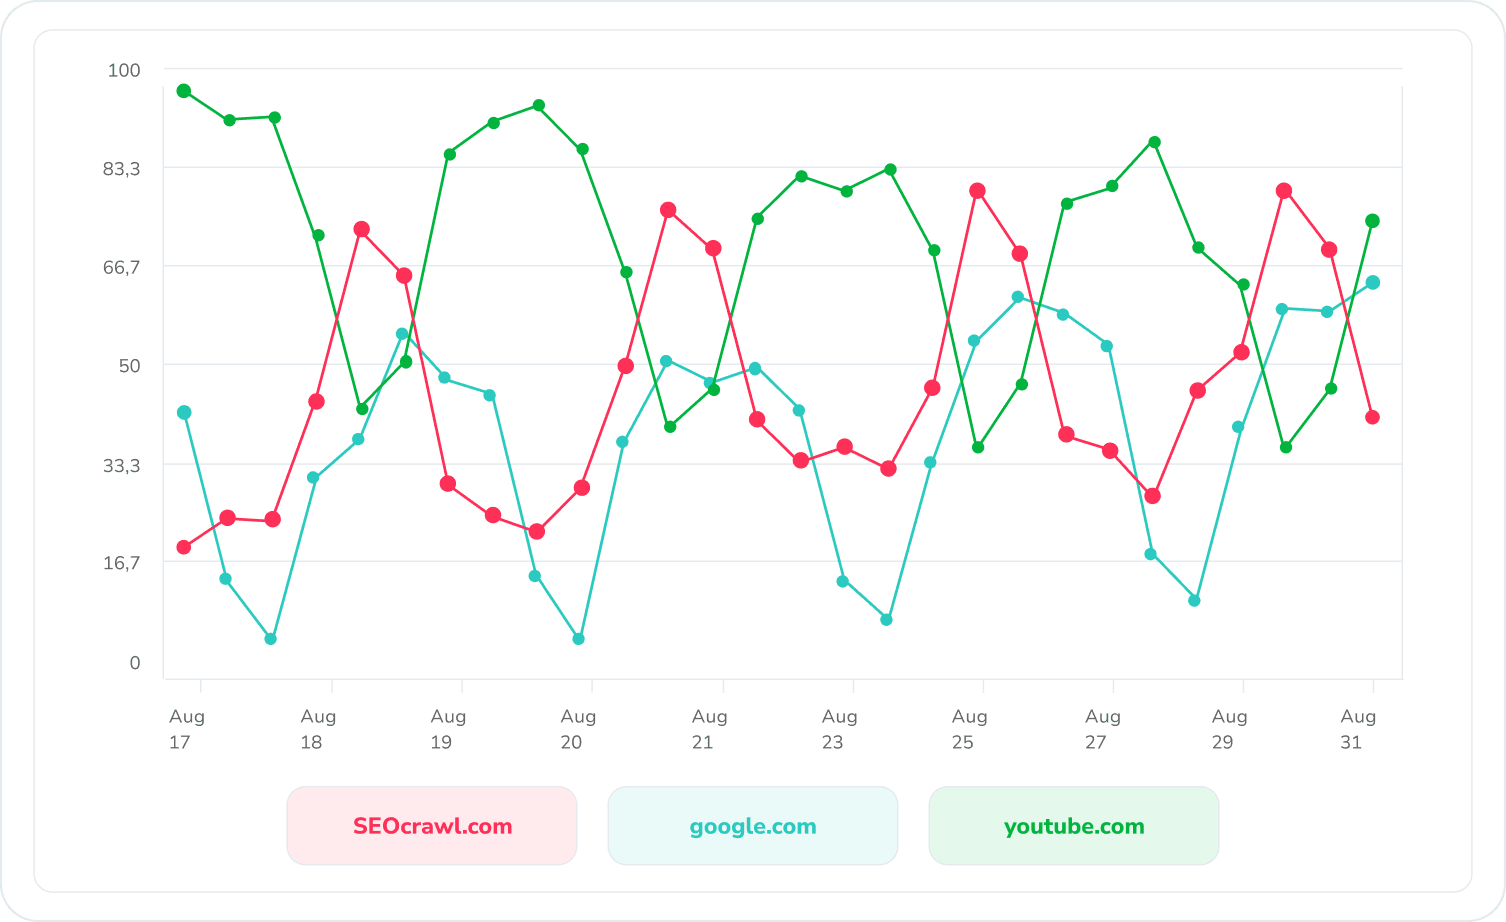
Как только ваш бренд выпадает из ответа или доля цитирований конкурента растёт, вы получаете оповещение в тот же день, а не на обзоре в конце месяца.
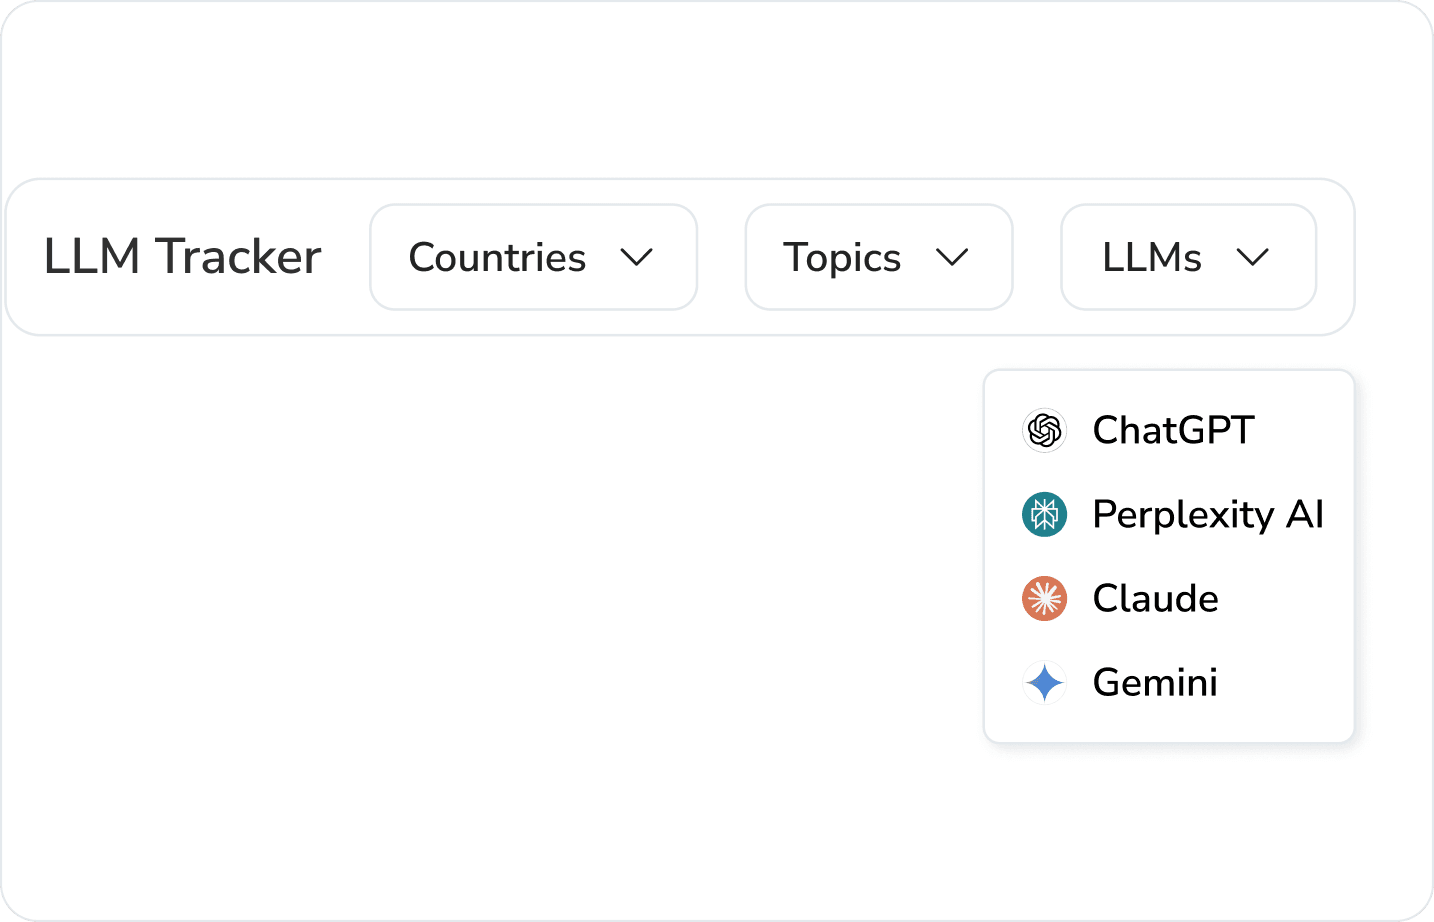
Переключайте один и тот же набор промптов между Perplexity, ChatGPT, Claude и Gemini, чтобы находить ответы, где один движок уже цитирует вас, а другой — нет.
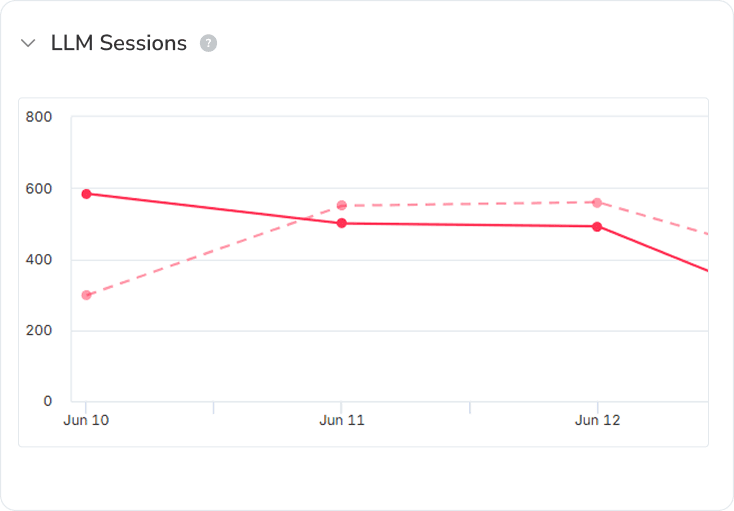
Слой AI Tracker затем связывает эти упоминания с реальными сеансами и конверсиями в GA4, так что вы отвечаете на оба вопроса сразу: есть ли я в ответе и приносит ли это трафик?
Частые вопросы
Помогает ли классическое SEO попасть в выдачу Perplexity?
Отчасти. Доступность для сканирования, авторитет домена и ссылочная масса переносятся сюда, потому что Perplexity берёт данные из живого веба. Новое — это упор на формулировки «сначала ответ», извлекаемую структуру и свежесть. Считайте крепкое SEO фундаментом и надстраивайте сверху GEO-тактики.
Как Perplexity решает, какие источники процитировать?
Он подбирает страницы-кандидаты под ваш запрос, затем переранжирует их по релевантности, свежести, авторитетности и структуре, а потом пишет ответ со ссылками на использованные источники. Больше всего шансов у страниц, которые формулируют ответ прямо и относятся к доверенным доменам.
Можно ли запретить Perplexity сканировать мой сайт?
Да. Вы можете запретить PerplexityBot и Perplexity-User в robots.txt, ориентируясь на обозначения с официальной страницы краулеров Perplexity. Компромисс в том, что вы одновременно исключаете себя из его ответов.
Сколько времени проходит до первого цитирования после публикации?
Фиксированных сроков нет. Всё зависит от того, как быстро Perplexity просканирует страницу и превзойдёт ли ваш материал источники, которые он цитирует сейчас. Актуальная карта сайта плюс по-настоящему свежий и хорошо структурированный контент сокращают ожидание.
Помогает ли микроразметка?
Она помогает Perplexity разобрать структуру и намерение вашего контента, что поддерживает цитирование, хотя сама по себе не является гарантированным фактором ранжирования. FAQPage, Article и HowTo — полезные типы для большинства страниц.
Попасть в выдачу Perplexity — это то же самое, что попасть в ChatGPT или в AI Overviews от Google?
Принципы пересекаются (авторитетность, структура, заслуживающее доверия авторство), но каждый движок подбирает источники по-своему. ChatGPT, например, опирается на индекс Bing, поэтому у попадания в выдачу ChatGPT свой чек-лист. Единый GEO-подход повышает ваши шансы во всех сразу, и это эффективнее, чем оптимизировать по одному движку за раз.
Какой контент чаще всего цитируют в Perplexity?
Прямые практические руководства, чёткие определения, страницы сравнений и материалы с большим количеством вопросов и ответов — особенно всё, что отвечает на конкретный вопрос в первых строках.
Как проверить, цитирует ли меня Perplexity?
Задайте свои целевые запросы в Perplexity и поищите свой домен в панели источников, затем подтвердите переходы в GA4. Чтобы отслеживать это постоянно по промптам и конкурентам, используйте инструмент трекинга промптов — например, трекер Perplexity в SEOcrawl AI. Тот же подход работает для упоминаний бренда в ChatGPT и любого другого движка, который вам важен.
Автор: David Kaufmann

Последние 10 с лишним лет я полностью одержим SEO — и, честно говоря, не хотел бы иначе.
Моя карьера вышла на новый уровень, когда я работал старшим SEO-специалистом в Chess.com — одном из ста самых посещаемых сайтов интернета. Работа в таком масштабе: миллионы страниц, десятки языков и одна из самых конкурентных выдач — научила меня тому, чему не научит ни один курс и ни один сертификат. Этот опыт изменил моё представление о том, как выглядит по-настоящему сильное SEO, и лёг в основу всего, что я построил потом.
Из него выросло SEO Alive — агентство для брендов, которые всерьёз занимаются органическим ростом. Мы не продаём дашборды и ежемесячные отчёты. Мы строим стратегии, которые реально двигают цифры, соединяя классическое SEO с новым и захватывающим миром Generative Engine Optimization (GEO): чтобы ваш бренд появлялся не только в синих ссылках Google, но и внутри ответов, которые ChatGPT, Perplexity и Google AI Overviews каждый день выдают миллионам людей.
А поскольку инструмента, который нормально закрывает оба этих мира, я так и не нашёл, я сделал его сам — SEOcrawl AI, платформу SEO-аналитики корпоративного уровня, где в одном месте собраны позиции, технические аудиты, мониторинг ссылок, здоровье краулинга и отслеживание видимости бренда в ИИ. Это та платформа, которой мне всегда не хватало.
Откройте больше материалов этого автора