Strona zeskanowana, ale obecnie niezindeksowana: co to znaczy i jak to naprawić

Google odwiedziło Twój adres URL, przeczytało stronę i pominęło ją w wynikach wyszukiwania. Oto jak ocenić, które strony zasługują na drugą szansę, i jak według Google przywrócić je do indeksu.
Strona zeskanowana, ale obecnie niezindeksowana oznacza, że Googlebot pobrał Twoją stronę i zdecydował, że nie doda jej do indeksu Google, więc nie może ona pojawić się w wynikach wyszukiwania. Pomoc dotycząca raportu Indeksowanie stron ujmuje to tak: strona została zeskanowana, ale nie zindeksowana, i „może, ale nie musi zostać zindeksowana w przyszłości”.
Przyczyną jest zwykle sama strona, a nie blokada techniczna. Poniżej dowiesz się, jak dla każdego adresu URL zdecydować, czy stronę naprawić, oznaczyć jako noindex, czy usunąć, i ile według Google trwa naprawa. Dopiero zaczynasz pracę z tym raportem? Zacznij od tego przewodnika po Google Search Console.
Co oznacza „Strona zeskanowana, ale obecnie niezindeksowana”?
Ten status oznacza, że Google zeskanowało stronę i postanowiło jej nie indeksować. Nic nie zablokowało Googlebota: Google zdecydowało, że na razie pominie stronę. Dwa rozróżnienia pomogą Ci poprawnie odczytać ten status.
Skanowanie a indeksowanie
Skanowanie to pobranie strony przez Googlebota. Indeksowanie to zapisanie jej przez Google, aby mogła pojawiać się w wynikach wyszukiwania. Strona może być skanowana wiele razy i nigdy nie trafić do indeksu.
Pomoc dotycząca narzędzia Sprawdzanie adresu URL mówi, że jakość strony musi być „na tyle wysoka, by uzasadniała zindeksowanie”, a test na żywo w ogóle nie potrafi wykryć tego statusu.
Czym różni się od „Strona wykryta, ale obecnie niezindeksowana”
Strona wykryta, ale obecnie niezindeksowana to etap wcześniej: Google znalazło adres URL, ale odłożyło skanowanie, aby nie przeciążać Twojej witryny, więc data ostatniego skanowania jest pusta.
| Strona wykryta, ale obecnie niezindeksowana | Strona zeskanowana, ale obecnie niezindeksowana | |
|---|---|---|
| Zeskanowana przez Google? | Nie | Tak |
| Data ostatniego skanowania | Pusta | Konkretna data |
| Typowa przyczyna | Skanowanie odłożone, by nie przeciążać witryny | Google przeczytało stronę i ją pominęło |
| Co sprawdzić najpierw | Przepustowość skanowania na bardzo dużych witrynach | Jakość treści, duplikaty, adresy kanoniczne |
Google podkreśla też: „Niezindeksowana nie musi oznaczać czegoś złego”. Strony z noindex, adresy URL zablokowane w robots.txt, duplikaty i błędy 404 bez zamiennika mają pozostać poza indeksem.
Dlaczego Google skanuje strony, ale ich nie indeksuje
Indeksowanie ma próg jakości, którego skanowanie nie ma. Przewodnik Google po crawl budget mówi, że zapotrzebowanie na skanowanie rośnie wraz z wartością i unikalnością Twoich treści.
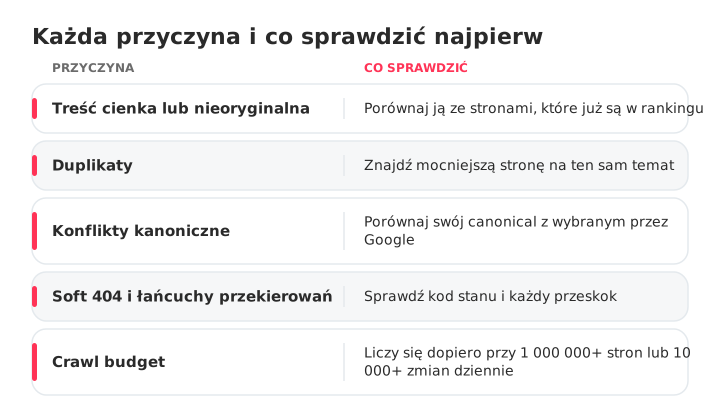
Większość dotkniętych adresów URL ma jedną z tych przyczyn, a każda z nich wymaga innej pierwszej kontroli:
- Cienka lub nieoryginalna treść: strona powtarza to, co już jest w rankingu.
- Duplikaty: archiwa tagów, adresy URL z sortowaniem, dwa wpisy na ten sam temat. Zobacz, jak wykryć i naprawić kanibalizację słów kluczowych.
- Konflikty adresów kanonicznych: porównaj zadeklarowany adres kanoniczny z tym, który wybrało Google. Gdy Google wybierze inny adres URL, strona zwykle przechodzi do statusu Strona alternatywna z prawidłowym tagiem strony kanonicznej lub do jednego ze statusów duplikatu.
- Soft 404 i łańcuchy przekierowań: Google twierdzi, że soft 404 marnują crawl budget.
- Crawl budget: ma znaczenie dla witryn z ponad 1 000 000 stron zmieniających się co tydzień lub ponad 10 000 zmieniających się codziennie. W większości witryn to nie jest przyczyna.
Poprzeczka rosła w dwóch krokach. 18 sierpnia 2022 Google ogłosiło aktualizację helpful content, czyli sygnał działający na poziomie całej witryny, i stwierdziło, że usunięcie mało pomocnych treści może pomóc pozostałym stronom. 5 marca 2024 Google ogłosiło core update, który miał ograniczyć treści tworzone pod kliknięcia, wraz z nową zasadą dotyczącą spamu przeciwko nadużywaniu treści na masową skalę.
Wytyczne Google dotyczące pomocnych treści mówią, że E-E-A-T nie jest konkretnym czynnikiem rankingowym, że najważniejsze jest zaufanie i że nie ma preferowanej liczby słów. Sztuczne wydłużanie strony nic nie da.
Jak znaleźć i zdiagnozować dotknięte strony w GSC
Otwórz raport Indeksowanie stron (dawniej raport Stan), sprawdź próbkę, a potem pogrupuj listę według wzorców. Google zaznacza, że witryny poniżej 500 stron prawdopodobnie nie potrzebują tego raportu.
Wyszukiwanie dotkniętych adresów URL w raporcie Strony
- W Google Search Console przejdź do Indeksowanie › Strony.
- W sekcji „Dlaczego strony nie są indeksowane” kliknij Strona zeskanowana, ale obecnie niezindeksowana.
- Kliknij Eksportuj i pobierz listę.
Raport pokazuje do 1000 przykładowych adresów URL, niekoniecznie wszystkie, więc w dużej witrynie eksport jest tylko próbką.
Sprawdzanie stron narzędziem Sprawdzanie adresu URL
Sprawdź od pięciu do dziesięciu wyeksportowanych adresów URL pod kątem daty ostatniego skanowania i strony kanonicznej wybranej przez Google. Adres kanoniczny wskazujący gdzie indziej oznacza, że Google widzi duplikat; data skanowania sprzed kilku miesięcy sugeruje, że Google rzadko wraca.
Wykrywanie wzorców w setkach adresów URL
Posortuj eksport według folderu, szablonu i parametru URL, a potem policz każdą grupę. Powiedzmy, że 300 adresów URL dzieli się na 180 stron /tag/, 70 adresów ?sort= i 50 wpisów: to trzy decyzje, a nie 300.
Naprawić, noindex czy usunąć: zdecyduj, na co zasługuje każdy adres URL
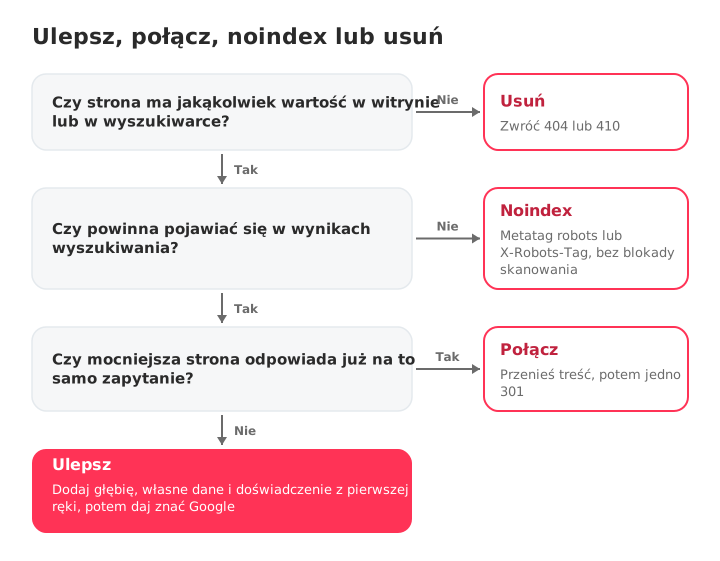
Każdy adres URL zasługuje na jeden z czterech wyników. Zapytaj: czy użytkownik byłby zadowolony, trafiając tutaj, i czy to jedyna strona w Twojej witrynie odpowiadająca na to zapytanie?
| Typ strony | Przykład | Decyzja | Jak |
|---|---|---|---|
| Przydatna i unikalna, ale cienka | Poradnik na 300 słów na temat, który znasz | Ulepsz | Dodaj głębię i doświadczenie z pierwszej ręki |
| Duplikuje mocniejszą stronę | Dwa wpisy na to samo zapytanie | Połącz | Przenieś treść, potem przekierowanie 301 |
| Przydatna w witrynie, nie w wyszukiwarce | Archiwa tagów, wyszukiwarka wewnętrzna, strony z podziękowaniem | Noindex | Metatag robots lub X-Robots-Tag |
| Bez wartości i bez zamiennika | Wygasłe promocje, strony testowe | Usuń | Zwróć 404 lub 410 |
Przewodnik Google po crawl budget potwierdza dwa ostatnie wiersze: dla usuniętych stron zwracaj 404 lub 410 i konsoliduj duplikaty. Błąd 404 w Search Console jest czymś oczekiwanym w przypadku stron usuniętych celowo.
To właśnie przy noindex segregacja najczęściej idzie źle:
Nie tak: tag noindex na stronach /tag/, podczas gdy robots.txt blokuje /tag/. Googlebot nie może pobrać tych stron, więc nigdy nie zobaczy tagu.
Tak: /tag/ pozostaje dostępne do skanowania i ma noindex jako metatag lub nagłówek X-Robots-Tag.
Zgodnie z dokumentacją Google dotyczącą noindex ta reguła nie działa w robots.txt, a na rzadko odwiedzanych stronach ponowne skanowanie może potrwać miesiące. Gdy tag zostanie odczytany, te adresy URL przejdą do statusu Wykluczono za pomocą tagu 'noindex', i właśnie tego dla nich chcesz.
Jak naprawić strony warte zindeksowania
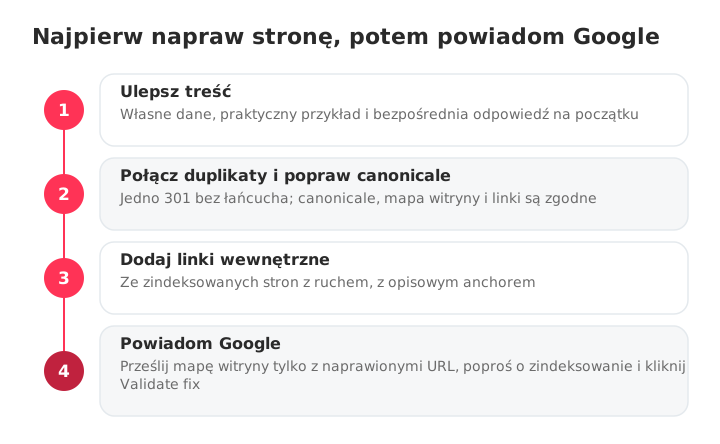
Najpierw spraw, by strona była warta zindeksowania, a dopiero potem powiadom Google. Prośba o zindeksowanie niezmienionej strony to prośba, by Google powtórzyło decyzję, którą już podjęło. Kolejność:
- Ulepsz treść.
- Połącz duplikaty i popraw adresy kanoniczne.
- Dodaj linki wewnętrzne.
- Prześlij ukierunkowaną mapę witryny i poproś o zindeksowanie.
Zwiększ głębię i oryginalność treści
Pisz pod zapytanie, a nie pod liczbę słów: dodaj własne dane, zrzuty ekranu, praktyczny przykład i bezpośrednią odpowiedź blisko początku.
Weźmy na przykład cienki poradnik na 300 słów: dodaj własny zbiór danych i praktyczny przykład, podlinkuj go z dwóch wpisów, które już mają ruch, i dopiero wtedy dodaj go do ukierunkowanej mapy witryny.
Połącz duplikaty i popraw adresy kanoniczne
Gdy dwa adresy URL dotyczą tego samego, zostaw jeden, przenieś do niego przydatną treść i ustaw przekierowanie 301 z drugiego bezpośrednio na niego, bez łańcucha. Następnie sprawdź, czy adresy kanoniczne, mapa witryny i linki wewnętrzne są zgodne i czy nie został żaden przypadkowy noindex.
Dodaj linki wewnętrzne ze stron, które Google już ceni
Podlinkuj każdą naprawioną stronę ze zindeksowanych stron, które mają ruch, używając opisowego anchora. Każdy crawler SEO wyświetli strony osierocone (bez linków wewnętrznych), jeśli przefiltrujesz je po zerowej liczbie linków przychodzących. Pełną metodę znajdziesz w przewodniku o strategii linkowania wewnętrznego.
Sprawdź też stronę na telefonie i w raporcie Podstawowe wskaźniki internetowe: zepsutą wersję mobilną łatwo szybko wykluczyć.
Prześlij ukierunkowaną mapę witryny i poproś o zindeksowanie
Utwórz mapę witryny zawierającą tylko naprawione adresy URL, prześlij ją i przefiltruj nią raport Strony, zanim klikniesz Validate fix. Google zaleca to, aby przyspieszyć weryfikację. Jeśli najpierw potrzebujesz obecnego pliku, znajdź mapę swojej witryny.
Google ignoruje priority i changefreq, więc zamiast tego dbaj o dokładne lastmod. Następnie kliknij Poproś o zindeksowanie w narzędziu Sprawdzanie adresu URL dla priorytetowych adresów URL: Google stosuje limit i zaznacza, że powtarzane prośby niczego nie przyspieszają.
Ile trwa zindeksowanie po naprawie?
Licz się z czasem od dnia do kilku tygodni, a zindeksowanie nigdy nie jest gwarantowane. Google podaje różne zakresy na różnych stronach, więc zestawiamy je obok siebie:
| Co zrobiłeś | Co mówi Google | Źródło |
|---|---|---|
| Poprosiłeś Google o ponowne skanowanie | Od kilku dni do kilku tygodni | Proszenie Google o ponowne skanowanie |
| Poproś o zindeksowanie | Zwykle około doby, do tygodnia lub dwóch, z dziennym limitem | Pomoc: Sprawdzanie adresu URL |
| Validate fix | Do około dwóch tygodni, czasem znacznie dłużej | Pomoc: Indeksowanie stron |
To terminy podawane przez Google, a nie przypadki odzyskania pozycji. Sprawdzaj raport Strony co tydzień; jeśli po upływie tych okresów naprawione adresy URL się nie zmieniły, wróć do treści.
Jak zapobiec trafianiu nowych stron do tego statusu
Zapobieganie to rutyna: sprawdzaj każdą stronę przed publikacją i co miesiąc przeglądaj Search Console. Przed publikacją upewnij się, że strona:
- Odpowiada na zapytanie, na które nie odpowiada żadna inna strona w Twojej witrynie.
- Wnosi Twoje własne dane, przykłady lub doświadczenie.
- Ma samoodwołujący się adres kanoniczny i żadnego przypadkowego noindex.
- Jest w mapie witryny z dokładnym lastmod.
- Ma podpisanego autora i, tam gdzie to ma zastosowanie, dane strukturalne.
- Otrzymuje link z powiązanej, zindeksowanej strony.
Raz w miesiącu porównaj raport Strony z poprzednim miesiącem; problem pozostaje na liście przez 90 dni od zniknięcia ostatniego wystąpienia. Witryny z ponad tysiącem stron powinny też śledzić raport Statystyki indeksowania.
SEOcrawl AI zajmuje się stroną techniczną na dużą skalę. Crawler skanuje każdą stronę i zwraca Audit Health Score, z problemami podzielonymi na Indexability, Crawlability, On-Page i inne kategorie. Jego widok Indexation grupuje adresy URL według stanu pokrycia w Search Console, dzięki czemu widzisz, ile z nich ma status „Strona zeskanowana, ale obecnie niezindeksowana”, i możesz śledzić tę liczbę w czasie.
Między skanowaniami SEO Monitor ostrzega Cię, gdy ważna strona dostanie noindex, zmieni adres kanoniczny, zwróci 404 lub zniknie z mapy witryny. Ta sama platforma śledzi widoczność Twojej marki w ChatGPT, Claude, Gemini, Perplexity i Copilot, więc SEO i GEO masz w jednym miejscu.
Najczęściej zadawane pytania
Co oznacza status „Strona zeskanowana, ale obecnie niezindeksowana”?
Oznacza, że Googlebot pobrał Twoją stronę i zdecydował, że nie doda jej do indeksu Google, więc nie może pojawić się w wynikach wyszukiwania. Nic nie zablokowało skanowania: Google przeczytało stronę i postanowiło na razie ją pominąć. To nie jest ręczna kara, a strona może, ale nie musi zostać zindeksowana w przyszłości.
Czy to to samo co „Strona wykryta, ale obecnie niezindeksowana”?
Nie. „Wykryta” oznacza, że Google zna adres URL, ale odłożyło skanowanie, więc data ostatniego skanowania jest pusta. „Zeskanowana” oznacza, że Google już odwiedziło i przeczytało stronę, a potem zdecydowało, że jej nie zindeksuje. Przy statusie „Wykryta” sprawdź przepustowość skanowania na bardzo dużych witrynach; przy „Zeskanowana” sprawdź jakość treści, duplikaty i adresy kanoniczne.
Czy status „Strona zeskanowana, ale obecnie niezindeksowana” szkodzi SEO?
Sam w sobie nie: ten status nie jest karą, a dana strona traci tylko własny ruch z wyszukiwarki. Ryzykiem jest skala, bo Google traktuje duży udział mało pomocnych treści jako sygnał dla całej witryny. Archiwum tagów poza indeksem nic nie kosztuje; strona produktu już tak. Jeśli liczba takich stron rośnie przy każdej publikacji, potraktuj to jako problem z treścią na poziomie witryny, a nie listę pojedynczych adresów URL.
Ile trwa zindeksowanie strony po naprawie?
Licz się z czasem od jednego dnia do kilku tygodni, a zindeksowanie nigdy nie jest gwarantowane. Według Google ponowne skanowanie trwa od kilku dni do kilku tygodni, prośba o zindeksowanie jest zwykle przetwarzana w ciągu mniej więcej doby, ale może potrwać tydzień lub dwa, a Validate fix trwa zazwyczaj do około dwóch tygodni.
Czy prośba o zindeksowanie pomoże?
Tylko wtedy, gdy najpierw zmienisz stronę. Prośba o zindeksowanie niezmienionej strony to prośba, by Google powtórzyło decyzję, którą już podjęło. Prośby podlegają dziennemu limitowi, a Google zaznacza, że wielokrotne wysyłanie tego samego adresu URL niczego nie przyspiesza.
Czy dodanie strony do mapy witryny XML pomaga?
Pomaga Google znaleźć adres URL, a nie go zindeksować. Google nazywa przesłaną mapę witryny „jedynie wskazówką”, a te strony zostały już znalezione i przeczytane. Po naprawie mapa witryny służy do zgrupowania adresów URL, które chcesz ponownie sprawdzić. Jeden plik mapy witryny mieści do 50 000 adresów URL lub 50 MB.
Dlaczego weryfikacja statusu „Strona zeskanowana, ale obecnie niezindeksowana” się nie powiodła?
Weryfikacja zatrzymuje się, gdy tylko Google znajdzie w grupie jeden nienaprawiony adres URL, więc jedna pominięta strona może zablokować całą partię. Napraw każdy adres URL w grupie albo zawęź grupę, filtrując raport mapą witryny zawierającą tylko naprawione adresy, i ponów weryfikację.
Jak SEOcrawl AI pomaga w przypadku stron, które Google skanuje, ale nie indeksuje?
SEOcrawl AI wykrywa przyczyny tego statusu po stronie witryny. Crawler pokazuje dla każdego adresu URL wynik kondycji, kod stanu HTTP i głębokość skanowania, dzięki czemu wychwycisz strony, do których Google trudno dotrzeć. Widok Indexation grupuje adresy URL według stanu pokrycia w Search Console, a SEO Monitor ostrzega Cię, gdy ważna strona dostanie noindex, zmieni adres kanoniczny, zwróci 404 lub zniknie z mapy witryny.
Autor: David Kaufmann

Ostatnie ponad 10 lat spędziłem kompletnie zafascynowany SEO — i szczerze mówiąc, nie zamieniłbym tego na nic innego.
Moja kariera wskoczyła na zupełnie nowy poziom, gdy pracowałem jako senior SEO specialist w Chess.com — jednej ze 100 najczęściej odwiedzanych stron w całym internecie. Działanie na taką skalę, na milionach podstron, w dziesiątkach języków i w jednych z najbardziej konkurencyjnych SERPs, nauczyło mnie rzeczy, których nie dałby żaden kurs ani certyfikat. To doświadczenie zmieniło moje spojrzenie na to, jak naprawdę wygląda świetne SEO — i stało się fundamentem wszystkiego, co zbudowałem od tamtej pory.
Z tego doświadczenia narodziło się SEO Alive — agencja dla marek, które na poważnie podchodzą do wzrostu organicznego. Nie jesteśmy tu po to, żeby sprzedawać dashboards i miesięczne raporty. Jesteśmy tu, żeby budować strategie, które realnie robią różnicę, łącząc to, co najlepsze w klasycznym SEO, z ekscytującym nowym światem Generative Engine Optimization (GEO) — tak, aby Twoja marka pojawiała się nie tylko w niebieskich linkach Google, ale też wewnątrz odpowiedzi generowanych przez AI, które ChatGPT, Perplexity i Google AI Overviews dostarczają każdego dnia milionom ludzi.
A ponieważ nie mogłem znaleźć narzędzia, które potrafiłoby porządnie obsłużyć oba te światy, zbudowałem je sam — SEOcrawl AI, platformę enterprise SEO intelligence, która łączy w jednym miejscu rankings, audyty techniczne, monitoring backlinks, kondycję crawl i śledzenie widoczności marki w AI. To platforma, o której istnieniu zawsze marzyłem.
Odkryj więcej treści tego autora


Domain Authority przewiduje, jak dobrze strona będzie się pozycjonować, ale nie jest czynnikiem rankingowym Google. Sprawdź, co naprawdę mierzy DA, jak wypada na tle DR i Authority Score oraz na które metryki warto patrzeć zamiast niej.