Wykluczono za pomocą tagu 'noindex': co to znaczy i jak to naprawić
Otworzyłeś Google Search Console, zobaczyłeś grupę adresów URL ze statusem "Wykluczono za pomocą tagu 'noindex'" i teraz te strony są niewidoczne w wynikach wyszukiwania.
Jeśli w Google Search Console widzisz grupę adresów URL oznaczonych jako "Wykluczono za pomocą tagu 'noindex'", Twoje strony są celowo trzymane poza indeksem Google, a naprawa jest zwykle prostsza, niż się wydaje: znajdź dyrektywę, usuń ją i poproś Google o ponowne zeskanowanie.
Ten poradnik dokładnie wyjaśnia, co wywołuje ten status, jak namierzyć odpowiedzialną za niego dyrektywę noindex i jakie konkretne kroki wykonać, aby ją usunąć w każdym popularnym CMS-ie, tak aby Twoje strony znów mogły się pozycjonować. Ta sama kontrola działa automatycznie w Crawlerze SEOcrawl AI, który wykrywa dyrektywy noindex w całej witrynie bez sprawdzania adres po adresie.
Co oznacza "Wykluczono za pomocą tagu 'noindex'" w Google Search Console?
Status "Wykluczono za pomocą tagu 'noindex'" oznacza, że Googlebot zeskanował Twoją stronę, znalazł dyrektywę noindex i ją zastosował, czyli nie dodał strony do indeksu Google. Strona nie pojawi się w wynikach wyszukiwania, dopóki ta dyrektywa pozostaje na miejscu.
Gdzie ten status pojawia się w GSC
W starym raporcie Stan (zastąpionym w 2022 roku raportem Indeksowanie stron) ten status widniał w sekcji "Wykluczone". W obecnym raporcie Indeksowanie stron (Indeksowanie › Strony) znajdziesz go w sekcji "Niezindeksowane", w tabeli "Dlaczego strony nie są indeksowane", z powodem "Wykluczono za pomocą tagu 'noindex'". Google grupuje wszystkie dotknięte adresy URL pod tą etykietą, dzięki czemu możesz je wyeksportować i przejrzeć zbiorczo.
Jak Google wykrywa dyrektywę noindex i jak ją respektuje
Dokumentacja Google o blokowaniu indeksowania za pomocą noindex opisuje dwa sposoby jej przekazania: tag <meta name="robots" content="noindex"> w sekcji <head> kodu HTML strony albo dyrektywę X-Robots-Tag: noindex w nagłówkach odpowiedzi HTTP. Gdy Googlebot napotka którąkolwiek z nich, całkowicie usuwa stronę z indeksu, nawet jeśli wcześniej była zindeksowana. Podstawy samego tagu znajdziesz w naszym poradniku o metatagu noindex.
Czy to zawsze problem? Kiedy wykluczenie jest celowe
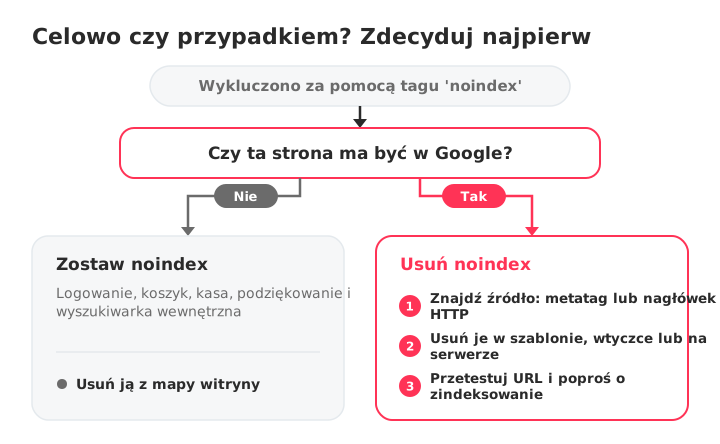
Nie każdy adres URL ze statusem "Wykluczono za pomocą tagu 'noindex'" to błąd. Panele administracyjne, ekrany logowania, koszyk i proces zamówienia, strony z podziękowaniem oraz wyniki wewnętrznej wyszukiwarki są celowo trzymane poza indeksem Google. Jeśli te strony mają ten status, system działa zgodnie z założeniami. Prawdziwy problem zaczyna się wtedy, gdy tę etykietę dostają strony, które chcesz pozycjonować.
Najczęstsze przyczyny statusu "Wykluczono za pomocą tagu 'noindex'"
Dyrektywa noindex może trafić na Twoją stronę kilkoma różnymi drogami. To, która z nich jest aktywna w Twojej witrynie, decyduje o sposobie naprawy.
Metatag robots z "noindex" w sekcji <head>
Najczęstsze źródło. Linia taka jak <meta name="robots" content="noindex"> w kodzie HTML strony mówi Googlebotowi, żeby jej nie indeksował. Może być wpisana na stałe w szablonie albo dodawana dynamicznie przez CMS, wtyczkę lub funkcję motywu.
X-Robots-Tag w nagłówkach odpowiedzi HTTP
X-Robots-Tag działa dokładnie tak jak metatag, ale znajduje się w nagłówku odpowiedzi HTTP, a nie w kodzie HTML. Mogą go dodawać konfiguracje serwera, reguły CDN lub dyrektywy w .htaccess. Na przykład:
Header set X-Robots-Tag "noindex"
Dotyczy to każdego pliku pasującego do reguły, w tym plików PDF i obrazów, które nie mają sekcji <head> w HTML. Wielu właścicieli witryn całkowicie pomija tę drogę, bo dyrektywy nie widać w źródle strony.
Ustawienia CMS-a, które przypadkiem blokują indeksowanie
WordPress ma w Ustawienia › Czytanie pole wyboru "Proś wyszukiwarki o nieindeksowanie tej witryny". Gdy jest zaznaczone, WordPress dodaje tag robots noindex do każdej strony witryny. Wielu właścicieli włącza je w trakcie prac nad witryną i zapomina je odznaczyć po starcie.
Shopify może stosować noindex przez kod motywu lub aplikacje. Niektóre strony konta i strony systemowe Shopify samo trzyma poza indeksem, co jest prawidłowe, ale edycja motywu lub aplikacja SEO może przez pomyłkę dodać noindex do stron produktów, kolekcji lub bloga.
Wix stosuje noindex do każdej strony, której ustawienia SEO nie pozwalają wyszukiwarkom jej indeksować. Częstą przyczyną jest zduplikowanie strony i nieświadome odziedziczenie ustawienia noindex z oryginału.
Konflikty wtyczek lub motywów dodające noindex
Wtyczki SEO pozwalają ustawić noindex dla wpisu, strony lub typu treści. Źle skonfigurowana reguła globalna, aktualizacja wtyczki, która resetuje ustawienia, albo motyw nadpisujący dyrektywy wtyczki mogą jednocześnie rozprzestrzenić noindex na dziesiątki stron. Jeśli niedawno aktualizowałeś wtyczkę lub zmieniałeś motyw, sprawdź to w pierwszej kolejności.
Ustawienia środowiska testowego przeniesione na produkcję
Zaskakująco częste źródło przypadkowych tagów noindex. Twoja witryna testowa (staging) używa noindex, żeby nie trafić do Google. Gdy pipeline wdrożeniowy przenosi konfigurację stagingu na produkcję, dyrektywa noindex wędruje razem z nią. Zwykle dotyczy to od razu całych sekcji witryny i jest jedną z najtrudniejszych do zdiagnozowania przyczyn, jeśli sprawdzasz tylko pojedyncze strony.
Jak sprawdzić, których stron dotyczy problem
Powtarzalny proces diagnostyczny pozwala znaleźć wszystkie dotknięte adresy URL bez zgadywania. Zacznij od Search Console, żeby uzyskać listę, a potem przejdź do pojedynczych stron, żeby znaleźć źródło.
Eksport dotkniętych adresów URL z raportu Indeksowanie stron
Otwórz Google Search Console i przejdź do Indeksowanie › Strony. Kliknij "Wykluczono za pomocą tagu 'noindex'" w tabeli "Dlaczego strony nie są indeksowane". Search Console pokazuje próbkę dotkniętych adresów URL; użyj przycisku Eksportuj, aby pobrać listę do dalszej analizy.
Sprawdzanie pojedynczego adresu narzędziem Sprawdzanie adresu URL
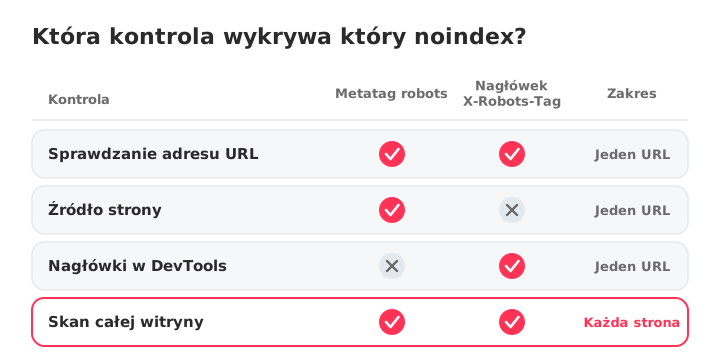
Wklej dowolny adres URL w pasek wyszukiwania u góry Search Console. Narzędzie Sprawdzanie adresu URL pokazuje, czy Google zobaczyło dyrektywę noindex i gdzie ją znalazło: w polu "Indeksowanie dozwolone?" podaje, czy noindex pochodzi z metatagu robots, czy z nagłówka HTTP X-Robots-Tag. Kliknij View crawled page, aby zobaczyć dokładny kod HTML, który otrzymał Googlebot. To najszybsza dostępna kontrola pojedynczej strony.
Sprawdzanie źródła strony pod kątem metatagów noindex
Otwórz stronę w przeglądarce, kliknij prawym przyciskiem i wybierz Wyświetl źródło strony, a następnie wyszukaj "noindex" (Ctrl+F lub Cmd+F). Jeśli znajdziesz <meta name="robots" content="noindex"> lub coś podobnego, winny jest metatag. Jeśli nie ma go w źródle, dyrektywa może pochodzić z nagłówka HTTP.
Sprawdzanie nagłówków HTTP w DevTools przeglądarki
Otwórz DevTools (F12 albo prawy przycisk › Zbadaj), przejdź do karty Network, odśwież stronę i kliknij żądanie głównego dokumentu. W sekcji Response Headers szukaj X-Robots-Tag: noindex. To jedyny sposób w przeglądarce, aby wykryć dyrektywy noindex przekazywane w nagłówku, których nie ma w kodzie HTML.
Skanowanie witryny za pomocą Screaming Frog lub SEOcrawl AI
Przy diagnozie całej witryny crawler wychwytuje wszystkie dotknięte strony za jednym razem. Screaming Frog SEO Spider pozwala filtrować strony według indeksowalności z uwzględnieniem metatagów i nagłówków. Crawler SEOcrawl AI skanuje każdą stronę, oznacza każdą z dyrektywą noindex w sekcji Indeksowalność i zwraca Audit Health Score, dzięki czemu widzisz pełną skalę problemu bez ręcznego eksportowania i filtrowania.
Jak naprawić "Wykluczono za pomocą tagu 'noindex'": krok po kroku
To najbardziej praktyczna część. Zastosuj poprawkę odpowiadającą diagnozie z poprzedniej sekcji.
Usuwanie metatagu noindex ze źródła strony
Edytuj szablon lub treść strony, aby usunąć <meta name="robots" content="noindex"> z sekcji <head> kodu HTML. W witrynach tworzonych na zamówienie sprawdź bezpośrednio pliki szablonów. Jeśli tag jest dodawany przez JavaScript, znajdź odpowiedzialny skrypt i usuń go lub dodaj warunek.
Przed:
<meta name="robots" content="noindex">
Po:
<meta name="robots" content="index, follow">
Możesz też po prostu całkowicie usunąć tag. Google traktuje brak dyrektywy noindex jako "indeksowanie dozwolone".
Naprawa X-Robots-Tag w konfiguracji serwera lub CDN
Sprawdź plik .htaccess (Apache), nginx.conf (Nginx) lub reguły CDN pod kątem dyrektyw X-Robots-Tag: noindex. Usuń je albo ogranicz do konkretnych ścieżek, które mają być wykluczone, zamiast stron, które chcesz mieć w indeksie. Możesz na przykład zostawić noindex na /staging/, a usunąć go z /blog/.
Jak to naprawić w WordPressie
Dwie kontrole, w tej kolejności:
- Ustawienie dla całej witryny: przejdź do Ustawienia › Czytanie i odznacz "Proś wyszukiwarki o nieindeksowanie tej witryny". To najczęstsza przyczyna problemów z noindex w całej witrynie na WordPressie.
- Ustawienia poszczególnych stron we wtyczkach SEO:
- Yoast SEO: otwórz wpis lub stronę, przewiń do pola Yoast, kliknij kartę Advanced i ustaw "Allow search engines to show this content in search results?" na "Yes".
- Rank Math: otwórz wpis, przejdź do pola Rank Math, kliknij kartę Advanced i ustaw "Robots Meta" na "Index".
- All in One SEO: edytuj wpis, otwórz kartę Advanced w ustawieniach AIOSEO i upewnij się, że w ustawieniach robots opcja "No Index" nie jest zaznaczona.
Sprawdź też globalne ustawienia każdej wtyczki pod kątem całych typów treści (tagów, kategorii, własnych typów wpisów) ustawionych na noindex. Resztę konfiguracji WordPressa opisujemy w poradniku o łączeniu WordPressa z Google Search Console.
Jak to naprawić w Shopify
W Shopify noindex pochodzi zwykle z kodu motywu lub z aplikacji. Otwórz Online Store › Themes › Edit code i przeszukaj theme.liquid oraz szablony stron w poszukiwaniu metatagu robots z noindex. Następnie sprawdź w aplikacjach SEO reguły ukrywające produkty, kolekcje lub wpisy na blogu, a także produkty i strony korzystające z metapola seo.hidden. Strony konta i inne strony systemowe Shopify trzyma poza indeksem i tak powinno zostać.
Jak to naprawić w Wix, Squarespace i innych kreatorach stron
Wix: otwórz ustawienia SEO strony (z menu strony) i włącz "Let search engines index this page". Jeśli strona została zduplikowana, kopia mogła odziedziczyć ustawienie noindex z oryginału.
Squarespace: sprawdź ustawienia SEO całej witryny pod kątem opcji ukrywającej witrynę przed wyszukiwarkami. W przypadku pojedynczych stron otwórz ustawienia strony i szukaj opcji "Hide page from search results" na karcie SEO. Squarespace domyślnie trzyma też niektóre strony systemowe, takie jak koszyk, poza wynikami wyszukiwania.
Po naprawie: prośba o ponowne zindeksowanie w Google Search Console
Usunięcie tagu noindex informuje Google, że może zindeksować stronę, ale Googlebot i tak musi ją ponownie zeskanować, aby potwierdzić zmianę.
Prośba o zindeksowanie w narzędziu Sprawdzanie adresu URL
Wklej poprawiony adres URL w pasek wyszukiwania Search Console. Kliknij Test live URL, aby potwierdzić, że indeksowanie jest teraz dozwolone, a potem kliknij Poproś o zindeksowanie. Google doda adres URL do kolejki ponownego skanowania. W ten sposób możesz zgłosić kilka adresów URL, ale Search Console ogranicza liczbę próśb dziennie.
Ile czasu Google potrzebuje, żeby ponownie zindeksować stronę?
Zwykle od kilku dni do kilku tygodni, zależnie od tego, jak często Googlebot odwiedza Twoją witrynę. Witryny z dużym ruchem i często aktualizowane są skanowane ponownie szybciej; nowe lub mało odwiedzane witryny mogą czekać tygodniami. Prośba o zindeksowanie to najszybszy sygnał, jaki możesz wysłać, ale nie gwarancja: dodaje adres URL do kolejki skanowania, a nie wymusza natychmiastowego ponownego skanowania.
Przesłanie zaktualizowanej mapy witryny XML, aby przyspieszyć skanowanie
Jeśli naprawiłeś wiele stron jednocześnie, prześlij zaktualizowaną mapę witryny XML w sekcji Mapy witryn w Search Console. To sygnał, że witryna się zmieniła, i zachęta do szerszego ponownego skanowania. Czysta mapa witryny bez adresów z noindex pozwala też uniknąć sprzecznych sygnałów, o czym piszemy dalej.
Kiedy zostawić tag noindex (celowe wykluczenia)
Nie każdy tag noindex trzeba usuwać. Niektóre strony nigdy nie powinny pojawiać się w wynikach wyszukiwania, a ich indeksowanie dodaje ubogie lub zduplikowane strony do obrazu Twojej witryny w oczach Google i marnuje uwagę crawlera.
Strony, które nigdy nie powinny być indeksowane
- Strony logowania i rejestracji
- Strony koszyka, kasy i potwierdzenia zamówienia
- Strony wyników wewnętrznej wyszukiwarki (aby uniknąć powielonej treści)
- Strony z podziękowaniem (lead magnety, wysłane formularze)
- Strony panelu administracyjnego i zaplecza
- Środowiska testowe i deweloperskie
- Strony filtrów i parametrów generujące zduplikowane adresy URL
noindex a robots.txt: najważniejsze różnice
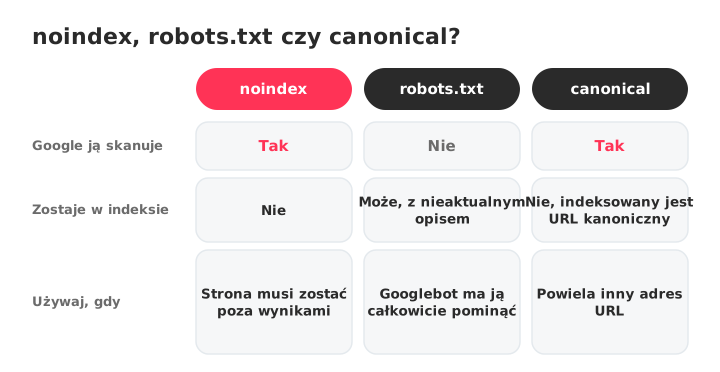
robots.txt blokuje skanowanie. noindex pozwala na skanowanie, ale blokuje indeksowanie. Jeśli zablokujesz stronę w robots.txt, Googlebot nigdy jej nie odczyta, co oznacza, że nie zobaczy też tagu noindex. Jeśli chcesz usunąć stronę z indeksu, użyj noindex. Jeśli chcesz, żeby Googlebot całkowicie pomijał stronę (aby oszczędzać budżet indeksowania), użyj robots.txt.
Częsty błąd: blokowanie w robots.txt strony, która jest już zindeksowana. Google nie zobaczy tagu noindex, jeśli nie może zeskanować strony, więc adres URL może zostać w indeksie z nieaktualnym tytułem i opisem. Prawidłowe podejście to zezwolenie na skanowanie i użycie noindex, aby usunąć stronę z indeksu.
Tagi kanoniczne a noindex: wybór właściwej dyrektywy
Tag kanoniczny (rel="canonical") mówi Google: "ta strona jest kopią tamtego adresu URL, pozycjonuj tamten". Tag noindex mówi Google: "w ogóle nie indeksuj tej strony". Służą różnym celom:
- Używaj canonical, gdy masz zduplikowaną lub prawie zduplikowaną treść i chcesz skupić sygnały rankingowe na jednym adresie URL.
- Używaj noindex, gdy strona w żadnych okolicznościach nie powinna pojawiać się w wynikach wyszukiwania.
Łączenie obu na tej samej stronie wysyła sprzeczne sygnały: jeden mówi "połącz tę stronę z innym adresem URL", drugi "usuń ją". Wybierz ten, który odpowiada Twojemu celowi.
Jak zapobiegać przypadkowym tagom noindex w przyszłości
Naprawianie problemów z noindex po fakcie jest konieczne, ale zapobieganie im oszczędza godziny diagnozy i utracony ruch.
Konfiguracja alertów Search Console o spadkach indeksowania
Google Search Console wysyła e-maile do zweryfikowanych właścicieli i użytkowników, gdy wykryje nowe problemy z indeksowaniem w usłudze. Upewnij się, że powiadomienia e-mail są włączone w ustawieniach e-maili Search Console. Jeśli liczba zindeksowanych stron nagle spadnie, alert da Ci przewagę, zanim spadnie ruch.
Dodanie kontroli noindex do listy QA przed publikacją
Przed wdrożeniem jakiejkolwiek witryny lub przeniesieniem stagingu na produkcję sprawdź, czy nie ma dyrektyw noindex. 30-sekundowa kontrola przez "Wyświetl źródło strony" i wyszukanie "noindex" wychwytuje najczęstszy błąd przy wdrożeniu. W większych witrynach zeskanuj je przed wdrożeniem i po nim, a potem porównaj liczbę stron z noindex. Dodaj to do swojej checklisty technicznego SEO, żeby nikt tego nie pominął.
Zaplanowane skany wykrywające niechciane dyrektywy noindex
Uruchamiaj pełny skan według harmonogramu, a także po każdej aktualizacji wtyczki, zmianie motywu lub migracji, aby wykryć niechciane tagi noindex, zanim odbiorą Ci ruch. Crawler SEOcrawl AI pozwala porównywać skany, dzięki czemu widzisz, które strony dostały noindex i kiedy, a SEO Monitor powiadamia Cię w chwili, gdy któraś z kluczowych stron otrzyma tag noindex.
Najczęściej zadawane pytania
Co oznacza "Wykluczono za pomocą tagu 'noindex'" w Google Search Console?
Oznacza, że Google znalazło na Twojej stronie dyrektywę noindex i ją uszanowało, więc strona nie pojawi się w wynikach wyszukiwania. Status widać w raporcie Indeksowanie stron w Search Console, w sekcji "Niezindeksowane".
Nie zawsze jest to błąd: strony, które celowo wykluczasz, takie jak logowanie czy kasa, powinny mieć ten status.
Jak naprawić "Wykluczono za pomocą tagu 'noindex'" w WordPressie?
Sprawdź dwa miejsca, w tej kolejności. Najpierw przejdź do Ustawienia › Czytanie i upewnij się, że opcja "Proś wyszukiwarki o nieindeksowanie tej witryny" jest odznaczona. Następnie otwórz każdy wpis lub stronę, których dotyczy problem, w swojej wtyczce SEO (Yoast, Rank Math, All in One SEO) i sprawdź, czy ustawienie robots dla danej strony pozwala na indeksowanie.
Ile czasu Google potrzebuje, żeby zindeksować stronę po usunięciu noindex?
Zwykle od kilku dni do kilku tygodni, zależnie od tego, jak często Googlebot odwiedza Twoją witrynę. Po usunięciu dyrektywy poproś o zindeksowanie za pomocą narzędzia Sprawdzanie adresu URL i prześlij zaktualizowaną mapę witryny XML, żeby przyspieszyć proces. Witryny z dużym ruchem są skanowane ponownie szybciej niż nowe lub mało odwiedzane.
Czy strona może zostać wykluczona przez noindex, nawet jeśli jest w mojej mapie witryny?
Tak. Dyrektywa noindex ma pierwszeństwo przed obecnością w mapie witryny. Google może nadal skanować adres URL z mapy witryny, ale nie zindeksuje go, dopóki noindex jest obecny.
Usuń noindex, aby strona mogła zostać zindeksowana, albo usuń adres URL z mapy witryny, jeśli wykluczenie jest celowe. Umieszczanie w mapie witryny adresów z noindex wysyła sprzeczne sygnały.
Czym różni się noindex od zablokowania strony w robots.txt?
robots.txt blokuje Googlebotowi skanowanie strony; noindex pozwala na skanowanie, ale uniemożliwia indeksowanie. Jeśli zablokujesz stronę w robots.txt, Google nie odczyta tagu noindex, więc strona, która już jest w indeksie, może w nim pozostać z nieaktualną treścią. Używaj noindex, aby usunąć stronę z indeksu, a robots.txt tylko wtedy, gdy chcesz całkowicie zablokować skanowanie.
Jak sprawdzić, czy strona ma tag noindex?
Trzy metody, od najszybszej do najdokładniejszej: użyj narzędzia Sprawdzanie adresu URL w Search Console, wyświetl źródło strony i wyszukaj "noindex" (Ctrl+F) albo sprawdź nagłówki odpowiedzi HTTP w DevTools przeglądarki (karta Network, szukaj X-Robots-Tag). Tylko narzędzie Sprawdzanie adresu URL i DevTools wykrywają noindex wysłany w nagłówku.
Czy powinienem się martwić, jeśli wiele stron ma status "Wykluczono za pomocą tagu 'noindex'"?
Tylko jeśli te strony powinny być zindeksowane. Wyeksportuj listę z Search Console, porównaj ją ze swoimi celowymi wykluczeniami (logowanie, koszyk, panel administracyjny, strony z podziękowaniem) i napraw tylko strony, które powinny pojawiać się w wynikach wyszukiwania. Jeśli każda strona z listy została wykluczona celowo, status działa prawidłowo.
Autor: David Kaufmann

Ostatnie ponad 10 lat spędziłem kompletnie zafascynowany SEO — i szczerze mówiąc, nie zamieniłbym tego na nic innego.
Moja kariera wskoczyła na zupełnie nowy poziom, gdy pracowałem jako senior SEO specialist w Chess.com — jednej ze 100 najczęściej odwiedzanych stron w całym internecie. Działanie na taką skalę, na milionach podstron, w dziesiątkach języków i w jednych z najbardziej konkurencyjnych SERPs, nauczyło mnie rzeczy, których nie dałby żaden kurs ani certyfikat. To doświadczenie zmieniło moje spojrzenie na to, jak naprawdę wygląda świetne SEO — i stało się fundamentem wszystkiego, co zbudowałem od tamtej pory.
Z tego doświadczenia narodziło się SEO Alive — agencja dla marek, które na poważnie podchodzą do wzrostu organicznego. Nie jesteśmy tu po to, żeby sprzedawać dashboards i miesięczne raporty. Jesteśmy tu, żeby budować strategie, które realnie robią różnicę, łącząc to, co najlepsze w klasycznym SEO, z ekscytującym nowym światem Generative Engine Optimization (GEO) — tak, aby Twoja marka pojawiała się nie tylko w niebieskich linkach Google, ale też wewnątrz odpowiedzi generowanych przez AI, które ChatGPT, Perplexity i Google AI Overviews dostarczają każdego dnia milionom ludzi.
A ponieważ nie mogłem znaleźć narzędzia, które potrafiłoby porządnie obsłużyć oba te światy, zbudowałem je sam — SEOcrawl AI, platformę enterprise SEO intelligence, która łączy w jednym miejscu rankings, audyty techniczne, monitoring backlinks, kondycję crawl i śledzenie widoczności marki w AI. To platforma, o której istnieniu zawsze marzyłem.
Odkryj więcej treści tego autora