


«Strona wykryta, ale obecnie niezindeksowana»: co to znaczy i jak to naprawić
Google wie, że Twój adres URL istnieje, ale jeszcze go nie odwiedził. Oto jak ocenić, czy czekać, czy działać, i jakie poprawki wypróbować najpierw w małej i dużej witrynie.
Strona wykryta, ale obecnie niezindeksowana oznacza, że Google znalazł adres URL, ale jeszcze go nie przeskanował. Tak opisuje to Pomoc dotycząca raportu Indeksowanie stron Google. Zwykle Google zamierzał skanować i przełożył to, by nie przeciążyć Twojej witryny, dlatego w raporcie data ostatniego skanowania jest pusta.
To status priorytetu skanowania, a nie wyrok o Twojej treści, ponieważ Google jeszcze nie przeczytał strony. Poniżej zobaczysz, czym różni się od «Zeskanowana», co znaleźliśmy, sprawdzając własną witrynę, oraz listę poprawek uporządkowaną według wielkości witryny. Dopiero zaczynasz z tym raportem? Zacznij od tego przewodnika po Google Search Console.
Co oznacza «Strona wykryta, ale obecnie niezindeksowana»
Google prowadzi adres URL przez cztery etapy: znalezienie, skanowanie, indeksowanie i dopiero potem ewentualne wyświetlenie w wynikach. Dwa statusy Search Console opisują adres, który po drodze utknął.
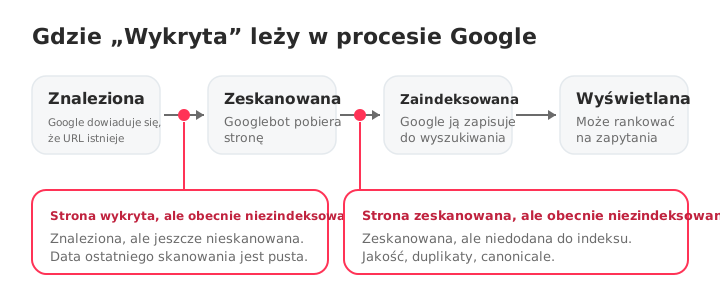
Adres URL trafia do «znalezionych» przez mapę witryny lub linki z innych stron. Potem Google decyduje, kiedy go przeskanować. «Wykryta» znaczy, że ta decyzja jeszcze nie zapadła.
Czym różni się od «Strona zeskanowana, ale obecnie niezindeksowana»
Oba statusy wyglądają podobnie, a wymagają innych poprawek.
| Strona wykryta, ale obecnie niezindeksowana | Strona zeskanowana, ale obecnie niezindeksowana | |
|---|---|---|
| Przeskanowana przez Google? | Nie | Tak |
| Data ostatniego skanowania | Pusta | Data |
| Czy Google przeczytał stronę? | Nie | Tak |
| Zwykły powód | Skanowanie odłożone lub niski priorytet | Google przeczytał stronę i ją pominął |
| Co sprawdzić najpierw | Linki wewnętrzne, mapa witryny, zdolność skanowania | Jakość treści, duplikaty, canonicale |
Pełną diagnozę drugiego statusu znajdziesz w przewodniku po statusie Strona zeskanowana, ale obecnie niezindeksowana.
Jak wygląda lista w prawdziwej witrynie
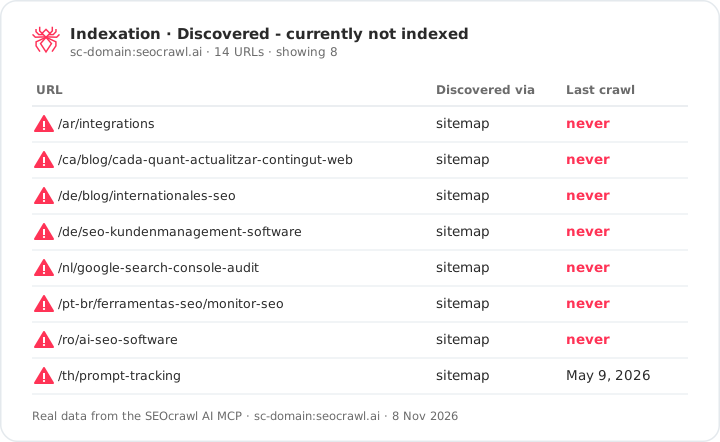
Sprawdziliśmy seocrawl.ai w raporcie Indeksowanie w SEOcrawl. Spośród 1000 adresów URL monitorowanych przez SEOcrawl (nasza mapa witryny deklaruje 6310) 823 są zindeksowane, czyli 82,3%. 128 ma status «Strona zeskanowana, ale obecnie niezindeksowana», a 14 — «Strona wykryta, ale obecnie niezindeksowana».
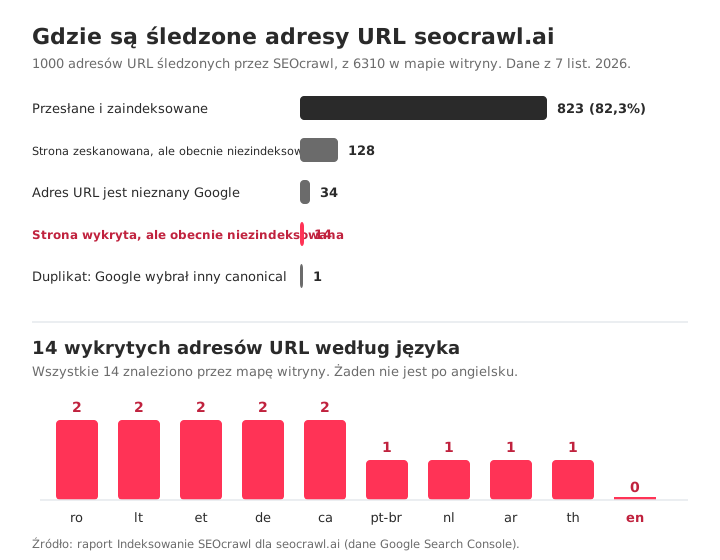
To, co mają wspólnego te 14, jest najcenniejsze:
- Wszystkie to przetłumaczone strony: arabski, kataloński, niemiecki, estoński, litewski, niderlandzki, portugalski brazylijski, rumuński i tajski. Żadna nie jest po angielsku.
- Google znalazł wszystkie 14 przez mapę witryny, a nie przez link z innej strony.
- Jedna z nich ma wcześniejszą datę skanowania (9 maja 2026), więc status opisuje, gdzie adres jest teraz, a nie to, że Google nigdy go nie odwiedził.
To wzorzec do sprawdzenia, a nie diagnoza. Strona istniejąca w 26 językach i docierana głównie przez mapę witryny to naturalny kandydat na słabe linki wewnętrzne, więc linki wewnętrzne to pierwsza rzecz do obejrzenia. Wniosek dotyczy każdej witryny: nie czytaj listy adres po adresie. Pogrupowane według języka, 14 adresów zamieniło się w jedno pytanie.
Liczby obejmują 1000 adresów monitorowanych przez SEOcrawl, czyli próbkę całej mapy witryny. Większa grupa 128 adresów to inny status i ma własny przewodnik.
Dlaczego Google odkłada skanowanie
Przewodnik po budżecie skanowania Google wyjaśnia, jak decyduje on, ile skanować: limit wydajności, który wytrzymuje Twój serwer, oraz zapotrzebowanie na Twoje adresy. Większość wykrytych adresów da się sprowadzić do jednej z pięciu przyczyn.
- Zdolność skanowania. Google podaje, że limit spada, gdy witryna działa wolno lub zwraca błędy serwera. Wolny serwer to mniej skanowań.
- Niskie zapotrzebowanie na skanowanie. Zależy ono od wielkości witryny, częstotliwości aktualizacji oraz jakości i trafności stron. Adres z niewielką liczbą linków wewnętrznych albo bez nich daje Google mało powodów, by szybko wrócić.
- Zmarnowane skanowanie. Zduplikowane adresy, parametry, filtry fasetowe, długie łańcuchy przekierowań i soft 404 konkurują z Twoimi prawdziwymi stronami. Google zauważa, że soft 404 są nadal skanowane i marnują budżet, a stronę z noindex Google i tak jeszcze pobiera, zanim ją porzuci.
- Znalezienie tylko przez mapę witryny. Mapa witryny informuje Google, że adres istnieje. Nie czyni go priorytetem, a Google traktuje mapę jako wskazówkę. Strony znalezione tylko tam czekają jako pierwsze.
- Nowa witryna lub sekcja. Każda witryna zaczyna od tego samego ostrożnego domyślnego limitu, który rośnie, gdy witryna dowodzi, że jest zdrowa.
Sam budżet skanowania zasługuje na Twoją uwagę tylko w bardzo dużych witrynach. Orientacyjna szacunkowa wartość Google: 1 000 000+ unikalnych stron aktualizowanych mniej więcej co tydzień albo 10 000+ stron zmieniających się codziennie. W mniejszych witrynach znacznie częstsze są przyczyny 2 i 4.
Czy to problem? Trzy pytania, zanim cokolwiek naprawisz
- Czy ten adres w ogóle powinien być zindeksowany? Jeśli to widok z filtrami, wewnętrzna strona wyszukiwania lub adres testowy, brak jest normalny. Aby to wyraźnie zaznaczyć, zastosuj noindex lub zwróć 404 albo 410 (zobacz Excluded by 'noindex' tag).
- Ile adresów i według jakiego wzorca? Google podaje, że przy mniej niż 500 stronach prawdopodobnie nawet nie potrzebujesz tego raportu. Lista jest też ograniczona do 1000 wierszy, więc w dużej witrynie to próbka.
- Czy są nowe? Adres opublikowany w zeszłym tygodniu nie jest jeszcze problemem. Przedziały czasowe samego Google znajdziesz w tabeli poniżej.
Jak to naprawić, zależnie od wielkości witryny
Właściwy pierwszy krok zależy od rozmiaru Twojej witryny, więc zacznij od odpowiedniej kolumny.
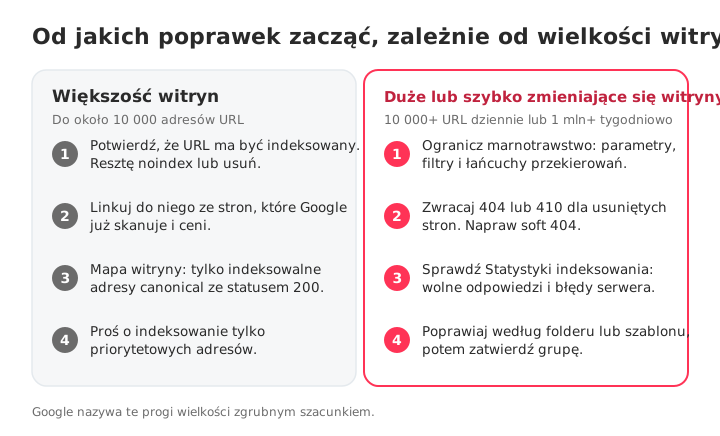
Większość witryn: do ok. 10 000 adresów
- Potwierdź, że adres zasługuje na indeksowanie. Jeśli nie, zastosuj noindex albo go usuń i skreśl z listy.
- Linkuj ze stron, które Google już skanuje. Dodaj kontekstowe linki z opisowym tekstem kotwicy ze stron zindeksowanych, które mają ruch. Każdy crawler pokaże Twoje strony-sieroty, filtrując strony bez linków wewnętrznych, a ten przewodnik po linkowaniu wewnętrznym zawiera pełną metodę.
- Utrzymuj czystą mapę witryny. Umieszczaj w niej tylko adresy zwracające 200, indeksowalne i będące wersją canonical, z poprawnym
lastmod. Google ignoruje priority i changefreq. Jeśli najpierw potrzebujesz pliku, znajdź swoją mapę witryny. Jeśli Search Console mówi, że żadnej nie znajduje, zobacz No referring sitemaps detected. - Poproś o indeksowanie kilku priorytetowych adresów. Otwórz narzędzie do sprawdzania adresów URL i kliknij Poproś o zindeksowanie. Google stosuje limit i podaje, że powtarzane prośby niczego nie przyspieszają, więc zachowaj to dla stron, które liczą się najbardziej.
Duże lub szybko zmieniające się witryny: 10 000+ adresów zmienianych dziennie lub 1 mln+ tygodniowo
- Ogranicz zmarnowane skanowanie. Zablokuj w robots.txt przestrzenie adresów bez wartości wyszukiwarkowej (parametry, fasety, wyszukiwarka wewnętrzna) i scalaj duplikaty za pomocą canonicali i przekierowań 301. Nie licz, że noindex oszczędzi budżet: Google nadal pobiera te strony.
- Zwracaj 404 lub 410 dla usuniętych stron i napraw soft 404. Google nazywa 404 silnym sygnałem, by nie skanować adresu ponownie, podczas gdy adresy zablokowane zostają w kolejce dłużej. Skróć każdy długi łańcuch przekierowań.
- Sprawdź statystyki skanowania. W Ustawieniach raport Statystyki skanowania pokazuje czasy odpowiedzi i błędy serwera. Jeśli są wysokie, Google obniża Twój limit wydajności i żadna poprawka treści nie pomoże, dopóki serwer się nie poprawi.
- Naprawiaj według folderu lub szablonu, a potem zatwierdź grupę. Podejmij jedną decyzję na wzorzec, utwórz mapę witryny tylko z naprawionymi adresami i kliknij Zatwierdź poprawkę. Przeczytaj więcej o budżecie skanowania, jeśli Twoja witryna należy do tej kategorii.
Czekać czy działać?
Najtrudniejsza nie jest poprawka, lecz wiedza, kiedy przestać czekać. Użyj przedziałów samego Google i własnego trendu.
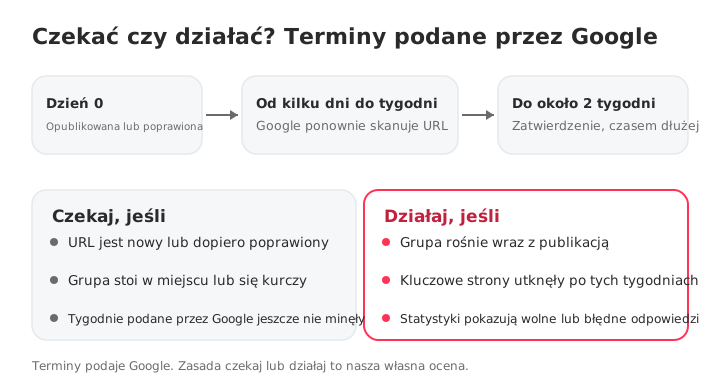
| Co zrobiono | Co mówi Google | Źródło |
|---|---|---|
| Poproszono Google o ponowne skanowanie | Od kilku dni do kilku tygodni | Prośba do Google o ponowne skanowanie |
| Poproszono o indeksowanie | Zwykle około doby, do jednego–dwóch tygodni, z dziennym limitem | Pomoc dotycząca sprawdzania adresów URL |
| Zatwierdzono poprawkę | Do ok. dwóch tygodni, czasem znacznie dłużej | Pomoc dotycząca indeksowania stron |
Przedziały czasowe pochodzą od Google. Reguła czekać czy działać jest nasza: czekaj, dopóki adres jest nowy, a grupa stabilna lub maleje, i działaj, gdy grupa wciąż rośnie albo kluczowe strony utknęły po tych tygodniach.
Jak monitorować to w czasie
Search Console pokazuje najnowszy stan każdego adresu i listę ograniczoną do 1000 wierszy, więc zbuduj własną rutynę:
- Raz w miesiącu eksportuj listę i porównuj z poprzednią. Czy grupa rośnie, jest stabilna czy maleje?
- Grupuj według wzorca (język, folder, szablon), zanim spojrzysz na pojedyncze adresy.
- Sprawdzaj, jak Google znalazł każdy adres. Lista z samym «mapa witryny» i bez «strony odsyłającej», jak nasze 14 adresów, wskazuje wprost na linki wewnętrzne.
Widok Indeksowanie w SEOcrawl AI dostarcza tę listę gotową: filtruj według stanu pokrycia, by zobaczyć adresy w nim, z datą ostatniego skanowania, kliknięciami i wyświetleniami. Przez MCP każdy adres zawiera też canonical wybrany przez Google obok zadeklarowanego oraz informację, czy znaleziono go przez mapę witryny, czy stronę odsyłającą. Crawler audytuje Twoje własne strony, więc zobaczysz, co jest słabe w adresie, zanim poprosisz Google o ponowne spojrzenie, a SEO Monitor ostrzega, gdy kluczowa strona dostaje noindex, zmienia canonical, zwraca 404 albo znika z mapy witryny.
Oto ta lista dla naszej własnej witryny, prosto z widoku Indeksowanie:
Możesz też pominąć panel. Z MCP SEOcrawl AI połączonym z Claude lub ChatGPT zapytaj: «Pokaż adresy ze statusem Strona wykryta, ale obecnie niezindeksowana i pogrupuj je według folderu.» Tu znajdziesz instrukcję krok po kroku, jak połączyć Search Console z Claude i ChatGPT.
Najczęściej zadawane pytania
Co oznacza «Strona wykryta, ale obecnie niezindeksowana»?
Oznacza, że Google znalazł Twój adres URL, ale jeszcze go nie przeskanował. Zwykle Google zamierzał skanować i to przełożył, dlatego data ostatniego skanowania jest pusta (Pomoc dotycząca indeksowania stron). Google nie przeczytał strony, więc status nic nie mówi o jej jakości. To nie jest kara.
Jak długo trwa «Strona wykryta, ale obecnie niezindeksowana»?
Google nie publikuje terminu dla tego statusu. Podaje, że zlecone ponowne skanowanie trwa od kilku dni do kilku tygodni, a zatwierdzenie poprawki do ok. dwóch tygodni, czasem znacznie dłużej. Nowy adres może po prostu potrzebować tych tygodni. Jeśli grupa rośnie w miarę publikowania, przestań czekać i działaj.
Czy poproszenie o indeksowanie to naprawia?
Może pomóc przy kilku priorytetowych adresach, bo prosi Google o wstawienie strony do kolejki. Nie usuwa przyczyny, więc strona może wrócić do tego samego statusu. Prośby podlegają dziennemu limitowi, a Google podaje, że wielokrotne zgłaszanie tego samego adresu niczego nie przyspiesza. Używaj tego po poprawie linków wewnętrznych, nigdy jako narzędzia masowego.
Czy to kara?
Nie. Działania ręczne mają osobny raport. Ten status oznacza, że Google znalazł adres i jeszcze go nie przeskanował, więc strony nie oceniono. Przyczyną jest zwykle priorytet skanowania: słabe linki wewnętrzne, wolny serwer albo mnóstwo mało wartościowych adresów konkurujących o skanowanie.
Dlaczego tyle moich stron jest wykrytych, ale niezindeksowanych?
Wysoka liczba zwykle wskazuje na wzorzec, a nie pojedyncze strony: parametry adresów lub fasety, duplikaty, mapę witryny z adresami, których tam być nie powinno, słabe linki wewnętrzne do całej sekcji albo serwer, który spowalnia Googlebota. Pogrupuj adresy według folderu, języka lub szablonu, zanim przyjrzysz się któremukolwiek osobno.
Czy w małej witrynie powinienem się martwić?
Zwykle nie. Google podaje, że jeśli Twoja witryna ma mniej niż 500 stron, raport Indeksowanie stron prawdopodobnie nie jest Ci nawet potrzebny. Kilka nowych adresów w tym statusie zwykle potrzebuje czasu i paru linków wewnętrznych ze stron, które Google już skanuje.
Jak SEOcrawl AI może pomóc przy wykrytych adresach?
Widok Indeksowanie w SEOcrawl AI wyświetla adresy utknięte w każdym stanie pokrycia Google, z datą ostatniego skanowania, kliknięciami i wyświetleniami. Przez MCP SEOcrawl AI możesz też poprosić Claude lub ChatGPT o tę listę z canonicalem Google obok zadeklarowanego i informacją, czy Google znalazł każdy adres przez mapę witryny, czy stronę odsyłającą, oraz pogrupować ją według folderu.
Więcej SEOcrawl AI w Google
Wybierz nas jako preferowane źródło, a zobaczysz więcej naszych artykułów w Najważniejszych artykułach Google.
Autor: David Kaufmann
Ostatnie ponad 10 lat spędziłem kompletnie zafascynowany SEO — i szczerze mówiąc, nie zamieniłbym tego na nic innego.
Moja kariera wskoczyła na zupełnie nowy poziom, gdy pracowałem jako senior SEO specialist w Chess.com — jednej ze 100 najczęściej odwiedzanych stron w całym internecie. Działanie na taką skalę, na milionach podstron, w dziesiątkach języków i w jednych z najbardziej konkurencyjnych SERPs, nauczyło mnie rzeczy, których nie dałby żaden kurs ani certyfikat. To doświadczenie zmieniło moje spojrzenie na to, jak naprawdę wygląda świetne SEO — i stało się fundamentem wszystkiego, co zbudowałem od tamtej pory.
Z tego doświadczenia narodziło się SEO Alive — agencja dla marek, które na poważnie podchodzą do wzrostu organicznego. Nie jesteśmy tu po to, żeby sprzedawać dashboards i miesięczne raporty. Jesteśmy tu, żeby budować strategie, które realnie robią różnicę, łącząc to, co najlepsze w klasycznym SEO, z ekscytującym nowym światem Generative Engine Optimization (GEO) — tak, aby Twoja marka pojawiała się nie tylko w niebieskich linkach Google, ale też wewnątrz odpowiedzi generowanych przez AI, które ChatGPT, Perplexity i Google AI Overviews dostarczają każdego dnia milionom ludzi.
A ponieważ nie mogłem znaleźć narzędzia, które potrafiłoby porządnie obsłużyć oba te światy, zbudowałem je sam — SEOcrawl AI, platformę enterprise SEO intelligence, która łączy w jednym miejscu rankings, audyty techniczne, monitoring backlinks, kondycję crawl i śledzenie widoczności marki w AI. To platforma, o której istnieniu zawsze marzyłem.
Odkryj więcej treści tego autora
Zmierzyliśmy kliknięcia z Google i ruch z asystentów AI na ponad 16 000 stron w 15 branżach. Ruch z AI rośnie o 45% rocznie, ale to wciąż około 1 wizyta na każde 100 z Google, a kliknięcia z Google spadły o 15%.

Do 30 listopada pierwszy rok każdego rocznego planu SEOcrawl AI kosztuje połowę ceny z kodem BLACKFRIDAY2026. Co dostajesz, co obejmują prompty w każdym planie i jak w 15 minut zobaczyć, gdzie wspominają o Tobie ChatGPT, Gemini, Claude i Perplexity.