« Explorée, actuellement non indexée » : signification et solutions

Google a visité votre URL, l'a lue et l'a laissée hors des résultats. Voici comment repérer les pages qui méritent une seconde chance, et comment Google conseille de les faire indexer.
Explorée, actuellement non indexée signifie que Googlebot a récupéré votre page et a décidé de ne pas l'ajouter à l'index de Google : elle ne peut donc pas apparaître dans les résultats de recherche. L'aide du rapport d'indexation des pages le formule ainsi : la page a été explorée mais pas indexée, et elle « pourra ou non être indexée à l'avenir ».
La cause est généralement la page elle-même, pas un blocage technique. Vous verrez ci-dessous comment décider, URL par URL, s'il faut corriger, passer en noindex ou supprimer chaque page, et combien de temps Google estime qu'une correction prend. Vous découvrez ce rapport ? Commencez par ce guide de Google Search Console.
Que signifie « Explorée, actuellement non indexée » ?
Ce statut signifie que Google a exploré la page et a choisi de ne pas l'indexer. Rien n'a bloqué Googlebot : Google a décidé de laisser la page de côté pour l'instant. Deux distinctions aident à bien lire ce statut.
Explorée ou indexée
L'exploration, c'est Googlebot qui télécharge une page. L'indexation, c'est Google qui l'enregistre pour pouvoir l'afficher dans les recherches. Une page peut être explorée de nombreuses fois sans jamais être indexée.
L'aide de l'outil d'inspection d'URL indique que la qualité d'une page doit être « suffisamment élevée pour justifier son indexation », et son test en direct ne peut pas du tout détecter ce statut.
En quoi il diffère de « Détectée, actuellement non indexée »
Détectée, actuellement non indexée intervient une étape plus tôt : Google a trouvé l'URL mais a reporté l'exploration pour ne pas surcharger votre site, si bien que la date de dernière exploration est vide.
| Détectée, actuellement non indexée | Explorée, actuellement non indexée | |
|---|---|---|
| Explorée par Google ? | Non | Oui |
| Date de dernière exploration | Vide | Une date |
| Raison habituelle | Exploration reportée pour ne pas surcharger le site | Google a lu la page et l'a écartée |
| À vérifier en premier | La capacité d'exploration, sur les très grands sites | Qualité du contenu, doublons, canoniques |
Google précise aussi que « Non indexée ne signifie pas forcément que c'est un problème ». Les pages en noindex, les URL bloquées dans le robots.txt, les doublons et les 404 sans remplacement sont censés rester en dehors.
Pourquoi Google explore des pages sans les indexer
L'indexation a une exigence de qualité que l'exploration n'a pas. Le guide de Google sur le budget d'exploration explique que la demande d'exploration augmente avec la valeur et l'originalité de votre contenu.
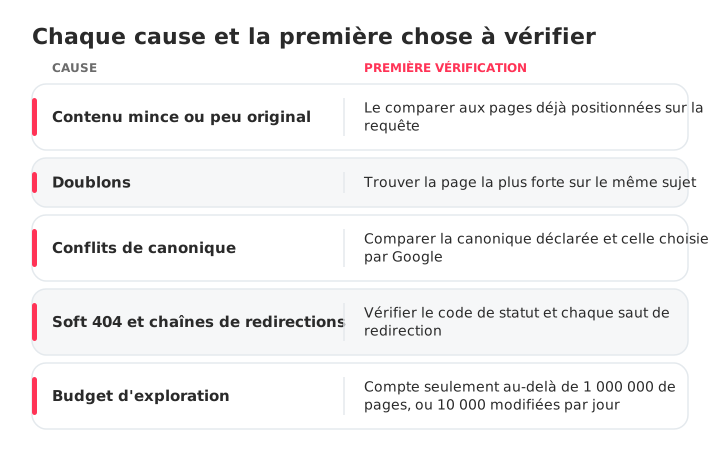
La plupart des URL concernées relèvent de l'une de ces causes, chacune avec sa première vérification :
- Contenu mince ou peu original : la page répète ce qui se positionne déjà.
- Doublons : archives de tags, URL triées, deux articles sur un même sujet. Voici comment repérer et corriger la cannibalisation de mots-clés.
- Conflits de canonique : comparez la canonique que vous déclarez avec celle que Google a sélectionnée. Quand Google choisit une autre URL, la page passe généralement à Autre page avec balise canonique correcte ou à un statut de doublon.
- Soft 404 et chaînes de redirections : selon Google, les soft 404 gaspillent du budget d'exploration.
- Budget d'exploration : il compte pour les sites de plus de 1 000 000 de pages modifiées chaque semaine ou de plus de 10 000 modifiées chaque jour. Pour la plupart des sites, ce n'est pas la cause.
Le niveau d'exigence a augmenté en deux étapes datées. Le 18 août 2022, Google a annoncé la mise à jour sur le contenu utile, un signal à l'échelle du site, en précisant que supprimer le contenu peu utile pouvait aider le reste du site. Le 5 mars 2024, Google a annoncé une mise à jour principale visant à afficher moins de contenu conçu pour attirer les clics, accompagnée d'une nouvelle règle anti-spam contre l'abus de contenu à grande échelle.
Les consignes de Google sur le contenu utile précisent que l'E-E-A-T n'est pas un facteur de classement en soi, que la fiabilité est ce qui compte le plus et qu'il n'existe pas de nombre de mots idéal. Rallonger une page ne réglera rien.
Comment trouver et diagnostiquer les pages concernées dans la GSC
Ouvrez le rapport d'indexation des pages (anciennement Couverture), inspectez un échantillon, puis regroupez la liste par motif. Google indique que les sites de moins de 500 pages n'ont probablement pas besoin de ce rapport.
Trouver les URL concernées dans le rapport Pages
- Dans Google Search Console, allez dans Indexation › Pages.
- Sous « Raisons pour lesquelles des pages ne sont pas indexées », cliquez sur Explorée, actuellement non indexée.
- Cliquez sur Exporter et téléchargez la liste.
Le rapport affiche jusqu'à 1 000 exemples d'URL, pas forcément toutes : sur un grand site, l'export n'est qu'un échantillon.
Vérifier les pages avec l'outil d'inspection d'URL
Inspectez cinq à dix URL exportées pour connaître la date de dernière exploration et l'URL canonique sélectionnée par Google. Une canonique qui pointe ailleurs signifie que Google voit un doublon ; une date d'exploration vieille de plusieurs mois suggère que Google revient rarement.
Repérer des motifs parmi des centaines d'URL
Triez l'export par dossier, modèle et paramètre d'URL, puis comptez chaque groupe. Imaginons 300 URL réparties en 180 pages /tag/, 70 URL ?sort= et 50 articles : cela fait trois décisions, pas 300.
Corriger, passer en noindex ou supprimer : décidez du sort de chaque URL
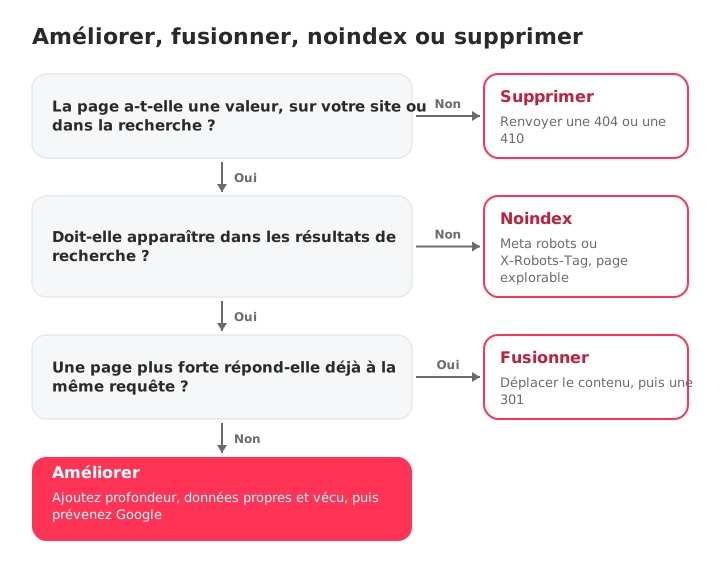
Chaque URL mérite l'une de ces quatre issues. Posez-vous la question : un internaute serait-il content d'arriver ici, et est-ce la seule page de votre site qui répond à la requête ?
| Type de page | Exemple | Décision | Comment |
|---|---|---|---|
| Utile et unique, mais mince | Un guide de 300 mots sur un sujet que vous maîtrisez | Améliorer | Ajouter de la profondeur et du vécu |
| Doublon d'une page plus forte | Deux articles sur la même requête | Fusionner | Déplacer le contenu, puis rediriger en 301 |
| Utile sur le site, pas dans la recherche | Archives de tags, recherche interne, pages de remerciement | Noindex | Balise meta robots ou X-Robots-Tag |
| Sans valeur, sans remplacement | Promotions expirées, pages de test | Supprimer | Renvoyer une 404 ou une 410 |
Le guide de Google sur le budget d'exploration appuie les deux dernières lignes : renvoyez une 404 ou une 410 pour les pages supprimées et regroupez les doublons. Une 404 dans Search Console est normale pour les pages que vous avez supprimées volontairement.
C'est sur le noindex que le tri dérape le plus souvent :
Pas comme ça : une balise noindex sur vos pages /tag/ alors que le robots.txt bloque /tag/. Googlebot ne peut pas récupérer les pages, il ne voit donc jamais la balise.
Comme ça : /tag/ reste explorable et porte le noindex sous forme de balise meta ou d'en-tête X-Robots-Tag.
D'après la documentation de Google sur le noindex, la règle ne fonctionne pas dans le robots.txt, et sur les pages rarement visitées, la nouvelle exploration peut prendre des mois. Une fois la balise lue, ces URL passent à Exclue par la balise 'noindex', ce qui est exactement ce que vous voulez pour elles.
Comment corriger les pages qui méritent d'être indexées
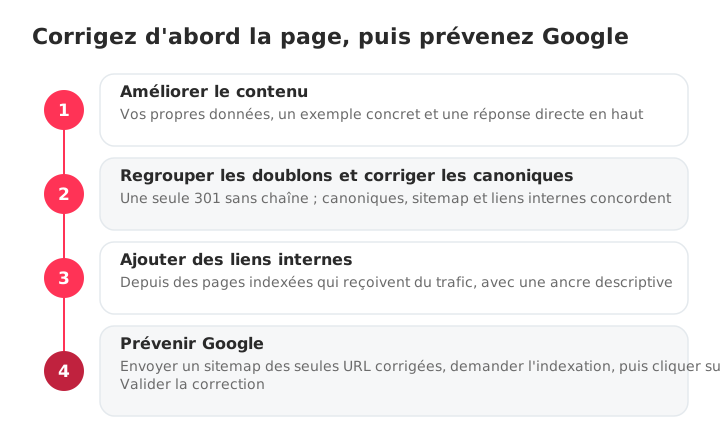
Rendez d'abord la page digne d'être indexée, puis prévenez Google. Demander l'indexation d'une page inchangée revient à demander à Google de répéter une décision déjà prise. L'ordre :
- Améliorer le contenu.
- Regrouper les doublons et corriger les canoniques.
- Ajouter des liens internes.
- Envoyer un sitemap ciblé et demander l'indexation.
Améliorer la profondeur et l'originalité du contenu
Réécrivez en fonction de la requête, pas d'un nombre de mots : ajoutez vos propres données, des captures d'écran, un exemple concret et une réponse directe en haut de page.
Prenons un guide mince de 300 mots : ajoutez un jeu de données de première main et un exemple concret, faites-y un lien depuis deux articles qui reçoivent déjà du trafic, et seulement ensuite ajoutez-le à un sitemap ciblé.
Regrouper les doublons et corriger les canoniques
Quand deux URL traitent du même sujet, gardez-en une, déplacez-y le contenu utile et faites une redirection 301 de l'autre directement vers elle, sans chaîne. Vérifiez ensuite que canoniques, sitemap et liens internes concordent, et qu'il ne reste aucun noindex oublié.
Ajouter des liens internes depuis des pages que Google valorise déjà
Faites un lien vers chaque page corrigée depuis des pages indexées qui reçoivent du trafic, avec une ancre descriptive. N'importe quel crawler peut lister les pages orphelines (zéro lien interne) en filtrant sur zéro lien entrant. La méthode complète se trouve dans ce guide de stratégie de maillage interne.
Vérifiez aussi la page sur mobile et dans le rapport Signaux Web essentiels (Core Web Vitals) : une page mobile défaillante est rapide à écarter.
Envoyer un sitemap ciblé et demander l'indexation
Créez un sitemap ne contenant que les URL que vous avez corrigées, envoyez-le, et filtrez le rapport Pages avec lui avant de cliquer sur Valider la correction. Google le suggère pour accélérer la validation. Si vous avez d'abord besoin de votre fichier actuel, trouvez le sitemap de votre site.
Google ignore priority et changefreq : gardez plutôt un lastmod exact. Cliquez ensuite sur Demander l'indexation dans l'outil d'inspection d'URL pour vos URL prioritaires : Google applique un quota et précise que répéter les demandes n'accélère rien.
Combien de temps prend l'indexation après une correction ?
Comptez d'un jour à plusieurs semaines, et l'indexation n'est jamais garantie. Google donne des fourchettes différentes selon les pages ; les voici côte à côte :
| Ce que vous avez fait | Ce que dit Google | Source |
|---|---|---|
| Demandé une nouvelle exploration | De quelques jours à quelques semaines | Demander à Google d'explorer à nouveau |
| Demander l'indexation | En général un jour environ, jusqu'à une ou deux semaines, avec une limite quotidienne | Aide de l'inspection d'URL |
| Valider la correction | Jusqu'à deux semaines environ, parfois beaucoup plus | Aide de l'indexation des pages |
Ce sont les délais annoncés par Google, pas des cas de récupération. Consultez le rapport Pages chaque semaine ; si les URL corrigées n'ont pas bougé une fois ces délais passés, revenez au contenu.
Comment éviter que de nouvelles pages tombent dans ce statut
La prévention est une routine : vérifiez chaque page avant sa mise en ligne et passez Search Console en revue chaque mois. Avant de publier, assurez-vous que la page :
- Répond à une requête à laquelle aucune autre page de votre site ne répond.
- Apporte vos propres données, exemples ou expérience.
- A une canonique auto-référente et aucun noindex oublié.
- Figure dans le sitemap avec un lastmod exact.
- A un auteur identifié et, le cas échéant, des données structurées.
- Reçoit un lien depuis une page indexée et liée au sujet.
Une fois par mois, comparez le rapport Pages avec celui du mois précédent ; un problème reste affiché pendant 90 jours après la disparition de sa dernière occurrence. Les sites de plus de mille pages devraient aussi surveiller le rapport Statistiques sur l'exploration.
SEOcrawl AI gère la partie technique à grande échelle. Le Crawler analyse chaque page et renvoie un Audit Health Score, avec les problèmes ventilés par Indexability, Crawlability, On-Page et plus encore. Sa vue Indexation regroupe vos URL par état de couverture Search Console : vous voyez combien se trouvent dans « Explorée, actuellement non indexée » et suivez ce nombre dans le temps.
Entre deux crawls, SEO Monitor vous alerte lorsqu'une page clé reçoit un noindex, change de canonique, renvoie une 404 ou sort du sitemap. La même plateforme suit la visibilité de votre marque dans ChatGPT, Claude, Gemini, Perplexity et Copilot, pour réunir SEO et GEO au même endroit.
FAQ
Que signifie « Explorée, actuellement non indexée » ?
Cela signifie que Googlebot a récupéré votre page et a décidé de ne pas l'ajouter à l'index de Google : elle ne peut donc pas apparaître dans les résultats. Rien n'a bloqué l'exploration : Google a lu la page et a choisi de la laisser de côté pour l'instant. Ce n'est pas une pénalité manuelle, et la page pourra ou non être indexée à l'avenir.
Est-ce la même chose que « Détectée, actuellement non indexée » ?
Non. « Détectée » signifie que Google connaît l'URL mais a reporté l'exploration : la date de dernière exploration est donc vide. « Explorée » signifie que Google a déjà visité et lu la page, puis a décidé de ne pas l'indexer. Pour Détectée, regardez la capacité d'exploration sur les très grands sites ; pour Explorée, regardez la qualité du contenu, les doublons et les balises canoniques.
« Explorée, actuellement non indexée » nuit-il à mon SEO ?
Pas en soi : ce statut n'est pas une pénalité, et la page concernée ne perd que son propre trafic de recherche. Le risque, c'est le volume, car Google traite une forte proportion de contenu peu utile comme un signal à l'échelle du site. Une archive de tags hors de l'index ne coûte rien ; une fiche produit, si. Si le nombre augmente à chaque publication, traitez-le comme un problème de contenu global, pas comme une liste d'URL isolées.
Combien de temps faut-il pour qu'une page soit indexée après une correction ?
Comptez d'un jour à plusieurs semaines, et l'indexation n'est jamais garantie. Selon Google, une nouvelle exploration prend de quelques jours à quelques semaines, une demande d'indexation est généralement traitée en un jour environ mais peut prendre une à deux semaines, et une validation de correction prend en général jusqu'à deux semaines environ.
Demander l'indexation va-t-il aider ?
Seulement après avoir modifié la page. Demander l'indexation d'une page inchangée revient à demander à Google de répéter une décision déjà prise. Les demandes sont soumises à un quota quotidien, et Google précise qu'envoyer plusieurs fois la même URL n'accélère rien.
Ajouter la page à mon sitemap XML aide-t-il ?
Cela aide Google à trouver une URL, pas à l'indexer. Google qualifie un sitemap envoyé de « simple indication », et ces pages ont déjà été trouvées et lues. Après une correction, le rôle du sitemap est de regrouper les URL que vous voulez faire revérifier. Chaque fichier sitemap contient au maximum 50 000 URL ou 50 Mo.
Pourquoi ma validation « Explorée, actuellement non indexée » a-t-elle échoué ?
La validation s'arrête dès que Google trouve dans le groupe une URL encore non corrigée : une seule page oubliée peut faire échouer tout le lot. Corrigez toutes les URL du groupe, ou réduisez-le en filtrant le rapport avec un sitemap ne contenant que vos URL corrigées, puis relancez la validation.
Comment SEOcrawl AI aide-t-il avec les pages que Google explore sans les indexer ?
SEOcrawl AI identifie les causes on-site derrière ce statut. Le Crawler affiche pour chaque URL son score de santé, son code de statut HTTP et sa profondeur d'exploration, pour repérer les pages difficiles à atteindre pour Google. La vue Indexation regroupe vos URL par état de couverture Search Console, et SEO Monitor vous alerte lorsqu'une page clé reçoit un noindex, change de canonique, renvoie une 404 ou sort du sitemap.
Auteur : David Kaufmann

Cela fait plus de 10 ans que je suis totalement obsédé par le SEO — et honnêtement, je ne voudrais pas qu'il en soit autrement.
Ma carrière a franchi un cap lorsque j'ai travaillé comme Senior SEO Specialist pour Chess.com — l'un des 100 sites les plus visités de tout Internet. Opérer à cette échelle, sur des millions de pages, des dizaines de langues et dans l'une des SERPs les plus concurrentielles qui soient, m'a appris des choses qu'aucun cours ni aucune certification ne pourrait jamais transmettre. Cette expérience a transformé ma vision de ce qu'est réellement un SEO d'excellence — et elle est devenue le socle de tout ce que j'ai construit depuis.
Forcé par cette expérience, j'ai fondé SEO Alive — une agence pour les marques qui prennent la croissance organique au sérieux. Nous ne sommes pas là pour vendre des dashboards et des rapports mensuels. Nous sommes là pour bâtir des stratégies qui font vraiment la différence, en combinant le meilleur du SEO classique avec le nouvel univers passionnant de la Generative Engine Optimization (GEO) — afin que votre marque apparaisse non seulement dans les liens bleus de Google, mais aussi dans les réponses générées par l'AI que ChatGPT, Perplexity et Google AI Overviews livrent chaque jour à des millions de personnes.
Et parce que je ne trouvais aucun outil capable de gérer correctement ces deux mondes, j'en ai construit un moi-même — SEOcrawl AI, une plateforme d'intelligence SEO pour les entreprises qui réunit rankings, audits techniques, monitoring des backlinks, santé du crawl et suivi de la visibilité de marque dans l'AI, le tout au même endroit. C'est la plateforme dont j'ai toujours rêvé.
Découvrez plus de contenu de cet auteur

Une page de listing produits (PLP) affiche toute une catégorie de produits d'un coup. Découvrez en quoi elle diffère d'une PDP, ce qui la fait convertir et comment faire indexer vos pages de listing sans le chaos de la navigation à facettes.

Le Domain Authority prédit la capacité d'un site à se positionner, mais ce n'est pas un facteur de classement Google. Voici ce que le DA mesure vraiment, comment il se compare au DR et à l'Authority Score, et quelles métriques méritent plutôt votre attention.