Exclue par la balise 'noindex' : signification et solutions
Vous avez ouvert Google Search Console, repéré une série d'URL signalées "Exclue par la balise 'noindex'", et ces pages sont désormais invisibles dans la recherche.
Si vous avez repéré une série d'URL portant le statut "Exclue par la balise 'noindex'" dans Google Search Console, vos pages sont délibérément tenues à l'écart de l'index de Google, et la solution est souvent plus simple qu'il n'y paraît : trouvez la directive, supprimez-la et demandez à Google d'explorer à nouveau.
Ce guide explique précisément ce qui déclenche ce statut, comment identifier la directive noindex en cause et les étapes exactes pour la supprimer dans tous les grands CMS, afin que vos pages puissent de nouveau se positionner. La même vérification s'exécute automatiquement dans le Crawler de SEOcrawl AI, qui détecte les directives noindex sur l'ensemble de votre site sans vérification URL par URL.
Que signifie "Exclue par la balise 'noindex'" dans Google Search Console ?
Le statut "Exclue par la balise 'noindex'" signifie que Googlebot a exploré votre page, trouvé une directive noindex et l'a respectée en gardant la page hors de l'index de Google. Votre page n'apparaîtra pas dans les résultats de recherche tant que cette directive restera en place.
Où ce statut apparaît dans la GSC
Dans l'ancien rapport Couverture (remplacé par le rapport d'indexation des pages en 2022), ce statut apparaissait sous "Exclues". Dans l'actuel rapport d'indexation des pages (Indexation › Pages), vous le trouverez sous "Non indexée", dans le tableau "Raisons pour lesquelles des pages ne sont pas indexées", avec le motif "Exclue par la balise 'noindex'". Google regroupe toutes les URL concernées sous ce libellé pour que vous puissiez les exporter et les examiner en masse.
Comment Google détecte et respecte la directive noindex
La documentation de Google sur le blocage de l'indexation avec noindex décrit deux méthodes : une balise <meta name="robots" content="noindex"> dans le <head> HTML de la page, ou une directive X-Robots-Tag: noindex dans les en-têtes de réponse HTTP. Lorsque Googlebot rencontre l'une ou l'autre, il retire complètement la page de l'index, même si elle était indexée auparavant. Pour les bases de la balise elle-même, consultez notre guide de la balise meta noindex.
Est-ce toujours un problème ? Quand l'exclusion est volontaire
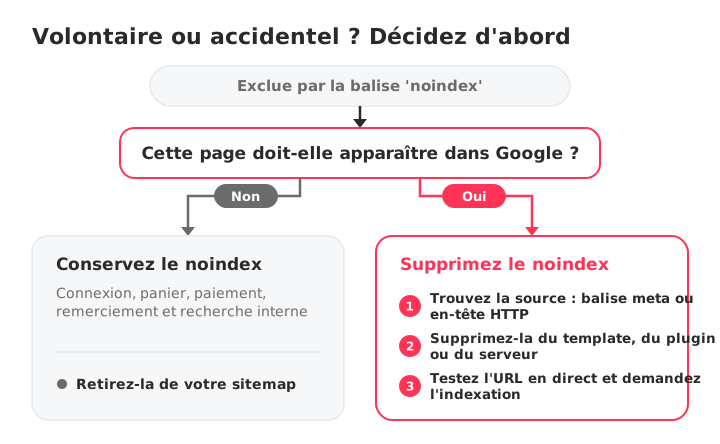
Toutes les URL "Exclue par la balise 'noindex'" ne sont pas des erreurs. Les pages d'administration, les écrans de connexion, le panier et le tunnel de paiement, les pages de remerciement et les résultats de recherche interne sont volontairement tenus hors de l'index de Google. Si ces pages affichent ce statut, le système fonctionne comme prévu. Le vrai problème commence quand des pages que vous voulez positionner portent ce libellé.
Causes fréquentes du statut "Exclue par la balise 'noindex'"
Une directive noindex peut atteindre votre page par plusieurs voies différentes. Savoir laquelle est active sur votre site détermine la solution.
Balise meta robots avec "noindex" dans le <head>
C'est la source la plus courante. Une ligne comme <meta name="robots" content="noindex"> dans le HTML de votre page indique à Googlebot de ne pas l'indexer. Elle peut être codée en dur dans le template ou injectée dynamiquement par un CMS, une extension ou une fonction du thème.
X-Robots-Tag dans les en-têtes de réponse HTTP
Le X-Robots-Tag fonctionne exactement comme la balise meta, mais il se trouve dans l'en-tête de réponse HTTP, pas dans le HTML. Des configurations serveur, des règles de CDN ou des directives .htaccess peuvent l'ajouter. Par exemple :
Header set X-Robots-Tag "noindex"
Cela concerne tous les fichiers visés par la règle, y compris les PDF et les images qui n'ont pas de section <head> HTML. Beaucoup de propriétaires de sites passent complètement à côté de cette voie, car la directive n'est pas visible dans le code source de la page.
Réglages du CMS qui bloquent l'indexation par erreur
WordPress propose une case à cocher dans Réglages › Lecture intitulée "Demander aux moteurs de recherche de ne pas indexer ce site". Lorsqu'elle est cochée, WordPress ajoute une balise robots noindex à toutes les pages du site. Beaucoup de propriétaires l'activent pendant le développement et oublient de la décocher après le lancement.
Shopify peut appliquer un noindex via le code du thème ou des applications. Shopify garde lui-même certaines pages de compte et pages système hors de l'index, ce qui est normal, mais une modification du thème ou une application SEO peut ajouter par erreur un noindex à des pages produit, collection ou blog.
Wix applique un noindex à toute page dont les paramètres SEO empêchent les moteurs de recherche de l'indexer. Un déclencheur fréquent : dupliquer une page et hériter sans s'en rendre compte du réglage noindex de l'original.
Conflits d'extensions ou de thèmes qui ajoutent un noindex
Les extensions SEO permettent de définir un noindex par article, par page ou par type de contenu. Une règle globale mal configurée, une mise à jour d'extension qui réinitialise les réglages ou un thème qui écrase les directives de l'extension peuvent propager un noindex sur des dizaines de pages à la fois. Si vous avez récemment mis à jour une extension ou changé de thème, vérifiez ce point en premier.
Réglages de préproduction poussés en production
Une source étonnamment fréquente de balises noindex accidentelles. Votre site de préproduction utilise un noindex pour rester hors de Google. Lorsque le pipeline de déploiement pousse la configuration de préproduction en production, la directive noindex part avec. Cela touche généralement des sections entières d'un site d'un coup et c'est l'une des causes les plus difficiles à diagnostiquer si vous ne vérifiez que des pages isolées.
Comment identifier les pages concernées
Un processus de diagnostic reproductible repère toutes les URL concernées sans deviner. Commencez par la Search Console pour obtenir la liste, puis descendez au niveau de chaque page pour trouver la source.
Exporter les URL concernées depuis le rapport d'indexation des pages
Ouvrez Google Search Console et allez dans Indexation › Pages. Cliquez sur "Exclue par la balise 'noindex'" dans le tableau "Raisons pour lesquelles des pages ne sont pas indexées". La Search Console affiche un échantillon des URL concernées ; utilisez le bouton Exporter pour télécharger la liste et la traiter.
Inspecter une URL avec l'outil d'inspection d'URL
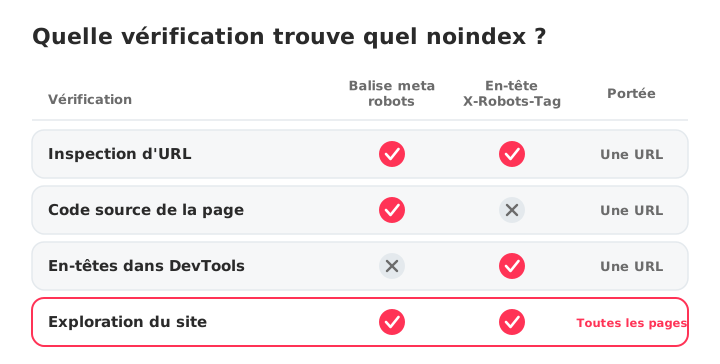
Collez n'importe quelle URL dans la barre de recherche en haut de la Search Console. L'outil d'inspection d'URL indique si Google a vu une directive noindex et où il l'a trouvée : sous "Indexation autorisée ?", il précise si le noindex provient de la balise meta robots ou de l'en-tête HTTP X-Robots-Tag. Cliquez sur Afficher la page explorée pour voir le HTML exact reçu par Googlebot. C'est la vérification d'une page la plus rapide qui existe.
Rechercher les balises meta noindex dans le code source
Ouvrez la page dans votre navigateur, faites un clic droit, sélectionnez Afficher le code source de la page, puis recherchez "noindex" (Ctrl+F ou Cmd+F). Si vous trouvez <meta name="robots" content="noindex"> ou équivalent, la balise meta est la coupable. Si elle n'apparaît pas dans le code source, la directive vient peut-être de l'en-tête HTTP.
Vérifier les en-têtes HTTP avec les DevTools du navigateur
Ouvrez les DevTools (F12, ou clic droit › Inspecter), allez dans l'onglet Réseau, rechargez la page et cliquez sur la requête du document principal. Cherchez X-Robots-Tag: noindex dans la section En-têtes de réponse. C'est le seul moyen, dans le navigateur, de détecter les directives noindex envoyées dans l'en-tête qui n'apparaissent pas dans le HTML.
Explorer votre site avec Screaming Frog ou SEOcrawl AI
Pour un diagnostic à l'échelle du site, un crawler repère toutes les pages concernées en un seul passage. Screaming Frog SEO Spider peut filtrer les pages selon leur indexabilité, en tenant compte des balises meta et des en-têtes. Le Crawler de SEOcrawl AI explore chaque page, signale chacune de celles qui ont une directive noindex dans Indexabilité et renvoie un Audit Health Score, pour que vous voyiez toute l'étendue du problème sans exporter ni filtrer à la main.
Comment corriger "Exclue par la balise 'noindex'" : étape par étape
C'est la section la plus concrète. Appliquez la correction qui correspond au diagnostic de la section précédente.
Supprimer la balise meta noindex du code source
Modifiez le template ou le contenu de la page pour supprimer <meta name="robots" content="noindex"> du <head> HTML. Sur les sites développés sur mesure, vérifiez directement les fichiers de template. Si la balise est injectée en JavaScript, trouvez le script responsable et supprimez-le ou ajoutez-lui une condition.
Avant :
<meta name="robots" content="noindex">
Après :
<meta name="robots" content="index, follow">
Ou supprimez tout simplement la balise. Google considère l'absence de directive noindex comme "indexation autorisée".
Corriger le X-Robots-Tag dans la configuration du serveur ou du CDN
Vérifiez votre .htaccess (Apache), votre nginx.conf (Nginx) ou vos règles de CDN à la recherche de directives X-Robots-Tag: noindex. Supprimez-les, ou limitez-les aux chemins qui doivent réellement être exclus plutôt qu'aux pages que vous voulez indexer. Par exemple, vous pouvez conserver le noindex sur /staging/ tout en le retirant de /blog/.
Comment corriger le problème dans WordPress
Deux vérifications, dans cet ordre :
- Réglage global du site : allez dans Réglages › Lecture et décochez "Demander aux moteurs de recherche de ne pas indexer ce site". C'est la cause la plus fréquente des problèmes de noindex sur l'ensemble d'un site WordPress.
- Réglages par page dans les extensions SEO :
- Yoast SEO : ouvrez l'article ou la page, descendez jusqu'à la meta box Yoast, cliquez sur l'onglet Avancé et réglez "Autoriser les moteurs de recherche à afficher ce contenu dans les résultats de recherche ?" sur "Oui".
- Rank Math : ouvrez l'article, allez dans la meta box Rank Math, cliquez sur l'onglet Avancé et réglez "Robots Meta" sur "Index".
- All in One SEO : modifiez l'article, ouvrez l'onglet Avancé des réglages AIOSEO et assurez-vous que "No Index" n'est pas coché dans les réglages robots.
Vérifiez aussi les réglages globaux de chaque extension pour repérer des types de contenu entiers (étiquettes, catégories, types de publication personnalisés) réglés en noindex. Pour le reste de la configuration WordPress, consultez notre guide pour connecter WordPress à Google Search Console.
Comment corriger le problème dans Shopify
Dans Shopify, le noindex vient généralement du code du thème ou d'une application. Ouvrez Boutique en ligne › Thèmes › Modifier le code et recherchez dans theme.liquid et les templates de page une balise meta robots avec noindex. Vérifiez ensuite vos applications SEO à la recherche de règles qui masquent des produits, des collections ou des articles de blog, ainsi que tout produit ou page utilisant le champ méta seo.hidden. Les pages de compte et autres pages système sont gardées hors de l'index par Shopify et doivent le rester.
Comment corriger le problème dans Wix, Squarespace et les autres créateurs de sites
Wix : ouvrez les paramètres SEO de la page (depuis le menu de la page) et activez "Let search engines index this page". Si vous avez dupliqué une page, la copie a peut-être hérité du réglage noindex de l'original.
Squarespace : vérifiez les paramètres SEO globaux du site à la recherche d'une option qui le masque aux moteurs de recherche. Pour une page précise, ouvrez ses paramètres et cherchez "Hide page from search results" dans l'onglet SEO. Squarespace garde aussi par défaut certaines pages système, comme le panier, hors des résultats de recherche.
Après la correction : demander la réindexation dans Google Search Console
Supprimer la balise noindex indique à Google qu'il peut indexer la page, mais Googlebot doit encore la réexplorer pour confirmer le changement.
Utiliser l'outil d'inspection d'URL pour demander l'indexation
Collez l'URL corrigée dans la barre de recherche de la Search Console. Cliquez sur Tester l'URL en direct pour confirmer que l'indexation est désormais autorisée, puis sur Demander l'indexation. Google placera l'URL dans la file d'attente d'exploration. Vous pouvez soumettre plusieurs URL de cette manière, mais la Search Console limite le nombre de demandes par jour.
Combien de temps faut-il à Google pour réindexer une page ?
En général de quelques jours à quelques semaines, selon la fréquence à laquelle Googlebot explore votre site. Les sites à fort trafic et souvent mis à jour sont réexplorés plus vite ; les sites récents ou peu visités peuvent attendre des semaines. Demander l'indexation est le signal le plus rapide que vous puissiez envoyer, mais ce n'est pas une garantie : cela place votre URL dans la file d'exploration, sans forcer une exploration immédiate.
Soumettre un sitemap XML à jour pour accélérer l'exploration
Si vous avez corrigé beaucoup de pages d'un coup, soumettez un sitemap XML à jour dans la section Sitemaps de la Search Console. Cela signale que votre site a changé et encourage une réexploration plus large. Un sitemap propre, sans URL en noindex, évite aussi d'envoyer des signaux contradictoires, comme nous le verrons ensuite.
Quand conserver la balise noindex (exclusions volontaires)
Toutes les balises noindex ne sont pas à supprimer. Certaines pages ne devraient jamais apparaître dans les résultats de recherche, et les indexer ajoute des pages pauvres ou dupliquées à la vision que Google a de votre site, tout en gaspillant de l'attention d'exploration.
Pages qui ne devraient jamais être indexées
- Pages de connexion et d'inscription
- Pages de panier, de paiement et de confirmation de commande
- Pages de résultats de recherche interne (pour éviter le contenu dupliqué)
- Pages de remerciement (lead magnets, envois de formulaires)
- Pages d'administration et de back-office
- Environnements de préproduction et de développement
- Pages de filtres et de paramètres qui génèrent des URL dupliquées
noindex ou robots.txt : les différences clés
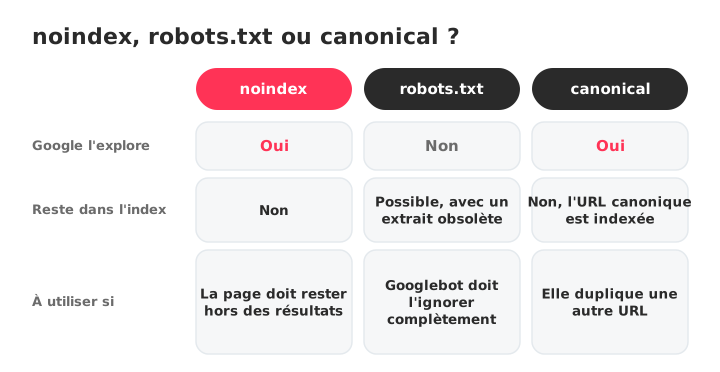
Le robots.txt bloque l'exploration. noindex autorise l'exploration mais bloque l'indexation. Si vous bloquez une page dans le robots.txt, Googlebot ne la lit jamais, ce qui signifie qu'il ne voit jamais non plus la balise noindex. Si vous voulez retirer une page de l'index, utilisez noindex. Si vous voulez que Googlebot ignore complètement la page (pour économiser le budget d'exploration), utilisez le robots.txt.
Une erreur fréquente : utiliser le robots.txt pour bloquer une page déjà indexée. Google ne peut pas voir la balise noindex s'il ne peut pas explorer la page, et l'URL peut donc rester dans l'index avec un titre et un extrait obsolètes. La bonne approche consiste à autoriser l'exploration et à utiliser noindex pour retirer la page de l'index.
Balises canonical ou noindex : choisir la bonne directive
Une balise canonical (rel="canonical") dit à Google "cette page est une copie de cette autre URL, positionne plutôt celle-là". Une balise noindex dit à Google "n'indexe pas du tout cette page". Elles ont des rôles différents :
- Utilisez canonical lorsque vous avez du contenu dupliqué ou quasi dupliqué et que vous voulez regrouper les signaux de positionnement sur une seule URL.
- Utilisez noindex lorsque la page ne doit en aucun cas apparaître dans les résultats de recherche.
Combiner les deux sur la même page envoie des signaux contradictoires : l'une dit "fusionne cette page avec une autre URL", l'autre dit "écarte-la". Choisissez celle qui correspond à votre objectif.
Éviter les balises noindex accidentelles à l'avenir
Corriger les problèmes de noindex après coup est nécessaire, mais les prévenir vous épargne des heures de diagnostic et du trafic perdu.
Configurer des alertes Search Console en cas de baisse de l'indexation
Google Search Console envoie un e-mail aux propriétaires et utilisateurs validés lorsqu'elle détecte de nouveaux problèmes d'indexation sur une propriété. Assurez-vous que les notifications par e-mail sont activées dans vos préférences d'e-mail de la Search Console. Si le nombre de pages indexées chute brutalement, l'alerte vous donne une longueur d'avance avant que le trafic ne suive.
Ajouter des vérifications noindex à votre checklist de recette avant mise en ligne
Avant de déployer un site ou de passer la préproduction en production, recherchez les directives noindex. Une vérification de 30 secondes avec "Afficher le code source de la page" et une recherche de "noindex" détecte l'erreur de déploiement la plus courante. Sur les gros sites, explorez avant et après le déploiement et comparez le nombre de pages en noindex. Ajoutez-la à votre checklist SEO technique pour que personne ne l'oublie.
Explorations planifiées pour repérer les directives noindex indésirables
Lancez une exploration complète à intervalles réguliers, ainsi qu'après chaque mise à jour d'extension, changement de thème ou migration, pour repérer les balises noindex indésirables avant qu'elles ne vous coûtent du trafic. Le Crawler de SEOcrawl AI vous permet de comparer les explorations, pour voir quelles pages sont passées en noindex et quand, et SEO Monitor vous alerte dès qu'une de vos pages clés reçoit une balise noindex.
FAQ
Que signifie "Exclue par la balise 'noindex'" dans Google Search Console ?
Cela signifie que Google a trouvé et respecté une directive noindex sur votre page : la page n'apparaîtra donc pas dans les résultats de recherche. Ce statut figure dans le rapport d'indexation des pages de la Search Console, sous "Non indexée".
Ce n'est pas toujours une erreur : les pages que vous excluez volontairement, comme les pages de connexion ou de paiement, doivent afficher ce statut.
Comment corriger "Exclue par la balise 'noindex'" dans WordPress ?
Vérifiez deux endroits, dans cet ordre. D'abord, allez dans Réglages › Lecture et assurez-vous que "Demander aux moteurs de recherche de ne pas indexer ce site" est décoché. Ensuite, ouvrez chaque article ou page concerné dans votre extension SEO (Yoast, Rank Math, All in One SEO) et vérifiez que le réglage robots de la page autorise l'indexation.
Combien de temps faut-il à Google pour indexer une page après la suppression du noindex ?
En général de quelques jours à quelques semaines, selon la fréquence à laquelle Googlebot explore votre site. Demandez l'indexation avec l'outil d'inspection d'URL après avoir supprimé la directive, et soumettez un sitemap XML à jour pour accélérer le processus. Les sites à fort trafic sont réexplorés plus vite que les sites récents ou peu visités.
Une page peut-elle être exclue par noindex même si elle figure dans mon sitemap ?
Oui. La directive noindex l'emporte sur la présence dans le sitemap. Google peut continuer à explorer l'URL depuis votre sitemap, mais ne l'indexera pas tant que le noindex est présent.
Soit vous supprimez le noindex pour que la page puisse être indexée, soit vous retirez l'URL du sitemap si l'exclusion est volontaire. Lister des URL en noindex dans un sitemap envoie des signaux contradictoires.
Quelle est la différence entre noindex et le blocage d'une page dans le robots.txt ?
Le robots.txt empêche Googlebot d'explorer la page ; noindex autorise l'exploration mais empêche l'indexation. Si vous bloquez une page avec le robots.txt, Google ne peut pas lire la balise noindex, et une page déjà indexée peut rester dans l'index avec un contenu obsolète. Utilisez noindex pour retirer une page de l'index, et le robots.txt uniquement si vous voulez empêcher complètement l'exploration.
Comment vérifier si une page contient une balise noindex ?
Trois méthodes, de la plus rapide à la plus complète : utilisez l'outil d'inspection d'URL de la Search Console, affichez le code source de la page et recherchez "noindex" (Ctrl+F), ou vérifiez les en-têtes de réponse HTTP dans les DevTools de votre navigateur (onglet Réseau, cherchez X-Robots-Tag). Seuls l'outil d'inspection d'URL et les DevTools détectent un noindex envoyé dans l'en-tête.
Dois-je m'inquiéter si de nombreuses pages affichent "Exclue par la balise 'noindex'" ?
Seulement si ces pages devraient être indexées. Exportez la liste depuis la Search Console, comparez-la à vos exclusions volontaires (connexion, panier, administration, pages de remerciement) et ne corrigez que les pages qui doivent se positionner dans la recherche. Si toutes les pages concernées ont été exclues délibérément, le statut fonctionne correctement.
Auteur : David Kaufmann

Cela fait plus de 10 ans que je suis totalement obsédé par le SEO — et honnêtement, je ne voudrais pas qu'il en soit autrement.
Ma carrière a franchi un cap lorsque j'ai travaillé comme Senior SEO Specialist pour Chess.com — l'un des 100 sites les plus visités de tout Internet. Opérer à cette échelle, sur des millions de pages, des dizaines de langues et dans l'une des SERPs les plus concurrentielles qui soient, m'a appris des choses qu'aucun cours ni aucune certification ne pourrait jamais transmettre. Cette expérience a transformé ma vision de ce qu'est réellement un SEO d'excellence — et elle est devenue le socle de tout ce que j'ai construit depuis.
Forcé par cette expérience, j'ai fondé SEO Alive — une agence pour les marques qui prennent la croissance organique au sérieux. Nous ne sommes pas là pour vendre des dashboards et des rapports mensuels. Nous sommes là pour bâtir des stratégies qui font vraiment la différence, en combinant le meilleur du SEO classique avec le nouvel univers passionnant de la Generative Engine Optimization (GEO) — afin que votre marque apparaisse non seulement dans les liens bleus de Google, mais aussi dans les réponses générées par l'AI que ChatGPT, Perplexity et Google AI Overviews livrent chaque jour à des millions de personnes.
Et parce que je ne trouvais aucun outil capable de gérer correctement ces deux mondes, j'en ai construit un moi-même — SEOcrawl AI, une plateforme d'intelligence SEO pour les entreprises qui réunit rankings, audits techniques, monitoring des backlinks, santé du crawl et suivi de la visibilité de marque dans l'AI, le tout au même endroit. C'est la plateforme dont j'ai toujours rêvé.
Découvrez plus de contenu de cet auteur