Redirect error i Google Search Console: årsager og løsninger
Du har åbnet rapporten Sideindeksering i Search Console og fundet URL'er under "Redirect error" (omdirigeringsfejl). I modsætning til de fleste statusser der er denne et reelt problem.
Kort fortalt: Google forsøgte at følge et redirect på din URL og kunne ikke nå frem til en side, der virker. Indtil du løser det, forbliver URL'en uden for indekset, og det samme gør det indhold, du ville sende den videre til.
Den gode nyhed er, at redirect-fejl som regel er hurtige at diagnosticere, når du ved, hvad du skal kigge efter. Denne guide gennemgår, hvad statussen betyder, hvilke årsager Google nævner, hvordan du sporer hver af dem, og hvordan du løser og validerer dem.
Hvad en Redirect error betyder i Search Console
Redirect error er en af årsagerne i tabellen "Hvorfor sider ikke indekseres" i rapporten Sideindeksering i Google Search Console. Den vises, når Googlebot følger et redirect fra din URL, men aldrig lander på en destination, den kan crawle, så hverken den oprindelige URL eller målet bliver indekseret via den vej.
Den forveksles let med "Page with redirect" (side med omdirigering), så lad os være tydelige: den status er normal. Den betyder, at redirectet virkede: URL'en indekseres ikke, fordi den peger et andet sted hen, og Google vurderer målet for sig. En Redirect error betyder, at selve redirectet mislykkedes.
Du finder den under Indeksering › Sider. Klik på rækken "Redirect error" for at se de berørte URL'er, og brug Eksportér til at downloade hele listen.
Almindelige årsager til en Redirect error
Googles dokumentation for rapporten Sideindeksering nævner fire situationer bag denne status. To andre dukker ofte op i praksis.
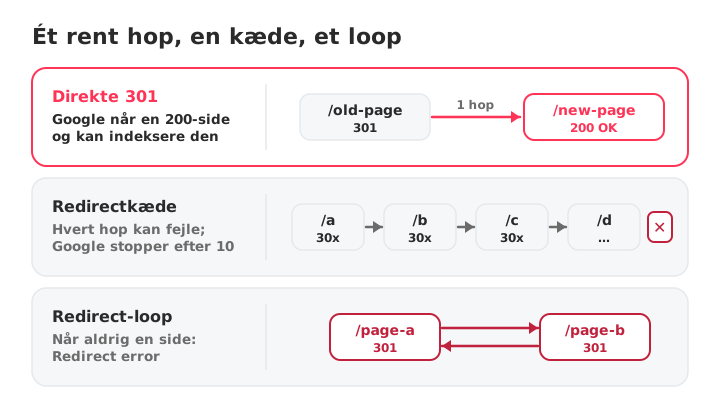
1. En redirectkæde, der er for lang
Hver URL, der redirecter til en anden, tilføjer et hop. Googles crawlere følger op til 10 redirect-hop, ifølge Googles crawldokumentation. Derefter giver Googlebot op, og Search Console rapporterer en redirect-fejl. Kæder vokser som regel over tid: først en regel fra HTTP til HTTPS, så en www-regel, så en regel for afsluttende skråstreg og oven i det en migrering af websitet.
2. Et redirect-loop
URL A redirecter til URL B, og URL B redirecter tilbage til URL A (eller til noget, der fører tilbage til A). Kæden ender aldrig, så der nås aldrig en side. Loops opstår ofte af to regler, der modsiger hinanden, for eksempel én, der tvinger en afsluttende skråstreg på, og en anden, der fjerner den.
3. En redirect-URL, der overskrider den maksimale længde
Hvis en redirectregel bliver ved med at tilføje noget til URL'en, for eksempel en parameter eller et stisegment ved hvert hop, vokser adressen, indtil den overskrider den maksimale URL-længde, og kæden fejler.
4. En forkert eller tom URL i kæden
En tastefejl som htp:// i stedet for http://, en relativ sti, der peger det forkerte sted hen, eller en tom Location-header bryder redirectet ved det hop.
5. En destination, Google ikke kan crawle
Hvis den endelige URL er blokeret af robots.txt, kan Googlebot ikke hente den. Tjek, at målet for hvert redirect kan crawles, ikke kun at det findes.
6. Modstridende redirectregler forskellige steder
Redirects, der er sat op i dit CMS, et plugin, webserveren og et CDN, kan stables oven på hinanden eller modarbejde hinanden. En regel i ét lag kan sende URL'en tilbage til en regel i et andet, og det er sådan, de fleste kæder og loops opstår.
Sådan diagnosticerer du en Redirect error
Start med de præcise URL'er, Search Console markerer, og spor derefter, hvad der sker, når hver af dem bliver anmodet om.
Brug URL Inspection
Indsæt en berørt URL i URL Inspection-feltet øverst i Search Console. Sektionen Sideindeksering viser, hvornår Google sidst crawlede den, og om hentningen af siden lykkedes. Klik på Test live URL for at tjekke den aktuelle adfærd, da rapporten kan halte efter dine rettelser.
Spor hele redirectforløbet
Anmod om URL'en, og følg hvert hop. Fra en terminal:
curl -sIL https://example.com/old-page | grep -iE "^(HTTP|location)"
Outputtet viser hver statuskode og hver Location-header i rækkefølge. Du leder efter mere end ét hop, en URL, der optræder to gange (et loop), en ugyldig Location eller et sidste svar, der ikke er 200.
Hvis du hellere vil undgå terminalen, tæller den gratis SEO-audit på siden for SEOcrawl AI's Crawler redirect-hoppene for enhver URL, og værktøjet fetch_url i SEOcrawl AI's MCP-server returnerer den endelige URL, statuskoden og hele redirectkæden direkte i Claude, ChatGPT eller Cursor.
Tjek den endelige svarkode
Bekræft, at den sidste URL i forløbet returnerer 200 og ikke endnu en 3xx, en 4xx eller en 5xx. Hvis kæden ender på en fejl, ligger problemet ved destinationen: se vores guides om Not found (404) og Blocked due to other 4xx issue.
Sådan løser du hver årsag
Løsningen bygger næsten altid på den samme idé: send den oprindelige URL til dens endelige destination i ét rent hop.
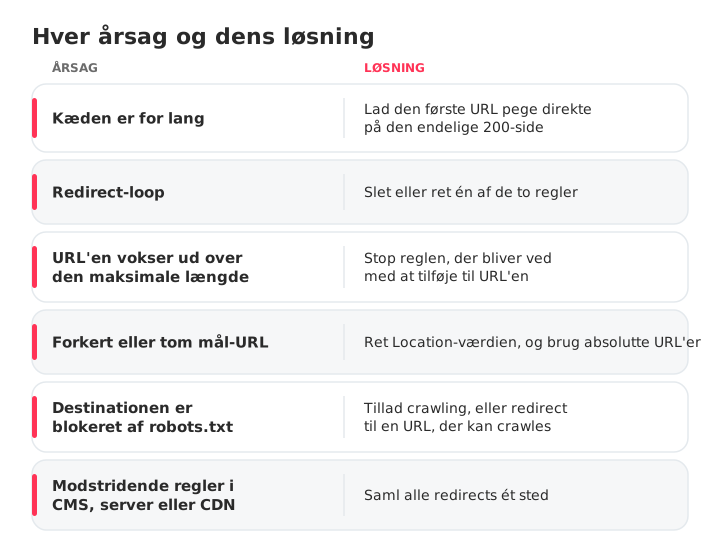
- Kæden er for lang: lad den første URL pege direkte på den endelige 200-URL, og fjern hoppene imellem. Hvis flere gamle URL'er fører ind i den samme kæde, så opdater dem alle.
- Redirect-loop: find de to regler, der peger på hinanden, og slet eller ret den ene, så forløbet ender på en rigtig side.
- URL'en er for lang: ret den regel, der bliver ved med at tilføje til URL'en, og bekræft derefter, at destinationen indlæses.
- Forkert eller tomt mål: ret tastefejlen eller den tomme
Location-værdi, og brug absolutte URL'er. - Destinationen er blokeret af robots.txt: tillad crawling af destinationen, eller redirect til en URL, der ikke er blokeret.
- Modstridende regler: saml dine redirects ét sted, så dit CMS, din server og dit CDN ikke overskriver hinanden.
Opdater derefter dine interne links, så de peger på den endelige URL i stedet for en URL, der redirecter, og medtag kun endelige URL'er i dit XML-sitemap. Crawleren markerer begge tilfælde på hele websitet: interne links, der returnerer en 3xx, og sitemaps, der indeholder en URL med redirect. Vil du tjekke et sitemap for sig, så kør det gennem den gratis sitemap checker, som validerer statuskoder og redirectkæder for hver URL, sitemappet indeholder.
Best practices for redirects
Et par gode vaner forhindrer de fleste redirect-fejl, før de opstår.
- Brug den rigtige statuskode. Et 301-redirect (eller 308) er et stærkt signal om, at målet skal indekseres: brug det til permanente flytninger. Et 302-redirect (eller 307) er et svagt signal, der holder den oprindelige URL i resultaterne: brug det kun, når flytningen er midlertidig.
- Foretræk server-side redirects. Google følger også øjeblikkelige meta refresh- og JavaScript-redirects, men anbefaler kun at bruge JavaScript, når server-side redirects eller meta refresh ikke er mulige.
- Hold kæderne korte. Ét hop er ideelt. Hvert ekstra hop gør det langsommere for brugerne, bruger crawl budget og tilføjer endnu et sted, hvor det kan gå galt.
- Redirect altid til en URL, der returnerer 200, aldrig til et andet redirect.
- Opdater interne links og sitemaps til de endelige URL'er, så Google og dine besøgende helt springer redirectet over.
- Tjek igen efter hver migrering eller ændring af regler i dit CMS, på din server eller i dit CDN, for det er netop dér, nye kæder og loops opstår.
Sådan validerer du rettelsen
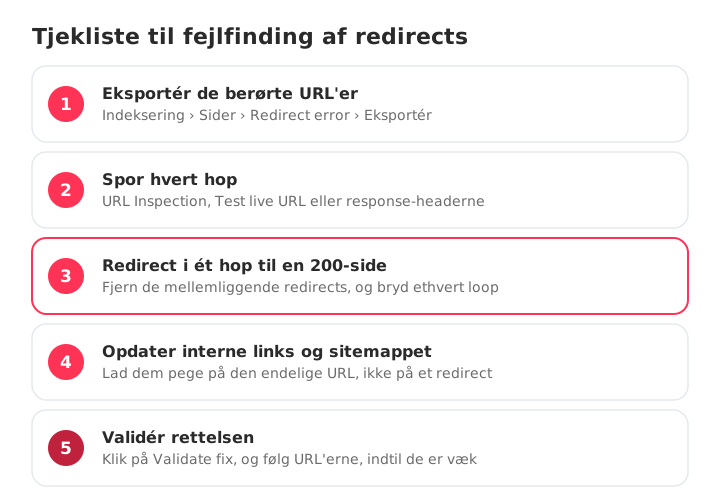
Når redirectet fører til en 200-side i ét hop:
- Kør URL Inspection på en berørt URL, og klik på Test live URL for at bekræfte, at Google nu når frem til destinationen.
- Klik på Request indexing for dine vigtigste URL'er.
- Åbn problemet Redirect error i rapporten Sideindeksering, og klik på Validate fix, så Google crawler alle berørte URL'er igen.
- Hold øje med valideringsstatussen. Det kan tage dage eller et par uger; URL'erne forsvinder fra problemet, efterhånden som de bliver crawlet igen.
Hold dig foran redirect-fejlene
Redirect-fejl melder sjældent sig selv. De dukker op i rapporten Sideindeksering, og på et stort website kan de ligge ubemærket hen, indtil trafikken falder. At tjekke Search Console manuelt for hver property er langsomt arbejde, som er let at springe over.
SEOcrawl AI's Indexation-visning grupperer dine URL'er efter dækningsstatus i Search Console, så du kan se, hvilke URL'er der havner i en fejlstatus, og følge, hvordan antallet ændrer sig over tid. Du kan tagge de berørte URL'er med regler, manuelt eller via MCP-serveren og arbejde dig igennem dem, indtil hver enkelt er løst. Arbejder du med en AI-assistent, tjekker Google Search Console-auditten din indeksdækning ud fra en enkelt prompt og opretter en opgave for hver rettelse.
Ofte stillede spørgsmål
Hvad forårsager en Redirect error i Google Search Console?
Google nævner fire årsager: en redirectkæde, der er for lang, et redirect-loop, en redirect-URL, der til sidst overskrider den maksimale URL-længde, og en forkert eller tom URL i kæden. I alle tilfælde kan Googlebot ikke nå frem til en endelig side, der virker.
Hvordan løser jeg en Redirect error?
Send den oprindelige URL til dens endelige destination i ét enkelt hop. Fjern mellemliggende redirects, bryd ethvert loop, og sørg for, at den sidste URL returnerer statuskode 200. Opdater interne links, så de peger på destinationen, og kør derefter URL Inspection og klik på Validate fix i rapporten Sideindeksering.
Hvad er en redirectkæde, og hvad er et redirect-loop?
En redirectkæde er en række redirects, hvor URL A går til B, B går til C og så videre, før den endelige side nås. Et redirect-loop er en kæde, der aldrig slutter, fordi URL'erne peger tilbage på hinanden. Begge dele kan forhindre Google i at nå en side, der kan indekseres.
301 eller 302: hvilken skal jeg bruge?
Brug en 301 (eller 308) til en permanent flytning: Google opfatter det som et stærkt signal om at indeksere målet. Brug kun en 302 (eller 307) til en midlertidig flytning, når den oprindelige URL skal blive i søgeresultaterne.
Er "Page with redirect" det samme som en Redirect error?
Nej. "Page with redirect" betyder, at redirectet virkede: URL'en indekseres ikke, fordi den peger på en anden side. En Redirect error betyder, at Google forsøgte at følge redirectet og aldrig nåede frem til en side, der virker.
Hvor lang tid tager det, før en Redirect error forsvinder?
Når du har klikket på Validate fix, crawler Google de berørte URL'er igen i løbet af de følgende dage, nogle gange op til to uger. Statussen opdateres, efterhånden som hver URL behandles, så du behøver ikke anmode om indeksering for hver URL manuelt.
Forfatter: David Kaufmann
Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter
CTR viser, hvor mange af dem, der så dit resultat, der faktisk klikkede. Her får du formlen, hvad en god CTR er i 2026 pr. kanal og pr. placering i Google, og hvordan du får flere klik ud af de rangeringer, du allerede har.
Ser du "Alternate page with proper canonical tag" i Search Console? Som regel gør Google præcis det, du har bedt om. Her kan du se, hvordan du skelner de normale tilfælde fra de reelle problemer, og hvordan du løser dem, der betyder noget.