Blokeret på grund af andet 4xx-problem: sådan retter du det
Du åbner Search Console, og der står det: Ikke indekseret: "Blokeret på grund af andet 4xx-problem." Ingen statuskode, ingen ramt fil, ingen tydelig årsag.
Denne guide forklarer præcis, hvilke fejl der udløser beskeden, hvordan du finder den rigtige statuskode bag, og hvordan du retter hver årsag — inklusive de diagnosetrin, de fleste gennemgange springer over. Vil du se, hvor rapporten hører hjemme i værktøjet som helhed, så læs vores komplette guide til Google Search Console.
Hvad "blokeret på grund af andet 4xx-problem" faktisk betyder
"Blokeret på grund af andet 4xx-problem" betyder, at Googlebot hentede en URL og fik et 4xx-svar (klientsiden), som Search Console ikke allerede har sin egen kategori for.
Fordi Google ikke kunne hente siden, indekserer den den ikke. I de tilfælde bliver URL'en holdt ude af søgeresultaterne, indtil den svarer med en succes-status.
Ordet "andet" er det, der bærer beskeden. Search Console har allerede egne betegnelser for de tre mest almindelige 4xx-koder:
- 401 → "Blokeret på grund af uautoriseret anmodning (401)."
- 403 → "Blokeret på grund af forbudt adgang (403)."
- 404 → "Ikke fundet (404)."
Så "andet 4xx" bliver paraplyen for alt det andet i 4xx-området: 400, 405, 408, 410, 429 og lignende koder. Beskeden er vag, fordi Google godt ved, at der skete en 4xx, men det er ikke en, de har sat navn på.
Hvilke 4xx-statuskoder udløser fejlen
Det er de koder, der oftest havner under betegnelsen. Du skal finde ud af, hvilken en din server faktisk svarer med, før du kan rette noget.
| Kode | Navn | Typisk årsag |
|---|---|---|
| 400 | Bad Request | Misdannet URL, ugyldige tegn, ødelagt forespørgsel |
| 405 | Method Not Allowed | Serveren afviser metoden (f.eks. GET slået fra på den sti) |
| 406 | Not Acceptable | Uoverensstemmelse i content negotiation |
| 408 | Request Timeout | Serveren er for langsom til at svare inden for sit vindue |
| 410 | Gone | Siden er fjernet permanent (se note nedenfor) |
| 411 / 412 / 421 / 422 | Diverse | Problemer med længde / precondition / misdirected / unprocessable |
| 429 | Too Many Requests | Rate limiting (en meget almindelig årsag på større eller hårdt beskyttede sites) |
| 451 | Unavailable for Legal Reasons | Geo- eller juridisk blokering |
| 418 | I'm a teapot | En spøgefuld status defineret i en RFC (sjælden, men en rigtig kode, som nogle opsætninger af og til svarer med) |
En note om 410 (Gone): er en side bevidst fjernet for altid, er en 410 det rigtige svar, og du skal ikke "rette" den. Sørg bare for, at det ikke er en side, du rent faktisk vil have indekseret.
Hvad der giver 4xx-fejl for Googlebot
De fleste tilfælde kan spores tilbage til en af disse fem årsager:

- Sikkerhedsregler og WAF'er. Firewalls som Cloudflare, Sucuri eller AWS WAF opfatter nogle gange Googlebot som en trussel og svarer 403 eller blokerer forespørgslen. Sikkerhedsplugins på WordPress kan gøre det samme.
- Rate limiting (429). Serveren svarer 429, når den vurderer, at der er kommet for mange forespørgsler for hurtigt, og Google indekserer ikke en side, den bliver ved med at blive rate-limitet på.
- Server- eller CDN-opsætning. En CDN-regel, et .htaccess-direktiv eller en ændring i en template kan begynde at svare 4xx på URL'er, der ser fine ud i din browser.
- Misdannede URL'er (400). En 400 betyder, at serveren ikke kunne forstå forespørgslen — ofte en forkert URL-struktur eller dårlige parametre. Det er almindeligt med faceteret navigation og session- eller trackingparametre.
- Filrettigheder. Mapperettigheder sat for stramt (f.eks. 700 i stedet for 755) kan udløse en 403.
Et nyttigt tegn: fordi det er svar på klientsiden, der hænger sammen med hvordan forespørgslen bliver lavet, ser du ofte ikke den samme fejl i din egen browser — og det er netop derfor, rapporten føles så uigennemsigtig.
Sådan finder du den præcise 4xx-statuskode, Google ramte
Search Console fortæller dig, at en side er ramt, men ikke hvilken 4xx-kode den svarede med. Det må du selv finde ud af. Gå frem sådan her:
- Få listen over ramte URL'er. Gå i Search Console til Indeksering → Sider, rul ned til "Hvorfor sider ikke er indekseret", og klik "Blokeret på grund af andet 4xx-problem" for at se hele listen. De ligger under sektionen Sider → fanen Ikke indekseret.
- Inspicér en URL. Klik på en URL og derefter på Test live-URL i URL-inspektionsværktøjet. Det viser præcis, hvad Googlebot så, inklusive HTTP-svaret og eventuelle redirects.
- Hent den som Googlebot. Fordi fejlen ofte hænger på en bestemt user agent, skal du genskabe den med Googlebots user agent. I Chrome DevTools åbner du fanen Network conditions, fjerner fluebenet ved "Use browser default" og vælger "Googlebot Smartphone", genindlæser og læser statuskoden. Du kan også køre
curl -A "Googlebot" -I https://yoururlfra en terminal. - Tjek serverloggene. Loggene viser den rigtige statuskode, din server svarede Googles IP'er med, og det er sandheden, når DevTools og browseren er uenige.
- Bekræft, at det virkelig er Googlebot. Blokerer en WAF, så bekræft, at den IP, der beder om siden, faktisk tilhører Google, før du åbner adgangen, så du ikke lukker op for bots, der udgiver sig for at være andre.

Sådan retter du hver 4xx-fejl, kode for kode
Når du kender koden, følger rettelsen af sig selv:
| 4xx-kode | Sandsynlig årsag | Sådan retter du den |
|---|---|---|
| 403 | WAF eller firewall blokerer Googlebot | Sæt verificeret Googlebot på allowlisten, eller justér den regel, der fanger den. Ret filrettighederne, hvis det er årsagen. |
| 429 | Rate limiting | Hæv eller justér grænsen for verificerede søgebots, og tjek, om et plugin eller et CDN struber crawls. |
| 400 | Misdannet URL | Ret URL-strukturen, stop med at generere ugyldige parameterkombinationer, og canonicalisér URL'er med parametre. |
| 405 / 406 / 408 | Serverregel, content negotiation eller timeout | Ret serverreglen, content negotiation eller timeout-adfærden for de ramte stier. |
| 410 (burde ikke være væk) | Siden er fjernet ved en fejl | Læg siden op igen, eller 301-redirect den til det nærmeste tilsvarende, hvis den har værdi og backlinks. |
| 404 / 410 (bevidst) | URL'en er reelt død | Lad den være. Det er ikke fejl, der skal rettes. Spær for spildt crawl med robots.txt, hvis mængden er stor. |
Sådan validerer du 4xx-rettelsen i Search Console
Når du har rettet årsagen, går du tilbage til rapporten "Blokeret på grund af andet 4xx-problem" og klikker Valider rettelse.
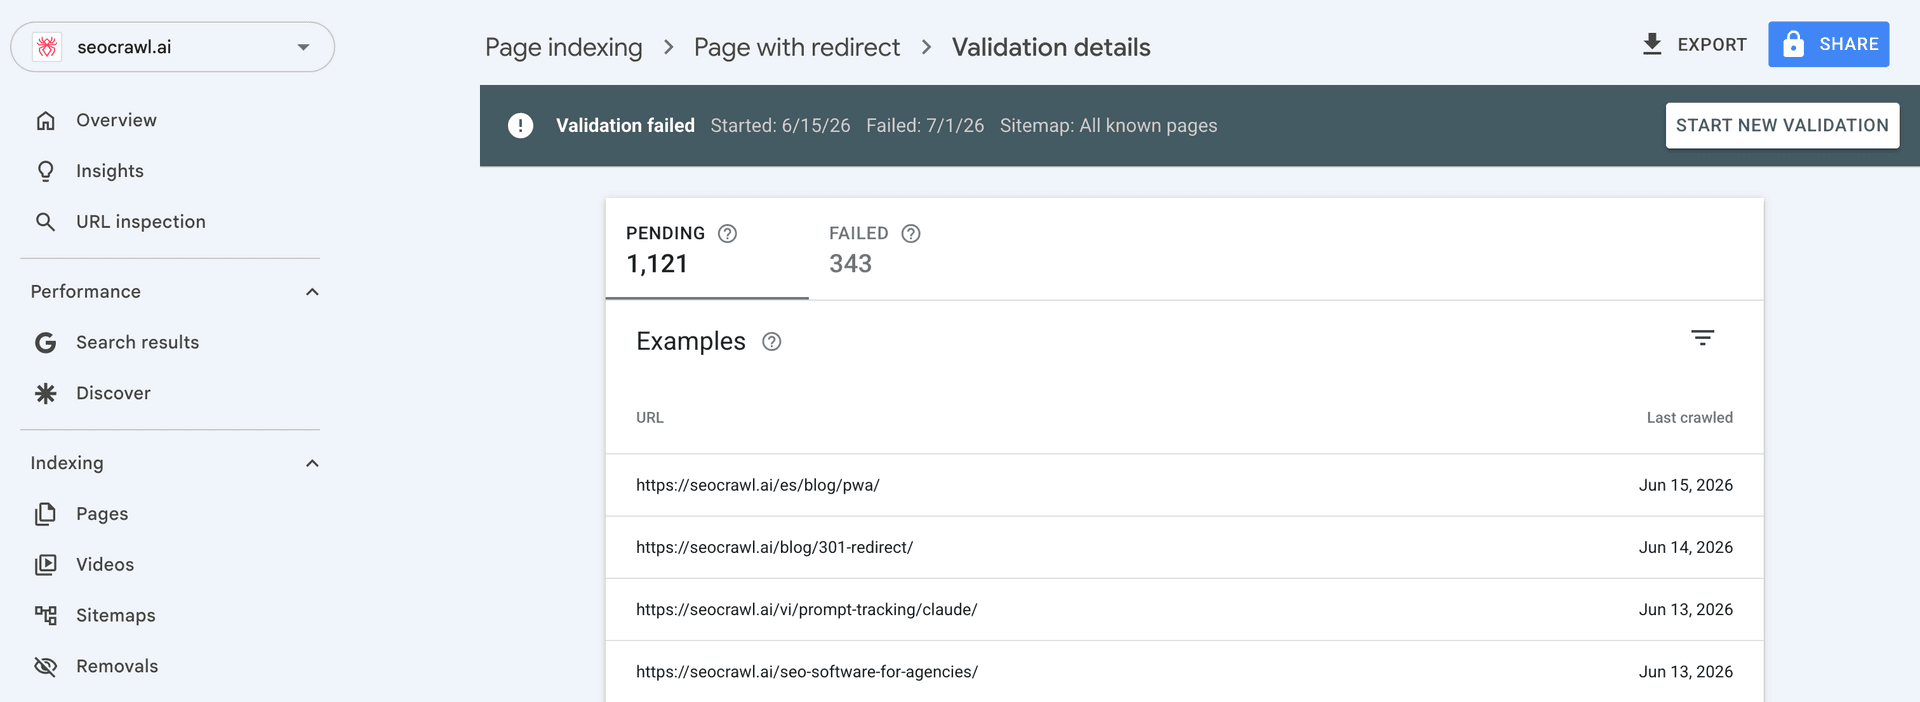
Google crawler de ramte URL'er igen, og et gencrawl af rettede URL'er tager typisk fra nogle dage til nogle uger, afhængigt af crawl budget.
Rapporten bliver opdateret, efterhånden som Google prøver hver URL igen, så nye rettelser dukker ikke op med det samme. Hav URL-inspektionsværktøjet ved hånden, så du kan bekræfte, at hver side nu svarer 200, før du læner dig op ad valideringen.
Sådan finder du 4xx-ramte URL'er i stor skala med SEOcrawl AI
Search Console viser problemet, men tvinger dig til at inspicere URL'er én ad gangen. SEOcrawl AI henter dine dækningsdata fra Search Console og viser indekseringstilstande på tværs af hele sitet, så du kan finde de ramte URL'er i bulk i stedet for at klikke dig igennem dem enkeltvis.
Vores MCP-server lader dig læse hele fordelingen af indeksdækning pr. tilstand og filtrere crawlede sider på statuskode (for eksempel alt, der svarer 404) direkte fra Claude eller ChatGPT og tagge dem med regler, manuelt eller over MCP. Kombinér det med planlagte crawls og alarmer, så du fanger et spring i 4xx-URL'er, før det går ud over dine placeringer.

Find alle 4xx-ramte URL'er ét sted. I stedet for at klikke dig gennem Search Console URL for URL viser SEOcrawl AI dig hele fordelingen af din indeksdækning og lader dig filtrere crawlede sider på statuskode direkte fra Claude eller ChatGPT. Prøv SEOcrawl AI.
FAQ
Hvad betyder en 4xx-fejl?
En 4xx-fejl er en HTTP-status på klientsiden, altså at selve forespørgslen ikke kunne indfries: siden findes ikke, adgangen bliver nægtet, forespørgslen er misdannet, eller serveren rate-limiter den.
4xx-familien tæller blandt andet 400 (bad request), 403 (forbidden), 404 (not found), 410 (gone) og 429 (too many requests). For SEO er enhver 4xx på en side, du vil have indekseret, et problem, for Google kan ikke hente indholdet og rangere det.
Er 4xx-fejl dårlige for SEO?
Det er de, når de rammer sider, du vil have i indekset. En side, der svarer med 4xx, kan ikke crawles, så den bliver hverken indekseret eller rangeret, og du mister den trafik, den ville have givet.
I stor skala æder udbredte 4xx-fejl også crawl budget og kan signalere dårlig vedligeholdelse af sitet. Bevidste 404'ere og 410'ere på URL'er, der reelt er døde, er normalt. Problemet er 4xx-svar på sider, der burde være i luften.
Hvad er en 4xx-fejl i SEO?
SEO-mæssigt er en 4xx-fejl ethvert svar på klientsiden, der spærrer søgemaskinerne fra at tilgå en URL. De vigtigste er 404'ere (ødelagte eller fjernede sider), 403'ere (adgang blokeret, ofte af en firewall) og koderne bag "blokeret på grund af andet 4xx-problem" som 400, 429 og 410.
Hvordan finder jeg ud af, hvilken 4xx Google ramte?
Search Console nævner ikke koden, så du må selv undersøge det. Åbn den ramte URL i URL-inspektionsværktøjet, og kør Test live-URL for at se svaret, eller hent siden med Googlebots user agent (i panelet Network conditions i Chrome DevTools eller med curl -A "Googlebot" -I [url]).
Serverloggene giver den endegyldige statuskode, din server sendte til Google. Skal du gøre det på mange URL'er på én gang, lader SEOcrawl AI dig filtrere crawlede sider på statuskode i bulk.
Forfatter: David Kaufmann

Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter