robots.txt: komplet guide til opsætning
Træt af at høre om robots.txt uden at vide, hvad folk taler om? Bare rolig, i dag har vi løsningen på dit problem. I dette indlæg gør vi vores bedste for at forklare, hvad robots.txt er, hvordan du sætter den op (især i WordPress), og hvilken betydning den kan have for vores projekts SEO.
Så går vi i gang!
Hvad er robots.txt, og hvad bruges den til?
robots.txt er ganske enkelt en fil, der ligger i roden af dit website, og som lader dig forhindre bestemte bots (som Googles eller Bings) i at besøge dit website eller dele af det.
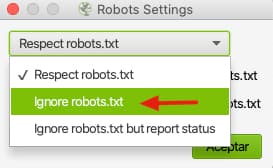
OBS: det er vigtigt at vide, at det er en protokol, og som hovedregel overholder alle »gode« bots den (GoogleBot, BingBot, Semrush, …), men enhver bot med dårlige hensigter kan springe den over, for eksempel Screaming Frog ved at sætte flueben her:
Hvorfor er robots.txt vigtig for SEO?
Som nævnt overholder alle gode bots (som GoogleBot) denne protokol, så det, vi kan gøre, er at bruge filen til at guide Google rundt på vores website. Sider, du disallower her, dukker op som »Blokeret af robots.txt« i Google Search Console.
Hvad? Hvad mener du? Guide Google med robots.txt?
Ja, bare rolig, vi forklarer det med et eksempel, så bliver det meget tydeligere:
Forestil dig, at du på dit website har et lukket område, som kun registrerede brugere har adgang til, og som vi jo ved, kan Google ikke tilgå et site, der kræver login (endnu …).
Ville det så ikke give mening, at Google ikke spilder vores crawlbudget på at crawle sider, der ikke har nogen værdi for den?
Præcis! En af de vigtigste anvendelser af robots.txt er at blokere stier, der har lav værdi for Google, og på den måde få den til at fokusere på de vigtige sider på vores website. Derfor bør robots.txt være en af grundpillerne i vores SEO-strategi.
Det er bare ét eksempel ud af de tusindvis af ting, vi kan gøre med denne fil. Andre eksempler er at angive vores sitemap, sænke crawlintervallet, blokere crawling af ressourcer …
Sådan laver du filen robots.txt
Nå … lad os komme i gang!
Det er virkelig enkelt at lave filen, du skal bare finde din teksteditor (Notepad på Windows eller TextEdit på Mac) eller bruge en online og efter at have skrevet din robots.txt eksportere den som en txt-fil.
Når vi har den, skal vi bare kalde den »robots.txt« og lægge den op i roden af dit website via dit serverpanel eller med FTP.
For at tjekke, om den er lagt rigtigt op, skal du bare sætte »/robots.txt« efter dit domæne, for eksempel https://seocrawl.ai/robots.txt
OBS: Pas på cachen, det er bedre at se den i inkognito ;)
Hvad hvis jeg har WordPress?
Har du WordPress, er det enklere, for de bedste SEO-plugins som Rank Math eller Yoast har en indbygget tilføjelse til at redigere robots.txt direkte.
I Rank Math finder du den under Rank Math > General Settings > Edit robots.txt
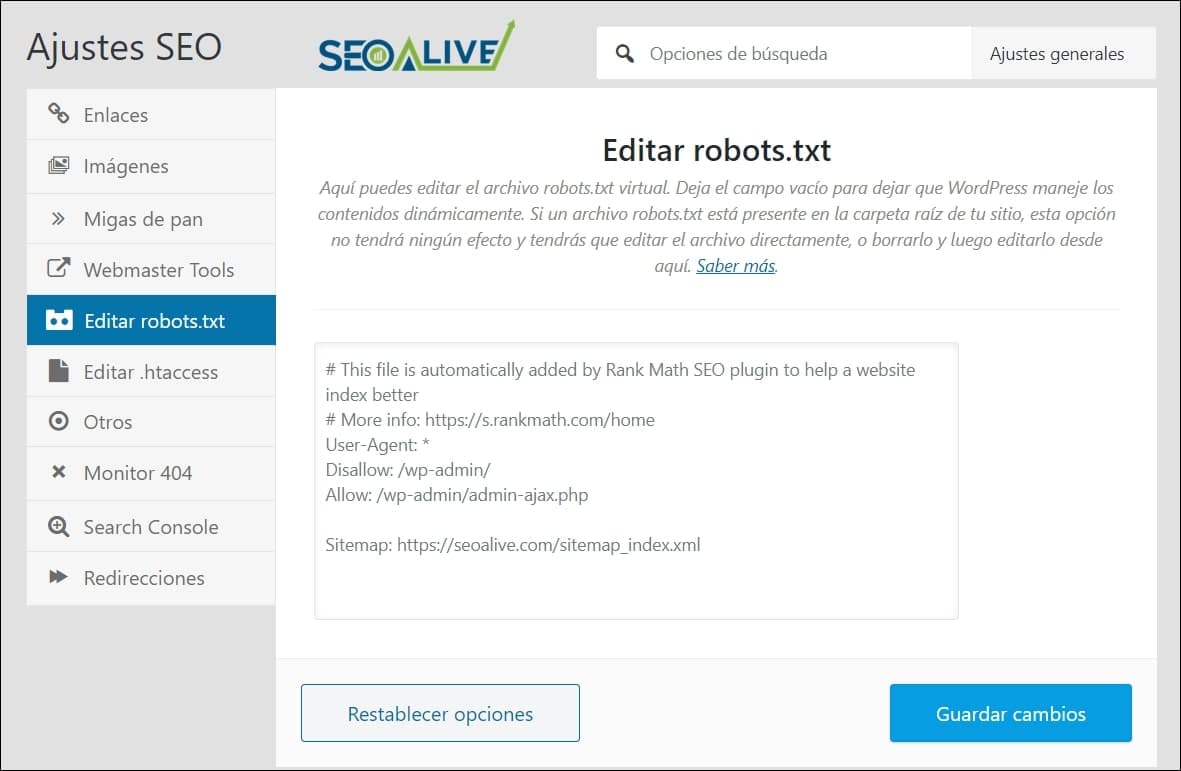
I Yoast skal vi gå til SEO > Tools > File Editor
På den måde kan du let redigere eller oprette filen uden at skulle gennem nogen af trinene ovenfor.
Kommandoer
Herunder ser vi på mange af de kommandoer, vi har til rådighed, sammen med eksempler:
Blokér crawling af hele dit website
User-agent: * Disallow: /
BEMÆRK: Er du i gang med at udvikle dit website, og vil du ikke have, at nogen bot går ind, læser og indekserer dit indhold, virker denne regel rigtig godt.
Blokér crawling af en side
User-agent: * Disallow: /url-paa-siden-jeg-ikke-vil-have-crawlet
Blokér crawling af en mappe
User-agent: * Disallow: /mappe/
Tillad adgang til en side
User-agent: * Allow: /side
Blokér en mappe, men tillad en side i den mappe
User-agent: * Disallow: /mappe/ Allow: /mappe/side
Angiv sitemappet
Sitemap: https://domain.com/sitemap.xml
Giv ordrer til bestemte bots
Her dvæler vi lidt længere. Har du lagt mærke til det, startede de fleste af de tidligere direktiver med:
User-agent: *
Den »*« henviser til alle bots. Altså gælder alle direktiver efter den linje for alle bots. Vil vi give bestemte ordrer til bestemte bots, skal vi ændre det sådan her:
User-agent: Googlebot Hvis vi vil henvise til Googles bot
User-agent: Bingbot Hvis vi vil henvise til Bings bot
User-agent: DuckDuckBot Hvis vi vil henvise til DuckDuckGos bot
Du skal bare finde ud af, hvad den bot, du vil give en ordre, hedder, og skrive dens navn, som vi lige har vist dig.
Gennemgå og test filen robots.txt
Nu hvor du er færdig med at »tune« din robots, så den er fuldt optimeret og tilpasset dit website, mangler du bare at teste den.
Teste den? Hvorfor det?
Jo, teste den for at sikre, at vi ikke har kludret i en linje, og at den faktisk blokerer de dele af sitet, vi vil blokere.
Til det anbefaler vi dette værktøj.
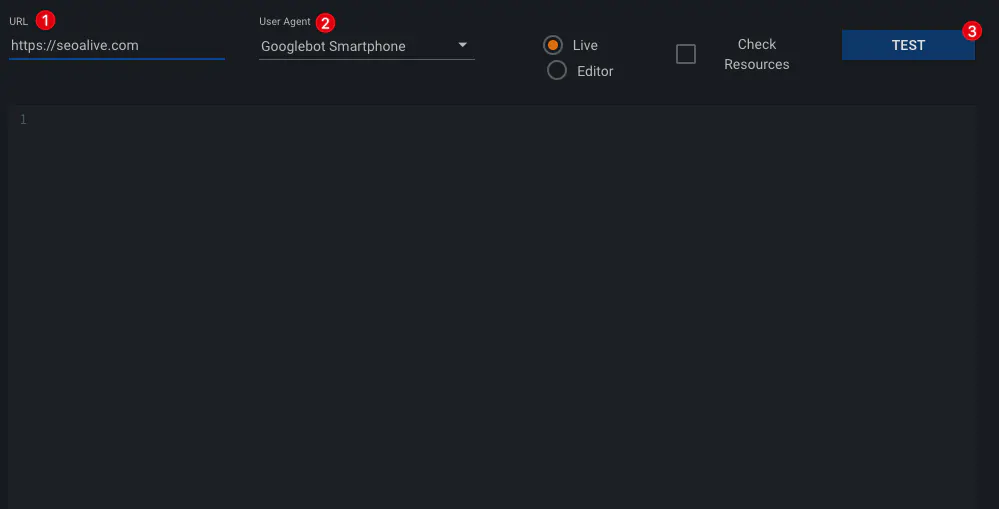
Når du er inde, skal du bare:
-
Skrive den URL, du vil tjekke, om crawling er tilladt på
-
Vælge User Agent
-
Klikke TEST
Lige efter loader hele vores robots.txt-fil, og nedenunder får vi at vide, om adgang er tilladt eller ej.
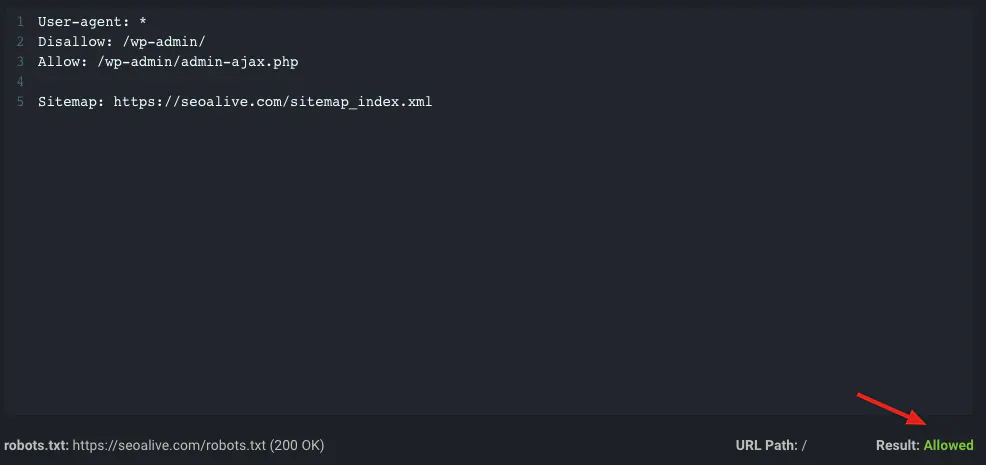
Her giver den os, som vi kan se, et positivt resultat, men hvis vi skrev en URL, der ikke er tilladt, ville den også fremhæve den linje, der blokerer den:
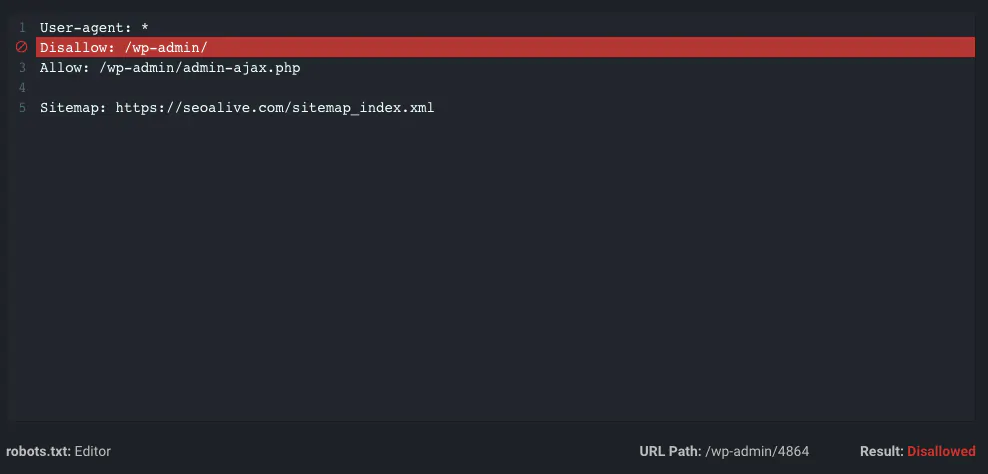
Desuden lader værktøjet os redigere vores robots.txt-fil direkte derfra, så vi kan lave de ændringer, der skal til, for at resultatet passer til vores mål. Når den er ændret og testet, skal vi bare lægge de nye ændringer ind i vores robots.
Bonustip: gør din robots.txt uforglemmelig
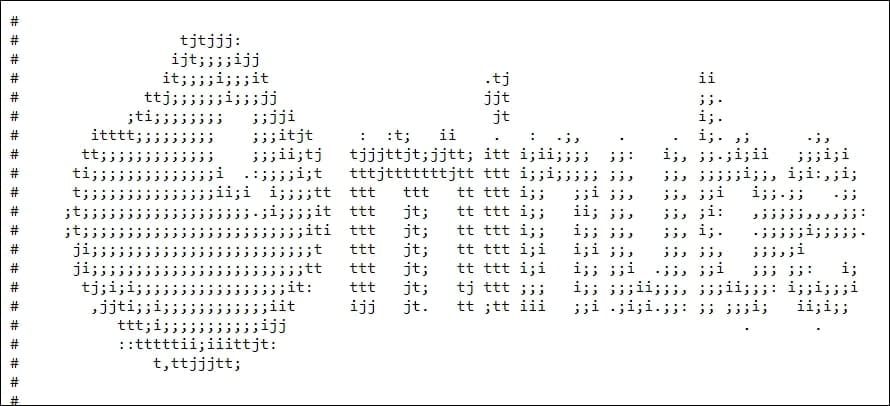
Vi har vist dig et væld af kodelinjer, der virker for bots, men du kan også indsætte kommentarer ved at starte linjen med et »#«. Alt, der starter med »#«, bliver altså ignoreret af bots. Det åbner en verden af muligheder og interne jokes. Derfor opfordrer vi dig til at kigge på robots.txt hos windupschool, pccomponentes eller Minube, du støder helt sikkert på en overraskelse ?
Konklusion
Som du har set, har filen robots.txt meget at byde på og kræver også en del omhu, for et forkert placeret direktiv kan blokere crawlingen af dit website.
Vi håber, guiden er nyttig for dig, og ved spørgsmål ses vi i kommentarerne.
Forfatter: David Kaufmann

Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter