


«Discovered – currently not indexed»: què significa i com solucionar-ho
Google sap que la teva URL existeix i encara no l'ha visitat. Així saps si cal esperar o actuar i quines solucions provar primer en un web petit i en un de gran.
Discovered – currently not indexed vol dir que Google ha trobat la URL però encara no l'ha rastrejat. Així ho descriu l'ajuda de l'informe d'indexació de pàgines de Google. Normalment Google havia previst rastrejar-la i ho ha ajornat per no sobrecarregar el teu web, i per això la data de l'últim rastreig apareix buida a l'informe.
És un estat de prioritat de rastreig, no un veredicte sobre el teu contingut, perquè Google encara no ha llegit la pàgina. A sota veuràs en què es diferencia de «Crawled», què vam trobar en revisar el nostre propi web i una llista de solucions ordenada per mida del web. Comences amb l'informe? Parteix d'aquesta guia de Google Search Console.
Què significa «Discovered – currently not indexed»
Google porta una URL per quatre passos: la troba, la rastreja, la indexa i després pot mostrar-la als resultats. Dos estats de Search Console descriuen una URL que s'ha encallat pel camí.
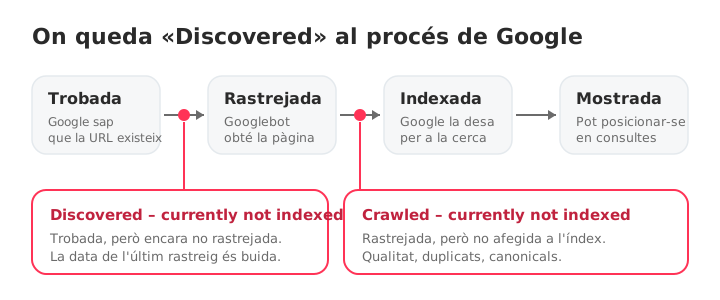
Una URL arriba a «trobada» pel sitemap o per enllaços d'altres pàgines. Després Google decideix quan rastrejar-la. «Discovered» vol dir que aquesta decisió encara no s'ha pres.
En què es diferencia de «Crawled – currently not indexed»
Els dos estats s'assemblen i demanen solucions diferents.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| L'ha rastrejat Google? | No | Sí |
| Data de l'últim rastreig | Buida | Una data |
| Ha llegit Google la pàgina? | No | Sí |
| Motiu habitual | Rastreig ajornat o prioritat baixa | Google va llegir la pàgina i la va descartar |
| Què mirar primer | Enllaços interns, sitemap, capacitat de rastreig | Qualitat del contingut, duplicats, canonicals |
El diagnòstic complet del segon estat és a la guia de Crawled – currently not indexed.
Com és la llista en un web real
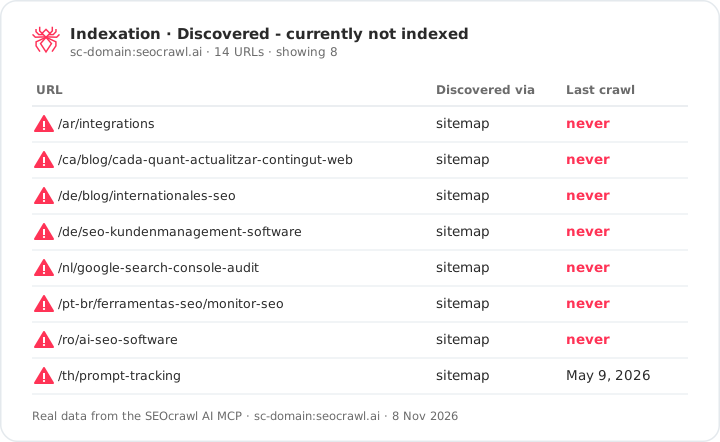
Hem revisat seocrawl.ai a l'informe d'Indexació de SEOcrawl. De les 1.000 URL que SEOcrawl monitoritza (el nostre sitemap en declara 6.310), 823 estan indexades, un 82,3%. 128 són a «Crawled – currently not indexed» i 14 a «Discovered – currently not indexed».
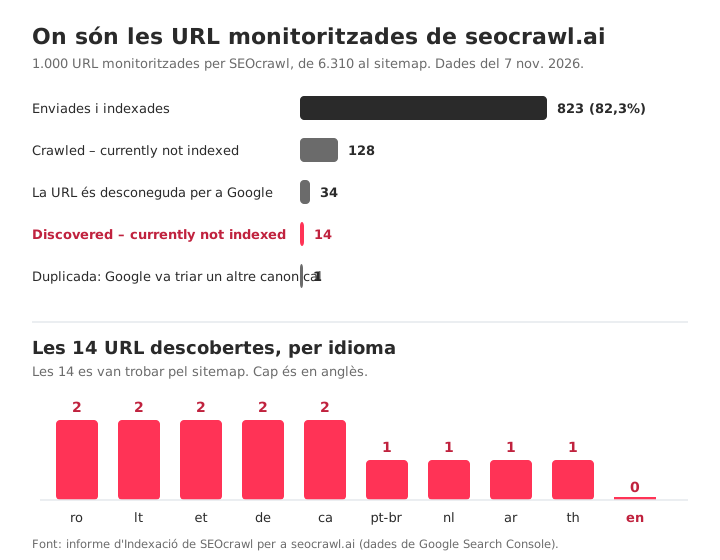
El que tenen en comú les 14 és la part útil:
- Totes són pàgines traduïdes: àrab, català, alemany, estonià, lituà, neerlandès, portuguès del Brasil, romanès i tailandès. Cap és en anglès.
- Google va trobar les 14 pel sitemap, no per un enllaç d'una altra pàgina.
- Una mostra una data de rastreig anterior (9 de maig de 2026), de manera que l'estat descriu on és la URL ara, no que Google no l'hagi visitat mai.
És un patró per comprovar, no un diagnòstic. Una pàgina que existeix en 26 idiomes i a la qual s'arriba sobretot pel sitemap és una candidata natural a tenir enllaços interns febles, així que els enllaços interns són el primer que cal mirar. La lliçó val per a qualsevol web: no llegeixis la llista URL per URL. Agrupades per idioma, 14 URL van passar a ser una sola pregunta.
Les xifres cobreixen les 1.000 URL que SEOcrawl monitoritza, una mostra de tot el sitemap. El grup més gran, de 128 URL, és l'altre estat i té la seva pròpia guia.
Per què Google ajorna un rastreig
La guia del pressupost de rastreig de Google explica com decideix quant rastrejar: un límit de capacitat que el teu servidor pot suportar i la demanda de les teves URL. La majoria de les URL descobertes es remunten a una d'aquestes cinc causes.
- Capacitat de rastreig. Google diu que el límit baixa quan el teu web es torna lent o retorna errors de servidor. Un servidor lent vol dir menys rastrejos.
- Demanda de rastreig baixa. La demanda depèn de la mida del web, de la freqüència d'actualització i de la qualitat i rellevància de les pàgines. Una URL amb pocs enllaços interns, o cap, dona a Google poques raons per tornar aviat.
- Rastreig malgastat. URL duplicades, paràmetres, facetes, cadenes llargues de redireccions i soft 404 competeixen amb les teves pàgines reals. Google assenyala que els soft 404 se segueixen rastrejant i malgasten pressupost, i que una pàgina amb noindex continua sent sol·licitada abans de descartar-la.
- Trobada només pel sitemap. Un sitemap avisa Google que una URL existeix. No la converteix en prioritat, i Google tracta el sitemap com una pista. Les pàgines trobades només allà són les primeres a esperar.
- Un web o secció nous. Tots els webs comencen amb el mateix límit de capacitat per defecte, prudent, que creix a mesura que el web demostra estar sa.
El pressupost de rastreig en si només mereix la teva atenció en webs molt grans. L'estimació aproximada de Google: 1.000.000+ de pàgines úniques actualitzades més o menys cada setmana, o 10.000+ pàgines que canvien cada dia. En webs més petits, les causes 2 i 4 són molt més habituals.
És un problema? Tres preguntes abans d'arreglar res
- Aquesta URL hauria d'estar indexada? Si és una vista filtrada, una pàgina de cerca interna o una URL de prova, és normal que hi falti. Per deixar-ho explícit, aplica noindex o retorna 404 o 410 (vegeu Excluded by 'noindex' tag).
- Quantes URL i amb quin patró? Google diu que amb menys de 500 pàgines probablement ni necessites aquest informe. La llista també està limitada a 1.000 files, així que en un web gran és una mostra.
- Són noves? Una URL publicada la setmana passada encara no és un problema. Els marges de temps del propi Google són a la taula de sota.
Com solucionar-ho segons la mida del web
El primer pas correcte depèn de la mida del teu web, així que comença per la columna adequada.
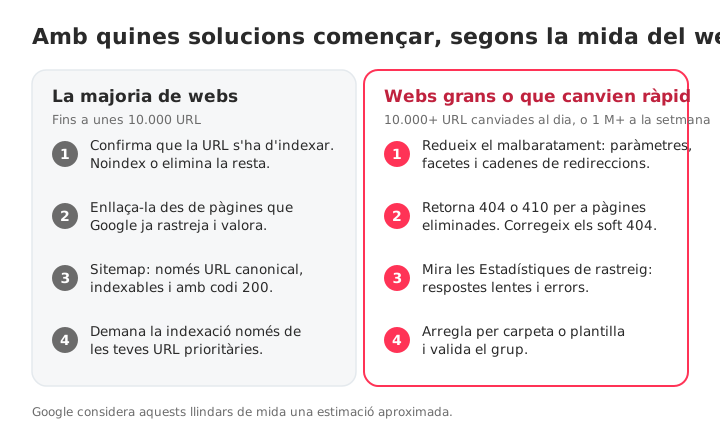
La majoria de webs: fins a unes 10.000 URL
- Confirma que la URL mereix indexació. Si no, aplica noindex o elimina-la i treu-la de la teva llista.
- Enllaça des de pàgines que Google ja rastreja. Afegeix enllaços contextuals, amb text d'ancoratge descriptiu, des de pàgines indexades que reben trànsit. Qualsevol rastrejador et mostra les teves pàgines òrfenes filtrant les que tenen zero enllaços interns, i aquesta guia d'enllaços interns té el mètode complet.
- Mantén el sitemap net. Inclou només URL que retornin 200, siguin indexables i siguin la versió canonical, amb un
lastmodcorrecte. Google ignora priority i changefreq. Si primer necessites el fitxer, troba el teu sitemap. Si Search Console diu que no en troba cap, vegeu No referring sitemaps detected. - Demana la indexació d'unes poques URL prioritàries. Obre l'eina d'inspecció d'URL i fes clic a Sol·licita la indexació. Google aplica una quota i diu que les sol·licituds repetides no acceleren res, així que reserva-ho per a les pàgines que més importen.
Webs grans o que canvien ràpid: 10.000+ URL canviades al dia o 1 milió+ a la setmana
- Redueix el rastreig malgastat. Bloqueja a robots.txt els espais d'URL sense valor de cerca (paràmetres, facetes, cerca interna) i consolida els duplicats amb canonicals i redireccions 301. No comptis amb noindex per estalviar pressupost: Google segueix sol·licitant aquestes pàgines.
- Retorna 404 o 410 per a pàgines eliminades i corregeix els soft 404. Google qualifica el 404 de senyal fort per no tornar a rastrejar la URL, mentre que les URL bloquejades romanen més temps a la cua. Escurça qualsevol cadena llarga de redireccions.
- Revisa les estadístiques de rastreig. A Configuració, l'informe d'Estadístiques de rastreig mostra els temps de resposta i els errors de servidor. Si són alts, Google redueix el teu límit de capacitat, i cap arranjament de contingut ajuda fins que el servidor millori.
- Arregla per carpeta o plantilla i després valida el grup. Pren una decisió per patró, crea un sitemap només amb les URL corregides i fes clic a Valida la correcció. Llegeix més sobre el pressupost de rastreig si el teu web entra en aquesta categoria.
Esperar o actuar?
El més difícil no és la correcció, sinó saber quan deixar d'esperar. Fes servir els marges del propi Google i la teva pròpia tendència.
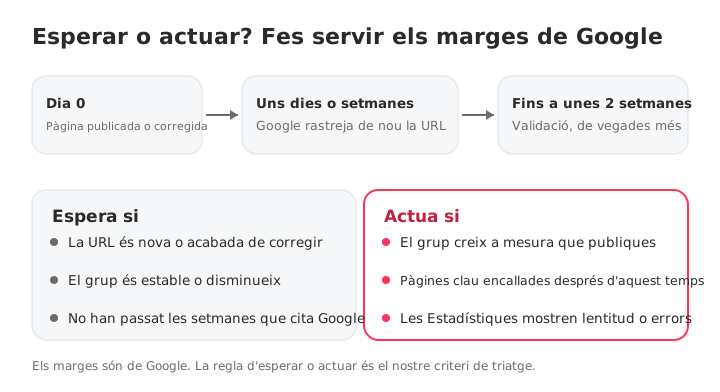
| El que has fet | El que diu Google | Font |
|---|---|---|
| Has demanat a Google que rastregi de nou | De pocs dies a unes setmanes | Demanar a Google que rastregi de nou |
| Has sol·licitat la indexació | Normalment al voltant d'un dia, fins a una o dues setmanes, amb quota diària | Ajuda d'inspecció d'URL |
| Has validat la correcció | Fins a unes dues setmanes, de vegades molt més | Ajuda d'indexació de pàgines |
Els marges de temps són de Google. La regla d'esperar o actuar és nostra: espera mentre la URL sigui nova i el grup sigui estable o disminueixi, i actua quan el grup continuï creixent o les teves pàgines clau segueixin encallades després d'aquestes setmanes.
Com fer-ne el seguiment al llarg del temps
Search Console mostra l'estat més recent de cada URL i una llista limitada a 1.000 files, així que munta la teva pròpia rutina:
- Un cop al mes, exporta la llista i compara-la amb l'anterior. El grup creix, és estable o disminueix?
- Agrupa per patró (idioma, carpeta, plantilla) abans de mirar URL soltes.
- Mira com va trobar Google cada URL. Una llista tota de «sitemap» i res de «pàgina de referència», com les nostres 14 URL, apunta directament als enllaços interns.
La vista Indexació de SEOcrawl AI et dona aquesta llista feta: filtra per estat de cobertura per veure'n les URL, amb data de l'últim rastreig, clics i impressions. Per MCP, cada URL arriba també amb el canonical triat per Google enfront del declarat i si es va trobar pel sitemap o per una pàgina de referència. El Crawler audita les teves pròpies pàgines, de manera que veus què és feble en una URL abans de demanar a Google que hi tingui una altra ullada, i el SEO Monitor t'avisa quan una pàgina clau passa a noindex, canvia de canonical, retorna 404 o desapareix del sitemap.
Aquesta és la llista del nostre propi web, directament de la vista d'Indexació:
També pots saltar-te el panell. Amb el MCP de SEOcrawl AI connectat a Claude o ChatGPT, pregunta: «Mostra'm les URL a Discovered – currently not indexed i agrupa-les per carpeta.» Aquí tens el pas a pas per connectar Search Console a Claude i ChatGPT.
Preguntes freqüents
Què significa «Discovered – currently not indexed»?
Significa que Google ha trobat la teva URL però encara no l'ha rastrejat. Normalment Google ho tenia previst i ho ha ajornat, i per això la data de l'últim rastreig és buida (ajuda d'indexació de pàgines). Google no ha llegit la pàgina, així que l'estat no diu res sobre la seva qualitat. No és una penalització.
Quant dura «Discovered – currently not indexed»?
Google no publica cap termini per a aquest estat. Diu que un nou rastreig sol·licitat triga de pocs dies a unes setmanes, i que la validació d'una correcció triga fins a unes dues setmanes, de vegades molt més. Una URL nova pot necessitar simplement aquestes setmanes. Si el grup continua creixent a mesura que publiques, deixa d'esperar i actua.
Sol·licitar la indexació ho soluciona?
Pot ajudar en unes poques URL prioritàries, perquè demana a Google que posi la pàgina a la cua. No elimina la causa, així que la pàgina pot tornar al mateix estat. Les sol·licituds estan subjectes a una quota diària, i Google diu que enviar la mateixa URL diverses vegades no accelera res. Fes-ho servir després de millorar els enllaços interns, mai com a eina massiva.
És una penalització?
No. Les accions manuals tenen el seu propi informe. Aquest estat vol dir que Google ha trobat la URL i encara no l'ha rastrejat, així que la pàgina no s'ha avaluat. La causa sol ser la prioritat de rastreig: enllaços interns febles, un servidor lent o un munt d'URL de poc valor competint per rastrejos.
Per què tantes de les meves pàgines estan descobertes però no indexades?
Una xifra alta sol apuntar a un patró, no a pàgines soltes: paràmetres d'URL o facetes, duplicats, un sitemap amb URL que no hi haurien de ser, enllaços interns febles cap a tota una secció o un servidor que frena Googlebot. Agrupa les URL per carpeta, idioma o plantilla abans de mirar-ne cap per separat.
Cal preocupar-se en un web petit?
Normalment no. Google diu que si el teu web té menys de 500 pàgines, probablement ni necessites l'informe d'indexació de pàgines. Unes poques URL noves en aquest estat acostumen a necessitar temps i uns quants enllaços interns des de pàgines que Google ja rastreja.
Com pot ajudar SEOcrawl AI amb les URL descobertes?
La vista Indexació de SEOcrawl AI llista les URL encallades en cada estat de cobertura de Google, amb data de l'últim rastreig, clics i impressions. Pel MCP de SEOcrawl AI també pots demanar a Claude o ChatGPT aquesta llista amb el canonical de Google enfront del declarat i si Google va trobar cada URL pel sitemap o per una pàgina de referència, agrupada per carpeta.
Més SEOcrawl AI a Google
Tria'ns com a font preferida i veuràs més articles nostres a les notícies destacades de Google.
Autor: David Kaufmann
He passat els últims 10+ anys completament obsessionat amb el SEO — i sincerament, no ho canviaria per res.
La meva carrera va fer un salt qualitatiu quan vaig treballar com a especialista SEO sènior a Chess.com — un dels 100 webs més visitats de tot Internet. Operar a aquesta escala em va ensenyar coses que cap curs ni certificació podrien transmetre.
D'aquella experiència vaig fundar SEO Alive — una agència per a marques que es prenen seriosament el creixement orgànic. I com que no trobava cap eina que gestionés bé tant el SEO clàssic com el món de la IA, vaig construir SEOcrawl AI. Si busques un partner SEO sènior que s'estimi aquest sector de debò — m'encantarà parlar amb tu!
Descobreix més contingut d'aquest autor
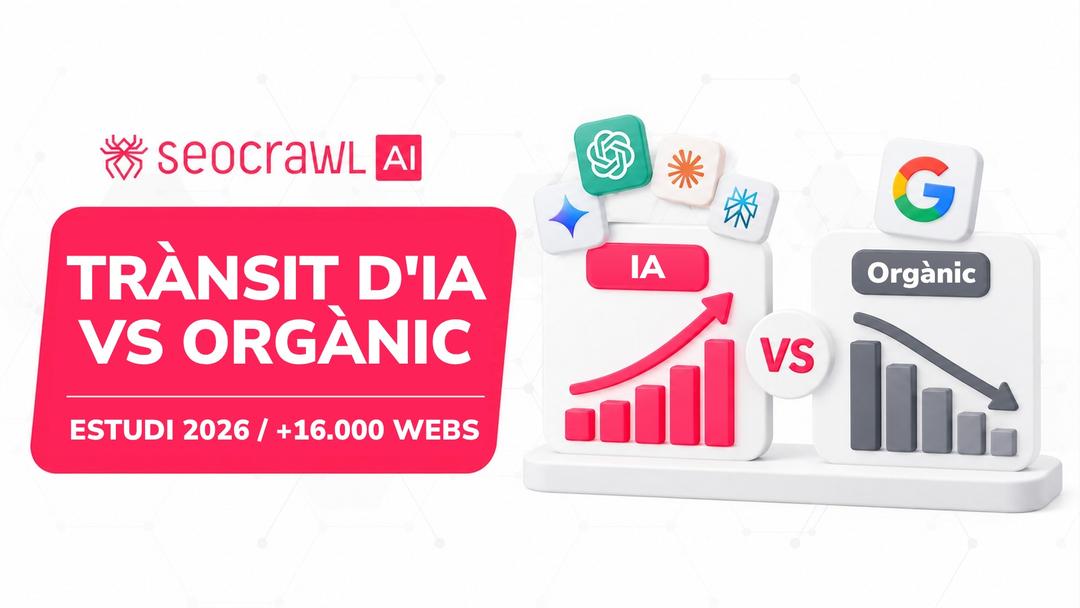
Hem mesurat els clics de Google i el trànsit referit per IA en més de 16.000 webs i 15 sectors. El trànsit d'IA creix un 45 % l'any, però encara equival a 1 visita per cada 100 de Google, mentre que els clics de Google han caigut un 15 %.

Fins al 30 de novembre, el primer any de qualsevol pla anual de SEOcrawl AI surt a meitat de preu amb el codi BLACKFRIDAY2026. Què inclou, quants prompts dona cada pla i com veure en 15 minuts on et mencionen ChatGPT, Gemini, Claude i Perplexity.