Exclosa per una etiqueta 'noindex': què vol dir i com solucionar-ho
Has obert Google Search Console, has vist un grup d'URL marcades com a "Exclosa per una etiqueta 'noindex'" i ara aquestes pàgines són invisibles a la cerca.
Si has detectat un conjunt d'URL amb l'etiqueta "Exclosa per una etiqueta 'noindex'" a Google Search Console, les teves pàgines s'estan mantenint fora de l'índex de Google de manera deliberada, i la solució sol ser més senzilla del que sembla: troba la directiva, elimina-la i demana a Google que torni a rastrejar.
Aquesta guia explica exactament què provoca aquest estat, com localitzar la directiva noindex responsable i els passos precisos per eliminar-la als principals CMS perquè les teves pàgines tornin a posicionar. La mateixa comprovació s'executa automàticament al Crawler de SEOcrawl AI, que detecta les directives noindex a tot el lloc sense haver de revisar URL per URL.
Què vol dir "Exclosa per una etiqueta 'noindex'" a Google Search Console?
L'estat "Exclosa per una etiqueta 'noindex'" vol dir que Googlebot ha rastrejat la teva pàgina, hi ha trobat una directiva noindex i l'ha respectada mantenint la pàgina fora de l'índex de Google. La pàgina no apareixerà als resultats de cerca mentre la directiva hi continuï.
On apareix aquest estat a GSC
A l'antic informe de cobertura (substituït per l'informe Indexació de pàgines el 2022), aquest estat apareixia a "Exclosa". A l'actual informe Indexació de pàgines (Indexació › Pàgines), el trobaràs a "No indexada", a la taula "Per què no s'indexen les pàgines", amb el motiu "Exclosa per una etiqueta 'noindex'". Google agrupa totes les URL afectades sota aquesta etiqueta perquè les puguis exportar i revisar en bloc.
Com descobreix i respecta Google la directiva noindex
La documentació de Google sobre com bloquejar la indexació amb noindex descriu dues vies: una etiqueta <meta name="robots" content="noindex"> a l'<head> de l'HTML de la pàgina, o una directiva X-Robots-Tag: noindex a les capçaleres de resposta HTTP. Quan Googlebot troba qualsevol de les dues, treu la pàgina de l'índex del tot, encara que abans estigués indexada. Per als conceptes bàsics de l'etiqueta, consulta la nostra guia sobre la metaetiqueta noindex.
Sempre és un problema? Quan l'exclusió és intencionada
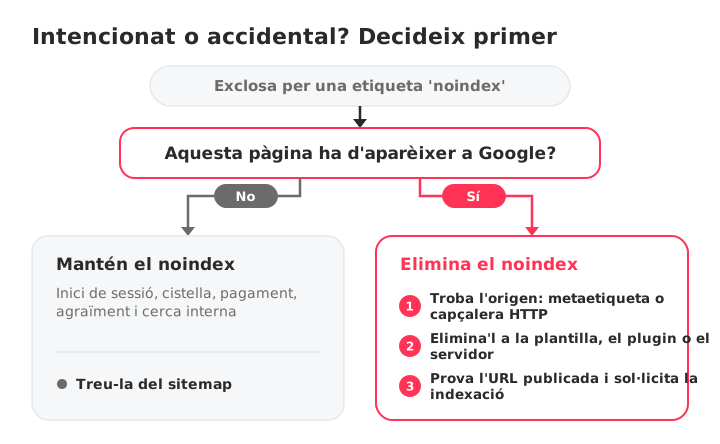
No totes les URL amb "Exclosa per una etiqueta 'noindex'" són un error. Les pàgines d'administració, les pantalles d'inici de sessió, els processos de cistella i pagament, les pàgines d'agraïment i els resultats de cerca interna es mantenen fora de l'índex de Google a propòsit. Si aquestes pàgines mostren aquest estat, el sistema funciona tal com s'espera. El problema real comença quan porten aquesta etiqueta pàgines que vols posicionar.
Causes habituals de l'estat "Exclosa per una etiqueta 'noindex'"
Una directiva noindex pot arribar a la teva pàgina per diverses vies. Saber quina està activa al teu lloc determina la solució.
Metaetiqueta robots amb "noindex" a l'<head>
L'origen més habitual. Una línia com <meta name="robots" content="noindex"> a l'HTML de la pàgina indica a Googlebot que no la indexi. Pot estar escrita directament a la plantilla o injectada dinàmicament per un CMS, un plugin o una funció del tema.
X-Robots-Tag a les capçaleres de resposta HTTP
L'X-Robots-Tag funciona exactament igual que la metaetiqueta, però viu a la capçalera de resposta HTTP, no a l'HTML. La pot afegir la configuració del servidor, regles de la CDN o directives de .htaccess. Per exemple:
Header set X-Robots-Tag "noindex"
Això afecta tots els fitxers que compleixen la regla, inclosos PDF i imatges que no tenen secció <head> d'HTML. Molts propietaris de llocs passen per alt aquesta via perquè la directiva no es veu al codi font de la pàgina.
Opcions del CMS que bloquegen la indexació per error
WordPress té una casella a Configuració › Lectura anomenada "Demana als motors de cerca que no indexin aquest lloc". Quan està marcada, WordPress afegeix una etiqueta robots noindex a totes les pàgines del lloc. Molts propietaris l'activen durant el desenvolupament i s'obliden de desmarcar-la després del llançament.
Shopify pot aplicar noindex a través del codi del tema o d'aplicacions. Shopify mateix manté fora de l'índex algunes pàgines de compte i de sistema, i això és correcte, però una edició del tema o una aplicació de SEO pot afegir noindex per error a pàgines de producte, de col·lecció o del blog.
Wix aplica noindex a qualsevol pàgina la configuració SEO de la qual impedeixi que els cercadors la indexin. Un desencadenant habitual és duplicar una pàgina i heretar-ne la configuració noindex de l'original sense adonar-se'n.
Conflictes de plugins o del tema que afegeixen noindex
Els plugins de SEO et permeten definir noindex per entrada, per pàgina o per tipus de contingut. Una regla global mal configurada, una actualització de plugin que restableix la configuració o un tema que sobreescriu les directives del plugin poden aplicar noindex a desenes de pàgines alhora. Si fa poc has actualitzat un plugin o has canviat de tema, revisa això primer.
Configuració de l'entorn de staging publicada en producció
Una font sorprenentment habitual d'etiquetes noindex accidentals. El teu lloc de staging fa servir noindex per mantenir-se fora de Google. Quan el procés de desplegament porta la configuració de staging a producció, la directiva noindex hi va inclosa. Això sol afectar seccions senceres d'un lloc alhora i és una de les causes més difícils de diagnosticar si només revises pàgines individuals.
Com diagnosticar quines pàgines estan afectades
Un procés de diagnòstic repetible detecta totes les URL afectades sense haver d'endevinar. Comença per Search Console per obtenir la llista i després baixa a les pàgines individuals per trobar l'origen.
Fer servir l'informe Indexació de pàgines per exportar les URL afectades
Obre Google Search Console i ves a Indexació › Pàgines. Fes clic a "Exclosa per una etiqueta 'noindex'" a la taula "Per què no s'indexen les pàgines". Search Console mostra una mostra de les URL afectades; fes servir el botó Exporta per baixar la llista i treballar-hi.
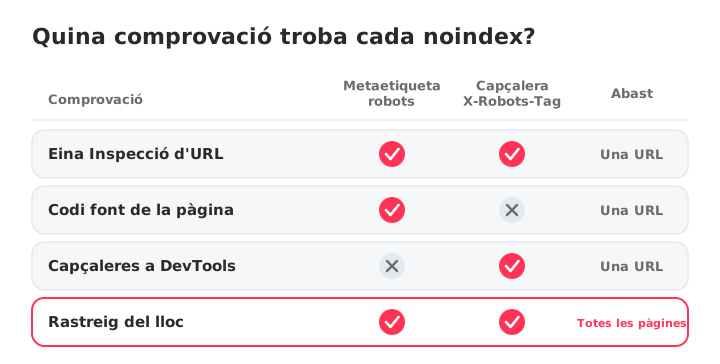
Inspeccionar una sola URL amb l'eina Inspecció d'URL
Enganxa qualsevol URL a la barra de cerca de la part superior de Search Console. L'eina Inspecció d'URL mostra si Google ha vist una directiva noindex i on l'ha trobada: a "Indexació permesa?" indica si el noindex venia de la metaetiqueta robots o de la capçalera HTTP X-Robots-Tag. Fes clic a Mostra la pàgina rastrejada per veure l'HTML exacte que va rebre Googlebot. És la comprovació més ràpida per a una sola pàgina.
Revisar el codi font de la pàgina per trobar metaetiquetes noindex
Obre la pàgina al navegador, fes clic amb el botó dret i selecciona Mostra el codi font de la pàgina, i després cerca "noindex" (Ctrl+F o Cmd+F). Si hi trobes <meta name="robots" content="noindex"> o alguna cosa semblant, la metaetiqueta és la culpable. Si no la trobes al codi font, pot ser que la directiva vingui de la capçalera HTTP.
Fer servir les DevTools del navegador per revisar les capçaleres HTTP
Obre les DevTools (F12, o clic dret › Inspecciona), ves a la pestanya Network, recarrega la pàgina i fes clic a la sol·licitud del document principal. Busca X-Robots-Tag: noindex a la secció Response Headers. És l'única manera de detectar des del navegador les directives noindex enviades a la capçalera que no apareixen a l'HTML.
Rastrejar el lloc amb Screaming Frog o SEOcrawl AI
Per a un diagnòstic de tot el lloc, un rastrejador detecta totes les pàgines afectades d'una sola passada. Screaming Frog SEO Spider pot filtrar les pàgines per indexabilitat tenint en compte metaetiquetes i capçaleres. El Crawler de SEOcrawl AI rastreja totes les pàgines, marca cadascuna de les que tenen una directiva noindex a Indexability i et retorna un Audit Health Score, de manera que veus l'abast complet sense exportar ni filtrar a mà.
Com solucionar "Exclosa per una etiqueta 'noindex'" pas a pas
Aquesta és la secció més pràctica. Aplica la solució que correspon al diagnòstic de la secció anterior.
Eliminar la metaetiqueta noindex del codi font de la pàgina
Edita la plantilla o el contingut de la pàgina per treure <meta name="robots" content="noindex"> de l'<head> de l'HTML. En llocs fets a mida, revisa directament els fitxers de plantilla. Si l'etiqueta l'injecta JavaScript, troba l'script responsable i elimina'l o posa-hi una condició.
Abans:
<meta name="robots" content="noindex">
Després:
<meta name="robots" content="index, follow">
O simplement elimina l'etiqueta del tot. Google interpreta l'absència d'una directiva noindex com a "indexació permesa".
Corregir l'X-Robots-Tag a la configuració del servidor o de la CDN
Revisa el teu .htaccess (Apache), el nginx.conf (Nginx) o les regles de la CDN per trobar directives X-Robots-Tag: noindex. Elimina-les, o limita-les als camins concrets que s'han d'excloure en lloc de les pàgines que vols indexar. Per exemple, pots mantenir el noindex a /staging/ i treure'l de /blog/.
Com solucionar-ho a WordPress
Dues comprovacions, per aquest ordre:
- Opció de tot el lloc: ves a Configuració › Lectura i desmarca "Demana als motors de cerca que no indexin aquest lloc". És la causa més habitual dels problemes de noindex a tot el lloc a WordPress.
- Configuració per pàgina als plugins de SEO:
- Yoast SEO: obre l'entrada o la pàgina, baixa fins a la caixa de Yoast, fes clic a la pestanya Avançat i posa "Permetre que els motors de cerca mostrin aquest contingut als resultats de cerca?" a "Sí".
- Rank Math: obre l'entrada, ves a la caixa de Rank Math, fes clic a la pestanya Advanced i posa "Robots Meta" a "Index".
- All in One SEO: edita l'entrada, obre la pestanya Advanced de la configuració d'AIOSEO i assegura't que "No Index" no està marcat a la configuració de robots.
Revisa també la configuració global de cada plugin per si hi ha tipus de contingut sencers (etiquetes, categories, tipus d'entrada personalitzats) amb noindex. Per a la resta de la configuració de WordPress, consulta la nostra guia per connectar WordPress amb Google Search Console.
Com solucionar-ho a Shopify
A Shopify, el noindex sol venir del codi del tema o d'una aplicació. Obre Botiga online › Temes › Editar codi i cerca a theme.liquid i a les plantilles de pàgina una metaetiqueta robots amb noindex. Després revisa les aplicacions de SEO per si tenen regles que amaguen productes, col·leccions o entrades del blog, i qualsevol producte o pàgina que faci servir el metacamp seo.hidden. Shopify manté fora de l'índex les pàgines de compte i altres pàgines de sistema, i han de continuar així.
Com solucionar-ho a Wix, Squarespace i altres creadors de webs
Wix: obre la configuració SEO de la pàgina (des del menú de la pàgina) i activa "Permet que els motors de cerca indexin aquesta pàgina". Si has duplicat una pàgina, la còpia pot haver heretat la configuració noindex de l'original.
Squarespace: revisa la configuració SEO de tot el lloc per si hi ha alguna opció que amagui el lloc als cercadors. Per a pàgines individuals, obre la configuració de la pàgina i busca "Hide page from search results" a la pestanya SEO. Squarespace també manté algunes pàgines de sistema, com la cistella, fora dels resultats de cerca per defecte.
Després de la solució: sol·licitar la reindexació a Google Search Console
Eliminar l'etiqueta noindex indica a Google que pot indexar la pàgina, però encara cal que Googlebot la torni a rastrejar per confirmar el canvi.
Fer servir l'eina Inspecció d'URL per sol·licitar la indexació
Enganxa l'URL corregida a la barra de cerca de Search Console. Fes clic a Prova l'URL publicada per confirmar que ara la indexació està permesa i després fes clic a Sol·licita la indexació. Google posarà l'URL a la cua per tornar-la a rastrejar. Pots enviar diverses URL d'aquesta manera, però Search Console limita quantes en pots sol·licitar cada dia.
Quant de temps triga Google a reindexar una pàgina?
Normalment entre uns quants dies i unes quantes setmanes, segons la freqüència amb què Googlebot rastreja el teu lloc. Els llocs amb molt de trànsit i actualitzats sovint es tornen a rastrejar més de pressa; els llocs nous o amb poc trànsit poden esperar setmanes. Sol·licitar la indexació és el senyal més ràpid que pots enviar, però no és cap garantia: posa l'URL a la cua de rastreig, no força un rastreig immediat.
Enviar un sitemap XML actualitzat per accelerar el rastreig
Si has corregit moltes pàgines alhora, envia un sitemap XML actualitzat a la secció Sitemaps de Search Console. Això indica que el teu lloc ha canviat i afavoreix un rastreig més ampli. Un sitemap net, sense URL amb noindex, també evita enviar senyals contradictoris, com veurem a continuació.
Quan cal mantenir l'etiqueta noindex (exclusions intencionades)
No totes les etiquetes noindex s'han d'eliminar. Algunes pàgines no haurien d'aparèixer mai als resultats de cerca, i indexar-les afegeix pàgines pobres o duplicades a la visió que Google té del teu lloc i malgasta atenció de rastreig.
Pàgines que no s'haurien d'indexar mai
- Pàgines d'inici de sessió i de registre
- Pàgines de cistella, pagament i confirmació de comanda
- Pàgines de resultats de cerca interna (per evitar contingut duplicat)
- Pàgines d'agraïment (lead magnets, enviaments de formularis)
- Pàgines d'administració i de backend
- Entorns de staging i de desenvolupament
- Pàgines de filtres i paràmetres que generen URL duplicades
noindex o robots.txt: diferències clau
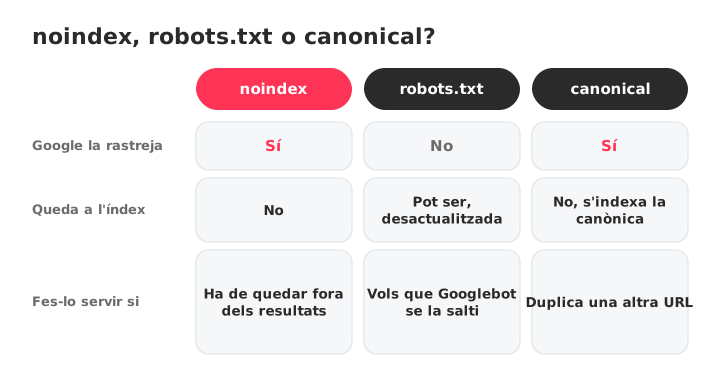
El robots.txt bloqueja el rastreig. El noindex permet el rastreig però bloqueja la indexació. Si bloqueges una pàgina al robots.txt, Googlebot no la llegeix mai, i això vol dir que tampoc no veu mai l'etiqueta noindex. Si vols treure una pàgina de l'índex, fes servir noindex. Si vols que Googlebot se la salti del tot (per estalviar pressupost de rastreig), fes servir robots.txt.
Un error habitual: fer servir robots.txt per bloquejar una pàgina que ja està indexada. Google no pot veure l'etiqueta noindex si no pot rastrejar la pàgina, així que l'URL pot quedar a l'índex amb un títol i un fragment desactualitzats. El correcte és permetre el rastreig i fer servir noindex per treure la pàgina de l'índex.
Etiquetes canonical o noindex: com triar la directiva adequada
Una etiqueta canonical (rel="canonical") diu a Google "aquesta pàgina és una còpia d'aquella altra URL, posiciona aquella". Una etiqueta noindex diu a Google "no indexis aquesta pàgina de cap manera". Tenen finalitats diferents:
- Fes servir canonical quan tens contingut duplicat o gairebé duplicat i vols consolidar els senyals de posicionament en una sola URL.
- Fes servir noindex quan la pàgina no ha d'aparèixer als resultats de cerca en cap cas.
Combinar-les totes dues a la mateixa pàgina envia senyals contradictoris: una diu "integra aquesta pàgina en una altra URL" i l'altra diu "descarta-la". Tria la que correspon al que vols.
Com evitar etiquetes noindex accidentals en el futur
Corregir els problemes de noindex quan apareixen és necessari, però prevenir-los estalvia hores de diagnòstic i trànsit perdut.
Configurar alertes de Search Console per a caigudes d'indexació
Google Search Console envia correus als propietaris i usuaris verificats quan detecta problemes d'indexació nous en una propietat. Assegura't que les notificacions per correu estan activades a les preferències de correu de Search Console. Si el nombre de pàgines indexades cau de sobte, l'alerta et dona avantatge abans que el trànsit també caigui.
Afegir comprovacions de noindex a la teva checklist de QA abans del llançament
Abans de desplegar qualsevol lloc o de passar staging a producció, comprova si hi ha directives noindex. Una comprovació de 30 segons amb "Mostra el codi font de la pàgina" i una cerca de "noindex" detecta l'error de desplegament més habitual. En llocs més grans, rastreja abans i després del desplegament i compara el nombre de pàgines amb noindex. Afegeix-ho a la teva checklist de SEO tècnic perquè ningú no se la salti.
Rastrejos programats per detectar directives noindex inesperades
Executa un rastreig complet de manera programada, i després de qualsevol actualització de plugins, canvi de tema o migració, per detectar etiquetes noindex inesperades abans que et costin trànsit. El Crawler de SEOcrawl AI et permet comparar rastrejos, de manera que veus quines pàgines han passat a noindex i quan, i SEO Monitor t'avisa en el moment que una de les teves pàgines clau rep una etiqueta noindex.
Preguntes freqüents
Què vol dir "Exclosa per una etiqueta 'noindex'" a Google Search Console?
Vol dir que Google ha trobat i ha respectat una directiva noindex a la teva pàgina, de manera que la pàgina no apareixerà als resultats de cerca. L'estat es mostra a l'informe Indexació de pàgines de Search Console, a l'apartat "No indexada".
No sempre és un error: les pàgines que exclous a propòsit, com les d'inici de sessió o de pagament, haurien de mostrar aquest estat.
Com solucione "Exclosa per una etiqueta 'noindex'" a WordPress?
Revisa dos llocs, per aquest ordre. Primer, ves a Configuració › Lectura i assegura't que l'opció "Demana als motors de cerca que no indexin aquest lloc" està desmarcada. Després, obre cada entrada o pàgina afectada al teu plugin de SEO (Yoast, Rank Math, All in One SEO) i comprova que la configuració de robots de la pàgina permet la indexació.
Quant de temps triga Google a indexar una pàgina després de treure el noindex?
Normalment entre uns quants dies i unes quantes setmanes, segons la freqüència amb què Googlebot rastreja el teu lloc. Sol·licita la indexació amb l'eina Inspecció d'URL després d'eliminar la directiva i envia un sitemap XML actualitzat per accelerar el procés. Els llocs amb molt de trànsit es tornen a rastrejar més de pressa que els nous o amb poc trànsit.
Una pàgina pot quedar exclosa per noindex encara que sigui al meu sitemap?
Sí. La directiva noindex té prioritat sobre la inclusió al sitemap. Google pot continuar rastrejant l'URL des del sitemap, però no la indexarà mentre hi hagi el noindex.
O bé elimines el noindex perquè la pàgina es pugui indexar, o bé treus l'URL del sitemap si l'exclusió és intencionada. Incloure URL amb noindex en un sitemap envia senyals contradictoris.
Quina diferència hi ha entre noindex i bloquejar una pàgina amb robots.txt?
El robots.txt impedeix que Googlebot rastregi la pàgina; el noindex permet el rastreig però n'impedeix la indexació. Si bloqueges una pàgina amb robots.txt, Google no pot llegir l'etiqueta noindex, i una pàgina ja indexada pot quedar a l'índex amb contingut desactualitzat. Fes servir noindex per treure una pàgina de l'índex, i robots.txt només quan vulguis evitar-ne el rastreig del tot.
Com puc comprovar si una pàgina té una etiqueta noindex?
Tres mètodes, del més ràpid al més exhaustiu: fes servir l'eina Inspecció d'URL de Search Console, mira el codi font de la pàgina i cerca "noindex" (Ctrl+F), o revisa les capçaleres de resposta HTTP a les DevTools del navegador (pestanya Network, busca X-Robots-Tag). Només l'eina Inspecció d'URL i les DevTools detecten un noindex enviat a la capçalera.
M'he de preocupar si moltes pàgines mostren "Exclosa per una etiqueta 'noindex'"?
Només si aquestes pàgines s'haurien d'indexar. Exporta la llista des de Search Console, compara-la amb les teves exclusions intencionades (inici de sessió, cistella, administració, pàgines d'agraïment) i corregeix només les pàgines que haurien de posicionar. Si totes les pàgines afectades són pàgines que has exclòs deliberadament, l'estat funciona correctament.
Автор: David Kaufmann

He passat els últims 10+ anys completament obsessionat amb el SEO — i sincerament, no ho canviaria per res.
La meva carrera va fer un salt qualitatiu quan vaig treballar com a especialista SEO sènior a Chess.com — un dels 100 webs més visitats de tot Internet. Operar a aquesta escala em va ensenyar coses que cap curs ni certificació podrien transmetre.
D'aquella experiència vaig fundar SEO Alive — una agència per a marques que es prenen seriosament el creixement orgànic. I com que no trobava cap eina que gestionés bé tant el SEO clàssic com el món de la IA, vaig construir SEOcrawl AI. Si busques un partner SEO sènior que s'estimi aquest sector de debò — m'encantarà parlar amb tu!
Descobreix més contingut d'aquest autor