Crawled – currently not indexed: què vol dir i com solucionar-ho

Google ha visitat la teva URL, l'ha llegida i l'ha deixada fora dels resultats. T'expliquem com saber quines pàgines mereixen una segona oportunitat i què diu Google per tornar-les a l'índex.
Crawled – currently not indexed (rastrejada, actualment no indexada) vol dir que Googlebot ha obtingut la pàgina i ha decidit no afegir-la a l'índex de Google, de manera que no pot aparèixer a les cerques. L'ajuda de l'informe Indexació de pàgines ho explica així: la pàgina s'ha rastrejat però no s'ha indexat, i «pot ser indexada o no en el futur».
La causa sol ser la mateixa pàgina, no un bloqueig tècnic. A continuació veuràs com decidir, URL per URL, si cal corregir, aplicar noindex o eliminar cada pàgina, i quant triga una correcció segons Google. És la primera vegada que obres l'informe? Comença per aquesta guia de Google Search Console.
Què vol dir «Crawled – currently not indexed»?
L'estat vol dir que Google ha rastrejat la pàgina i ha decidit no indexar-la. Res no ha bloquejat Googlebot: Google ha decidit deixar la pàgina fora de moment. Dues distincions t'ajuden a interpretar bé l'estat.
Rastrejada o indexada
Rastrejar és que Googlebot descarregui una pàgina. Indexar és que Google l'emmagatzemi perquè pugui aparèixer a les cerques. Una pàgina es pot rastrejar moltes vegades i no arribar a indexar-se mai.
L'ajuda de l'eina Inspecció d'URL diu que la qualitat d'una pàgina ha de ser «prou alta per justificar-ne la indexació», i la prova en directe no pot detectar aquest estat.
En què es diferencia de «Discovered – currently not indexed»
Discovered – currently not indexed (descoberta, actualment no indexada) arriba un pas abans: Google ha trobat la URL però ha ajornat el rastreig per no sobrecarregar el lloc, per això la data de l'últim rastreig és buida.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Rastrejada per Google? | No | Sí |
| Data de l'últim rastreig | Buida | Una data |
| Motiu habitual | Rastreig ajornat per no sobrecarregar el lloc | Google ha llegit la pàgina i l'ha descartada |
| Què cal revisar primer | Capacitat de rastreig, en llocs molt grans | Qualitat del contingut, duplicats, canòniques |
Google també diu que «no estar indexada no és necessàriament dolent». Les pàgines amb noindex, les URL bloquejades a robots.txt, els duplicats i els 404 sense substituta han de quedar fora.
Per què Google rastreja pàgines sense indexar-les
La indexació té un llistó de qualitat que el rastreig no té. La guia del pressupost de rastreig de Google diu que la demanda de rastreig creix amb el valor i l'originalitat del contingut.
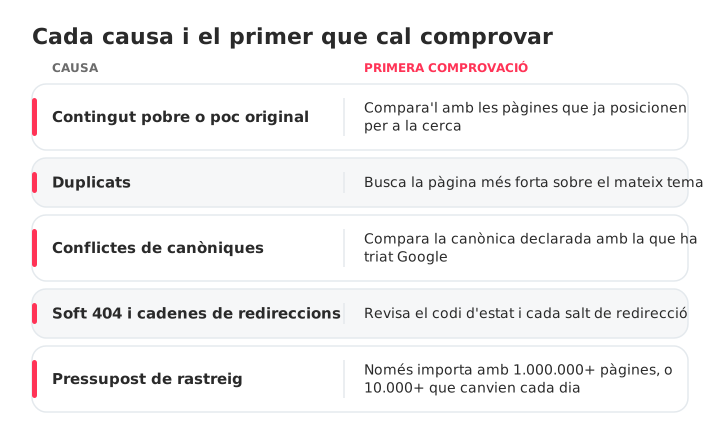
La majoria de les URL afectades encaixen en una d'aquestes causes, cadascuna amb la seva primera comprovació:
- Contingut pobre o poc original: la pàgina repeteix el que ja posiciona.
- Duplicats: arxius d'etiquetes, URL ordenades, dos articles sobre el mateix tema. Així pots detectar i corregir la canibalització de paraules clau.
- Conflictes de canòniques: compara la canònica que declares amb la que ha triat Google. Quan Google tria una altra URL, la pàgina sol passar a Alternate page with proper canonical tag o a un estat de duplicat.
- Soft 404 i cadenes de redireccions: Google diu que els soft 404 malbaraten pressupost de rastreig.
- Pressupost de rastreig: importa en llocs amb més d'1.000.000 de pàgines que canvien cada setmana o més de 10.000 que canvien cada dia. En la majoria de llocs no n'és la causa.
El llistó va pujar en dos moments concrets. El 18 d'agost de 2022, Google va anunciar l'actualització de contingut útil, un senyal de tot el lloc, i va dir que eliminar el contingut poc útil podia ajudar la resta del lloc. El 5 de març de 2024, Google va anunciar una core update per mostrar menys contingut creat per atreure clics, juntament amb una nova política de spam contra l'abús de contingut a escala.
La guia de contingut útil de Google diu que E-E-A-T no és un factor de posicionament concret, que el que més pesa és la confiança i que no hi ha un nombre de paraules preferit. Farcir una pàgina no ho arregla.
Com trobar i diagnosticar les pàgines afectades a GSC
Obre l'informe Indexació de pàgines (abans, Cobertura), inspecciona'n una mostra i agrupa la llista per patrons. Google indica que els llocs de menys de 500 pàgines probablement no necessiten aquest informe.
Trobar les URL afectades a l'informe de pàgines
- A Google Search Console, ves a Indexació › Pàgines.
- A «Per què no s'indexen les pàgines», fes clic a Crawled – currently not indexed.
- Fes clic a Exporta i baixa la llista.
L'informe mostra fins a 1.000 URL d'exemple, no necessàriament totes, així que en un lloc gran l'exportació és una mostra.
Revisar pàgines amb l'eina Inspecció d'URL
Inspecciona entre cinc i deu URL exportades i fixa't en la data de l'últim rastreig i en la URL canònica seleccionada per Google. Si la canònica apunta a una altra URL, Google hi veu un duplicat; si l'últim rastreig és de fa mesos, Google hi torna molt poc.
Detectar patrons entre centenars d'URL
Ordena l'exportació per carpeta, plantilla i paràmetre d'URL, i compta cada grup. Imagina 300 URL repartides en 180 pàgines /tag/, 70 URL amb ?sort= i 50 articles: són tres decisions, no 300.
Corregir, noindex o eliminar: decideix què mereix cada URL
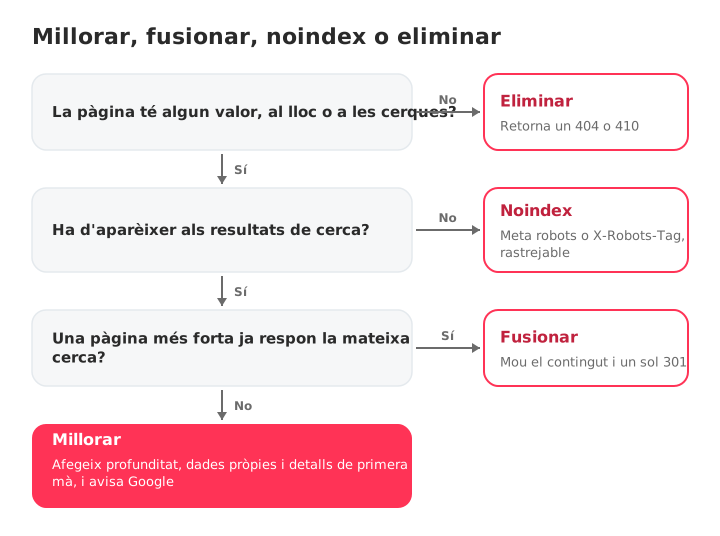
Cada URL mereix un de quatre destins. Pregunta't: estaria content qui cerca d'arribar aquí, i és aquesta l'única pàgina del lloc que respon aquella cerca?
| Tipus de pàgina | Exemple | Decisió | Com |
|---|---|---|---|
| Útil i única, però pobra | Una guia de 300 paraules sobre un tema que domines | Millorar | Afegeix profunditat i detalls de primera mà |
| Duplica una pàgina més forta | Dos articles per a la mateixa cerca | Fusionar | Mou el contingut i redirigeix amb un 301 |
| Útil al lloc, no a les cerques | Arxius d'etiquetes, cerca interna, pàgines d'agraïment | Noindex | Metaetiqueta robots o X-Robots-Tag |
| Sense valor ni substituta | Promocions caducades, pàgines de prova | Eliminar | Retorna un 404 o un 410 |
La guia del pressupost de rastreig de Google avala les dues últimes files: retorna un 404 o un 410 a les pàgines eliminades i consolida els duplicats. Un 404 a Search Console és el que toca a les pàgines que has eliminat expressament.
Amb el noindex és on més es falla a l'hora de classificar:
Així no: una etiqueta noindex a les pàgines /tag/ mentre robots.txt bloqueja /tag/. Googlebot no pot obtenir les pàgines, així que no veu mai l'etiqueta.
Així sí: /tag/ continua sent rastrejable i porta el noindex com a metaetiqueta o com a capçalera X-Robots-Tag.
Segons la documentació de noindex de Google, la regla no funciona dins de robots.txt, i en pàgines poc visitades el nou rastreig pot trigar mesos. Quan es llegeix l'etiqueta, aquestes URL passen a Exclosa per una etiqueta 'noindex', que és just el que vols per a elles.
Com corregir les pàgines que mereixen ser indexades
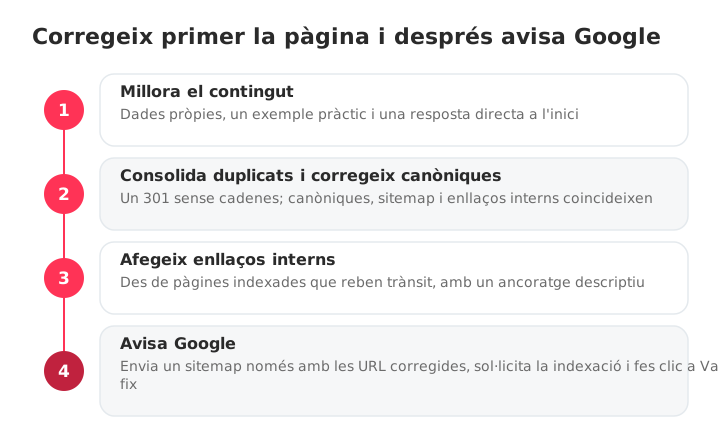
Primer fes que la pàgina mereixi ser indexada i després avisa Google. Sol·licitar la indexació d'una pàgina sense canvis és demanar a Google que repeteixi una decisió que ja ha pres. L'ordre:
- Millora el contingut.
- Consolida els duplicats i corregeix les canòniques.
- Afegeix enllaços interns.
- Envia un sitemap acotat i sol·licita la indexació.
Millora la profunditat i l'originalitat del contingut
Reescriu pensant en la cerca, no en un nombre de paraules: afegeix dades pròpies, captures, un exemple pràctic i una resposta directa a prop de l'inici.
Per exemple, agafa una guia pobra de 300 paraules: afegeix-hi un conjunt de dades propi i un exemple pràctic, enllaça-la des de dos articles que ja reben trànsit i només llavors inclou-la en un sitemap acotat.
Consolida els duplicats i corregeix les canòniques
Quan dues URL tracten el mateix, queda't-ne una, mou-hi el contingut útil i fes una redirecció 301 de l'altra directament cap a ella, sense cadenes. Després comprova que les canòniques, el sitemap i els enllaços interns coincideixen, i que no queda cap noindex perdut.
Afegeix enllaços interns des de pàgines que Google ja valora
Enllaça cada pàgina corregida des de pàgines indexades que reben trànsit, amb un text d'ancoratge descriptiu. Qualsevol crawler pot llistar les pàgines òrfenes (sense enllaços interns) filtrant per zero enllaços entrants. Tens el mètode complet en aquesta guia d'estratègia d'enllaçat intern.
Revisa també la pàgina en un mòbil i a l'informe Core Web Vitals: una pàgina trencada en mòbil es descarta ràpidament.
Envia un sitemap acotat i sol·licita la indexació
Crea un sitemap només amb les URL que has corregit, envia'l i filtra-hi l'informe de pàgines abans de fer clic a Validate fix. Google ho recomana per accelerar la validació. Si abans necessites el fitxer actual, troba el sitemap del teu lloc.
Google ignora priority i changefreq, així que val més mantenir lastmod precís. Després fes clic a Sol·licita la indexació a l'eina Inspecció d'URL per a les URL prioritàries: Google aplica una quota i diu que repetir les sol·licituds no accelera res.
Quant triga la indexació després d'una correcció?
Compta entre un dia i diverses setmanes, i la indexació no està mai garantida. Google dona terminis diferents en pàgines diferents, així que aquí els tens junts:
| Què has fet | Què diu Google | Font |
|---|---|---|
| Demanar a Google un nou rastreig | D'uns quants dies a unes quantes setmanes | Demanar a Google que torni a rastrejar |
| Sol·licita la indexació | Normalment un dia o així, fins a una o dues setmanes, amb un límit diari | Ajuda d'Inspecció d'URL |
| Validate fix | Fins a unes dues setmanes, de vegades molt més | Ajuda d'Indexació de pàgines |
Són els terminis de Google, no casos de recuperació. Revisa l'informe de pàgines cada setmana; si les URL corregides no s'han mogut un cop passats aquests terminis, torna al contingut.
Com evitar que les pàgines noves acabin en aquest estat
La prevenció és una rutina: revisa cada pàgina abans de publicar-la i repassa Search Console cada mes. Abans de publicar, confirma que la pàgina:
- Respon una cerca que cap altra pàgina del lloc respon.
- Aporta dades, exemples o experiència pròpies.
- Té una canònica autoreferenciada i cap noindex perdut.
- És al sitemap amb un lastmod precís.
- Té un autor amb nom i, quan escaigui, dades estructurades.
- Rep un enllaç des d'una pàgina relacionada i indexada.
Un cop al mes, compara l'informe de pàgines amb el del mes anterior; un problema continua apareixent durant 90 dies després que desaparegui l'últim cas. Els llocs de més de mil pàgines també haurien de vigilar l'informe d'Estadístiques de rastreig.
SEOcrawl AI s'encarrega de la part tècnica a escala. El Crawler analitza totes les pàgines i retorna un Audit Health Score, amb els problemes desglossats per Indexability, Crawlability, On-Page i més. La vista Indexation agrupa les teves URL segons l'estat de cobertura de Search Console, perquè vegis quantes n'hi ha a «Crawled – currently not indexed» i en segueixis l'evolució.
Entre rastrejos, SEO Monitor t'avisa quan una pàgina clau rep un noindex, canvia la canònica, retorna un 404 o surt del sitemap. La mateixa plataforma segueix la visibilitat de la teva marca a ChatGPT, Claude, Gemini, Perplexity i Copilot, perquè el SEO i el GEO estiguin junts.
Preguntes freqüents
Què vol dir «Crawled – currently not indexed»?
Vol dir que Googlebot ha obtingut la pàgina i ha decidit no afegir-la a l'índex de Google, de manera que no pot aparèixer a les cerques. Res no ha bloquejat el rastreig: Google ha llegit la pàgina i ha decidit deixar-la fora de moment. No és una penalització manual, i la pàgina pot ser indexada o no en el futur.
És el mateix que «Discovered – currently not indexed»?
No. «Discovered» vol dir que Google coneix la URL però ha ajornat el rastreig, per això la data de l'últim rastreig és buida. «Crawled» vol dir que Google ja ha visitat i llegit la pàgina, i després ha decidit no indexar-la. Amb Discovered, revisa la capacitat de rastreig en llocs molt grans; amb Crawled, revisa la qualitat del contingut, els duplicats i les canòniques.
«Crawled – currently not indexed» perjudica el meu SEO?
Per si sol, no: l'estat no és una penalització i la pàgina afectada només perd el seu propi trànsit de cerca. El risc és el volum, perquè Google tracta una proporció gran de contingut poc útil com un senyal de tot el lloc. Un arxiu d'etiquetes fora de l'índex no costa res; una pàgina de producte, sí. Si la xifra puja cada vegada que publiques, tracta-ho com un problema de contingut del lloc, no com una llista d'URL soltes.
Quant triga una pàgina a indexar-se després de corregir-la?
Compta entre un dia i diverses setmanes, i la indexació no està mai garantida. Google diu que un nou rastreig triga d'uns quants dies a unes quantes setmanes, que una sol·licitud d'indexació se sol processar en un dia o així però pot trigar una o dues setmanes, i que Validate fix sol trigar fins a unes dues setmanes.
Serveix d'alguna cosa sol·licitar la indexació?
Només després de canviar la pàgina. Sol·licitar la indexació d'una pàgina sense canvis és demanar a Google que repeteixi una decisió que ja ha pres. Les sol·licituds tenen una quota diària, i Google diu que enviar la mateixa URL diverses vegades no accelera res.
Ajuda afegir la pàgina al meu sitemap XML?
Ajuda Google a trobar una URL, no a indexar-la. Google diu que un sitemap enviat és «només una indicació», i aquestes pàgines ja s'han trobat i llegit. Després d'una correcció, la funció del sitemap és agrupar les URL que vols que es tornin a revisar. Cada fitxer de sitemap admet fins a 50.000 URL o 50 MB.
Per què ha fallat la validació de «Crawled – currently not indexed»?
La validació s'atura tan bon punt Google troba una URL del grup sense corregir, de manera que una sola pàgina pendent pot fer fallar tot el lot. Corregeix totes les URL del grup, o redueix el grup filtrant l'informe amb un sitemap que només contingui les URL corregides, i torna a validar.
Com ajuda SEOcrawl AI amb les pàgines que Google rastreja però no indexa?
SEOcrawl AI troba les causes internes del lloc que hi ha darrere de l'estat. El Crawler mostra la puntuació de salut, el codi d'estat HTTP i la profunditat de rastreig de cada URL, perquè detectis les pàgines a què Google arriba amb dificultat. La vista Indexation agrupa les teves URL segons l'estat de cobertura de Search Console, i SEO Monitor t'avisa quan una pàgina clau rep un noindex, canvia la canònica, retorna un 404 o surt del sitemap.
Автор: David Kaufmann

He passat els últims 10+ anys completament obsessionat amb el SEO — i sincerament, no ho canviaria per res.
La meva carrera va fer un salt qualitatiu quan vaig treballar com a especialista SEO sènior a Chess.com — un dels 100 webs més visitats de tot Internet. Operar a aquesta escala em va ensenyar coses que cap curs ni certificació podrien transmetre.
D'aquella experiència vaig fundar SEO Alive — una agència per a marques que es prenen seriosament el creixement orgànic. I com que no trobava cap eina que gestionés bé tant el SEO clàssic com el món de la IA, vaig construir SEOcrawl AI. Si busques un partner SEO sènior que s'estimi aquest sector de debò — m'encantarà parlar amb tu!
Descobreix més contingut d'aquest autor

Una pàgina de llistat de productes (PLP) mostra tota una categoria de productes alhora. Descobreix en què es diferencia d'una PDP, què la fa convertir i com aconseguir que els llistats s'indexin sense el desgavell de la navegació facetada.
