Как использовать regex в Google Search Console
Фильтры regex — самый быстрый способ вытащить из Google Search Console настоящие ответы. Зная пару-тройку шаблонов, вы отделите брендовый трафик от небрендового, соберёте все вопросы, которые люди задают перед тем, как попасть к вам, или выделите одну папку сайта — и всё это без выгрузки хотя бы одной строки.
В этом руководстве — готовые рецепты, которые работают, плюс правила RE2, из-за которых остальные молча ломаются. Всё описанное ниже работает внутри отчёта Performance, никаких дополнений не нужно.
Где в Google Search Console можно использовать regex
Чтобы открыть regex: Performance > Search results > + New filter > выбираете Query или Page > выбираете Custom (regex) в выпадающем списке.
Появляется второй список с вариантами Matches regex и Doesn't match regex. Второй вариант — ваш отрицательный фильтр, и пользоваться им вы будете постоянно.

Синтаксис RE2: что Google поддерживает (а что нет)
Google работает на RE2 — собственном движке регулярных выражений. Он быстрый и лишён нескольких возможностей, которых можно было бы ждать от Python или JavaScript. Четыре правила порождают большинство ситуаций «почему это не работает»:
- Ваш шаблон совпадает в любом месте строки, если вы не поставите якорь
^(начало) или$(конец). Поэтомуseoсовпадёт и с «seo tools», и с «best seo agency». - Согласно документации Google, сопоставление не чувствительно к регистру по умолчанию. Поставьте в начало
(?-i), если нужен учёт регистра. Данные по запросам и так хранятся в нижнем регистре, поэтому регистр кусается только на URL страниц. - Lookahead, lookbehind и обратных ссылок в RE2 нет. Когда рука тянется к отрицательному lookahead, переключите фильтр на Doesn't match regex.
- GSC ограничивает шаблон примерно 4 096 символами. Если упёрлись в лимит, разделите шаблон на два фильтра, наложенных друг на друга.
Следите за невалидными шаблонами: GSC не показывает синтаксическую ошибку, если regex составлен неправильно. Он просто возвращает ноль результатов — ровно как валидный шаблон без совпадений. Если фильтр вернул пусто, сначала исключите сломанный шаблон.

Готовые regex-фильтры для GSC
Вставляйте их прямо в фильтр Query или Page. Не забудьте заменить бренд и папки из примеров на свои.
- Брендовые запросы (Query > Matches regex). Перечислите бренд и то, как его чаще всего пишут с ошибками:
seocrawl|seo crawl|seocrawl ai - Небрендовые запросы (Query > Doesn't match regex). Тот же самый шаблон, просто переключите фильтр на «Doesn't match». Это и есть настоящая мера вашего органического охвата.
- Похожие написания бренда (Query > Matches regex).
?делает символ необязательным, поэтому один шаблон ловит сразу несколько опечаток:seo ?crawl|seocrwal|seo crawel|secrawl - Запросы-вопросы (Query > Matches regex). Привязано к началу, чтобы получить только запросы, которые начинаются с вопросительного слова:
^(who|what|when|where|why|how|is|are|can|do|does|should)\b - Одна папка или путь (Page > Matches regex). Экранируйте точки в своём домене обратным слешем:
example\.com/(blog|guides|docs)/ - Несколько ключевых слов сразу (Query > Matches regex). Вертикальная черта — это обычное ИЛИ:
buy|purchase|order|pricing|cost - Исключить ненужные слова (Query > Doesn't match regex). Уберите соискателей, любителей халявы или название конкурента:
jobs|salary|free|login - Длиннохвостые запросы по числу слов (Query > Matches regex). Это совпадает с любым запросом из четырёх слов и более — чистый источник идей для FAQ и контента:
\S+(\s+\S+){3,}
Собираем фильтр по шагам: небрендовые вопросы
Допустим, вы хотите посмотреть, как себя чувствует небрендовый трафик из запросов-вопросов.
- Откройте Performance > Search results и добавьте фильтр Query.
- Выберите Custom (regex), поставьте Doesn't match regex и вставьте шаблон своего бренда (
seocrawl|seo crawl). Примените. - Добавьте второй фильтр Query, Matches regex, и вставьте шаблон вопросов (
^(who|what|when|where|why|how)\b). Примените.
GSC складывает оба фильтра, так что в таблице теперь только небрендовые вопросы, отсортированные по кликам.
Переключите сортировку на показы — и перед вами спрос, по которому вы ранжируетесь, но почти не получаете кликов, и можно браться за следующую пачку контент-брифов.

Чиним regex, который ничего не находит
Таблица пустая? Вот как это разобрать:
| Симптом | Почему | Как чинить |
|---|---|---|
| Фильтр ничего не возвращает, хотя данные есть | Вы слишком жёстко привязались якорями: ^how$ совпадает только с одним словом «how» | Уберите $, если вам не нужно точное совпадение |
| Шаблон возвращает ноль строк без ошибки | Вы использовали возможность, которой нет в RE2 (lookahead, обратная ссылка), и весь шаблон стал невалидным | Перепишите отрицание как фильтр «Doesn't match regex» |
| Шаблон, который должен совпадать, не совпадает | Спецсимвол читается буквально: точки, слеши и вопросительные знаки в regex имеют значение | Экранируйте их обратным слешем |
| Не появляются запросы с заглавными буквами | Данные по запросам хранятся в нижнем регистре | Пишите шаблон строчными буквами |
Перестаньте набирать regex каждую сессию
Regex в GSC мощный, но он ничего не запоминает. Каждую сессию вы заново набираете тот же шаблон бренда, тот же фильтр вопросов, тот же путь до папки.
GSC даёт regex и фильтры «contains», но не даёт сохранённой таксономии, поэтому большинство команд каждую неделю выгружает данные в таблицу и размечает запросы вручную.
Для команд, которым нужны все запросы в одном месте (а не только то, что влезло в одну сессию), такая группировка уже встроена в SEO-дашборд SEOcrawl AI. Вы навешиваете теги на ключевые слова и страницы поверх своих реальных кликов и показов из Search Console, а затем режете отчёт по любому своему измерению: бренд, тематический кластер, интент, этап воронки.
Тегирование работает тремя способами: вручную, правилами автотегирования, которые классифицируют новые запросы по мере их появления, или прямо из Claude или ChatGPT через MCP SEOcrawl AI.
Теги сохраняются и переиспользуются, поэтому разделение на брендовое и небрендовое, написанное один раз, продолжит работать и в следующем месяце, без перенабора. А поскольку данные приходят из вашего собственного Google Search Console, а не из спарсенной панели, здесь нет ограничения по строкам и нет потолка выгрузки в 1 000 строк.
Search Console забывает ваш regex в момент, когда вы закрываете вкладку. SEOcrawl AI сохраняет те же шаблоны — брендовые и небрендовые, запросы-вопросы, отдельная папка — как переиспользуемые сегменты, поэтому фильтр, собранный однажды, будет на месте и на следующей неделе, без перенабора.
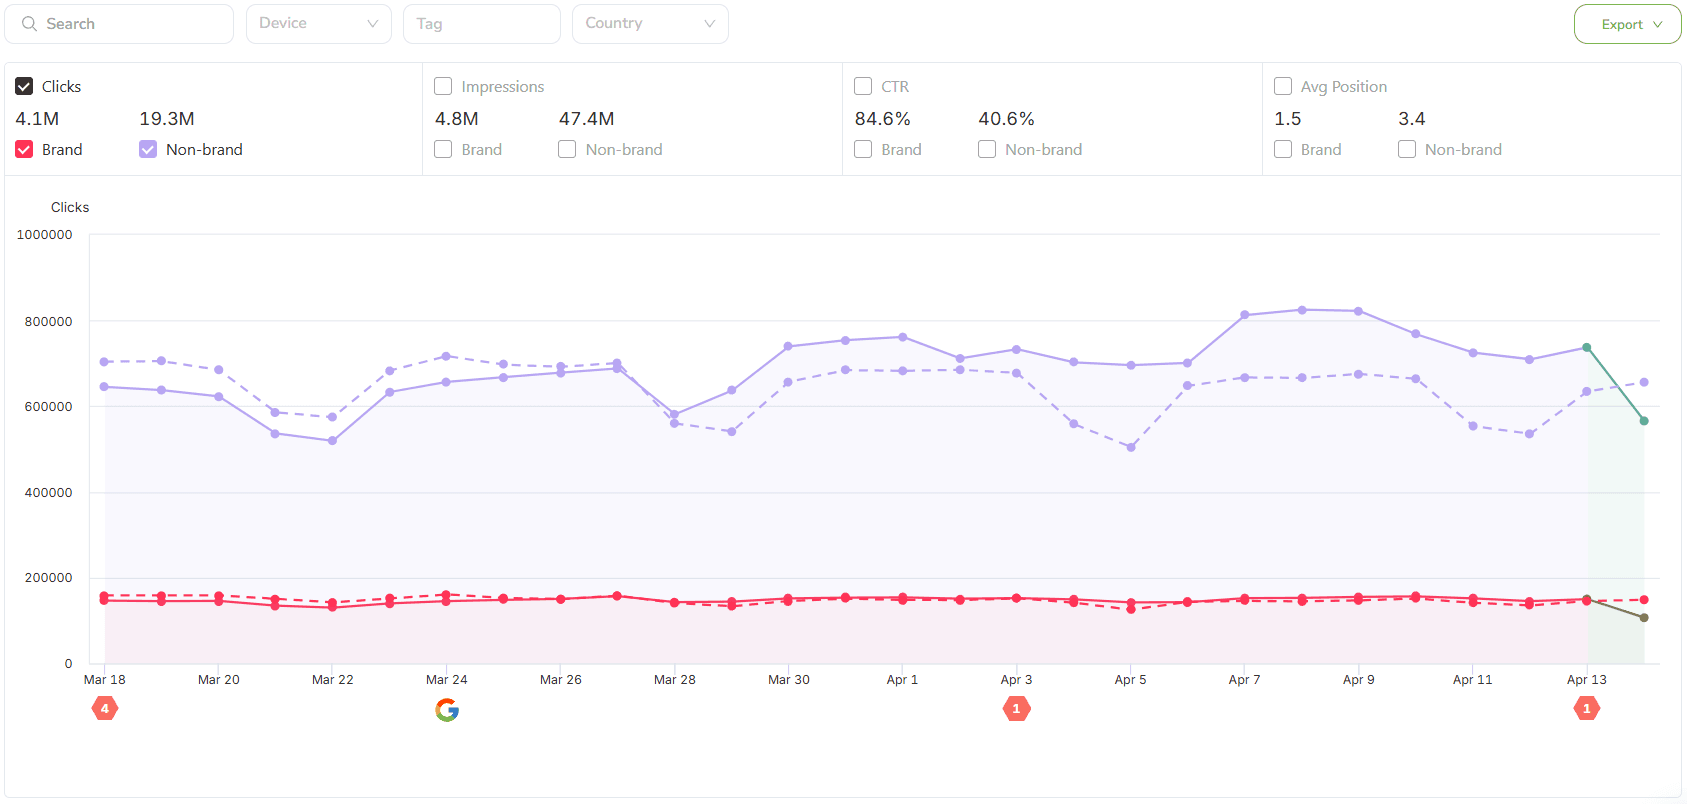
Соберите сегмент один раз и переиспользуйте каждый месяц. SEOcrawl AI навешивает теги на ключевые слова и страницы из Search Console, а затем позволяет резать клики и показы по бренду, кластеру или интенту без ограничения по строкам. Попробуйте SEOcrawl AI или посмотрите SEO-дашборд.
Частые вопросы
Поддерживает ли Google Search Console regex?
Да. Отчёт Performance принимает regex в фильтрах Query и Page через опцию Custom (regex) на синтаксисе RE2 от Google. Доступны и Matches regex, и Doesn't match regex, а несколько фильтров можно складывать друг на друга. Фильтры Country, Device и Search Appearance его не поддерживают.
Чувствителен ли regex в Google Search Console к регистру?
Нет, по умолчанию нет. В официальной документации Google сказано, что сопоставление regex в отчёте Performance регистронезависимо, если только вы не поставите в начало (?-i), чтобы включить учёт регистра. Поскольку GSC хранит данные по запросам в нижнем регистре, на практике регистр влияет только на фильтры по URL страниц, так что этот флаг почти никому не нужен.
Как отфильтровать брендовые запросы с помощью regex?
Добавьте фильтр Query, выберите Custom (regex) и перечислите свой бренд и его частые опечатки через вертикальную черту, например seocrawl|seo crawl|seocrwal. Оставьте Matches regex, чтобы увидеть брендовый трафик. Чтобы увидеть всё остальное, примените тот же шаблон с Doesn't match regex.
Почему мой regex ничего не находит?
Обычно причина в одном из четырёх: вы слишком жёстко привязались якорями ^ или $; вы использовали неподдерживаемую возможность вроде lookahead или обратной ссылки, из-за чего весь шаблон становится невалидным и ничего не возвращает; вы не экранировали спецсимвол, например точку или слеш; или вы написали заглавные буквы против данных в нижнем регистре.
Как сохранить свои regex-фильтры, чтобы не набирать их заново при каждом заходе?
В GSC нет функции сохранения, поэтому шаблоны исчезают вместе с сессией. SEOcrawl AI решает это так: вы один раз размечаете и группируете свои ключевые слова из GSC — вручную, правилами автотегирования или через MCP. Затем переиспользуете эти сегменты во всех отчётах. Теги ложатся на ваши собственные данные Search Console, поэтому нет лимита по ключевым словам и не нужно каждую неделю всё пересобирать.
Автор: David Kaufmann

Последние 10 с лишним лет я полностью одержим SEO — и, честно говоря, не хотел бы иначе.
Моя карьера вышла на новый уровень, когда я работал старшим SEO-специалистом в Chess.com — одном из ста самых посещаемых сайтов интернета. Работа в таком масштабе: миллионы страниц, десятки языков и одна из самых конкурентных выдач — научила меня тому, чему не научит ни один курс и ни один сертификат. Этот опыт изменил моё представление о том, как выглядит по-настоящему сильное SEO, и лёг в основу всего, что я построил потом.
Из него выросло SEO Alive — агентство для брендов, которые всерьёз занимаются органическим ростом. Мы не продаём дашборды и ежемесячные отчёты. Мы строим стратегии, которые реально двигают цифры, соединяя классическое SEO с новым и захватывающим миром Generative Engine Optimization (GEO): чтобы ваш бренд появлялся не только в синих ссылках Google, но и внутри ответов, которые ChatGPT, Perplexity и Google AI Overviews каждый день выдают миллионам людей.
А поскольку инструмента, который нормально закрывает оба этих мира, я так и не нашёл, я сделал его сам — SEOcrawl AI, платформу SEO-аналитики корпоративного уровня, где в одном месте собраны позиции, технические аудиты, мониторинг ссылок, здоровье краулинга и отслеживание видимости бренда в ИИ. Это та платформа, которой мне всегда не хватало.
Откройте больше материалов этого автора