Этапы и элементы процесса сканирования
Сканирование, пауки, боты — с этими терминами любой SEO-специалист имеет дело изо дня в день, и они имеют принципиальный вес в любой стратегии ранжирования, потому что если этот этап провалится, провалится и всё остальное.
Разберём в деталях, из чего состоит процесс сканирования сайта.
Что значит просканировать сайт?
Прежде чем идти дальше, определим сам процесс сканирования сайта и покажем, насколько он важен для любой попытки попасть в результаты поиска Google.
Под сканированием сайта понимают процесс, в ходе которого пауки (краулеры) проходят по разным страницам сайта, собирая всю доступную информацию, чтобы сохранить её, обработать и затем классифицировать.
Стоит выделить несколько принципиальных терминов внутри определения, которое мы только что дали:
-
Проход: Представьте себе именно паука. Это дружелюбное насекомое должно пройти по как можно большему числу страниц, чтобы извлечь как можно больше информации. Чтобы перейти с одной страницы на другую, он идёт по внутренним ссылкам, которые их связывают. Отсюда и важность правильной перелинковки, которая позволит этим паукам «обнаружить» если не весь сайт, то хотя бы самые значимые для нас страницы.
-
Доступность: Информация должна быть доступна этим паукам. То есть если мы каким-то образом ограничиваем их доступ — намеренно или по ошибке, — мы не даём паукам обработать весь контент, а значит, понять и в итоге классифицировать его.
Эта блокировка или ограничение контента страниц может происходить несколькими разными способами, которые мы попробуем объяснить дальше в этом посте.
Краулеры
Мы говорили о пауках, они же краулеры или боты. Их можно определить как программы, которые анализируют документы на нашем сайте, то есть они как «библиотекари», которые ищут, классифицируют и упорядочивают. Их главная функция — строить базы данных. Их несколько типов, в зависимости от того, какую информацию они собирают. Назовём самые распространённые.
Googlebot: Паук, отвечающий за сканирование нашего контента и его категоризацию в органических результатах (SERP). Для SEO-специалистов он самый важный. Точно посмотреть, как он сканирует ваш сайт, можно в отчёте «Статистика сканирования» в Google Search Console.
Внутри этого типа можно выделить несколько подтипов:
-
Googlebot (смартфоны): Мобильная версия
-
Googlebot (десктопная версия): Десктопная версия
-
Googlebot Images: Отвечает за сканирование изображений
-
Googlebot News: Для новостей
-
Googlebot Video: Теперь очередь видео
Пример бота, определённого в наших логах:
Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/W.X.Y.Z‡ Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
Они не единственные — есть и другие, например Adsbot, Adsense и так далее. Значимые для SEO-отрасли мы уже назвали, а отличать их от остальных — не задача этой статьи, но дополнительную информацию можно найти по следующей официальной ссылке Google.
Этапы процесса сканирования и индексации в Google
Теперь, когда мы знаем, что такое сканирование, кто отвечает за эту функцию, и обсудили процесс, разберём его подробнее.
Первый этап: сканирование и классификация
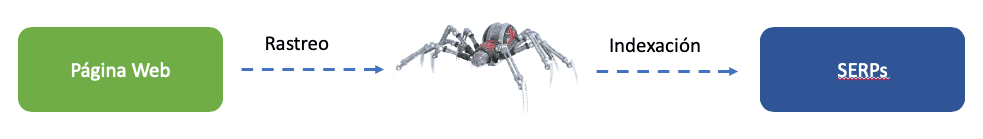
Процесс, по которому наши страницы появляются в результатах Google, проходит через первый этап сканирования, как мы видели, выполняемый пауками (краулерами), чтобы они прочитали, интерпретировали, проиндексировали и классифицировали наш контент.
Именно это новое слово мы и хотим разобрать детально — классифицировать. Google должен прекрасно понимать наш контент, просто и быстро, потому что, как мы увидим дальше, Google тратит на наш сайт определённое количество времени, и за это время он должен «понять» наш контент и связать его с разными поисковыми интентами пользователей.
Поэтому в современном SEO так часто звучит выражение «поисковый интент» (Search Intent): Google учтёт его при этой классификации, и он определит позицию, которую наши страницы займут в выдаче.
Поэтому процесс сканирования должен быть чистым, простым, быстрым, без препятствий и так далее, чтобы всё было ясно и нас классифицировали правильно.
Этап второй: индексация
Нельзя забывать про этап индексации, который предшествует классификации и тоже играет принципиальную роль, ведь это шаг, на котором Google добавляет наш контент в свою базу данных, то есть индексирует его.
Блокировка роботов Google
Мы упоминали выше, что есть способы, которыми мы можем ограничивать доступ этих пауков к нашему контенту. Для этого существует элемент принципиального веса в SEO, известный как robots.txt.
Файл robots.txt — это текстовый файл, который мы загружаем на сервер и в котором даём разным паукам точные указания разрешить или запретить обход URL нашего сайта. Эта блокировка может применяться:
-
ко всему домену
-
к конкретному пути
-
к конкретному URL
-
или к набору URL, которые соответствуют определённому шаблону.
Посмотрим на пример конфигурации этого файла:
User-agent: *
Disallow: /wp-admin/
Allow: wp-admin/admin-ajax.php
Sitemap: /sitemap.xml
Как видим, в первой строке мы указываем user-agent (имя краулера, которому хотим запретить или разрешить обход, из тех, что мы видели раньше), а дальше идут команды «disallow», чтобы запретить вход, или «allow», чтобы его разрешить.
В конкретном случае, который мы видим, указывая *, мы говорим «все краулеры», без исключения. Мы запрещаем им входить в путь /wp-admin/, но внутри этого пути хотим разрешить им вход в /admin-ajax.php.
Неправильная конфигурация этого файла может привести к тому, что мы заблокируем важные части нашего контента. Частая ошибка — держать весь сайт заблокированным, пока он в разработке, а потом забыть снять блокировку после выкладки в продакшен, из-за чего сайт становится недоступен для Google.
Ещё одна проблема, с которой пауки Google могут столкнуться при сканировании нашего контента, — невозможность пройти по внутренним ссылкам, которые есть у нас на сайте, и, соответственно, добраться до остальных URL. Так происходит, когда мы используем javascript-элементы вместо «href» в этих ссылках. Практика очень распространённая, ведь у JS много преимуществ на уровне пользователя, но при неправильном применении и добавлении во внутренние ссылки Google может не суметь по ним пройти.
В мире SEO это известно как «обфускация ссылок». На сегодняшний день остаётся открытым спор, способен ли Google корректно сканировать и рендерить страницы, сделанные на JS.
Коды ответа сервера
Чтобы и дальше хорошо понимать этот процесс, нельзя обойти понятие, с которым SEO-специалисты сталкиваются ежедневно, — коды ответа сервера.
Раньше мы разобрали цикл, по которому Google нас находит, но как это происходит? Пользователь выполняет поиск (запрос) в Google. Поисковик идёт в свою базу данных и показывает самые релевантные результаты (SERP) для этого запроса — согласно сделанной классификации.
Когда пользователь видит разные результаты (показы), он кликает по одному из них — тому, который, по его мнению, лучше всего подходит под его задачу. В этот момент вступает в игру запрос Google к серверу, где размещён сайт, чтобы тот «отдал» контент.
Когда это происходит, сервер отвечает соответствующим кодом. Назовём самые значимые, которые мы как SEO-специалисты обязаны учитывать:
-
200: Этот код ответа говорит Google, что страница существует, что на ней есть контент и что показать её не проблема. Самый желанный для SEO-специалистов — при условии, что контент этой страницы с кодом 200 оптимален.
-
30x: Семейство статусов 30x соответствует редиректам. Самые заметные — 301 (постоянный), 302 и 307 (временные). По сути они говорят Google: «эй, этот URL A, который ты запросил, больше не тот, это вот другой URL B». Есть и другие, но они не относятся к понятию, которое мы разбираем. Важно знать, что для SEO предпочтительны 301-е, которые передают весь вес.
Рекомендуем к прочтению: Руководство по 301 редиректам
-
40X: Коды ошибок. Самые нежеланные для SEO-специалистов. Самый частый — знаменитый 404. Когда появляется этот код, мы говорим Google в ответ на его запрос URL, что такого URL больше нет и это, следовательно, ошибка.
-
410: Мы решили выделить его из семейства 40x за его SEO-ценность. Когда мы используем этот код в ответ на запрос сервера Google по URL, мы говорим ему, что URL «ушёл навсегда». Это интересно, потому что, в отличие от 404, Google понимает, что его больше никогда там не будет, и перестанет пытаться его сканировать, тогда как при 404 он просканирует его снова, думая, что мы, возможно, захотим это исправить.
-
50x: Этот тип ответа связан с ошибками сервера. Когда наша машина по какой-то причине даёт сбой и Google пытается запросить у нас контент какого-то URL, при отказе сервера он возвращает статус 505.
Crawl Budget
На этом месте поста нам ещё нужно разобрать термин, который стал популярен в мире SEO пару лет назад, — crawl budget (краулинговый бюджет).
Crawl budget — это время, которое пауки Google тратят на сканирование сайта и всех его URL. Как мы уже говорили, это время конечно. Отсюда и важность оптимизации нашего сайта, чтобы за это время ему было проще увидеть самые значимые страницы.
Это время, которое краулеры тратят на обход нашего сайта, не фиксированная величина: оно будет расти или сокращаться в зависимости от таких аспектов, как частота обновления контента, авторитет нашего домена (популярность) и так далее.
Чем выше качество нашего сайта, чем больше авторитет и чем больше свежего контента, тем более значимыми Google нас сочтёт и тем больше бюджета выделит на наше сканирование.
С помощью программ для сканирования вроде Screaming Frog мы выполняем идеализированные симуляции обхода нашего сайта, то есть как если бы у пауков было сколько угодно времени, чтобы пройти по каждому нашему URL.
Но с Googlebot это работает не так: каждый раз, когда Google заходит на наш сайт, он посетит одни URL чаще, чем другие. Более того, какие-то он может вообще не посетить. Анализировать это мы будем с помощью того, что известно как логи сервера (записи о том, какие URL Google просканировал, как часто он это делал и сколько раз за определённый период).
На этом заканчивается весь разбор того, что такое сканирование, и разных элементов, входящих в систему сканирования Google.
Есть вопросы или предложения? Как всегда... будем рады вас услышать!
Автор: David Kaufmann

Последние 10 с лишним лет я полностью одержим SEO — и, честно говоря, не хотел бы иначе.
Моя карьера вышла на новый уровень, когда я работал старшим SEO-специалистом в Chess.com — одном из ста самых посещаемых сайтов интернета. Работа в таком масштабе: миллионы страниц, десятки языков и одна из самых конкурентных выдач — научила меня тому, чему не научит ни один курс и ни один сертификат. Этот опыт изменил моё представление о том, как выглядит по-настоящему сильное SEO, и лёг в основу всего, что я построил потом.
Из него выросло SEO Alive — агентство для брендов, которые всерьёз занимаются органическим ростом. Мы не продаём дашборды и ежемесячные отчёты. Мы строим стратегии, которые реально двигают цифры, соединяя классическое SEO с новым и захватывающим миром Generative Engine Optimization (GEO): чтобы ваш бренд появлялся не только в синих ссылках Google, но и внутри ответов, которые ChatGPT, Perplexity и Google AI Overviews каждый день выдают миллионам людей.
А поскольку инструмента, который нормально закрывает оба этих мира, я так и не нашёл, я сделал его сам — SEOcrawl AI, платформу SEO-аналитики корпоративного уровня, где в одном месте собраны позиции, технические аудиты, мониторинг ссылок, здоровье краулинга и отслеживание видимости бренда в ИИ. Это та платформа, которой мне всегда не хватало.
Откройте больше материалов этого автора