


«Discovered – currently not indexed»: ko tas nozīmē un kā to novērst
Google zina, ka jūsu URL pastāv, bet vēl to nav apmeklējis. Lūk, kā noteikt, vai gaidīt vai rīkoties, un kādus labojumus izmēģināt vispirms mazā un lielā vietnē.
Discovered – currently not indexed nozīmē, ka Google URL ir atradis, bet vēl to nav izskatījis. Tā to raksturo Google lapu indeksēšanas atskaites palīdzība. Parasti Google plānoja pārmeklēt un atlika to, lai nepārslogotu jūsu vietni, tāpēc atskaitē pēdējās pārmeklēšanas datums ir tukšs.
Tas ir pārmeklēšanas prioritātes statuss, nevis spriedums par jūsu saturu, jo Google lapu vēl nav lasījis. Zemāk redzēsiet, kā tas atšķiras no «Crawled», ko atradām, pārbaudot savu vietni, un labojumu sarakstu pēc vietnes izmēra. Atskaiti lietojat pirmo reizi? Sāciet ar šo Google Search Console ceļvedi.
Ko nozīmē «Discovered – currently not indexed»
Google URL ved cauri četriem soļiem: atrod, pārmeklē, indeksē un tikai pēc tam var rādīt rezultātos. Divi Search Console statusi apraksta URL, kas ceļā iestrēdzis.
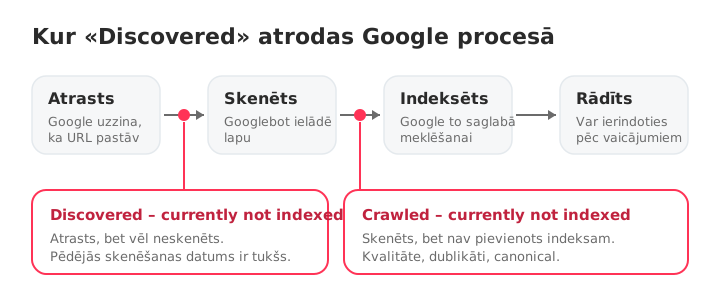
URL līdz «atrasts» nonāk pa vietnes karti vai ar saitēm no citām lapām. Pēc tam Google izlemj, kad to pārmeklēt. «Discovered» nozīmē, ka šis lēmums vēl nav pieņemts.
Kā tas atšķiras no «Crawled – currently not indexed»
Abi statusi izskatās līdzīgi, bet prasa dažādus labojumus.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Vai Google pārmeklējis? | Nē | Jā |
| Pēdējās pārmeklēšanas datums | Tukšs | Datums ir |
| Vai Google lasījis lapu? | Nē | Jā |
| Parastais iemesls | Pārmeklēšana atlikta vai zema prioritāte | Google izlasīja lapu un to atstāja |
| Ko skatīt vispirms | Iekšējās saites, vietnes karte, pārmeklēšanas jauda | Satura kvalitāte, dublikāti, canonical |
Pilnu otrā statusa diagnostiku skatiet Crawled – currently not indexed ceļvedī.
Kā saraksts izskatās īstā vietnē
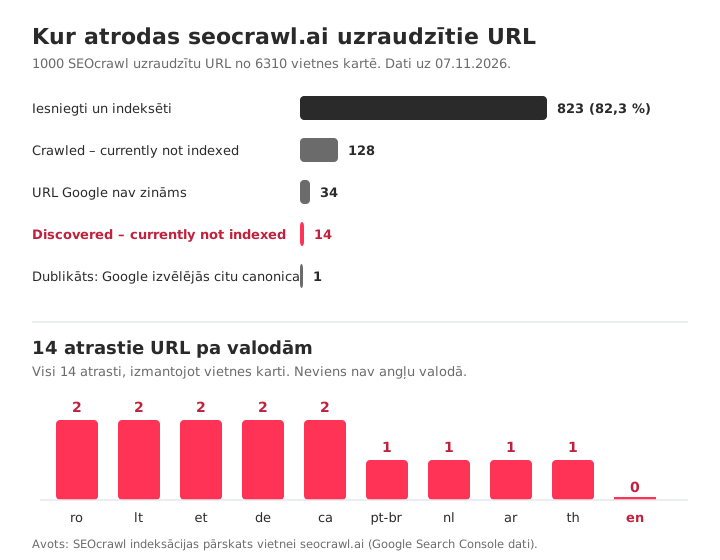
Mēs pārbaudījām seocrawl.ai SEOcrawl indeksēšanas atskaitē. No 1000 URL, ko SEOcrawl uzrauga (mūsu vietnes karte deklarē 6310), 823 ir indeksēti, tas ir, 82,3 %. 128 ir statusā «Crawled – currently not indexed» un 14 — «Discovered – currently not indexed».
Tas, kas šiem 14 ir kopīgs, ir noderīgākā daļa:
- Visas ir tulkotas lapas: arābu, katalāņu, vācu, igauņu, lietuviešu, holandiešu, Brazīlijas portugāļu, rumāņu un taju. Neviena nav angļu valodā.
- Google visus 14 atrada pa vietnes karti, nevis ar saiti no citas lapas.
- Vienam no tiem ir agrāks pārmeklēšanas datums (2026. gada 9. maijs), tātad statuss apraksta, kur URL ir tagad, nevis to, ka Google tajā nekad nav bijis.
Tā ir pārbaudāma likumsakarība, nevis diagnoze. Lapa, kas pastāv 26 valodās un kuru galvenokārt sasniedz pa vietnes karti, ir dabisks kandidāts vājām iekšējām saitēm, tāpēc iekšējās saites ir pirmais, kam pievērst uzmanību. Mācība der jebkurai vietnei: nelasiet sarakstu URL pa URL. Grupējot pēc valodas, 14 URL kļuva par vienu jautājumu.
Skaitļi aptver 1000 URL, ko SEOcrawl uzrauga, proti, visas vietnes kartes izlasi. Lielākā, 128 URL grupa ir otrs statuss, un tai ir sava ceļvedis.
Kāpēc Google pārmeklēšanu atliek
Google pārmeklēšanas budžeta ceļvedis skaidro, kā viņš izlemj, cik daudz pārmeklēt: jaudas robeža, ko jūsu serveris iztur, un jūsu URL pieprasījums. Lielāko daļu atklāto URL var attiecināt uz vienu no šiem pieciem cēloņiem.
- Pārmeklēšanas jauda. Google norāda, ka robeža krītas, kad vietne kļūst lēna vai atgriež servera kļūdas. Lēns serveris nozīmē mazāk pārmeklēšanu.
- Zems pārmeklēšanas pieprasījums. Pieprasījums atkarīgs no vietnes izmēra, atjaunināšanas biežuma un lapu kvalitātes un atbilstības. URL ar nedaudzām iekšējām saitēm vai bez tām dod Google maz iemeslu drīz atgriezties.
- Veltīgi iztērēta pārmeklēšana. Dublēti URL, parametri, fasetes, garas pāradresāciju ķēdes un soft 404 sacenšas ar jūsu īstajām lapām. Google atzīmē, ka soft 404 turpina pārmeklēt un tie tērē budžetu, un ka lapu ar noindex tomēr pieprasa, pirms to atstāj.
- Atrasts tikai pa vietnes karti. Vietnes karte Google paziņo, ka URL pastāv. Tā to nepadara par prioritāti, un Google karti uzskata par mājienu. Lapas, kas atrastas tikai tur, gaida pirmās.
- Jauna vietne vai sadaļa. Katra vietne sāk ar vienu un to pašu piesardzīgo noklusējuma jaudas robežu, kas aug, kad vietne pierāda, ka ir veselīga.
Pats pārmeklēšanas budžets pelna jūsu uzmanību tikai ļoti lielās vietnēs. Google aptuvenais novērtējums: 1 000 000+ unikālu lapu, kas tiek atjauninātas aptuveni reizi nedēļā, vai 10 000+ lapu, kas mainās katru dienu. Mazākās vietnēs 2. un 4. cēlonis ir daudz biežāks.
Vai tā ir problēma? Trīs jautājumi, pirms ko labojat
- Vai šim URL vispār jābūt indeksētam? Ja tas ir filtrēts skats, iekšējās meklēšanas lapa vai testa URL, tā trūkums ir normāls. Lai to skaidri norādītu, izmantojiet noindex vai atgrieziet 404 vai 410 (skatiet Excluded by 'noindex' tag).
- Cik URL un ar kādu likumsakarību? Google norāda, ka ar mazāk nekā 500 lapām šī atskaite jums, visticamāk, vispār nav vajadzīga. Saraksts ir arī ierobežots līdz 1000 rindām, tāpēc lielā vietnē tā ir izlase.
- Vai tie ir jauni? Pagājušajā nedēļā publicēts URL vēl nav problēma. Paša Google laika intervāli ir tabulā zemāk.
Kā labot atkarībā no vietnes izmēra
Pareizais pirmais solis ir atkarīgs no jūsu vietnes izmēra, tāpēc sāciet ar pareizo kolonnu.
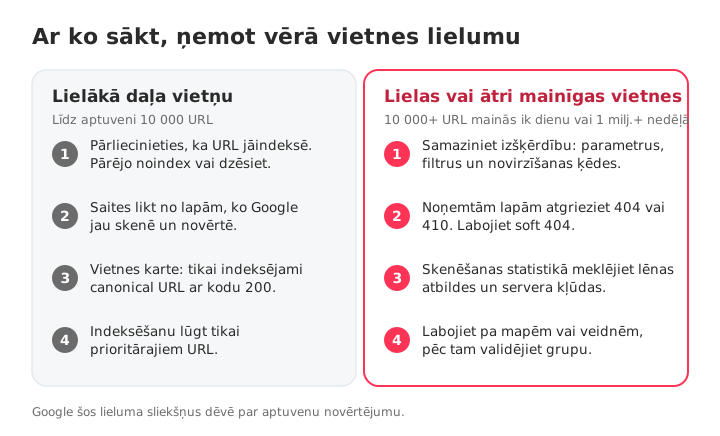
Lielākā daļa vietņu: līdz aptuveni 10 000 URL
- Pārliecinieties, ka URL ir indeksēšanas vērts. Ja nav, izmantojiet noindex vai noņemiet to un izsvītrojiet no saraksta.
- Veidojiet saites no lapām, ko Google jau pārmeklē. Pievienojiet kontekstuālas saites ar aprakstošu enkurtekstu no indeksētām lapām, kas saņem trafiku. Jebkurš pārmeklētājs parāda jūsu bāreņu lapas, filtrējot lapas bez iekšējām saitēm, un šajā iekšējo saišu ceļvedī ir visa metode.
- Turiet vietnes karti tīru. Iekļaujiet tikai URL, kas atgriež 200, ir indeksējami un ir canonical versija, ar precīzu
lastmod. Google ignorē priority un changefreq. Ja vispirms vajadzīgs fails, atrodiet savu vietnes karti. Ja Search Console norāda, ka neatrod nevienu, skatiet No referring sitemaps detected. - Palūdziet indeksēt dažus prioritāros URL. Atveriet URL pārbaudes rīku un noklikšķiniet uz Pieprasīt indeksēšanu. Google piemēro kvotu un norāda, ka atkārtoti pieprasījumi neko nepaātrina, tāpēc atstājiet to svarīgākajām lapām.
Lielas vai ātri mainīgas vietnes: 10 000+ URL mainās dienā vai 1 milj.+ nedēļā
- Samaziniet veltīgu pārmeklēšanu. Robots.txt bloķējiet URL telpas bez meklēšanas vērtības (parametri, fasetes, vietnes meklēšana) un apvienojiet dublikātus ar canonical un 301 pāradresācijām. Neceriet, ka noindex ietaupīs budžetu: Google šīs lapas turpina pieprasīt.
- Dzēstām lapām atgrieziet 404 vai 410 un labojiet soft 404. Google 404 sauc par spēcīgu signālu URL vairs nepārmeklēt, bet bloķēti URL rindā paliek ilgāk. Saīsiniet katru garo pāradresāciju ķēdi.
- Pārbaudiet pārmeklēšanas statistiku. Iestatījumos pārmeklēšanas statistikas atskaite rāda atbildes laikus un servera kļūdas. Ja tie ir augsti, Google pazemina jūsu jaudas robežu, un neviens satura labojums nepalīdzēs, kamēr serveris neuzlabosies.
- Labojiet pa mapēm vai veidnēm, tad validējiet grupu. Pieņemiet vienu lēmumu katrai likumsakarībai, izveidojiet vietnes karti tikai ar izlabotajiem URL un noklikšķiniet uz Validēt labojumu. Lasiet vairāk par pārmeklēšanas budžetu, ja jūsu vietne pieder šai kategorijai.
Gaidīt vai rīkoties?
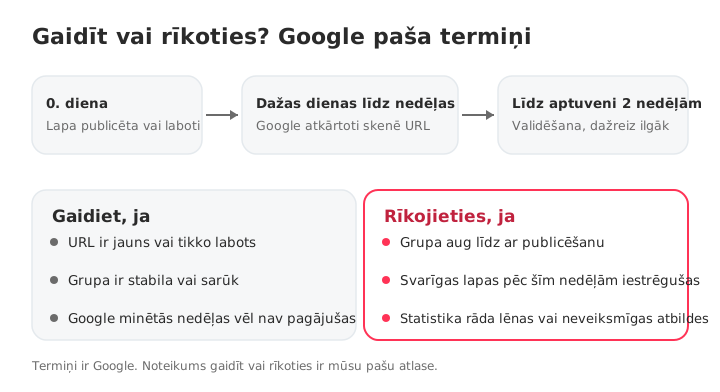
Visgrūtākais nav labojums, bet zināt, kad beigt gaidīt. Izmantojiet paša Google intervālus un savu tendenci.
| Ko jūs izdarījāt | Ko saka Google | Avots |
|---|---|---|
| Palūdzāt Google pārmeklēt vēlreiz | No dažām dienām līdz dažām nedēļām | Google lūgšana pārmeklēt vēlreiz |
| Pieprasījāt indeksēšanu | Parasti aptuveni diena, līdz vienai vai divām nedēļām, ar dienas kvotu | URL pārbaudes palīdzība |
| Validējāt labojumu | Līdz aptuveni divām nedēļām, dažkārt ievērojami ilgāk | Lapu indeksēšanas palīdzība |
Laika intervāli ir no Google. Noteikums gaidīt vai rīkoties ir mūsu: gaidiet, kamēr URL ir jauns un grupa stabila vai sarūkoša, un rīkojieties, kad grupa turpina augt vai jūsu galvenās lapas pēc šīm nedēļām ir iestrēgušas.
Kā uzraudzīt laika gaitā
Search Console rāda katra URL jaunāko stāvokli un sarakstu, kas ierobežots līdz 1000 rindām, tāpēc izveidojiet savu rutīnu:
- Reizi mēnesī eksportējiet sarakstu un salīdziniet ar iepriekšējo. Vai grupa aug, ir stabila vai sarūk?
- Grupējiet pēc likumsakarības (valoda, mape, veidne), pirms skatāties atsevišķus URL.
- Aplūkojiet, kā Google atrada katru URL. Saraksts, kurā visur ir «vietnes karte» un nekur nav «atsaucošā lapa», kā mūsu 14 URL gadījumā, tieši norāda uz iekšējām saitēm.
SEOcrawl AI Indeksēšanas skats šo sarakstu sniedz gatavu: filtrējiet pēc pārklājuma stāvokļa, lai redzētu tajā esošos URL ar pēdējās pārmeklēšanas datumu, klikšķiem un parādījumiem. Ar MCP katram URL līdzi nāk arī Google izvēlētais canonical, salīdzināts ar deklarēto, un informācija, vai tas atrasts pa vietnes karti vai atsaucošu lapu. Crawler auditē jūsu pašu lapas, tāpēc redzat, kas URL ir vājš, pirms lūdzat Google paskatīties vēlreiz, un SEO Monitor brīdina, kad galvenā lapa iegūst noindex, maina canonical, atgriež 404 vai pazūd no vietnes kartes.
Lūk, šis saraksts mūsu pašu vietnei, tieši no Indeksēšanas skata:
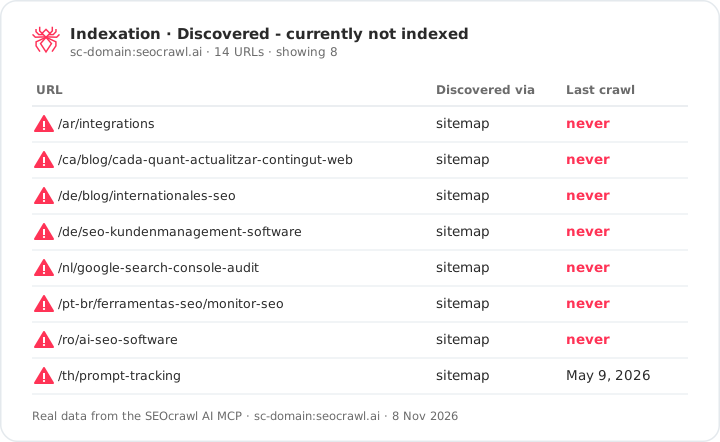
Informācijas paneli var arī izlaist. Ar SEOcrawl AI MCP, kas pieslēgts Claude vai ChatGPT, pajautājiet: «Parādi URL statusā Discovered – currently not indexed un sagrupē tos pa mapēm.» Lūk, soli pa solim, kā savienot Search Console ar Claude un ChatGPT.
Biežāk uzdotie jautājumi
Ko nozīmē «Discovered – currently not indexed»?
Tas nozīmē, ka Google atrada jūsu URL, bet vēl to nav izskatījis. Parasti Google plānoja pārmeklēt un to atlika, tāpēc pēdējās pārmeklēšanas datums ir tukšs (lapu indeksēšanas palīdzība). Google lapu nav lasījis, tāpēc statuss neko nesaka par tās kvalitāti. Tas nav sods.
Cik ilgi ilgst «Discovered – currently not indexed»?
Google šim statusam termiņu nepublicē. Viņš norāda, ka pieprasīta atkārtota pārmeklēšana aizņem no dažām dienām līdz dažām nedēļām un labojuma validācija līdz aptuveni divām nedēļām, dažkārt ievērojami ilgāk. Jaunam URL šīs nedēļas var vienkārši būt vajadzīgas. Ja grupa turpina augt, jums publicējot, beidziet gaidīt un rīkojieties.
Vai indeksēšanas pieprasīšana to atrisina?
Tā var palīdzēt dažiem prioritārajiem URL, jo lūdz Google lapu ielikt rindā. Tā nenovērš cēloni, tāpēc lapa var atgriezties tajā pašā statusā. Pieprasījumiem ir dienas kvota, un Google norāda, ka viena un tā paša URL iesniegšana vairākas reizes neko nepaātrina. Izmantojiet to pēc iekšējo saišu uzlabošanas, nekad kā masveida rīku.
Vai tas ir sods?
Nē. Manuālajām darbībām ir atsevišķa atskaite. Šis statuss nozīmē, ka Google URL atradis un vēl nav pārmeklējis, tātad lapa nav novērtēta. Cēlonis parasti ir pārmeklēšanas prioritāte: vājas iekšējās saites, lēns serveris vai daudz mazvērtīgu URL, kas sacenšas par pārmeklēšanu.
Kāpēc tik daudz manu lapu ir atklātas, bet neindeksētas?
Liels skaitlis parasti norāda uz likumsakarību, nevis atsevišķām lapām: URL parametriem vai fasetēm, dublikātiem, vietnes karti ar URL, kuriem tur nebūtu jābūt, vājām iekšējām saitēm uz veselu sadaļu vai serveri, kas bremzē Googlebot. Sagrupējiet URL pa mapēm, valodām vai veidnēm, pirms skatāties uz kādu atsevišķi.
Vai mazā vietnē jāuztraucas?
Parasti nē. Google norāda, ka, ja jūsu vietnē ir mazāk nekā 500 lapu, lapu indeksēšanas atskaite jums, visticamāk, vispār nav vajadzīga. Dažiem jauniem URL šajā statusā visbiežāk vajag laiku un pāris iekšējo saišu no lapām, ko Google jau pārmeklē.
Kā SEOcrawl AI var palīdzēt ar atklātajiem URL?
SEOcrawl AI Indeksēšanas skats uzskaita URL, kas iestrēguši katrā Google pārklājuma stāvoklī, ar pēdējās pārmeklēšanas datumu, klikšķiem un parādījumiem. Ar SEOcrawl AI MCP varat arī palūgt Claude vai ChatGPT šo sarakstu ar Google canonical, salīdzinātu ar deklarēto, un informāciju, vai Google katru URL atrada pa vietnes karti vai atsaucošu lapu, sagrupētu pa mapēm.
Vairāk SEOcrawl AI Google
Izvēlieties mūs kā vēlamo avotu, un Google galvenajās ziņās redzēsiet vairāk mūsu rakstu.
Autors: David Kaufmann
Pēdējos 10+ gadus esmu pavadījis, pilnībā aizrāvies ar SEO — un, godīgi sakot, es to nevēlētos citādi.
Mana karjera sasniedza jaunu līmeni, kad strādāju par vecāko SEO speciālistu Chess.com — vienā no 100 visapmeklētākajām vietnēm visā internetā. Darbs šādā mērogā, aptverot miljoniem lapu, desmitiem valodu un vienu no konkurētspējīgākajām SERPs, iemācīja man to, ko neviens kurss vai sertifikāts nekad nespētu. Šī pieredze mainīja manu skatījumu uz to, kā patiesībā izskatās izcils SEO — un kļuva par pamatu visam, ko esmu izveidojis kopš tā laika.
No šīs pieredzes es nodibināju SEO Alive — aģentūru zīmoliem, kas nopietni domā par organisko izaugsmi. Mēs neesam šeit, lai pārdotu dashboards un ikmēneša atskaites. Mēs esam šeit, lai veidotu stratēģijas, kas patiešām rada rezultātus, apvienojot labāko no klasiskā SEO ar aizraujošo jauno Generative Engine Optimization (GEO) pasauli — nodrošinot, ka jūsu zīmols parādās ne tikai Google zilajās saitēs, bet arī AI ģenerētajās atbildēs, ko ChatGPT, Perplexity un Google AI Overviews katru dienu piegādā miljoniem cilvēku.
Un tā kā es nevarēju atrast rīku, kas pareizi apstrādātu abas šīs pasaules, es izveidoju to pats — SEOcrawl AI, enterprise SEO intelligence platformu, kas vienuviet apvieno rankings, tehniskos auditus, backlinks uzraudzību, crawl veselību un AI zīmola redzamības izsekošanu. Tā ir platforma, par kuras esamību es vienmēr biju vēlējies.
Atklājiet vairāk šī autora satura
Mēs izmērījām Google klikšķus un MI novirzīto datplūsmu vairāk nekā 16 000 vietnēs un 15 nozarēs. MI datplūsma gadā pieaug par 45%, taču joprojām atbilst aptuveni 1 apmeklējumam uz katriem 100 no Google, kamēr Google klikšķu skaits samazinājās par 15%.

Līdz 30. novembrim jebkura SEOcrawl AI gada plāna pirmais gads ar kodu BLACKFRIDAY2026 maksā uz pusi mazāk. Ko tu saņem, ko aptver katra plāna prompti un kā 15 minūtēs redzēt, kur tevi piemin ChatGPT, Gemini, Claude un Perplexity.