Excluded by 'noindex' tag: ko tas nozīmē un kā to novērst
Jūs atvērāt Google Search Console, pamanījāt vairākus URL ar atzīmi "Excluded by 'noindex' tag", un tagad šīs lapas meklēšanā nav redzamas.
Ja Google Search Console esat pamanījis vairākus URL ar statusu "Excluded by 'noindex' tag", jūsu lapas apzināti netiek iekļautas Google indeksā, un risinājums parasti ir vienkāršāks, nekā šķiet: atrodiet direktīvu, noņemiet to un palūdziet Google lapu pārmeklēt vēlreiz.
Šajā ceļvedī paskaidrots, kas tieši izraisa šo statusu, kā atrast noindex direktīvu, kas to rada, un precīzi soļi, kā to noņemt visās populārākajās CMS, lai jūsu lapas atkal varētu ranžēties. Tā pati pārbaude automātiski darbojas rīkā SEOcrawl AI Crawler, kas atzīmē noindex direktīvas visā vietnē bez URL pārbaudes pa vienam.
Ko Google Search Console nozīmē statuss "Excluded by 'noindex' tag"?
Statuss "Excluded by 'noindex' tag" nozīmē, ka Googlebot pārmeklēja jūsu lapu, atrada noindex direktīvu un to ievēroja, neiekļaujot lapu Google indeksā. Kamēr direktīva paliek, lapa meklēšanas rezultātos neparādīsies.
Kur šis statuss parādās GSC
Vecajā pārskatā Coverage (2022. gadā to aizstāja pārskats Page indexing) šis statuss bija sadaļā "Excluded". Pašreizējā pārskatā Page indexing (Indexing › Pages) to atradīsiet sadaļā "Not indexed", tabulā "Why pages aren't indexed", ar iemeslu "Excluded by 'noindex' tag". Google grupē visus skartos URL zem šīs atzīmes, lai tos varētu eksportēt un pārskatīt kopā.
Kā Google atklāj un ievēro noindex direktīvu
Google dokumentācijā par indeksēšanas bloķēšanu ar noindex aprakstīti divi nodošanas veidi: <meta name="robots" content="noindex"> birka lapas HTML sadaļā <head> vai X-Robots-Tag: noindex direktīva HTTP atbildes galvenēs. Kad Googlebot saskaras ar kādu no tām, tas pilnībā izņem lapu no indeksa, pat ja lapa iepriekš bija indeksēta. Par pašas birkas pamatiem lasiet mūsu ceļvedī par noindex meta birku.
Vai tā vienmēr ir problēma? Kad izslēgšana ir apzināta
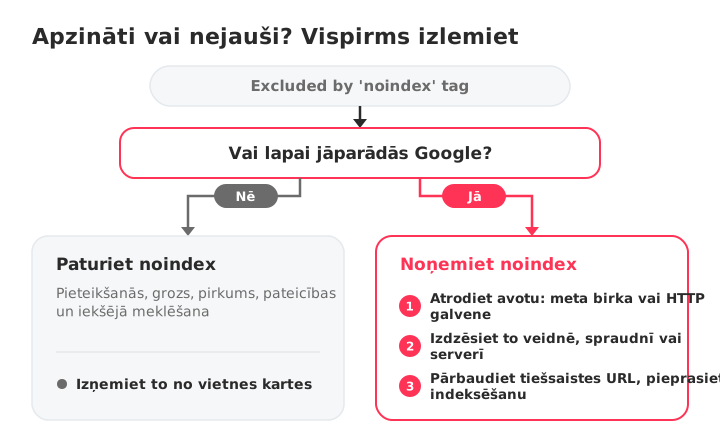
Ne katrs URL ar statusu "Excluded by 'noindex' tag" ir kļūda. Administrēšanas lapas, pieteikšanās ekrāni, grozs un pirkuma noformēšana, pateicības lapas un iekšējās meklēšanas rezultāti apzināti netiek iekļauti Google indeksā. Ja šīm lapām ir šis statuss, sistēma darbojas, kā paredzēts. Īstā problēma sākas tad, kad šo atzīmi saņem lapas, kuras vēlaties ranžēt.
Biežākie statusa "Excluded by 'noindex' tag" cēloņi
Noindex direktīva jūsu lapā var nonākt vairākos dažādos veidos. No tā, kurš no tiem darbojas jūsu vietnē, atkarīgs risinājums.
Robots meta birka ar "noindex" sadaļā <head>
Visbiežākais avots. Rinda, piemēram, <meta name="robots" content="noindex"> lapas HTML kodā liek Googlebot lapu neindeksēt. Tā var būt ierakstīta tieši veidnē vai dinamiski pievienota ar CMS, spraudni vai motīva funkciju.
X-Robots-Tag HTTP atbildes galvenēs
X-Robots-Tag darbojas tieši tāpat kā meta birka, taču atrodas HTTP atbildes galvenē, nevis HTML kodā. To var pievienot servera konfigurācija, CDN noteikumi vai .htaccess direktīvas. Piemēram:
Header set X-Robots-Tag "noindex"
Tas ietekmē katru failu, kas atbilst noteikumam, arī PDF failus un attēlus, kuriem nav HTML sadaļas <head>. Daudzi vietņu īpašnieki šo ceļu pilnībā nepamana, jo direktīva lapas pirmkodā nav redzama.
CMS iestatījumi, kas nejauši bloķē indeksēšanu
WordPress sadaļā Settings › Reading ir izvēles rūtiņa "Discourage search engines from indexing this site". Kad tā ir atzīmēta, WordPress katrai vietnes lapai pievieno robots noindex birku. Daudzi to ieslēdz izstrādes laikā un pēc palaišanas aizmirst noņemt atzīmi.
Shopify var pievienot noindex ar motīva kodu vai lietotnēm. Dažas konta un sistēmas lapas Shopify pats neiekļauj indeksā, un tas ir pareizi, taču motīva labojums vai SEO lietotne var kļūdas pēc pievienot noindex produktu, kolekciju vai bloga lapām.
Wix pievieno noindex jebkurai lapai, kuras SEO iestatījumi neļauj meklētājprogrammām to indeksēt. Biežs iemesls ir lapas dublēšana, kad kopija nemanāmi pārmanto oriģināla noindex iestatījumu.
Spraudņu vai motīvu konflikti, kas pievieno noindex
SEO spraudņi ļauj iestatīt noindex katram ierakstam, lapai vai satura tipam. Nepareizi konfigurēts globāls noteikums, spraudņa atjauninājums, kas atiestata iestatījumus, vai motīvs, kas pārraksta spraudņa direktīvas, var vienlaikus pievienot noindex desmitiem lapu. Ja nesen atjauninājāt spraudni vai nomainījāt motīvu, pārbaudiet to vispirms.
Testa vides iestatījumi, kas nonākuši produkcijā
Pārsteidzoši bieži nejaušu noindex birku avots. Jūsu testa vietne izmanto noindex, lai netiktu iekļauta Google. Kad izvietošanas process pārnes testa vides konfigurāciju uz produkciju, noindex direktīva tiek pārnesta līdzi. Parasti tas vienlaikus skar veselas vietnes sadaļas, un šo cēloni ir vienu no grūtāk diagnosticēt, ja pārbaudāt tikai atsevišķas lapas.
Kā noteikt, kuras lapas ir skartas
Atkārtojams diagnostikas process atklāj visus skartos URL bez minēšanas. Sāciet ar Search Console, lai iegūtu sarakstu, un tad pārejiet pie atsevišķām lapām, lai atrastu avotu.
Skarto URL eksportēšana no pārskata Page indexing
Atveriet Google Search Console un dodieties uz Indexing › Pages. Tabulā "Why pages aren't indexed" noklikšķiniet uz "Excluded by 'noindex' tag". Search Console parāda skarto URL paraugu; izmantojiet pogu Export, lai lejupielādētu sarakstu apstrādei.
Viena URL pārbaude ar rīku URL Inspection
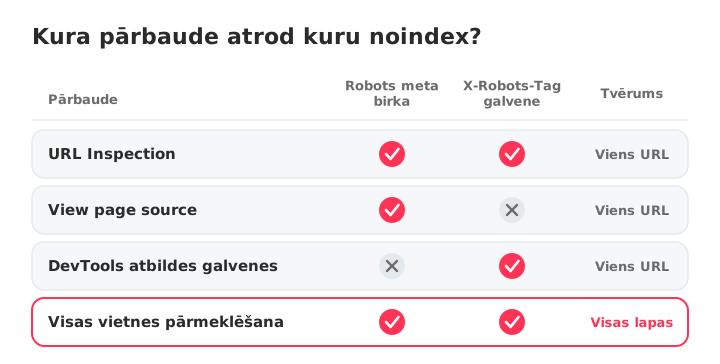
Ielīmējiet jebkuru URL meklēšanas joslā Search Console augšdaļā. Rīks URL Inspection parāda, vai Google redzēja noindex direktīvu un kur to atrada: punktā "Indexing allowed?" ir norādīts, vai noindex nāca no robots meta birkas vai no X-Robots-Tag HTTP galvenes. Noklikšķiniet uz View crawled page, lai redzētu precīzu HTML, ko saņēma Googlebot. Tā ir ātrākā pieejamā vienas lapas pārbaude.
Lapas pirmkoda pārbaude, meklējot noindex meta birkas
Atveriet lapu pārlūkā, ar peles labo pogu noklikšķiniet un izvēlieties View page source, pēc tam meklējiet "noindex" (Ctrl+F vai Cmd+F). Ja atrodat <meta name="robots" content="noindex"> vai līdzīgu birku, vainīgā ir meta birka. Ja pirmkodā to neatrodat, direktīva, iespējams, nāk no HTTP galvenes.
HTTP galveņu pārbaude pārlūka DevTools
Atveriet DevTools (F12 vai labais klikšķis › Inspect), dodieties uz cilni Network, pārlādējiet lapu un noklikšķiniet uz galvenā dokumenta pieprasījuma. Sadaļā Response Headers meklējiet X-Robots-Tag: noindex. Tas ir vienīgais veids tieši pārlūkā atklāt galvenēs nosūtītas noindex direktīvas, kas HTML kodā neparādās.
Vietnes pārmeklēšana ar Screaming Frog vai SEOcrawl AI
Visas vietnes diagnostikai rāpuļprogramma vienā piegājienā atrod visas skartās lapas. Screaming Frog SEO Spider var filtrēt lapas pēc indeksējamības, ņemot vērā meta birkas un galvenes. SEOcrawl AI Crawler pārmeklē katru lapu, sadaļā Indexability atzīmē katru lapu ar noindex direktīvu un sniedz Audit Health Score, tāpēc jūs redzat visu apjomu bez manuālas eksportēšanas un filtrēšanas.
Kā novērst "Excluded by 'noindex' tag": soli pa solim
Šī ir praktiskākā sadaļa. Izmantojiet risinājumu, kas atbilst iepriekšējās sadaļas diagnostikai.
Noindex meta birkas noņemšana no lapas pirmkoda
Rediģējiet lapas veidni vai saturu, lai noņemtu <meta name="robots" content="noindex"> no HTML sadaļas <head>. Pielāgoti izstrādātās vietnēs pārbaudiet veidņu failus tieši. Ja birku pievieno JavaScript, atrodiet atbildīgo skriptu un noņemiet to vai pievienojiet nosacījumu.
Pirms:
<meta name="robots" content="noindex">
Pēc:
<meta name="robots" content="index, follow">
Vai vienkārši noņemiet birku pilnībā. Google noindex direktīvas neesamību uztver kā "indeksēšana atļauta".
X-Robots-Tag labošana servera vai CDN konfigurācijā
Pārbaudiet .htaccess (Apache), nginx.conf (Nginx) vai CDN noteikumus, vai tajos nav X-Robots-Tag: noindex direktīvu. Noņemiet tās vai ierobežojiet tās tikai ar konkrētiem ceļiem, kas jāizslēdz, nevis ar lapām, kuras vēlaties indeksēt. Piemēram, noindex var paturēt ceļam /staging/, bet noņemt no /blog/.
Kā novērst WordPress vietnē
Divas pārbaudes šādā secībā:
- Visas vietnes iestatījums: atveriet Settings › Reading un noņemiet atzīmi no "Discourage search engines from indexing this site". Tas ir visbiežākais visas vietnes noindex problēmu cēlonis WordPress.
- Atsevišķu lapu iestatījumi SEO spraudņos:
- Yoast SEO: atveriet ierakstu vai lapu, ritiniet līdz Yoast blokam, noklikšķiniet uz cilnes Advanced un iestatiet "Allow search engines to show this content in search results?" uz "Yes".
- Rank Math: atveriet ierakstu, dodieties uz Rank Math bloku, noklikšķiniet uz cilnes Advanced un iestatiet "Robots Meta" uz "Index".
- All in One SEO: rediģējiet ierakstu, AIOSEO iestatījumos atveriet cilni Advanced un pārliecinieties, ka robots iestatījumos nav atzīmēts "No Index".
Pārbaudiet arī katra spraudņa globālos iestatījumus, vai veseli satura tipi (birkas, kategorijas, pielāgoti ierakstu tipi) nav iestatīti uz noindex. Par pārējo WordPress iestatīšanu lasiet mūsu ceļvedī par WordPress savienošanu ar Google Search Console.
Kā novērst Shopify
Shopify noindex parasti rada motīva kods vai lietotne. Atveriet Online Store › Themes › Edit code un meklējiet failā theme.liquid un lapu veidnēs robots meta birku ar noindex. Pēc tam pārbaudiet SEO lietotnes, vai tajās nav noteikumu, kas slēpj produktus, kolekcijas vai bloga ierakstus, un visus produktus vai lapas, kas izmanto metalauku seo.hidden. Konta un citas sistēmas lapas Shopify pats neiekļauj indeksā, un tā tam arī jāpaliek.
Kā novērst Wix, Squarespace un citos vietņu veidotājos
Wix: atveriet lapas SEO iestatījumus (no lapas izvēlnes) un ieslēdziet "Let search engines index this page". Ja lapu dublējāt, kopija varēja pārmantot oriģināla noindex iestatījumu.
Squarespace: pārbaudiet visas vietnes SEO iestatījumus, vai tur nav opcijas, kas slēpj vietni no meklētājprogrammām. Atsevišķām lapām atveriet lapas iestatījumus un cilnē SEO meklējiet "Hide page from search results". Squarespace arī pēc noklusējuma neiekļauj meklēšanas rezultātos dažas sistēmas lapas, piemēram, grozu.
Pēc labojuma: atkārtotas indeksēšanas pieprasīšana Google Search Console
Noindex birkas noņemšana pasaka Google, ka tas lapu drīkst indeksēt, taču Googlebot tā joprojām ir jāpārmeklē vēlreiz, lai apstiprinātu izmaiņas.
Indeksēšanas pieprasīšana ar rīku URL Inspection
Ielīmējiet laboto URL Search Console meklēšanas joslā. Noklikšķiniet uz Test live URL, lai pārliecinātos, ka indeksēšana tagad ir atļauta, un pēc tam noklikšķiniet uz Request indexing. Google ievietos URL atkārtotas pārmeklēšanas rindā. Šādi varat iesniegt vairākus URL, taču Search Console ierobežo, cik pieprasījumu dienā varat veikt.
Cik ilgā laikā Google atkārtoti indeksē lapu?
Parasti no dažām dienām līdz dažām nedēļām, atkarībā no tā, cik bieži Googlebot pārmeklē jūsu vietni. Vietnes ar lielu datplūsmu un biežiem atjauninājumiem tiek pārmeklētas ātrāk; jaunām vietnēm vai vietnēm ar nelielu datplūsmu var nākties gaidīt nedēļām. Indeksēšanas pieprasījums ir ātrākais signāls, ko varat nosūtīt, taču tā nav garantija: tas ievieto jūsu URL pārmeklēšanas rindā, nevis piespiež tūlītēju pārmeklēšanu.
Atjauninātas XML vietnes kartes iesniegšana, lai paātrinātu pārmeklēšanu
Ja esat izlabojis daudz lapu vienlaikus, iesniedziet atjauninātu XML vietnes karti Search Console sadaļā Sitemaps. Tas signalizē, ka jūsu vietne ir mainījusies, un veicina plašāku atkārtotu pārmeklēšanu. Tīra vietnes karte bez noindex URL arī novērš pretrunīgus signālus, par kuriem runāsim tālāk.
Kad noindex birku vajadzētu paturēt (apzināta izslēgšana)
Ne katra noindex birka ir jānoņem. Dažām lapām nekad nevajadzētu parādīties meklēšanas rezultātos, un to indeksēšana pievieno vājas vai dublētas lapas Google priekšstatam par jūsu vietni un velti tērē rāpuļprogrammas uzmanību.
Lapas, kuras nekad nevajadzētu indeksēt
- Pieteikšanās un reģistrācijas lapas
- Groza, pirkuma noformēšanas un pasūtījuma apstiprinājuma lapas
- Iekšējās meklēšanas rezultātu lapas (lai novērstu dublētu saturu)
- Pateicības lapas (lead magnet materiāli, veidlapu iesniegšana)
- Administrēšanas un aizmugursistēmas lapas
- Testa un izstrādes vides
- Filtru un parametru lapas, kas rada dublētus URL
noindex pret robots.txt: galvenās atšķirības
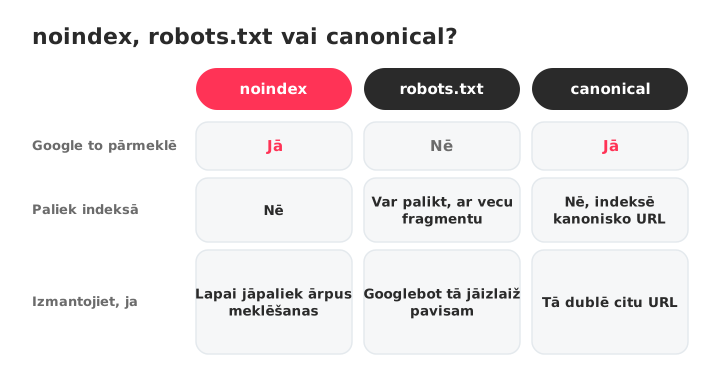
robots.txt bloķē pārmeklēšanu. noindex pārmeklēšanu atļauj, bet bloķē indeksēšanu. Ja bloķējat lapu robots.txt failā, Googlebot to nekad nenolasa, kas nozīmē, ka tas nekad neredz arī noindex birku. Ja vēlaties izņemt lapu no indeksa, izmantojiet noindex. Ja vēlaties, lai Googlebot lapu izlaistu pavisam (lai ietaupītu pārmeklēšanas budžetu), izmantojiet robots.txt.
Bieža kļūda: izmantot robots.txt, lai bloķētu lapu, kas jau ir indeksēta. Google neredz noindex birku, ja nevar pārmeklēt lapu, tāpēc URL var palikt indeksā ar novecojušu virsrakstu un fragmentu. Pareizā pieeja ir atļaut pārmeklēšanu un izmantot noindex, lai izņemtu lapu no indeksa.
Canonical birkas pret noindex: pareizās direktīvas izvēle
Canonical birka (rel="canonical") pasaka Google: "šī lapa ir cita URL kopija, ranžē labāk to". Noindex birka pasaka Google: "šo lapu vispār neindeksē". Tām ir dažādi mērķi:
- Izmantojiet canonical, ja jums ir dublēts vai gandrīz dublēts saturs un vēlaties apvienot ranžēšanas signālus vienā URL.
- Izmantojiet noindex, ja lapai nekādos apstākļos nav jāparādās meklēšanas rezultātos.
Abu apvienošana vienā lapā sūta pretrunīgus signālus: viena saka "apvieno šo lapu ar citu URL", otra saka "izmet to". Izvēlieties to, kas atbilst jūsu mērķim.
Kā nākotnē novērst nejaušas noindex birkas
Noindex problēmu labošana pēc to rašanās ir nepieciešama, taču to novēršana ietaupa stundām ilgu diagnostiku un zaudētu datplūsmu.
Search Console brīdinājumu iestatīšana par indeksēšanas kritumiem
Google Search Console sūta e-pastus verificētiem īpašniekiem un lietotājiem, kad īpašumā konstatē jaunas indeksēšanas problēmas. Pārliecinieties, ka Search Console e-pasta preferencēs ir ieslēgti e-pasta paziņojumi. Ja indeksēto lapu skaits pēkšņi krītas, brīdinājums dod jums laika priekšrocību, pirms sāk kristies datplūsma.
Noindex pārbaužu pievienošana QA kontrolsarakstam pirms palaišanas
Pirms jebkuras vietnes izvietošanas vai testa vides pārnešanas uz produkciju pārbaudiet, vai nav noindex direktīvu. 30 sekunžu pārbaude ar "View page source" un "noindex" meklēšanu atklāj visbiežāko izvietošanas kļūdu. Lielākām vietnēm veiciet pārmeklēšanu pirms un pēc izvietošanas un salīdziniet lapu ar noindex skaitu. Pievienojiet to savam tehniskā SEO kontrolsarakstam, lai neviens to neizlaistu.
Plānota pārmeklēšana, lai atklātu nevēlamas noindex direktīvas
Palaidiet pilnu pārmeklēšanu pēc grafika un pēc katra spraudņa atjauninājuma, motīva maiņas vai migrācijas, lai atklātu nevēlamas noindex birkas, pirms tās jums maksā datplūsmu. SEOcrawl AI Crawler ļauj salīdzināt pārmeklēšanas, tāpēc redzat, kurām lapām un kad parādījās noindex, bet SEO Monitor jūs brīdina tajā brīdī, kad kādā no jūsu svarīgākajām lapām parādās noindex birka.
Biežāk uzdotie jautājumi
Ko Google Search Console nozīmē statuss "Excluded by 'noindex' tag"?
Tas nozīmē, ka Google jūsu lapā atrada noindex direktīvu un to ievēroja, tāpēc lapa neparādīsies meklēšanas rezultātos. Statuss redzams Search Console pārskatā Page indexing, sadaļā "Not indexed".
Tā ne vienmēr ir kļūda: lapām, kuras izslēdzat apzināti, piemēram, pieteikšanās vai pirkuma noformēšanas lapām, jābūt tieši šim statusam.
Kā novērst "Excluded by 'noindex' tag" WordPress vietnē?
Pārbaudiet divas vietas šādā secībā. Vispirms atveriet Settings › Reading un pārliecinieties, ka opcija "Discourage search engines from indexing this site" nav atzīmēta. Pēc tam atveriet katru skarto ierakstu vai lapu savā SEO spraudnī (Yoast, Rank Math, All in One SEO) un pārliecinieties, ka lapas robots iestatījums atļauj indeksēšanu.
Cik ilgā laikā Google indeksē lapu pēc noindex noņemšanas?
Parasti no dažām dienām līdz dažām nedēļām, atkarībā no tā, cik bieži Googlebot pārmeklē jūsu vietni. Pēc direktīvas noņemšanas pieprasiet indeksēšanu ar rīku URL Inspection un iesniedziet atjauninātu XML vietnes karti, lai paātrinātu procesu. Vietnes ar lielu datplūsmu tiek pārmeklētas ātrāk nekā jaunas vietnes vai vietnes ar nelielu datplūsmu.
Vai lapu var izslēgt ar noindex, pat ja tā ir manā vietnes kartē?
Jā. Noindex direktīva ir svarīgāka par iekļaušanu vietnes kartē. Google joprojām var pārmeklēt URL no jūsu vietnes kartes, taču to neindeksēs, kamēr ir noindex.
Vai nu noņemiet noindex, lai lapu varētu indeksēt, vai izņemiet URL no vietnes kartes, ja izslēgšana ir apzināta. Noindex URL vietnes kartē sūta pretrunīgus signālus.
Kāda ir atšķirība starp noindex un lapas bloķēšanu robots.txt failā?
robots.txt neļauj Googlebot pārmeklēt lapu; noindex pārmeklēšanu atļauj, bet novērš indeksēšanu. Ja bloķējat lapu ar robots.txt, Google nevar nolasīt noindex birku, tāpēc jau indeksēta lapa var palikt indeksā ar novecojušu saturu. Izmantojiet noindex, lai izņemtu lapu no indeksa, un robots.txt tikai tad, ja vēlaties pārmeklēšanu novērst pilnībā.
Kā pārbaudīt, vai lapai ir noindex birka?
Trīs metodes, no ātrākās līdz rūpīgākajai: izmantojiet rīku URL Inspection Search Console, apskatiet lapas pirmkodu un meklējiet "noindex" (Ctrl+F) vai pārbaudiet HTTP atbildes galvenes pārlūka DevTools (cilne Network, meklējiet X-Robots-Tag). Tikai URL Inspection un DevTools atklāj noindex, kas nosūtīts galvenē.
Vai jāuztraucas, ja daudzām lapām ir statuss "Excluded by 'noindex' tag"?
Tikai tad, ja šīm lapām būtu jābūt indeksētām. Eksportējiet sarakstu no Search Console, salīdziniet to ar apzināti izslēgtajām lapām (pieteikšanās, grozs, administrēšana, pateicības lapas) un labojiet tikai tās lapas, kurām jāranžējas meklēšanā. Ja visas skartās lapas esat izslēdzis apzināti, statuss darbojas pareizi.
Autors: David Kaufmann

Pēdējos 10+ gadus esmu pavadījis, pilnībā aizrāvies ar SEO — un, godīgi sakot, es to nevēlētos citādi.
Mana karjera sasniedza jaunu līmeni, kad strādāju par vecāko SEO speciālistu Chess.com — vienā no 100 visapmeklētākajām vietnēm visā internetā. Darbs šādā mērogā, aptverot miljoniem lapu, desmitiem valodu un vienu no konkurētspējīgākajām SERPs, iemācīja man to, ko neviens kurss vai sertifikāts nekad nespētu. Šī pieredze mainīja manu skatījumu uz to, kā patiesībā izskatās izcils SEO — un kļuva par pamatu visam, ko esmu izveidojis kopš tā laika.
No šīs pieredzes es nodibināju SEO Alive — aģentūru zīmoliem, kas nopietni domā par organisko izaugsmi. Mēs neesam šeit, lai pārdotu dashboards un ikmēneša atskaites. Mēs esam šeit, lai veidotu stratēģijas, kas patiešām rada rezultātus, apvienojot labāko no klasiskā SEO ar aizraujošo jauno Generative Engine Optimization (GEO) pasauli — nodrošinot, ka jūsu zīmols parādās ne tikai Google zilajās saitēs, bet arī AI ģenerētajās atbildēs, ko ChatGPT, Perplexity un Google AI Overviews katru dienu piegādā miljoniem cilvēku.
Un tā kā es nevarēju atrast rīku, kas pareizi apstrādātu abas šīs pasaules, es izveidoju to pats — SEOcrawl AI, enterprise SEO intelligence platformu, kas vienuviet apvieno rankings, tehniskos auditus, backlinks uzraudzību, crawl veselību un AI zīmola redzamības izsekošanu. Tā ir platforma, par kuras esamību es vienmēr biju vēlējies.
Atklājiet vairāk šī autora satura